OpenAI dan Anthropic telah memangkas harga API secara agresif sejak Juli 2026, dan pemotongan itu tercantum di halaman harga mereka sendiri. GPT-5.6 Luna turun 80% dalam semalam, GPT-6.1 Sol terdaftar pada $2/$10 dibandingkan $5/$30 milik GPT-5.6 Sol, Claude Opus 5.5 memangkas pembacaan cache 60%, dan Claude Haiku 5.5 terdaftar pada sepersepuluh harga Haiku 4.5. Jika model biaya, aturan routing, atau peringatan anggaran Anda dibuat sebelum September, semuanya sekarang salah, dan sebagian besar justru menguntungkan Anda. Berikut ini: harga sebelum/sesudah yang terverifikasi, perhitungan per permintaan, jebakan yang masih membengkakkan tagihan, dan cara membuat coding agent Anda mengubah anggaran token menjadi pengujian.
Pemicunya adalah esai Max Woolf OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why? beserta thread Hacker News-nya. Kami membahas sisi pasarnya di perang harga model AI September 2026; tulisan ini membahas apa yang harus diubah oleh sebuah tim.
Harga sebelum/sesudah yang terverifikasi
USD per juta token (input / output / input ter-cache), tier standar, di bawah ambang long-context. Baris OpenAI berasal dari halaman harga OpenAI API yang dibaca pada 2026-10-26, dengan harga "sebelum" dari salinan arsip halaman tersebut. Baris Anthropic berasal dari dokumentasi harga Claude, yang mencantumkan model lama dan baru secara berdampingan.
| Perubahan model | Sebelum | Sesudah | Perubahan | Kapan |
|---|---|---|---|---|
| GPT-5.6 Luna (pemotongan harga) | $1 / $6 / $0.10 | $0.20 / $1.20 / $0.02 | -80% di semua lini | 2026-07-30 |
| GPT-5.6 Terra (pemotongan harga) | $2.50 / $15 / $0.25 | $2 / $12 / $0.20 | -20% | 2026-07-30 |
| GPT-5.6 Sol (promosi) | $5 / $30 / $0.50 | $4 / $20 / $0.40 | -20% input, -33% output | 2026-08-21 |
| GPT-5.6 Sol daftar ke GPT-6.1 Sol | $5 / $30 / $0.50 | $2 / $10 / $0.10 | -60% input, -67% output, -80% cache | 2026-09-29 |
| GPT-5.6 Luna ke GPT-6 Luna | $0.20 / $1.20 / $0.02 | $0.10 / $0.50 / $0.01 | -50% input, -58% output | 2026-09-22 |
| Claude Opus 5 ke Opus 5.5 | $5 / $25 / $0.50 | $4 / $20 / $0.20 | -20% input/output, -60% cache | 2026-09-22 |
| Claude Fable 5 ke Fable 5.1 | $10 / $50 / $1 | $10 / $50 / $0.25 | -75% hanya cache | September 2026 |
| Claude Sonnet 5 ke Sonnet 5.5 | $2 / $10 / $0.20 | $2 / $10 / $0.10 | -50% hanya cache | September-Oktober 2026 |
| Claude Haiku 4.5 ke Haiku 5.5 | $1 / $5 / $0.10 | $0.10 / $0.50 / $0.01 | -90% (prompt hingga 100K) | Oktober 2026 |
Hanya baris GPT-5.6 yang merupakan pemotongan harga pada model yang sama; sisanya adalah penerus yang lebih murah, sehingga kualitas dan jumlah tokennya berbeda. Harga peluncuran Sonnet 5 sebesar $2/$10 menjadi permanen, dan dokumentasi menyatakan rencana perpindahan ke $3/$15 "tidak akan terjadi". Diskon GPT-5.6 Sol bersifat promosi, "tersedia setidaknya hingga 21 November 2026". Harga Luna dan Terra sebelum pemotongan ada di halaman harga OpenAI yang diarsipkan dari 29 Juli.
Rincian per model: pemotongan harga GPT-5.6, harga GPT-6 Sol, harga Claude Haiku 5.5.
Mengapa harganya turun
Satu-satunya alasan dari pihak pertama berasal dari Anthropic: pengumuman Claude Opus 5.5 menyatakan model tersebut "memerlukan lebih sedikit komputasi untuk melayani dibandingkan Opus 5, dan harganya mencerminkan hal itu", serta memperkirakan biaya 40% lebih rendah pada beban kerja tipikal. Halaman OpenAI tidak memberikan alasan. Sisanya adalah opini:
- Persaingan, biaya peralihan yang rendah. Woolf berargumen bahwa model kini hampir menjadi substitusi satu sama lain: beralih hanya perlu mengganti satu sakelar di harness atau mengganti string model melalui router. Model open-weight yang dilayani banyak penyedia (ia menghitung 29 untuk satu varian DeepSeek Flash di OpenRouter pada 24 Oktober) menetapkan batas bawahnya.
- Balas membalas. Pemotongan harga itu bergantian antara kedua perusahaan, dan keduanya merilis model unggulan yang lebih murah pada 22 September.
- Waktu IPO. Woolf mencatat keduanya dikabarkan mendekati IPO dan menganggap waktunya aneh. Itu spekulasi tentang motif.
- Efisiensi. Banyak komentator HN memberikan penjelasan yang lebih sederhana: caching yang lebih baik, model yang lebih kecil, penyajian yang lebih murah.
Woolf juga mengutip data Vercel AI Gateway: biaya per token turun menjadi 43,3% dari level April 2026 sementara total pengeluaran naik. Token yang lebih murah jarang mengecilkan tagihan kecuali Anda mengubah cara membelanjakannya.
Apa yang berubah akibat pemotongan harga: perhitungan per permintaan
Satu giliran agent yang berat cache
Ambil satu giliran coding agent: 100.000 token percakapan dibaca dari cache, 2.000 token input baru, 1.000 token output.
| Model | Pembacaan cache | Input baru | Output | Biaya per giliran |
|---|---|---|---|---|
| GPT-5.6 Sol (daftar) | $0.050 | $0.010 | $0.030 | $0.090 |
| GPT-5.6 Sol (promosi) | $0.040 | $0.008 | $0.020 | $0.068 |
| GPT-6.1 Sol | $0.010 | $0.004 | $0.010 | $0.024 |
| Claude Opus 5 | $0.050 | $0.010 | $0.025 | $0.085 |
| Claude Opus 5.5 | $0.020 | $0.008 | $0.020 | $0.048 |
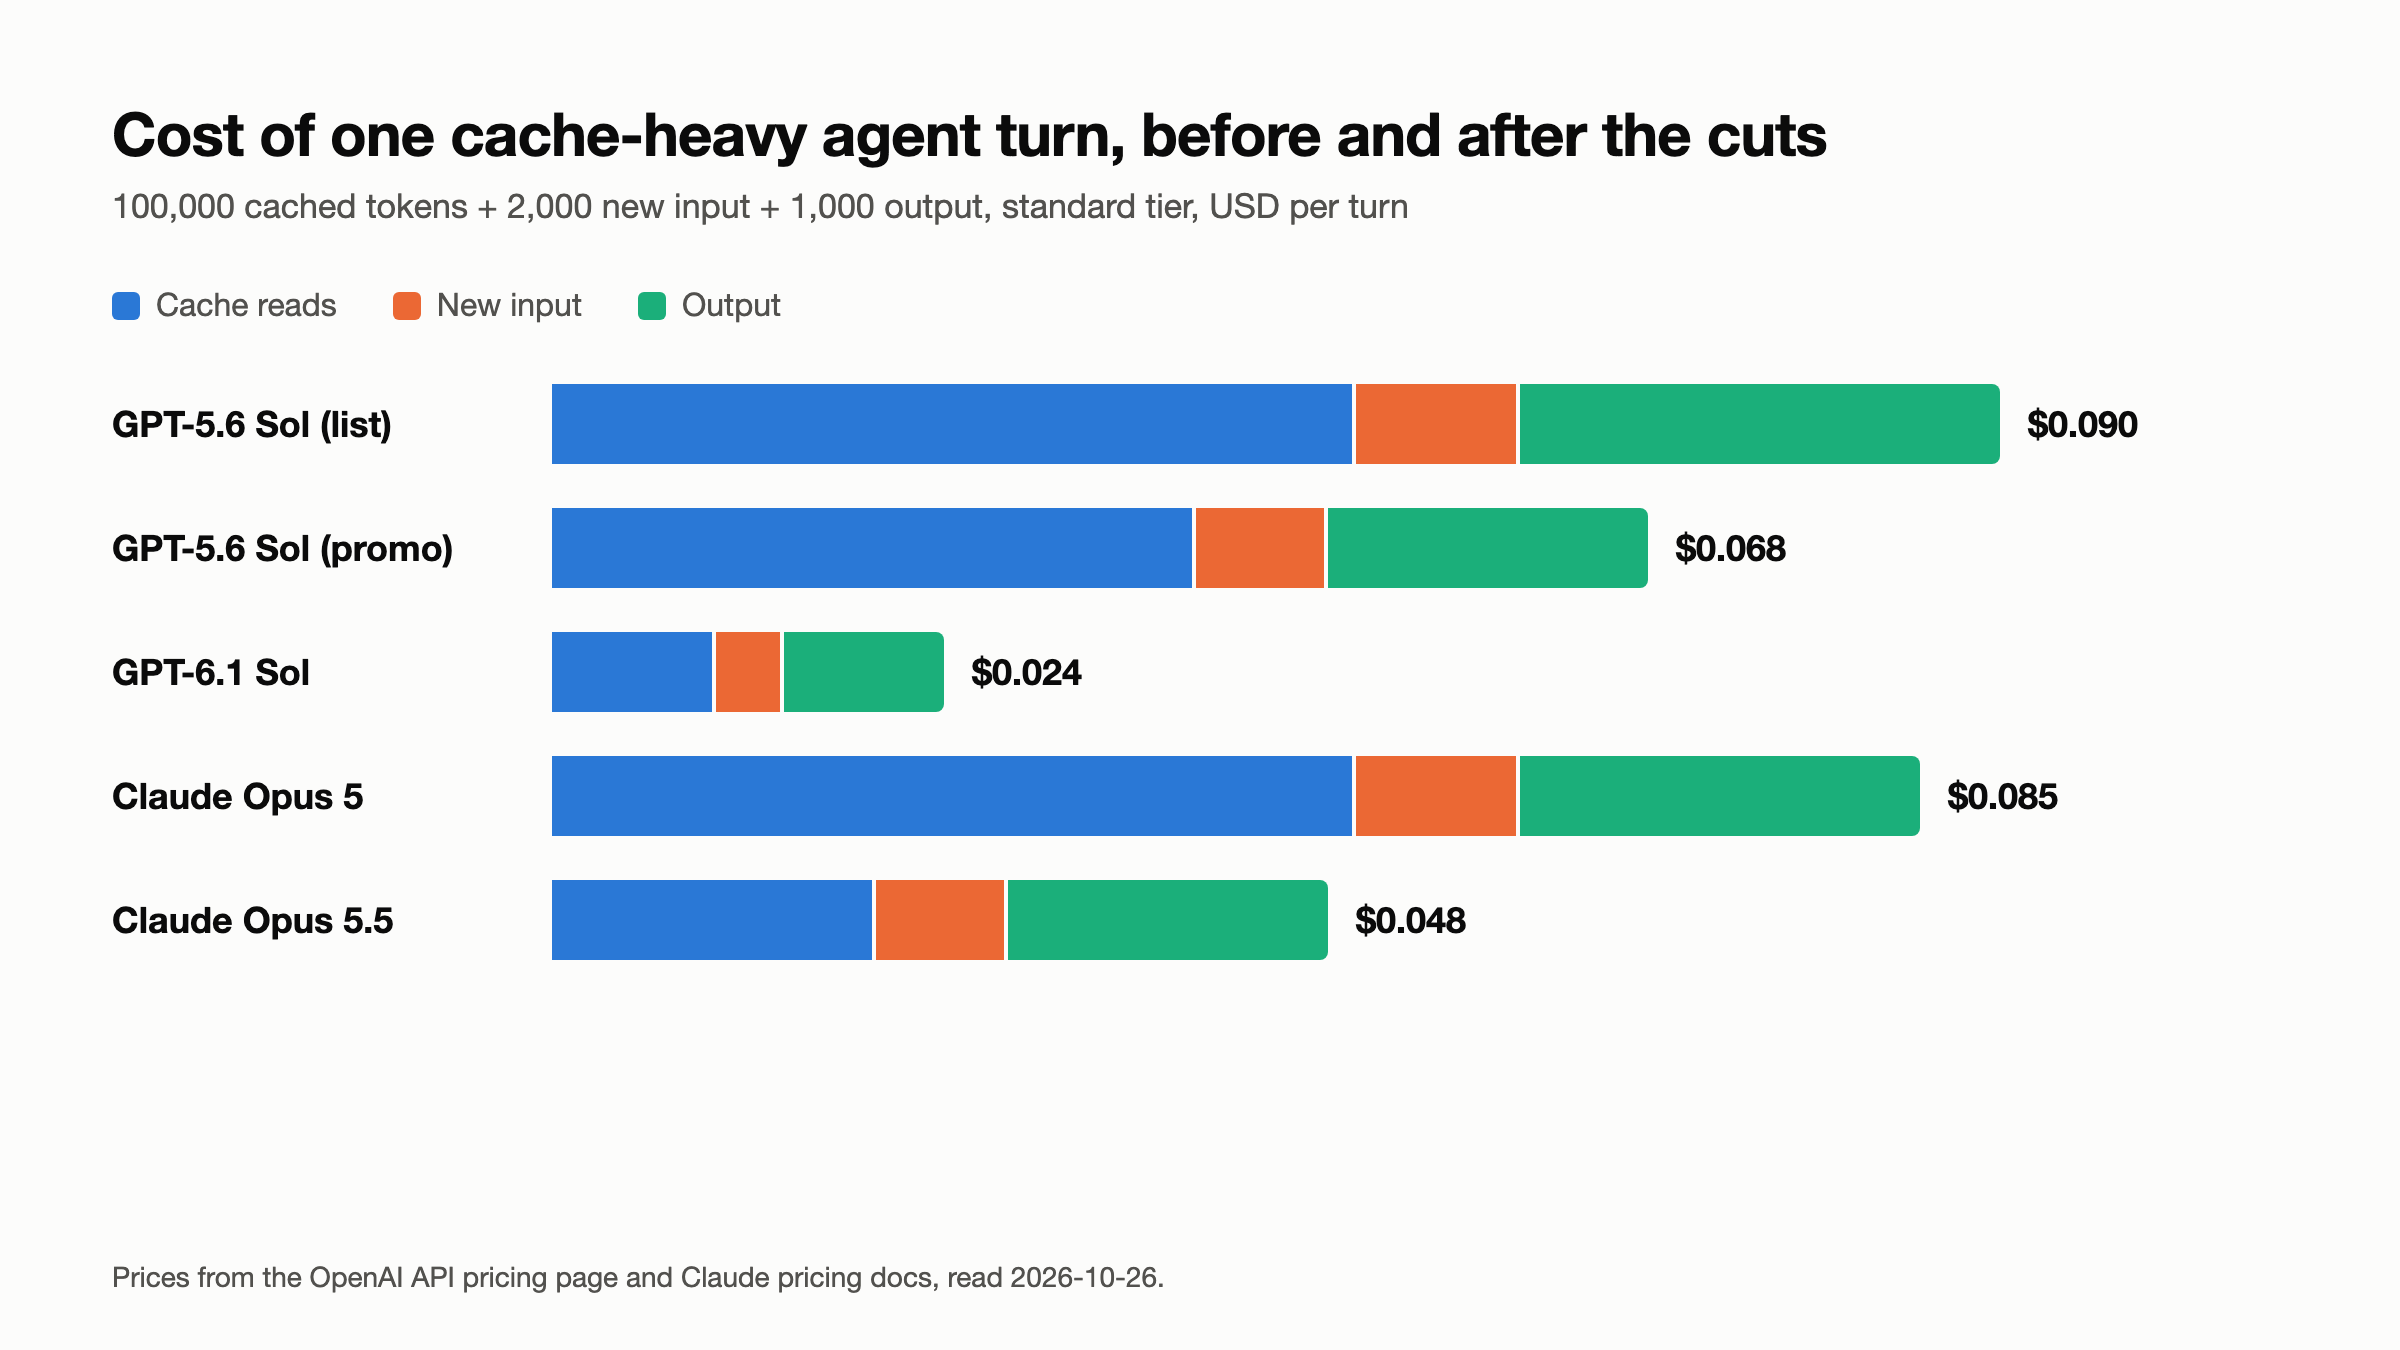
GPT-6.1 Sol berada 73% di bawah harga daftar GPT-5.6 Sol pada giliran ini, dan Opus 5.5 berada 44% di bawah Opus 5, mendekati angka 40% dari Anthropic. Pada model lama, pembacaan cache menghabiskan lebih dari separuh biaya giliran, jadi harga pembacaan cache kini menjadi angka yang penting bagi agent. Itulah sebabnya pemotongan khusus cache pada Fable 5.1 lebih penting daripada kesan dari harga $10/$50 yang tidak berubah. Lihat perhitungan titik impas caching Opus 5.5 dan panduan prompt caching GPT-6 kami.
Yang perlu diubah: peringkatkan model berdasarkan biaya per giliran pada rasio cache-hit nyata Anda, bukan berdasarkan harga input yang terdaftar.
Classifier bervolume tinggi
Sekarang sebuah router atau classifier: 1 juta permintaan sehari, masing-masing 1.500 token input dan 200 token output, tanpa caching.
- GPT-5.6 Luna sebelum 30 Juli: 1,5B input pada $1 ditambah 200M output pada $6 = $2.700/hari
- GPT-6 Luna: $150 + $100 = $250/hari
- Claude Haiku 4.5: $1.500 + $1.000 = $2.500/hari
- Claude Haiku 5.5: $150 + $100 = $250/hari
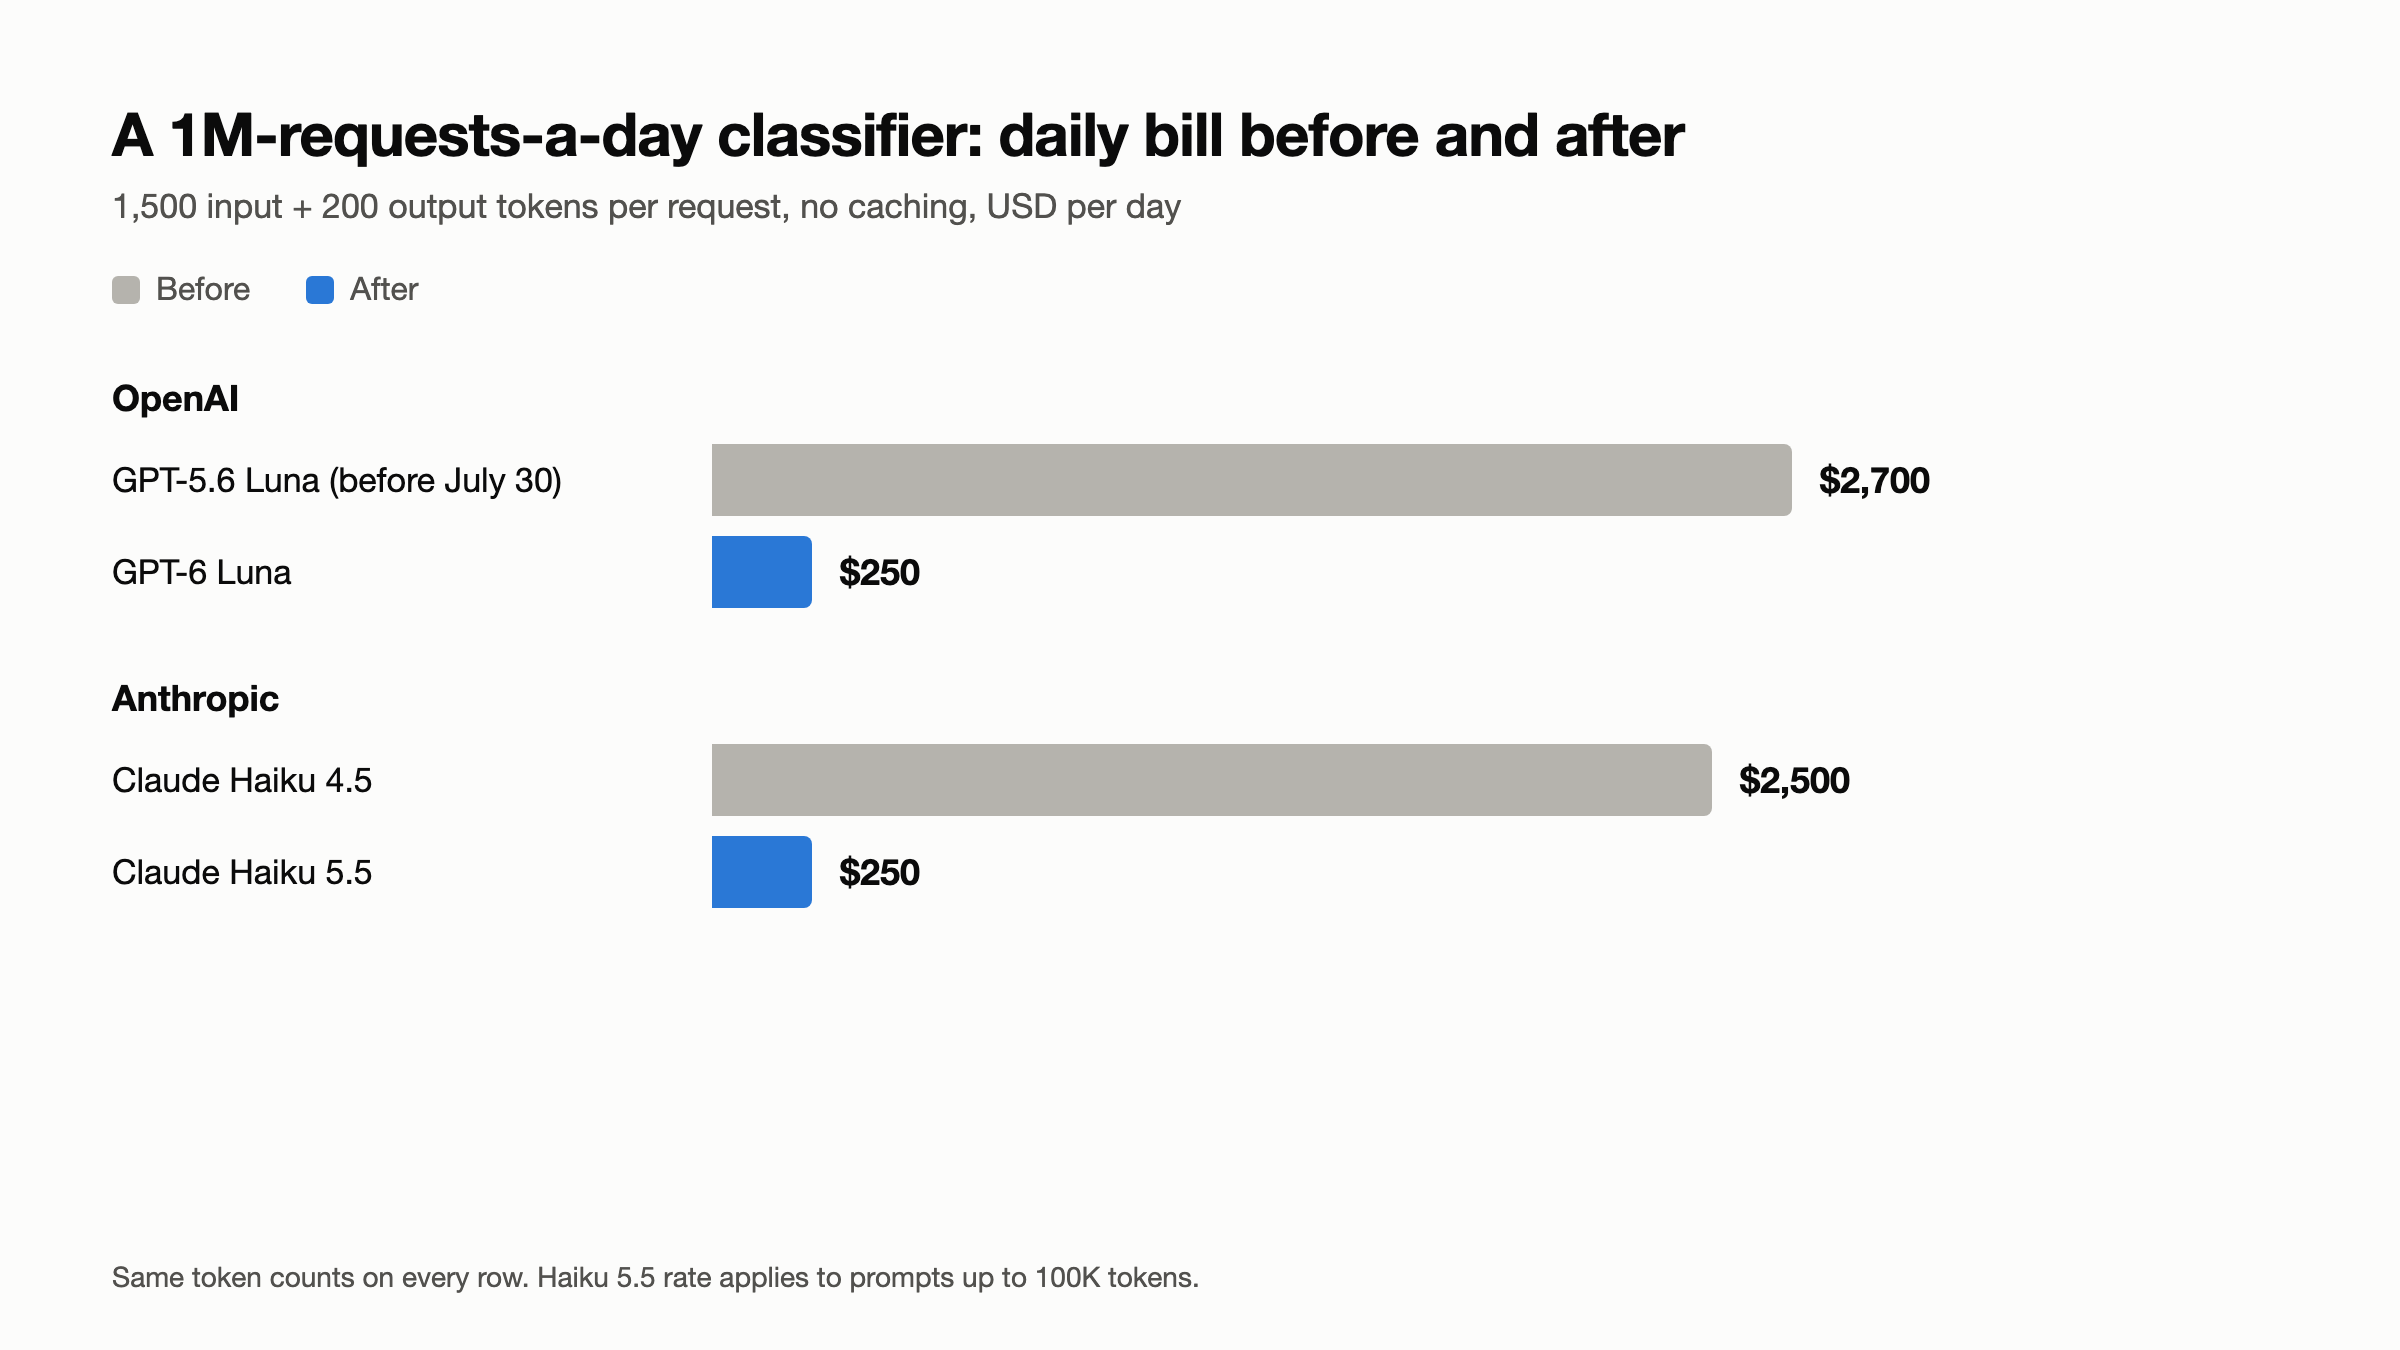
Yang perlu diubah: berhenti memangkas prompt untuk model kecil, dan uji apakah trafik kelas menengah kini cocok dengan model kecil. Jalankan dulu set evaluasi Anda: harga per token tidak mengatakan apa pun tentang akurasi pada data Anda.
Batch: dolar lebih kecil, persentase sama
Keduanya masih memberikan diskon 50% untuk pekerjaan asinkron: Batch API Anthropic memotong separuh input dan output, dan tier Flex/Batch OpenAI memotong separuh semuanya, termasuk input ter-cache (GPT-6.1 Sol: $1 / $5 / $0.05). Pada classifier di atas, batch kini menghemat $125 sehari. Untuk beban kerja kecil, itu mungkin tidak lagi cukup untuk membenarkan infrastruktur antrean tambahan; untuk yang besar, panduan OpenAI Batch API masih berlaku.
Jebakan yang masih membengkakkan tagihan
Penulisan cache lebih mahal daripada input. Anthropic menagih 1,25x input dasar untuk penulisan 5 menit dan 2x untuk penulisan 1 jam. Tabel OpenAI juga memiliki kolom penulisan: 1,25x untuk 30 menit dan 2,5x untuk 12 jam (GPT-6.1 Sol: $2.50 dan $5 dibandingkan input $2). Prefiks yang ditulis tetapi tidak pernah dibaca memakan biaya 25% hingga 150% lebih mahal daripada tanpa cache. Dengan pembacaan sebesar 5% dari input, penulisan singkat balik modal setelah satu kali pembacaan, penulisan panjang setelah dua kali.
Pengali long-context. Pada GPT-6.1 Sol dan GPT-6 Luna, halaman model OpenAI menyatakan prompt di atas 272K token input dikenai harga 2x untuk input dan tarif cache serta 1,5x untuk output "untuk keseluruhan permintaan". Claude Haiku 5.5 melonjak dari $0.10/$0.50 menjadi $0.50/$2.50 di atas 100.000 token prompt, dan Anthropic menghitung pembacaan serta penulisan cache terhadap ambang tersebut. Model Claude 4.6 dan setelahnya menagih seluruh jendela 1M dengan tarif standar. Satu prompt yang kelebihan ukuran pada jalur panas dapat menghapus penghematannya.
Token penalaran adalah token output. Panduan penalaran OpenAI menyatakan token penalaran "ditagih sebagai token output" dan menampilkannya di usage.output_tokens_details.reasoning_tokens. Sebuah respons dapat mencapai max_output_tokens sebelum ada output yang terlihat, dan Anda tetap membayarnya. Dokumentasi biaya thinking Anthropic menagih seluruh proses thinking, bukan ringkasan yang terlihat, yang dilaporkan di usage.output_tokens_details.thinking_tokens. Output adalah sisi mahal dari setiap baris, jadi pengaturan effort dapat menggerakkan tagihan lebih besar daripada pilihan model.
Kenaikan regional. OpenAI menambahkan 10% untuk pemrosesan regional (residensi data) pada model yang dirilis pada atau setelah 5 Maret 2026, dan 10% untuk endpoint FedRAMP. Anthropic menerapkan pengali 1,1x saat Anda menyetel inference_geo: "us", dan endpoint regional di Bedrock serta Google Cloud dikenai premi 10% dibandingkan endpoint global.
Tokenizer dan promo. Dokumentasi Anthropic menyatakan model Claude 4.7 dan setelahnya menggunakan tokenizer yang menghasilkan sekitar 30% lebih banyak token untuk teks yang sama dibandingkan Sonnet 4.6 dan sebelumnya, jadi pada teks yang sama, peralihan Haiku 4.5 ke Haiku 5.5 hasilnya lebih mendekati 87% daripada 90%. Dan jika Anda mematok gpt-5.6-sol untuk mempertahankan tarif promosi, catat 21 November 2026 di kalender Anda.
Biarkan coding agent Anda memasang asersi biaya pada panggilan LLM Anda dengan Apidog CLI
Harga berubah setiap bulan; jumlah token berubah setiap kali seseorang mengedit prompt atau menaikkan pengaturan effort. Perbaikan yang tahan lama adalah pengujian yang gagal saat sebuah panggilan melewati anggaran, dijalankan pada setiap pull request. Biarkan Claude Code, Codex, atau Cursor menulisnya dengan Apidog CLI.
Pasang CLI dan skill agent satu kali:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt kepada agent Anda:
In Apidog project <id>, create an environment "openai" with base URL https://api.openai.com
and an endpoint POST /v1/responses. Add a test case that sends our support-ticket summary
prompt to gpt-6.1-sol and asserts: HTTP 200, usage.output_tokens at most 1500 and
usage.output_tokens_details.reasoning_tokens at most 1000. Use an API key variable,
not a literal. Run it and summarize any failures.
Agent membaca setiap skema payload, memvalidasi sebelum menulis, dan menjalankan kasusnya:
apidog environment create openai --project <id> --base-url https://api.openai.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog test-case category --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Anggaran tersebut disimpan di postProcessors milik kasus sebagai asersi pada JSONPath, dengan perbandingan seperti isAtMost dan isAtLeast dari skema test-case-create:
{
  "type": "assertion",
  "defaultEnable": true,
  "enable": true,
  "data": {
    "name": "output tokens under budget",
    "subject": "responseJson",
    "comparison": "isAtMost",
    "value": "1500",
    "path": "$.usage.output_tokens"
  }
}
Untuk Claude, arahkan endpoint ke /v1/messages dan pasang asersi pada $.usage.output_tokens dan $.usage.output_tokens_details.thinking_tokens. Lalu minta skenario pengujian yang melakukan panggilan yang sama dua kali dan memastikan $.usage.input_tokens_details.cached_tokens (OpenAI) atau $.usage.cache_read_input_tokens (Claude) pada respons kedua bernilai di atas nol: saat seseorang merusak prefiks yang ter-cache, build gagal sebelum faktur tiba. Berikan prompt yang representatif dengan -d, teruskan API key dari secret CI dengan --env-var, dan gunakan -r junit di pipeline Anda (panduan CI/CD). Apidog CLI di Claude Code membahas penyiapan agent.
FAQ
Benarkah OpenAI dan Anthropic memangkas harga hingga 80%? Untuk satu model, ya: GPT-5.6 Luna turun dari $1/$6 menjadi $0.20/$1.20 pada 30 Juli 2026. Sebagian besar penurunan lainnya berasal dari model penerus yang lebih murah.
Apakah pemotongan harga berlaku untuk langganan Claude Code dan Codex? Halaman harga tersebut mencakup API. Woolf mengatakan penghematannya juga sampai ke harness berlangganan, tetapi ia juga melaporkan bahwa OpenAI memangkas separuh jatah penggunaan pada tier Codex seharga $200, jadi periksa batas paket Anda.
Apakah harga GPT-5.6 Sol permanen? Tidak. Itu promosi, setidaknya hingga 21 November 2026. Lagi pula, GPT-6.1 Sol lebih murah.
Apa cara termurah untuk memangkas tagihan agent sekarang? Tingkatkan rasio cache-hit Anda dan turunkan effort penalaran. Pembacaan cache mendominasi sesi panjang, dan penalaran ditagih pada tarif output.
Langkah selanjutnya
Hitung ulang biaya untuk tiga panggilan LLM Anda yang paling sibuk, lalu minta agent Anda menambahkan pengujian anggaran token untuk masing-masingnya. Unduh Apidog untuk memulai.