
NVIDIA telah merilis model speech-to-text open-weight paling akurat di Hugging Face Open ASR Leaderboard, dan Anda bisa menggunakannya secara gratis hari ini. Nemotron 3.5 Transcribe (nama lengkap NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) hadir pada 28 Oktober 2026 di bawah lisensi OpenMDW-1.1, yang mengizinkan penggunaan komersial. Artinya ada tiga jalur $0: Space demo milik NVIDIA sendiri, bobot gratis di GPU Anda sendiri, dan Space komunitas yang membungkus checkpoint yang sama.
Panduan ini membahas setiap jalur gratis, apa yang bisa dan tidak bisa dilakukannya, serta opsi berbayar termurah ketika gratis sudah tidak cukup. Setiap fakta berasal dari kartu model resmi, postingan peluncuran NVIDIA di Hugging Face, dan Open ASR Leaderboard, semuanya dibaca pada 29 Oktober 2026.
Jika Anda hanya membutuhkan API hosted, langsung saja ke panduan API Nemotron 3.5 Transcribe kami.
Apakah Nemotron 3.5 Transcribe gratis?
Ya, dalam dua hal. Bobotnya gratis untuk diunduh dan lisensinya mengizinkan penggunaan komersial maupun non-komersial, jadi self-hosting hanya membutuhkan biaya perangkat keras. NVIDIA juga menjalankan Space demo gratis di Hugging Face tempat Anda bisa mencobanya langsung di browser.
Yang tidak gratis: API hosted. DeepInfra mengenakan biaya $0,002 per menit audio dan OpenRouter mencantumkannya $0,000033 per detik. Keduanya tidak menampilkan varian gratis. Dan per 29 Oktober 2026, model ini belum muncul di build.nvidia.com, tempat banyak model NVIDIA mendapatkan API uji coba gratis. Pencarian di sana untuk "transcribe" hanya mengembalikan satu model ASR bahasa Spanyol yang tidak berkaitan.
Mengapa orang menginginkannya: angkanya
Nemotron 3.5 Transcribe adalah model bahasa yang diperkaya kemampuan bicara (speech-augmented). Encoder ASR berparameter 600M dan encoder speaker memasok ke model bahasa campuran para-ahli (mixture-of-experts) hibrida Mamba-2 dan Transformer. Totalnya berparameter 34B, tetapi hanya sekitar 4,3B yang aktif per token, itulah sebabnya model ini bisa berjalan di satu GPU.
Apa yang dilakukannya dalam satu checkpoint:
- Transkripsi dalam 40 bahasa, dengan 13 di antaranya dinilai "terdepan" (Inggris, Spanyol, Prancis, Jerman, Hindi, Korea, Portugis, dan lainnya)
- Rekaman hingga satu jam dalam satu permintaan (konteks 65.536 token)
- Atribusi pembicara dengan hingga delapan pembicara berlabel
- Timestamp tingkat kata melalui head penyelarasan CTC
- Terjemahan ucapan ke dan dari bahasa Inggris di 31 bahasa
- Context prompting: berikan nama dan jargon agar ejaannya tepat
- Tanya jawab audio (hanya bahasa Inggris)
Di Open ASR Leaderboard, yang diperbarui 28 Oktober 2026, model ini mencetak rata-rata WER 5,33%. Itu menempatkannya di peringkat 9 dari 61 model. Delapan model di atasnya (Otter, Zoom Scribe v2 Pro, ElevenLabs Scribe v2, Azure Speech, dan lainnya) semuanya adalah API berbayar tertutup. Di antara model yang bisa Anda unduh, tidak ada yang berperingkat lebih tinggi. whisper-large-v3 dari OpenAI berada di peringkat 41 dengan 7,16%.
Kartu model NVIDIA sendiri melaporkan WER rata-rata 4,71% pada sembilan set publik. Angka 5,33% dari leaderboard menambahkan dua set privat, jadi kedua angka tersebut jujur; keduanya mengukur campuran yang berbeda.
Satu batasan yang perlu diketahui sebelum memulai: ini model offline. Ia mentranskripsi file rekaman, bukan aliran mikrofon langsung.
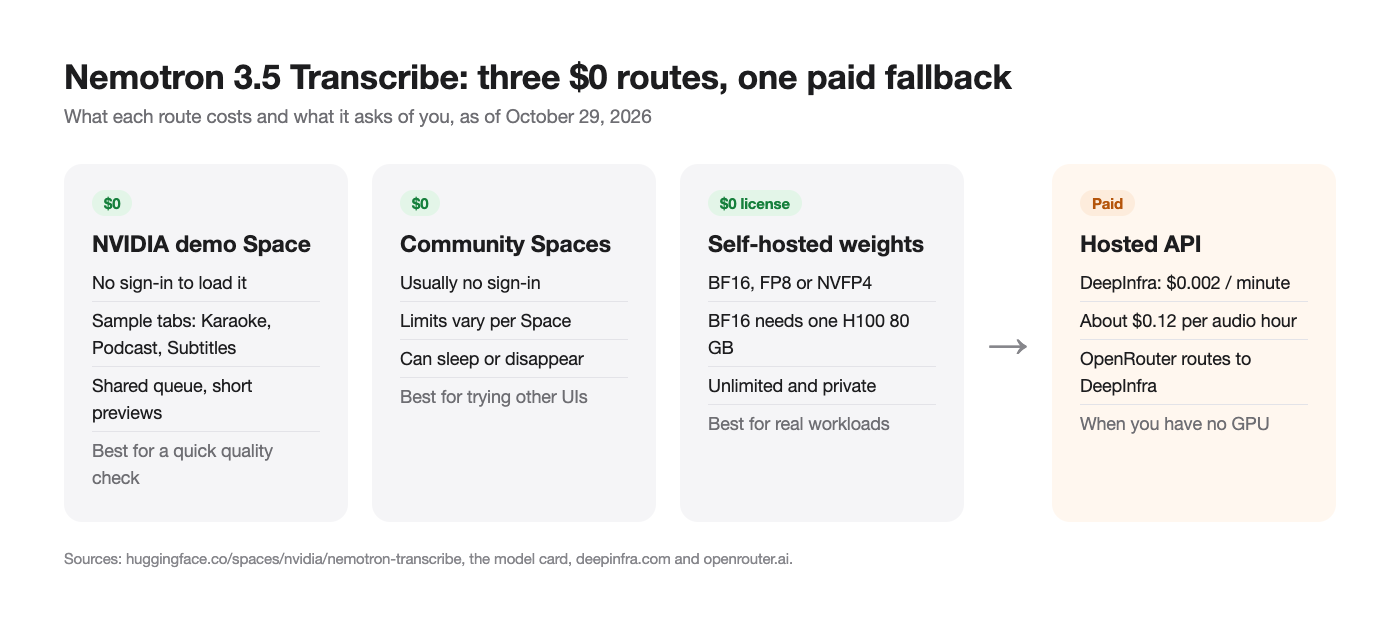
Perbandingan semua jalur gratis dan berbayar
| Jalur | Biaya | Login | Batasan | Terbaik untuk |
|---|---|---|---|---|
Space demo NVIDIA (nvidia/nemotron-transcribe) |
$0 | Tidak | Pratinjau 60 detik pada tab sampel; antrean bersama | Pemeriksaan kualitas cepat |
| Space komunitas | $0 | Biasanya tidak | Berbeda per Space; bisa tidur atau hilang | Mencoba UI lain |
| Bobot self-hosted (BF16, FP8, NVFP4) | Lisensi $0, GPU Anda | Akun Hugging Face untuk mengunduh | Satu H100 80 GB untuk BF16; kartu lebih kecil butuh FP8 atau NVFP4 | Transkripsi privat tanpa batas |
| API DeepInfra | $0,002 per menit | Akun dan API key | Penggunaan berbayar | Produksi tanpa GPU |
| OpenRouter | $0,000033 per detik | Akun dan kredit | Hanya dirutekan ke DeepInfra | Satu key untuk banyak model |
| build.nvidia.com | Belum tercantum | n/a | n/a | Pantau terus |
Hanya tiga baris pertama yang tidak memerlukan biaya.
Jalur gratis 1: Space demo NVIDIA
Cara tercepat untuk mendengar apa yang bisa dilakukan model ini adalah Space resmi NVIDIA di huggingface.co/spaces/nvidia/nemotron-transcribe.
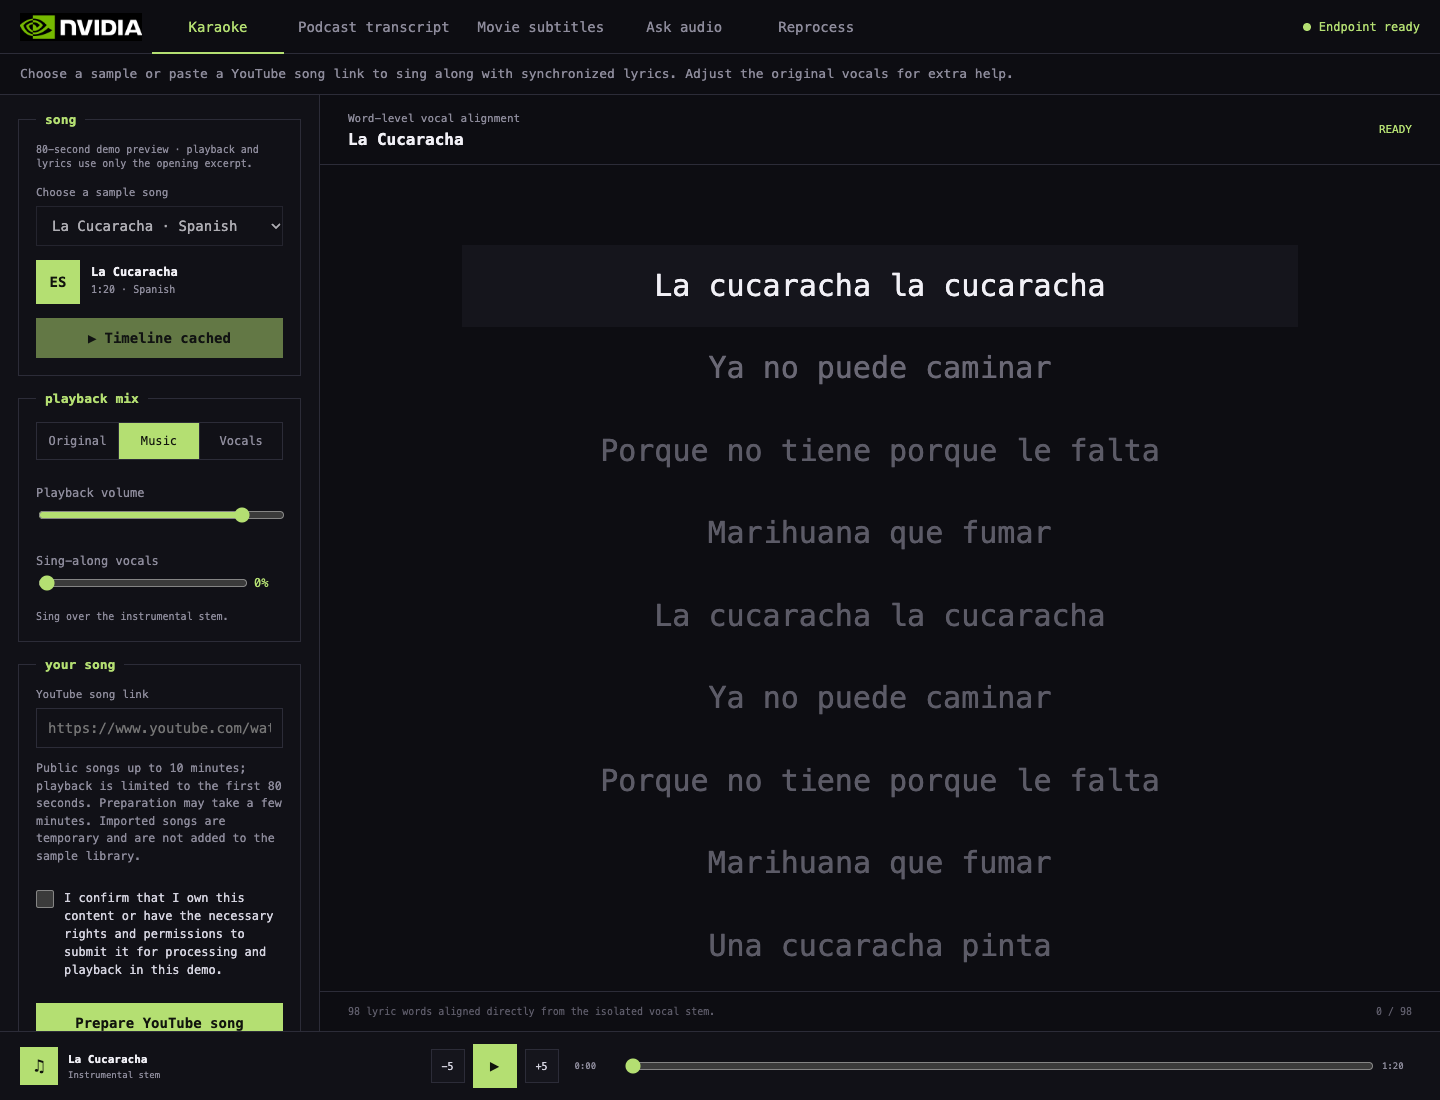
- Buka Space tersebut di browser Anda. Tidak perlu akun untuk memuatnya.
- Pilih tab. Pada 29 Oktober 2026, Space ini memiliki tiga tab: Karaoke (lirik dengan waktu per kata), Podcast transcript (teks dengan atribusi pembicara), dan Movie subtitles (subtitle berwaktu).
- Pilih sampel atau tempel tautan, sesuai yang diizinkan tab tersebut. Tab Karaoke mencatat bahwa pratinjaunya mencakup 60 detik pertama.
- Jalankan dan baca hasilnya. Tampilan Karaoke menyorot setiap kata saat dinyanyikan, yang memperlihatkan kemampuan timestamp tingkat kata.
Perlakukan Space ini sebagai demo, bukan API gratis. Space publik berbagi GPU, mengantrekan permintaan, dan bisa berubah tanpa pemberitahuan. Jangan membangun produk di atasnya.
Jalur gratis 2: jalankan sendiri bobot terbukanya
Inilah tier gratis yang sesungguhnya: transkripsi tanpa batas di perangkat keras yang sudah Anda miliki, tanpa apa pun keluar dari mesin Anda. Lisensinya (OpenMDW-1.1) mengizinkan penggunaan komersial, jadi Anda bisa menyertakannya dalam sebuah produk.
Masalahnya ada pada perangkat keras. Setup referensi NVIDIA adalah satu H100 80 GB dalam BF16. Tabel kompatibilitas pada kartu model mencantumkan:
- BF16: H100, H200, A100 80 GB, B200, GB200, DGX Spark
- FP8: H100, H200, L40S 48 GB
- Hanya NVFP4: RTX 5090 (32 GB) dan RTX PRO 6000 Blackwell
Jadi RTX 5090 konsumen bisa dipakai, dengan checkpoint NVFP4. Kartu 24 GB yang lebih lama seperti RTX 4090 tidak ada dalam daftar.
Tes tercepat hanya memerlukan Transformers yang dipasang dari sumber:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

inputs = processor.apply_transcription_request("meeting.wav").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=True))
Itu cukup untuk beberapa file. Untuk batch, rekaman panjang, dan endpoint yang kompatibel dengan OpenAI, sajikan dengan vLLM 0.32.0 dan plugin NeMo Speech. Panduan langkah demi langkah kami untuk menjalankan Nemotron 3.5 Transcribe secara lokal memuat perintah instalasi dan vllm serve persis dari kartu model.
Tidak punya GPU lokal? Menyewa per jam adalah jalur "hampir gratis" termurah untuk tumpukan pekerjaan besar. NVIDIA menyebut satu RTX PRO 6000 Blackwell dapat memproses 100 jam audio dalam waktu kurang dari tiga menit dengan build NVFP4, meskipun angka itu menggunakan optimasi penyajian yang belum open source.
Jalur gratis 3: Space komunitas
Halaman model mencantumkan beberapa Space komunitas yang dibangun di atas checkpoint yang sama, termasuk hugging-apps/nemotron-3-5-transcribe dan mrfakename/nemotron-3.5-transcribe. Space ini berguna ketika antrean Space NVIDIA panjang atau Anda menginginkan kotak unggah biasa. Space ini dijalankan oleh perorangan, jadi bersiaplah menghadapi mode tidur, kuota, dan tautan mati yang sesekali muncul.
Prompt yang menghasilkan hasil gratis lebih baik
Nemotron 3.5 Transcribe menerima instruksi dalam bahasa sehari-hari. Ini diambil dari kartu model dan daftar DeepInfra. Biarkan system prompt kosong untuk transkripsi dan gunakan temperature 0.
Teks bersih dan mudah dibaca:
Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only.
Siapa mengatakan apa:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Nama produk dan jargon:
Transcribe with punctuation and capitalization. Context terms: Apidog, OpenAPI, Kubernetes, gRPC.
Terjemahan:
Please translate the given speech to English.
Context terms lebih penting dari yang Anda duga. Pada benchmark ContextASR NVIDIA, WER turun dari 3,33% tanpa konteks menjadi 1,71% dengan konteks terperinci.
Ketika gratis tidak cukup: jalur berbayar termurah
Jika Anda tidak memiliki GPU yang didukung dan membutuhkan lebih dari sekadar demo, API hosted itu murah. Dengan tarif DeepInfra $0,002 per menit, rekaman satu jam berbiaya $0,12, dan 1.000 jam berbiaya $120. Tarif OpenRouter $0,000033 per detik setara dengan sekitar $0,119 per jam, dirutekan ke penyedia yang sama.
Permintaan DeepInfra minimal, diambil dari halaman API-nya:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@meeting.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
Responsnya mencakup text, segments dengan waktu mulai dan selesai, words, serta language yang terdeteksi. Panduan API kami membahas key, field respons, dan biaya secara terperinci.
Biarkan coding agent Anda menguji endpoint dengan Apidog CLI
Baik Anda self-host maupun memakai DeepInfra, Anda menginginkan pemeriksaan yang gagal dengan jelas ketika transkripsi kembali kosong atau dalam bahasa yang salah. Serahkan tugas itu kepada coding agent Anda dan Apidog CLI alih-alih memeriksa JSON dengan mata.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
Lalu berikan satu prompt kepada agent Anda:
In Apidog project <id>, create a test case for POST {{baseUrl}}/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
that uploads samples/hello.mp3 as the "audio" form field, asserts status 200, a non-empty "text",
"language" equal to "en", and at least one item in "words", then run it against the
deepinfra environment and summarize any failures.
Agent membaca skema, memvalidasi payload-nya, menulis test case, dan menjalankannya:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Ganti environment agar mengarah ke server lokal Anda saat Anda beralih dari API ke self-hosting. apidog run yang sama dengan -r junit bisa langsung dipasang di CI; lihat menjalankan Apidog CLI di pipeline CI/CD dan Apidog CLI di Claude Code untuk penyiapannya.
Batasan yang perlu diketahui sebelum Anda mengandalkannya
- Hanya offline. Model ini tidak streaming. NVIDIA menunjuk model terpisah, Nemotron 3.5 ASR Streaming, untuk audio langsung.
- Tanya jawab audio hanya bahasa Inggris. Transkripsi mencakup 40 bahasa, tetapi pemahaman audio dan instruksi lisan hanya dievaluasi dalam bahasa Inggris.
- Label pembicara bukan identitas.
<spk:0>berarti "suara pertama," bukan orang dengan nama tertentu. - Output panjang butuh ruang. Percakapan padat selama satu jam dapat menghasilkan sekitar 20.000 token output, jadi atur
max_new_tokenssesuai kebutuhan. - Model ini bisa berhalusinasi. Kartu model memperingatkan bahwa ia mungkin "menghasilkan transkrip yang masuk akal" untuk audio yang tidak jelas. Tinjau apa pun yang bersifat legal atau medis.
FAQ
Apakah Nemotron 3.5 Transcribe gratis untuk penggunaan komersial? Ya. Lisensi OpenMDW-1.1 mengizinkan penggunaan komersial dan non-komersial atas bobotnya. API hosted mengenakan biaya untuk komputasi.
Apakah ada API key Nemotron 3.5 Transcribe gratis? Tidak ada yang kami temukan pada 29 Oktober 2026. DeepInfra dan OpenRouter berbayar, dan model ini belum ada di build.nvidia.com. Bandingkan dengan API gratis NVIDIA untuk Nemotron Nano 12B v2 VL, yang memang mendapatkan endpoint uji coba gratis.
Bisakah saya menjalankannya di Mac? Tidak, dari daftar resminya. Runtime yang didukung menyasar GPU NVIDIA di Linux atau Windows (WSL2). Dukungan GGML hanya tercantum untuk RTX 5090 dan RTX PRO 6000.
Bagaimana perbandingannya dengan Whisper? Pada leaderboard 28 Oktober, rata-ratanya 5,33% WER versus 7,16% untuk whisper-large-v3. Lihat panduan Whisper API kami untuk opsi hosted OpenAI dan peringkat model speech-to-text open-source terbaik kami untuk bidang lengkapnya.
Apakah model ini mendukung MP3? Ya. Ia menerima WAV, FLAC, MP3, OGG, atau apa pun yang ter-decode menjadi PCM mono 16 kHz. Gunakan FFmpeg untuk mengonversi format lain.
Kesimpulan
Nemotron 3.5 Transcribe gratis di bagian yang paling penting: bobotnya, lisensinya, dan demo NVIDIA. Coba Space-nya untuk pemeriksaan kualitas, self-host di H100, L40S, atau RTX 5090 untuk penggunaan privat tanpa batas, dan beralihlah ke DeepInfra seharga $0,12 per jam ketika Anda tidak memiliki perangkat kerasnya. Apa pun jalur yang Anda pilih, biarkan agent Anda menjalankan pemeriksaan Apidog pada endpoint agar transkrip yang buruk tidak pernah sampai ke produksi.