Mentranskripsikan rekaman berdurasi satu jam dengan API Nemotron 3.5 Transcribe baru dari NVIDIA menghabiskan biaya 12 sen. Itu adalah harga DeepInfra sebesar $0,002 per menit untuk model open-weight teratas di Papan Peringkat Open ASR Hugging Face, model yang juga mengembalikan stempel waktu kata, label pembicara, dan bahasa yang terdeteksi dalam panggilan yang sama.
Panduan ini menunjukkan cara mendapatkan kunci API, mengirim permintaan pertama Anda, membaca respons, menulis prompt untuk label pembicara dan jargon, serta menjaga biaya tetap dapat diprediksi. Semua yang ada di bawah ini diperiksa pada 29 Oktober 2026 terhadap halaman model DeepInfra, daftar OpenRouter, dan kartu model resmi.
Mencari rute $0 sebagai gantinya? Baca cara menggunakan Nemotron 3.5 Transcribe secara gratis.
Apa yang Anda dapatkan dari API Nemotron 3.5 Transcribe
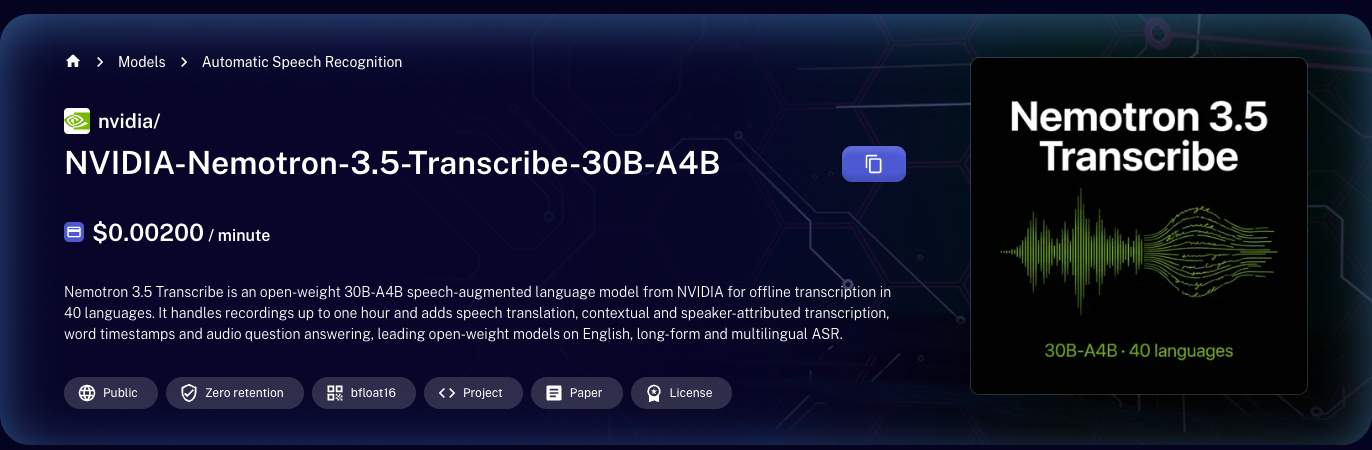
NVIDIA merilis Nemotron 3.5 Transcribe (NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) pada 28 Oktober 2026. Ini adalah model wicara open-weight dengan total 34B parameter dan sekitar 4,3B aktif, dibangun di atas model bahasa campuran ahli Mamba-2 dan Transformer hibrida dengan encoder ASR dan encoder pembicara yang ditambahkan.
Dari satu endpoint Anda mendapatkan:
- Transkripsi dalam 40 bahasa
- File hingga satu jam panjangnya
- Stempel waktu kata dan stempel waktu segmen
- Transkrip yang diatribusikan ke pembicara hingga delapan pembicara
- Terjemahan wicara di 31 bahasa ke dan dari bahasa Inggris
- Prompt konteks untuk nama, produk, dan jargon
- Identifikasi bahasa
Pada Papan Peringkat Open ASR (diperbarui 28 Oktober 2026), model ini rata-rata 5,33% WER, peringkat ke-9 dari 61 model dan pertama di antara model dengan bobot publik. Delapan model di atasnya adalah API komersial tertutup.
Ini adalah model offline. Kirim file rekaman, bukan siaran langsung.
Di mana memanggilnya, dan berapa biayanya
Dengan tarif ini, 1.000 jam audio berbiaya sekitar $120. Sebagai perbandingan, API OpenAI Whisper secara historis mengenakan biaya $0,006 per menit, tiga kali harga DeepInfra, dan whisper-large-v3 berada di peringkat ke-41 pada papan peringkat yang sama dengan 7,16% WER.
Langkah 1: dapatkan kunci API DeepInfra
- Buat akun di deepinfra.com.
- Buka dasbor dan buat kunci API.
- Tambahkan metode pembayaran atau kredit. Halaman model mengharuskan login bahkan untuk demo di browser.
- Ekspor kunci di shell Anda:
export DEEPINFRA_API_KEY="your_key_here"
Jauhkan kunci dari kontrol sumber. Jika Anda bekerja melalui agen coding, letakkan di lingkungan agen, bukan di prompt.
Langkah 2: transkripsikan file pertama Anda
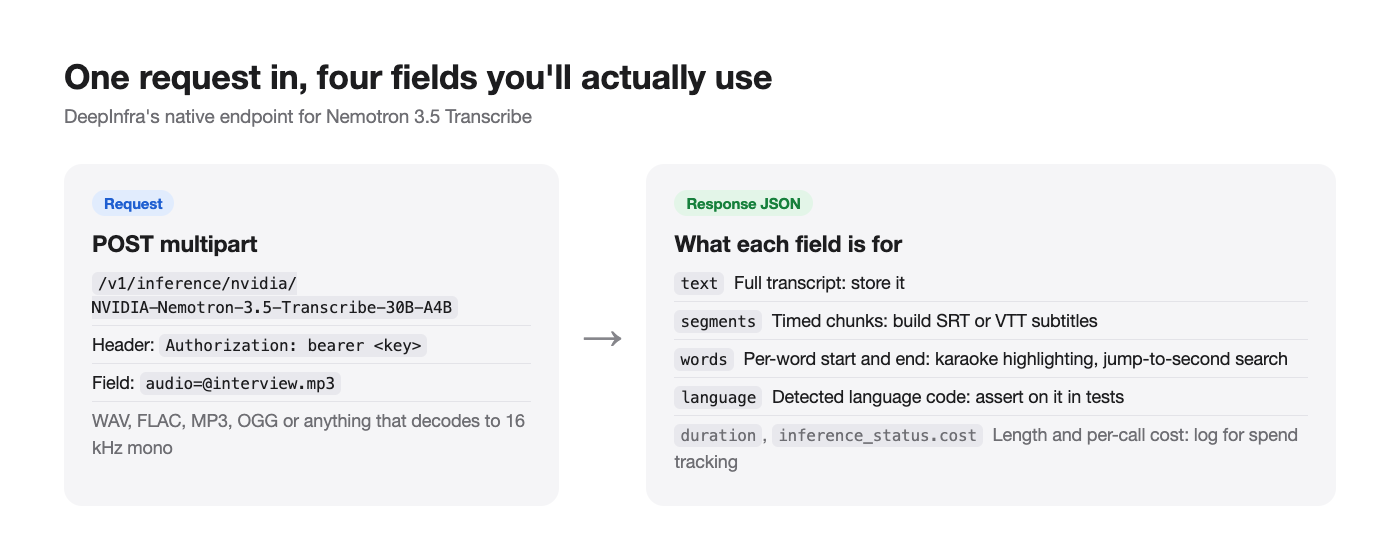
Endpoint inferensi native DeepInfra menerima unggahan multipart dengan bidang audio. Ini adalah bentuk permintaan persis dari halaman API-nya:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@interview.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
Model menerima WAV, FLAC, MP3, OGG, atau format apa pun yang terdekode ke PCM mono 16 kHz. Jika Anda memiliki file M4A atau video, konversikan dengan FFmpeg terlebih dahulu:
ffmpeg -i call.m4a -ar 16000 -ac 1 call.wav
Langkah 3: baca responsnya
DeepInfra mendokumentasikan bentuk respons ini (nilai di bawah ini hanya ilustratif):
{
  "text": "Hello World",
  "segments": [
    { "id": 0, "start": 0.0, "end": 1.0, "text": "Hello" },
    { "id": 1, "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "language": "en",
  "words": [
    { "start": 0.0, "end": 1.0, "text": "Hello" },
    { "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "duration": 5.0,
  "inference_status": { "status": "succeeded", "runtime_ms": 0, "cost": 0.0 }
}
Untuk apa setiap bidang:
textadalah transkrip lengkap. Simpan ini.segmentsmemberikan potongan berwaktu. Gunakan untuk subtitel (SRT atau VTT).wordsmemberikan waktu per kata. Gunakan untuk penyorotan bergaya karaoke atau pencarian yang melompat ke detik yang tepat.languageadalah kode bahasa yang terdeteksi. Lakukan assertion pada ini dalam pengujian; bahasa yang salah adalah kegagalan umum pada klip pendek.inference_status.costmelaporkan berapa biaya panggilan. Catat untuk melacak pengeluaran per file.
Langkah 4: panggil dari Python
import os
import requests

URL = "https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"

def transcribe(path: str) -> dict:
    with open(path, "rb") as f:
        r = requests.post(
            URL,
            headers={"Authorization": f"bearer {os.environ['DEEPINFRA_API_KEY']}"},
            files={"audio": f},
            timeout=600,
        )
    r.raise_for_status()
    return r.json()

result = transcribe("interview.mp3")
print(result["language"], len(result["words"]), "words")
print(result["text"][:500])
Tetapkan timeout yang panjang. Satu jam penuh wicara padat dapat menghasilkan sekitar 20.000 token output, dan kartu model memperingatkan bahwa tugas panjang membutuhkan waktu.
DeepInfra juga mencantumkan tab “OpenAI Speech-to-Text” untuk model ini, sehingga kode OpenAI SDK yang memanggil audio.transcriptions kemungkinan dapat diarahkan ke base URL kompatibel OpenAI milik DeepInfra. Periksa tab tersebut untuk base URL persisnya sebelum mengganti kode produksi.
Prompt: verbatim, bersih, pembicara, jargon
Yang membedakan Nemotron 3.5 Transcribe dari API ASR lama adalah model ini menerima instruksi. Prompt yang direkomendasikan NVIDIA, seperti yang tercantum di halaman DeepInfra:
| Yang Anda inginkan | Instruksi |
|---|---|
| Kata verbatim | Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only. |
| Teks yang mudah dibaca | Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only. |
| Kosakata domain | Transcribe with punctuation and capitalization. Context terms: <names and terms>. |
| Siapa mengatakan apa | Transcribe verbatim, including fillers. ... Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. |
| Terjemahan | Please translate the given speech to <target language>. |
Gunakan temperature 0 dengan reasoning nonaktif untuk transkripsi, terjemahan, dan ID bahasa, dan biarkan system prompt kosong.
Kata konteks membuahkan hasil. NVIDIA melaporkan WER ContextASR-Bench turun dari 3,33% tanpa konteks menjadi 1,71% dengan konteks terperinci, dan Earnings22 kontekstual dari 12,54% menjadi 9,58%. Untuk panggilan pendapatan, berikan nama perusahaan, ticker, dan nama eksekutif.
Periksa tab skema input DeepInfra untuk bidang yang membawa instruksi pada endpoint native. Di server self-hosted, instruksi ditempatkan di pesan chat di samping audio, seperti yang ditunjukkan dalam panduan penyiapan lokal kami.
Menggunakan OpenRouter sebagai gantinya
Jika Anda sudah menggunakan OpenRouter untuk LLM, Anda dapat mempertahankan satu kunci dan satu tagihan. ID modelnya adalah nvidia/nemotron-3.5-transcribe, dengan harga $0,000033 per detik, dan DeepInfra sebagai satu-satunya penyedia yang terdaftar pada 29 Oktober 2026 (uptime 100%, latensi sekitar satu detik saat itu). Salin format permintaan dari tab API model di OpenRouter, karena endpoint audio berbeda dari chat completions.
Trade-off-nya: OpenRouter menambah satu hop jaringan, dan saat ini tidak ada failover penyedia karena hanya satu penyedia yang melayani model tersebut.
Jaga biaya tetap dapat diprediksi
- Pangkas keheningan terlebih dahulu. Anda membayar per menit audio, bukan per menit wicara. Memotong udara mati dari rekaman memangkas tagihan.
- Downmix dan resample. 16 kHz mono adalah yang digunakan model; mengirim stereo 48 kHz hanya menambah waktu unggah.
- Batch per file, bukan per potongan. Model menangani satu jam dalam satu permintaan. Memecah file menjadi potongan 30 detik merusak label pembicara dan konteks.
- Catat
inference_status.cost. Jumlahkan per pelanggan atau per pekerjaan. - Self-host di atas volume stabil. NIM yang dioptimalkan NVIDIA memproses hingga 2.238 detik audio per detik pada satu RTX PRO 6000 Blackwell. Jika Anda mentranskripsikan ribuan jam per bulan, satu GPU sewaan mengalahkan harga per menit. Perhatikan bahwa jalur vLLM sumber terbuka diperkirakan sekitar dua kali lebih lambat daripada angka NIM tersebut.
Biarkan agen coding Anda mengujinya dengan Apidog CLI
API transkripsi gagal secara diam-diam: status 200 dengan text kosong, klip Spanyol terdeteksi sebagai Portugis, atau words hilang setelah pembaruan penyedia. Alih-alih memeriksa JSON secara manual, biarkan agen coding Anda menulis dan menjalankan pemeriksaan dengan Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu beri agen Anda satu prompt:
In Apidog project <id>, add the DeepInfra endpoint POST
https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
with a multipart "audio" field and a bearer token from {{DEEPINFRA_API_KEY}}.
Create a test case per file in samples/ (en.mp3, es.mp3, two-speakers.wav) asserting
status 200, non-empty "text", the expected "language", and "words" length > 0.
Run them against the prod environment and report failures with the response body.
Agen membaca skema, memvalidasi payload-nya, menulis kasus, dan menjalankannya:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Tambahkan -r junit dan perintah yang sama menjadi gerbang CI. Lihat Apidog CLI dalam pipeline CI/CD dan Apidog CLI di Claude Code untuk penyiapan lengkapnya.
FAQ
Berapa harga API Nemotron 3.5 Transcribe? $0,002 per menit di DeepInfra dan $0,000033 per detik di OpenRouter, per 29 Oktober 2026. Itu sekitar $0,12 per jam audio di keduanya.
Apakah ada kunci API gratis? Kami tidak menemukannya. Model ini belum ada di build.nvidia.com. Rute gratisnya adalah Space demo NVIDIA dan self-hosting; lihat panduan gratis.
Berapa panjang file maksimum? Satu jam per permintaan, dengan konteks 65.536 token.
Apakah API melakukan streaming hasil? Tidak. Ini adalah model offline yang mengembalikan transkrip saat file selesai.
Bahasa apa saja yang didukung? 40 bahasa, dinilai dalam tiga tingkatan. 13 bahasa “terdepan” meliputi Inggris, Spanyol, Prancis, Jerman, Italia, Portugis, Hindi, Korea, Rusia, dan Polandia. Jepang, Turki, dan Ukraina “siap produksi.” Mandarin Tionghoa dan Arab “didukung.”
Bagaimana perbandingannya dengan API wicara lainnya? Lihat peringkat model speech-to-text sumber terbuka terbaik kami dan kumpulan API text-to-speech dan speech-to-text teratas yang lebih lama.
Mulai mentranskripsikan
Dapatkan kunci DeepInfra, kirim satu curl dengan MP3, dan Anda akan mendapatkan kembali teks berwaktu dan bertag bahasa seharga $0,002 per menit. Tambahkan kata konteks untuk domain Anda, gunakan prompt pembicara untuk rapat, dan minta agen Anda menjalankan pemeriksaan Apidog pada setiap rilis agar regresi senyap tidak pernah terkirim.