
Bobot terbuka Mistral Large 4 muncul di Hugging Face pada 29 Oktober 2026. Anda mendapatkan model 1,05T parameter yang sama yang disajikan Mistral di API-nya, di bawah lisensi MIT yang dimodifikasi, dalam checkpoint FP8 dan NVFP4 plus kuant GGUF komunitas. Anda dapat mengunduhnya tanpa langkah persetujuan, menyajikannya di 8 GPU pusat data dengan vLLM atau SGLang, atau melewati perangkat keras dan memanggil mistral-large-4 di Mistral API seharga $0,70 per juta token masukan.
Di bawah ini: apa yang berubah sejak pratinjau 6 Oktober, ukuran unduhan, perangkat keras per rute, dan lisensinya. Untuk ringkasan model, baca uraian peluncuran Mistral Large 4 kami; untuk format permintaan dan kode SDK, lihat panduan API Mistral Large 4.
Apa itu bobot terbuka Mistral Large 4?
Bobot terbuka Mistral Large 4 adalah checkpoint yang dapat diunduh dari model unggulan Mistral, dijuluki “Le Chonk.” Ini adalah model mixture-of-experts multimodal dengan total sekitar 1,05T parameter, sekitar 49B aktif per token (52B termasuk embedding dan lapisan keluaran), encoder visi 1,6B, dan jendela konteks 1M token, dirilis di bawah Mistral Ecosystem Open-Weight License.
Kartu model resmi mencantumkan 72 lapisan teks dan 128 ahli routed, dengan 4 dipilih per token plus 1 ahli bersama.
Rilis ini bukan salinan beku dari pratinjau. Pengumuman open-weight Mistral mengatakan model mendapat tiga minggu tambahan reinforcement learning yang berfokus pada coding dan keamanan siber sebelum bobotnya dirilis.
Apa yang berubah sejak pratinjau 6 Oktober
Jika Anda menguji Large 4 selama pratinjau, ada empat hal yang berbeda sekarang.
| Area | Pratinjau 6 Oktober | Rilis terbuka 29 Oktober |
|---|---|---|
| Bobot | Hanya API, bobot dijanjikan nanti | FP8 dan NVFP4 di Hugging Face, tanpa pembatasan |
| Mode penalaran | high atau none |
low, medium, high (default high); low menggantikan none |
| Terminal-Bench 4.0 (dilaporkan Mistral) | 28% | 41%, dengan sekitar 30% lebih sedikit token keluaran |
| Ketahanan serangan B3 Agent Security (dilaporkan Mistral) | 93,3% | 97,1% |
| Harga API per 1 juta token | Ditampilkan dengan diskon pratinjau | $0,70 masukan, $0,07 masukan cache, $2,10 keluaran |
Perubahan penalaran merusak kode. Jika integrasi pratinjau Anda mengirim reasoning_effort: "none", ganti ke "low": posting peluncuran Hugging Face mencatat bahwa Transformers menjalankan none pada high, jadi pengaturan yang usang menghabiskan token alih-alih gagal.
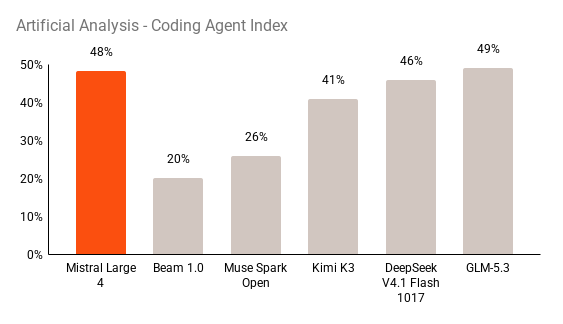
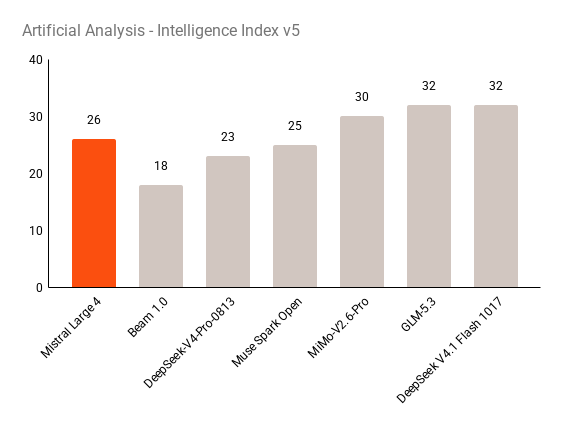
Semua angka benchmark dalam posting ini dilaporkan vendor. Mistral juga mengklaim 19,7% pada benchmark privat FrontierCode 2.0 milik Cognition, skor bobot terbuka teratas dalam grafiknya, dan 48% pada Artificial Analysis Coding Agent Index, kira-kira setara dengan GLM-5.3. Replikasi independen masih tertunda saat kami memeriksa pada 2 November.
Tiga cara menjalankan Mistral Large 4
Anda punya tiga rute, dan yang tepat bergantung pada seberapa banyak perangkat keras yang Anda kendalikan.
- Panggil Mistral API. ID model
mistral-large-4, $0,70 masukan, $0,07 masukan cache, dan $2,10 keluaran per juta token. Tanpa GPU. - Gunakan penyedia terkelola. Mistral mencantumkan OpenRouter, endpoint yang dihosting NVIDIA dan kontainer NIM, serta Microsoft Foundry, yang juga menawarkan deployment privat di Azure.
- Hosting sendiri bobotnya. Unduh dari Hugging Face dan layani dengan vLLM, SGLang, Transformers, atau llama.cpp di mesin Anda sendiri.
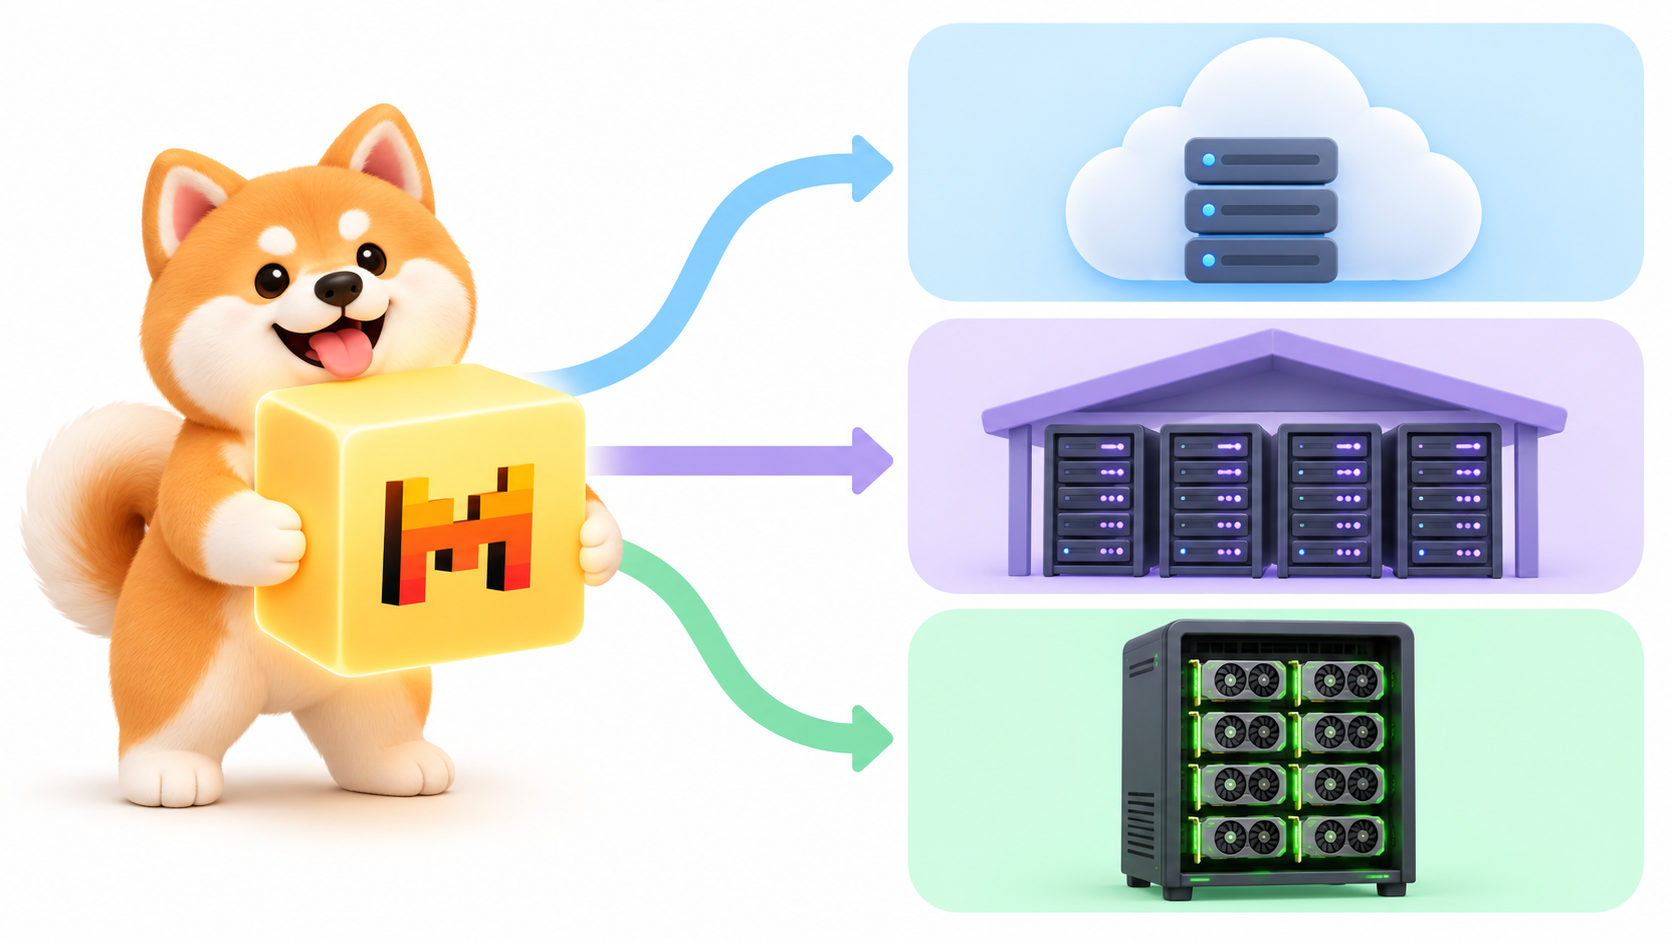
Mulai dari rute 1 atau 2. Pindah ke rute 3 untuk alasan konkret: data yang tidak boleh keluar dari jaringan Anda, fine-tune yang perlu Anda miliki, atau volume yang membuat node 8-GPU tetap sibuk.
Cara mengunduh Mistral Large 4
Repo resmi tidak dibatasi (API Hugging Face melaporkan gated: false untuk keduanya), jadi akun mana pun atau klien anonim dapat menariknya. Ukuran adalah penghalang sebenarnya.
| Repo | Format | Ukuran di disk |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8, resmi | sekitar 1.061 GB |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4, resmi | sekitar 610 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | sekitar 1.115 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | sekitar 635 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | sekitar 381 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | sekitar 298 GB |
Kami menjumlahkan ini dari daftar file setiap repo pada 2 November 2026. Unsloth juga menerbitkan kuant GGUF di bawah unsloth/Mistral-Large-4-1T-A52B-GGUF.
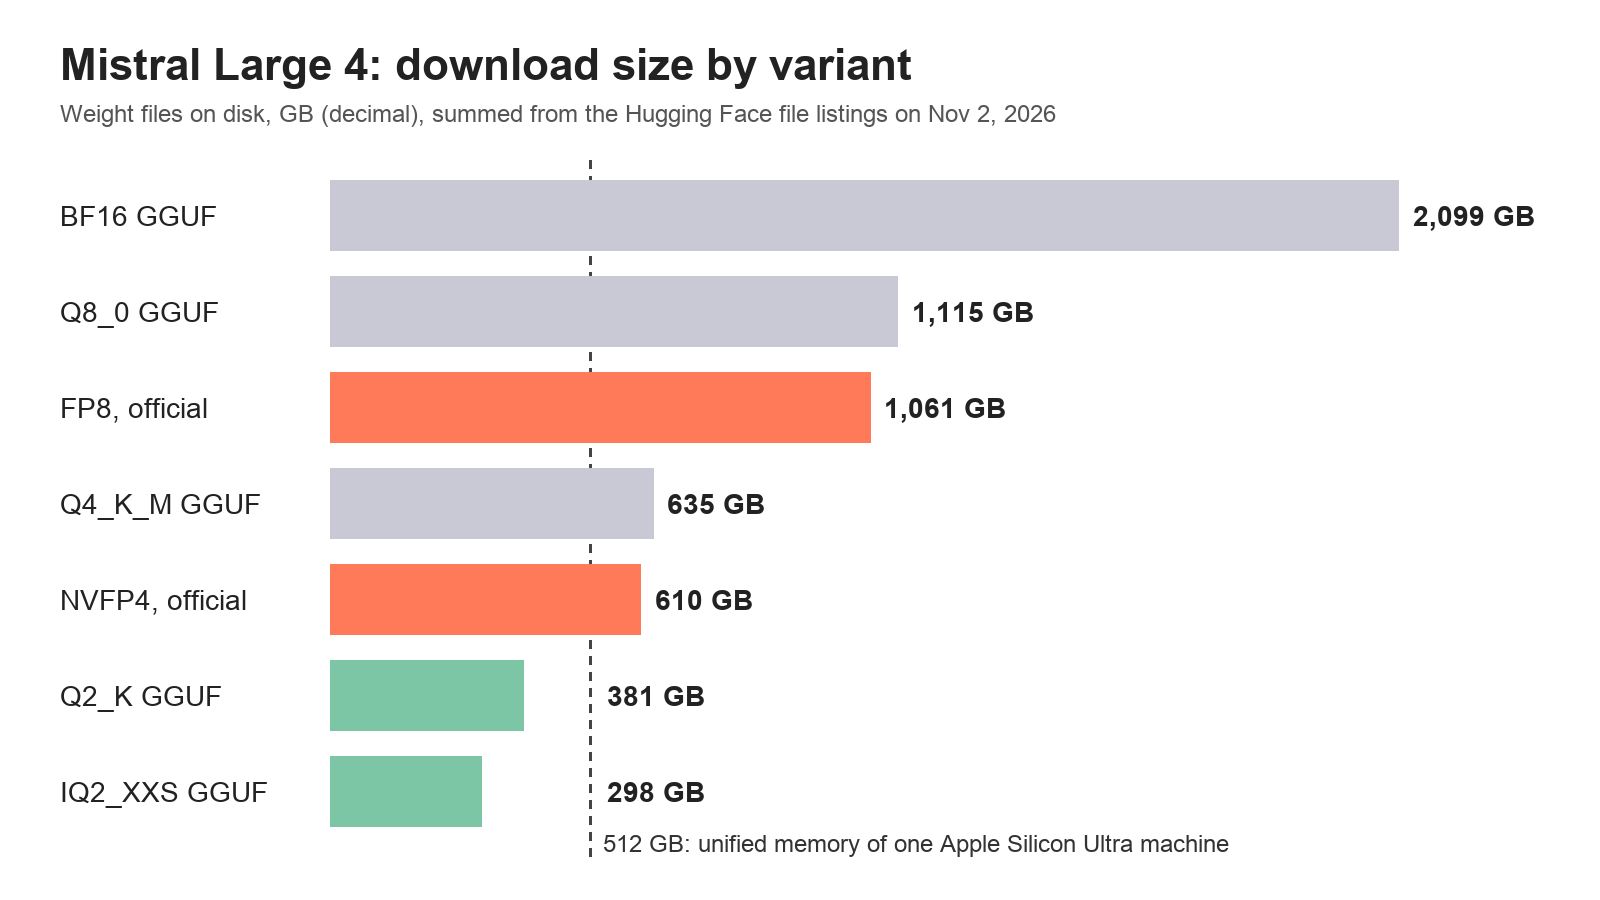
Unduh hanya file yang Anda butuhkan dengan Hugging Face CLI:
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
Unduhan FP8 memakan waktu sedikit lebih dari dua jam pada 1 Gbps berkelanjutan.
Cara melakukan self-host Mistral Large 4
Setiap contoh penyajian resmi mengasumsikan satu node dengan 8 GPU dan paralelisme tensor 8. Berikut yang diharapkan setiap engine.
| Engine | Checkpoint | Perangkat keras dalam contoh resmi |
|---|---|---|
| vLLM | FP8 | 8 GPU, --tensor-parallel-size 8; Hugging Face Inference Endpoints menggunakan 8x H200 |
| vLLM | NVFP4 | 8 GPU NVIDIA Blackwell |
| SGLang | FP8 | 8 GPU, --tp-size 8 |
| Transformers | FP8 | 8 GPU melalui torchrun |
| llama.cpp | Q2_K GGUF | Satu mesin Apple Silicon Ultra dengan memori terpadu 512 GB |
vLLM
Kartu model merekomendasikan vLLM dan menyediakan image Docker khusus:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
Pertahankan kedua flag parser, atau teks berpikir masuk ke content dan panggilan alat datang sebagai teks mentah. Untuk decoding lebih cepat, kartu mendokumentasikan decoder spekulatif DSpark opsional: tambahkan --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'.
Pada 8x H200 dengan drafter itu, Hugging Face mengukur sekitar 65 token per detik untuk satu permintaan dan sekitar 480 token per detik total di 1.000 percakapan ShareGPT di bawah beban.
SGLang juga berfungsi: contoh sglang serve pada kartu model menggunakan --tp-size 8, --speculative-algorithm DSPARK dan parser penalaran serta panggilan alat auto.
llama.cpp di Mac
Tim llama.cpp merilis dukungan day-0. Kuant Q2_K (381 GB) muat di satu mesin Apple Silicon Ultra dengan memori terpadu 512 GB:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
Hugging Face melaporkan sekitar 90 token per detik untuk prefill dan 15 untuk generasi pada satu M3 Ultra: cukup untuk eksperimen privat, lambat untuk loop agen. Kuant 2-bit juga kehilangan kualitas, jadi uji dulu pada tugas Anda sendiri.
Sampling yang direkomendasikan Mistral adalah temperature=1.0 dan top_p=0.95 di setiap tingkat penalaran.
Memanggil model self-hosted Anda
vLLM dan SGLang sama-sama mengekspos server yang kompatibel dengan OpenAI, jadi permintaannya terlihat sama seperti chat completion mana pun:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
Pada API terkelola, kirim body yang sama ke https://api.mistral.ai/v1/chat/completions dengan "model": "mistral-large-4" dan kunci Bearer. Dokumen server kompatibel OpenAI vLLM mencantumkan field yang diterimanya.
Biarkan Claude Code menguji kedua endpoint dengan Apidog CLI
Model self-hosted gagal secara diam-diam: flag parser yang hilang membocorkan penalaran ke content, atau panggilan alat kembali sebagai teks biasa. Biarkan agen coding Anda memeriksa kedua rute dengan Apidog CLI alih-alih menempelkan perintah curl secara manual.
Siapkan sekali:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
Lalu beri Claude Code satu prompt:
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
Agen membaca setiap skema, memvalidasi payload-nya, dan menjalankan kasusnya:
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
Tambahkan --upload-report untuk melihat eksekusi di aplikasi Apidog, atau letakkan baris apidog run ... -r junit yang sama di CI agar upgrade vLLM tidak bisa dirilis dengan panggilan alat yang rusak. Panduan Apidog CLI di Claude Code kami membahas penyiapannya lebih detail. Paket Free Apidog mencakup hingga 4 pengguna.
Lisensi: apa yang bisa dan tidak bisa Anda lakukan
Mistral Ecosystem Open-Weight License adalah MIT dengan satu syarat tambahan.
Anda dapat: menjalankan, men-deploy, fine-tune, dan memodifikasi model serta turunannya, untuk penggunaan komersial dan nonkomersial, selama Anda mempertahankan pemberitahuan hak cipta dan izin dalam salinan.
Anda memerlukan lisensi komersial terpisah dari Mistral jika: Anda menjalankannya sebagai “Model as a Service,” yang didefinisikan lisensi sebagai memberikan pihak ketiga akses ke model atau turunannya untuk inferensi atau pasca-pelatihan.
Syarat itu tidak berlaku untuk: penggunaan internal, produk pengguna akhir tempat model berada di dalam fitur atau harness tertentu, sekadar meneruskan permintaan ke model yang dihosting orang lain, dan penggunaan melalui produk Mistral sendiri.
Asisten coding internal atau fitur produk yang dibangun di atas model tidak masalah; menjual ulang inferensi mentah memerlukan kesepakatan. Ini ringkasan, bukan nasihat hukum.
Untuk panduan serupa tentang model open-weight lain, lihat panduan self-hosting GLM-5.3 kami.
Haruskah Anda self-host atau memanggil API?
Panggil API ketika volume Anda moderat, Anda ingin konteks 1M tanpa menyetel batas server, atau Anda belum menjalankan node 8-GPU. Dengan $0,70 masukan dan $2,10 keluaran per juta token, 100 juta token masukan plus 20 juta token keluaran per bulan menjadi $112, sebelum diskon caching apa pun.
Self-host ketika data Anda tidak boleh keluar dari jaringan, ketika Anda ingin memiliki fine-tune (Hugging Face menunjukkan pelatihan LoRA dengan TRL pada node 8x B300), atau ketika volume stabil membuat node tetap sibuk. Layanan Forge Mistral adalah opsi terkelola untuk tuning pada data Anda sendiri.
FAQ
Apakah bobot terbuka Mistral Large 4 gratis diunduh?
Ya. Kedua repo resmi di Hugging Face tidak dibatasi, jadi Anda dapat mengunduhnya tanpa meminta akses. Biayanya adalah menjalankannya: checkpoint FP8 resmi sekitar 1.061 GB dan contoh penyajian menggunakan 8 GPU pusat data.
Bisakah saya menjalankan Mistral Large 4 di satu GPU?
Tidak ada resep resmi yang mencakup satu GPU. Setiap contoh vLLM, SGLang, dan Transformers menggunakan 8 GPU dengan paralelisme tensor. Penyiapan terkecil yang didokumentasikan adalah llama.cpp dengan kuant Q2_K 381 GB pada satu mesin Apple Silicon Ultra dengan memori terpadu 512 GB.
Apakah Mistral Large 4 open source?
Ini open weight, bukan open source dalam pengertian OSI. Anda mendapatkan bobotnya di bawah lisensi MIT yang dimodifikasi yang mengizinkan penggunaan komersial, tetapi menawarkan model ke pihak ketiga sebagai layanan inferensi atau pasca-pelatihan memerlukan lisensi komersial terpisah dari Mistral.
Apakah model open-weight sama dengan model API?
Mistral mengatakan checkpoint yang dirilis mendapat tiga minggu tambahan reinforcement learning setelah pratinjau 6 Oktober, dan API menyajikan model yang diperbarui sebagai mistral-large-4. Mode penalarannya juga berubah: gunakan low, medium, atau high.
Berapa biaya API Mistral Large 4?
Mistral mencantumkan $0,70 per juta token masukan, $0,07 per juta token masukan cache, dan $2,10 per juta token keluaran, per 2 November 2026.