
Insinyur Mistral AI merancang Magistral Small 1.2 sebagai model berparameter 24 miliar yang memprioritaskan efisiensi penalaran. Versi ini dibangun langsung dari Mistral Small 1.1. Para insinyur menerapkan penyetelan halus yang diawasi (supervised fine-tuning) menggunakan jejak dari Magistral Medium, diikuti oleh tahapan pembelajaran penguatan (reinforcement learning). Akibatnya, model ini unggul dalam logika multi-langkah tanpa tuntutan komputasi yang berlebihan.
Memahami Evolusi Keluarga Model Magistral
Fondasi Arsitektur dan Spesifikasi Teknis
Magistral Small 1.2 dibangun di atas fondasi kuat Magistral 1.1, menggabungkan kemampuan penalaran canggih melalui penyetelan halus yang diawasi (SFT) dari jejak Magistral Medium yang dikombinasikan dengan optimasi pembelajaran penguatan (RL). Dibangun di atas Magistral 1.1, dengan kemampuan penalaran tambahan, menjalani SFT dari jejak Magistral Medium dan RL di atasnya, ini adalah model penalaran kecil dan efisien dengan 24 miliar parameter.
Selain itu, desain arsitektur memungkinkan skenario penerapan yang efisien. Magistral Small dapat diterapkan secara lokal, muat dalam satu RTX 4090 atau MacBook RAM 32GB setelah dikuantisasi. Aksesibilitas ini membuat model cocok untuk lingkungan perusahaan maupun pengembang individu.
Peningkatan Teknis Utama dalam Versi 1.2
Transisi dari versi 1.1 ke 1.2 memperkenalkan beberapa peningkatan penting yang secara signifikan memengaruhi kinerja dan kegunaan model. Yang paling penting, pembaruan ini mengatasi keterbatasan fundamental sekaligus memperluas batas kemampuan.
Terobosan Integrasi Multimodal
Kini dilengkapi dengan encoder visi, model-model ini menangani teks dan gambar dengan mulus. Integrasi ini merepresentasikan pergeseran paradigma dari penalaran berbasis teks murni ke pemahaman multimodal yang komprehensif. Arsitektur encoder visi memungkinkan model untuk memproses informasi visual sambil mempertahankan kemampuan penalaran teks mereka.
Hasil Optimasi Kinerja
Peningkatan 15% pada tolok ukur matematika dan pengkodean seperti AIME 24/25 dan LiveCodeBench v5/v6. Peningkatan kinerja ini secara langsung diterjemahkan ke dalam aplikasi praktis, terutama menguntungkan pengembang yang bekerja pada komputasi matematika, pengembangan algoritma, dan skenario pemecahan masalah yang kompleks.
Analisis Fitur Komprehensif
Kemampuan Penalaran Tingkat Lanjut
Arsitektur penalaran menggabungkan token pemikiran khusus yang menyusun proses penalaran internal model. Implementasi ini menggunakan token [THINK] dan [/THINK] untuk merangkum konten penalaran, menciptakan transparansi dalam proses pengambilan keputusan model sambil mencegah kebingungan selama pemrosesan prompt.
Selain itu, sistem penalaran beroperasi melalui rantai inferensi logis yang diperpanjang sebelum menghasilkan respons akhir. Pendekatan ini memungkinkan model untuk mengatasi masalah kompleks yang membutuhkan analisis multi-langkah, derivasi matematis, dan deduksi logis.
Infrastruktur Dukungan Multibahasa
Model-model ini menunjukkan dukungan bahasa yang komprehensif di berbagai keluarga linguistik. Bahasa yang didukung mencakup wilayah Eropa, Asia, Timur Tengah, dan Asia Selatan, termasuk Inggris, Prancis, Jerman, Yunani, Hindi, Indonesia, Italia, Jepang, Korea, Melayu, Nepal, Polandia, Portugis, Rumania, Rusia, Serbia, Spanyol, Turki, Ukraina, Vietnam, Arab, Bengali, Tiongkok, dan Farsi.
Selain itu, kemampuan multibahasa yang luas ini memastikan aksesibilitas global dan memungkinkan pengembang untuk membuat aplikasi yang melayani pasar internasional tanpa memerlukan implementasi model terpisah untuk bahasa yang berbeda.
Arsitektur Pemrosesan Visi
Integrasi encoder visi memungkinkan analisis dan penalaran gambar yang canggih. Model memproses konten visual dan menggabungkannya dengan informasi tekstual untuk menghasilkan respons yang komprehensif. Kemampuan ini melampaui pengenalan gambar sederhana untuk mencakup pemahaman kontekstual, penalaran spasial, dan pemecahan masalah visual.
Tolok Ukur Kinerja dan Analisis Komparatif
Kinerja Penalaran Matematika
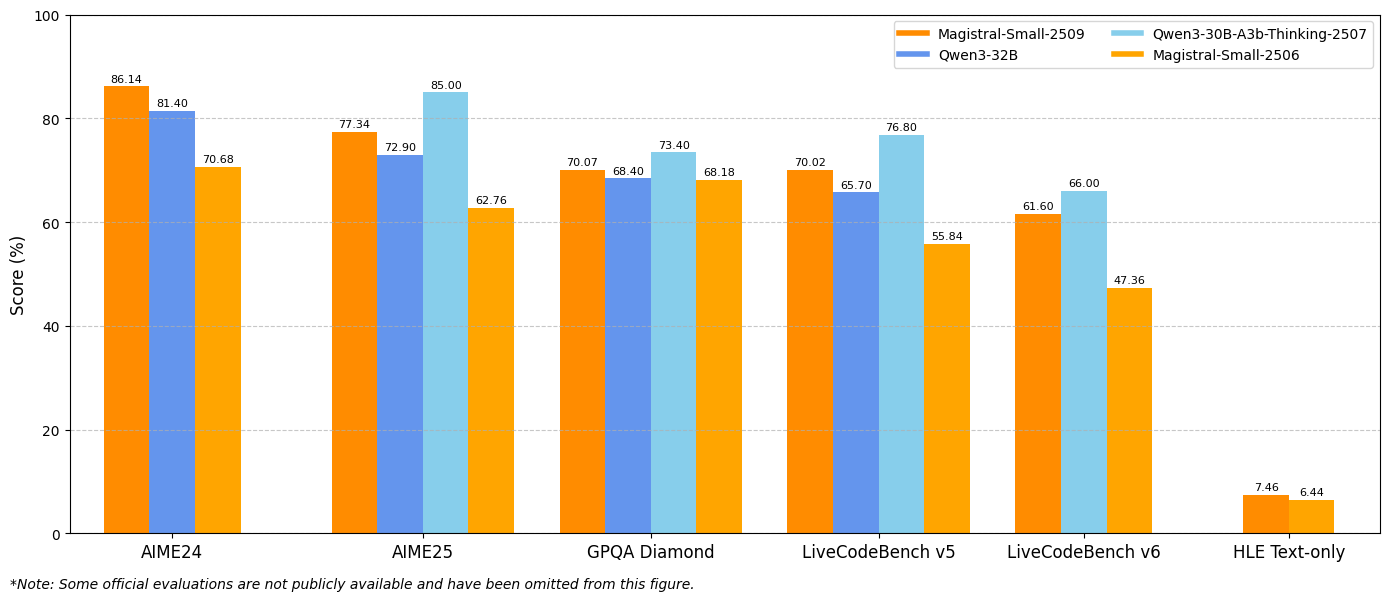
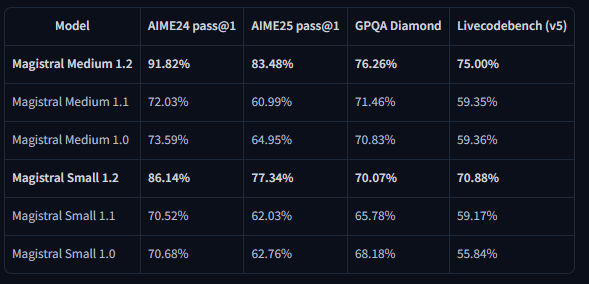
Hasil tolok ukur menunjukkan peningkatan substansial di seluruh metrik evaluasi utama. Magistral Small 1.2 mencapai 86,14% pada AIME24 pass@1 dan 77,34% pada AIME25 pass@1, mewakili kemajuan signifikan dibandingkan versi 1.1 yang masing-masing 70,52% dan 62,03%.
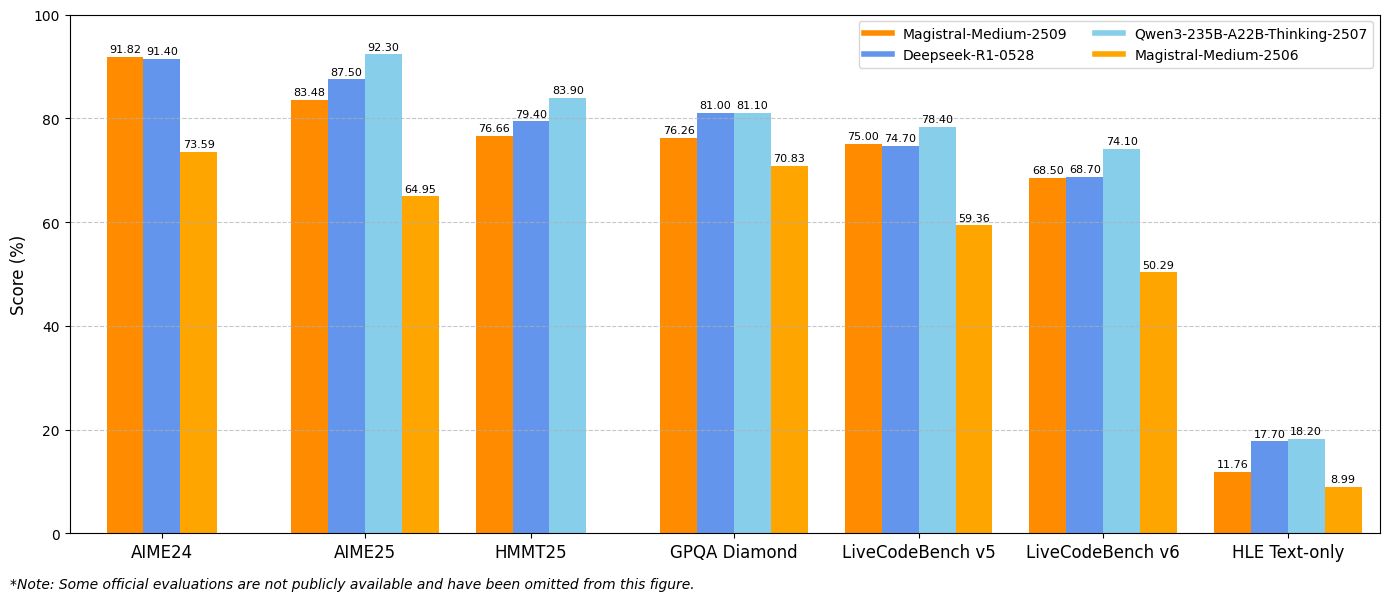
Demikian pula, Magistral Medium 1.2 memberikan kinerja luar biasa dengan 91,82% pada AIME24 pass@1 dan 83,48% pada AIME25 pass@1, melampaui versi 1.1 yang 72,03% dan 60,99%. Peningkatan ini menunjukkan kemampuan penalaran matematika yang ditingkatkan yang secara langsung menguntungkan komputasi ilmiah, aplikasi rekayasa, dan lingkungan penelitian.
Metrik Kinerja Pengkodean
Evaluasi LiveCodeBench menunjukkan peningkatan kemampuan pengkodean yang substansial. Magistral Small 1.2 memperoleh skor 70,88% pada LiveCodeBench v5, sementara Magistral Medium 1.2 mencapai 75,00%. Skor-skor ini merepresentasikan kemajuan berarti dalam tugas-tugas pembuatan kode, debugging, dan implementasi algoritma.
Selain itu, model-model ini menunjukkan pemahaman yang lebih baik tentang konsep pemrograman, pola arsitektur perangkat lunak, dan metodologi debugging. Kinerja pengkodean yang ditingkatkan ini menguntungkan tim pengembangan perangkat lunak, kerangka kerja pengujian otomatis, dan lingkungan pemrograman edukasi.
Hasil GPQA Diamond
Hasil tolok ukur General Purpose Question Answering (GPQA) Diamond menunjukkan kemampuan aplikasi pengetahuan model yang luas. Magistral Small 1.2 mencapai 70,07%, sementara Magistral Medium 1.2 mencapai 76,26%. Skor-skor ini mencerminkan kemampuan model untuk menangani berbagai jenis pertanyaan yang membutuhkan pengetahuan dan penalaran interdisipliner.
Strategi Implementasi dan Integrasi
Konfigurasi Lingkungan Pengembangan
Mengimplementasikan Magistral Small 1.2 dan Magistral Medium 1.2 memerlukan konfigurasi teknis spesifik untuk mengoptimalkan kinerja. Parameter sampling yang direkomendasikan meliputi top_p: 0.95, temperature: 0.7, dan max_tokens: 131072. Pengaturan ini menyeimbangkan kreativitas dengan konsistensi sambil mendukung urutan penalaran yang diperpanjang.
Selain itu, model-model ini mendukung berbagai kerangka kerja penerapan termasuk vLLM, Transformers, llama.cpp, dan format kuantisasi khusus. Fleksibilitas ini memungkinkan integrasi di berbagai lingkungan komputasi dan kasus penggunaan.
Integrasi API dengan Apidog
Apidog menyediakan alat komprehensif untuk menguji dan mengintegrasikan API Magistral ke dalam aplikasi Anda. Platform ini mendukung skenario pengujian API canggih, termasuk penanganan input multimodal, analisis jejak penalaran, dan pemantauan kinerja. Melalui antarmuka Apidog, pengembang dapat secara efisien menguji kombinasi gambar-teks, memvalidasi keluaran penalaran, dan mengoptimalkan parameter panggilan API.
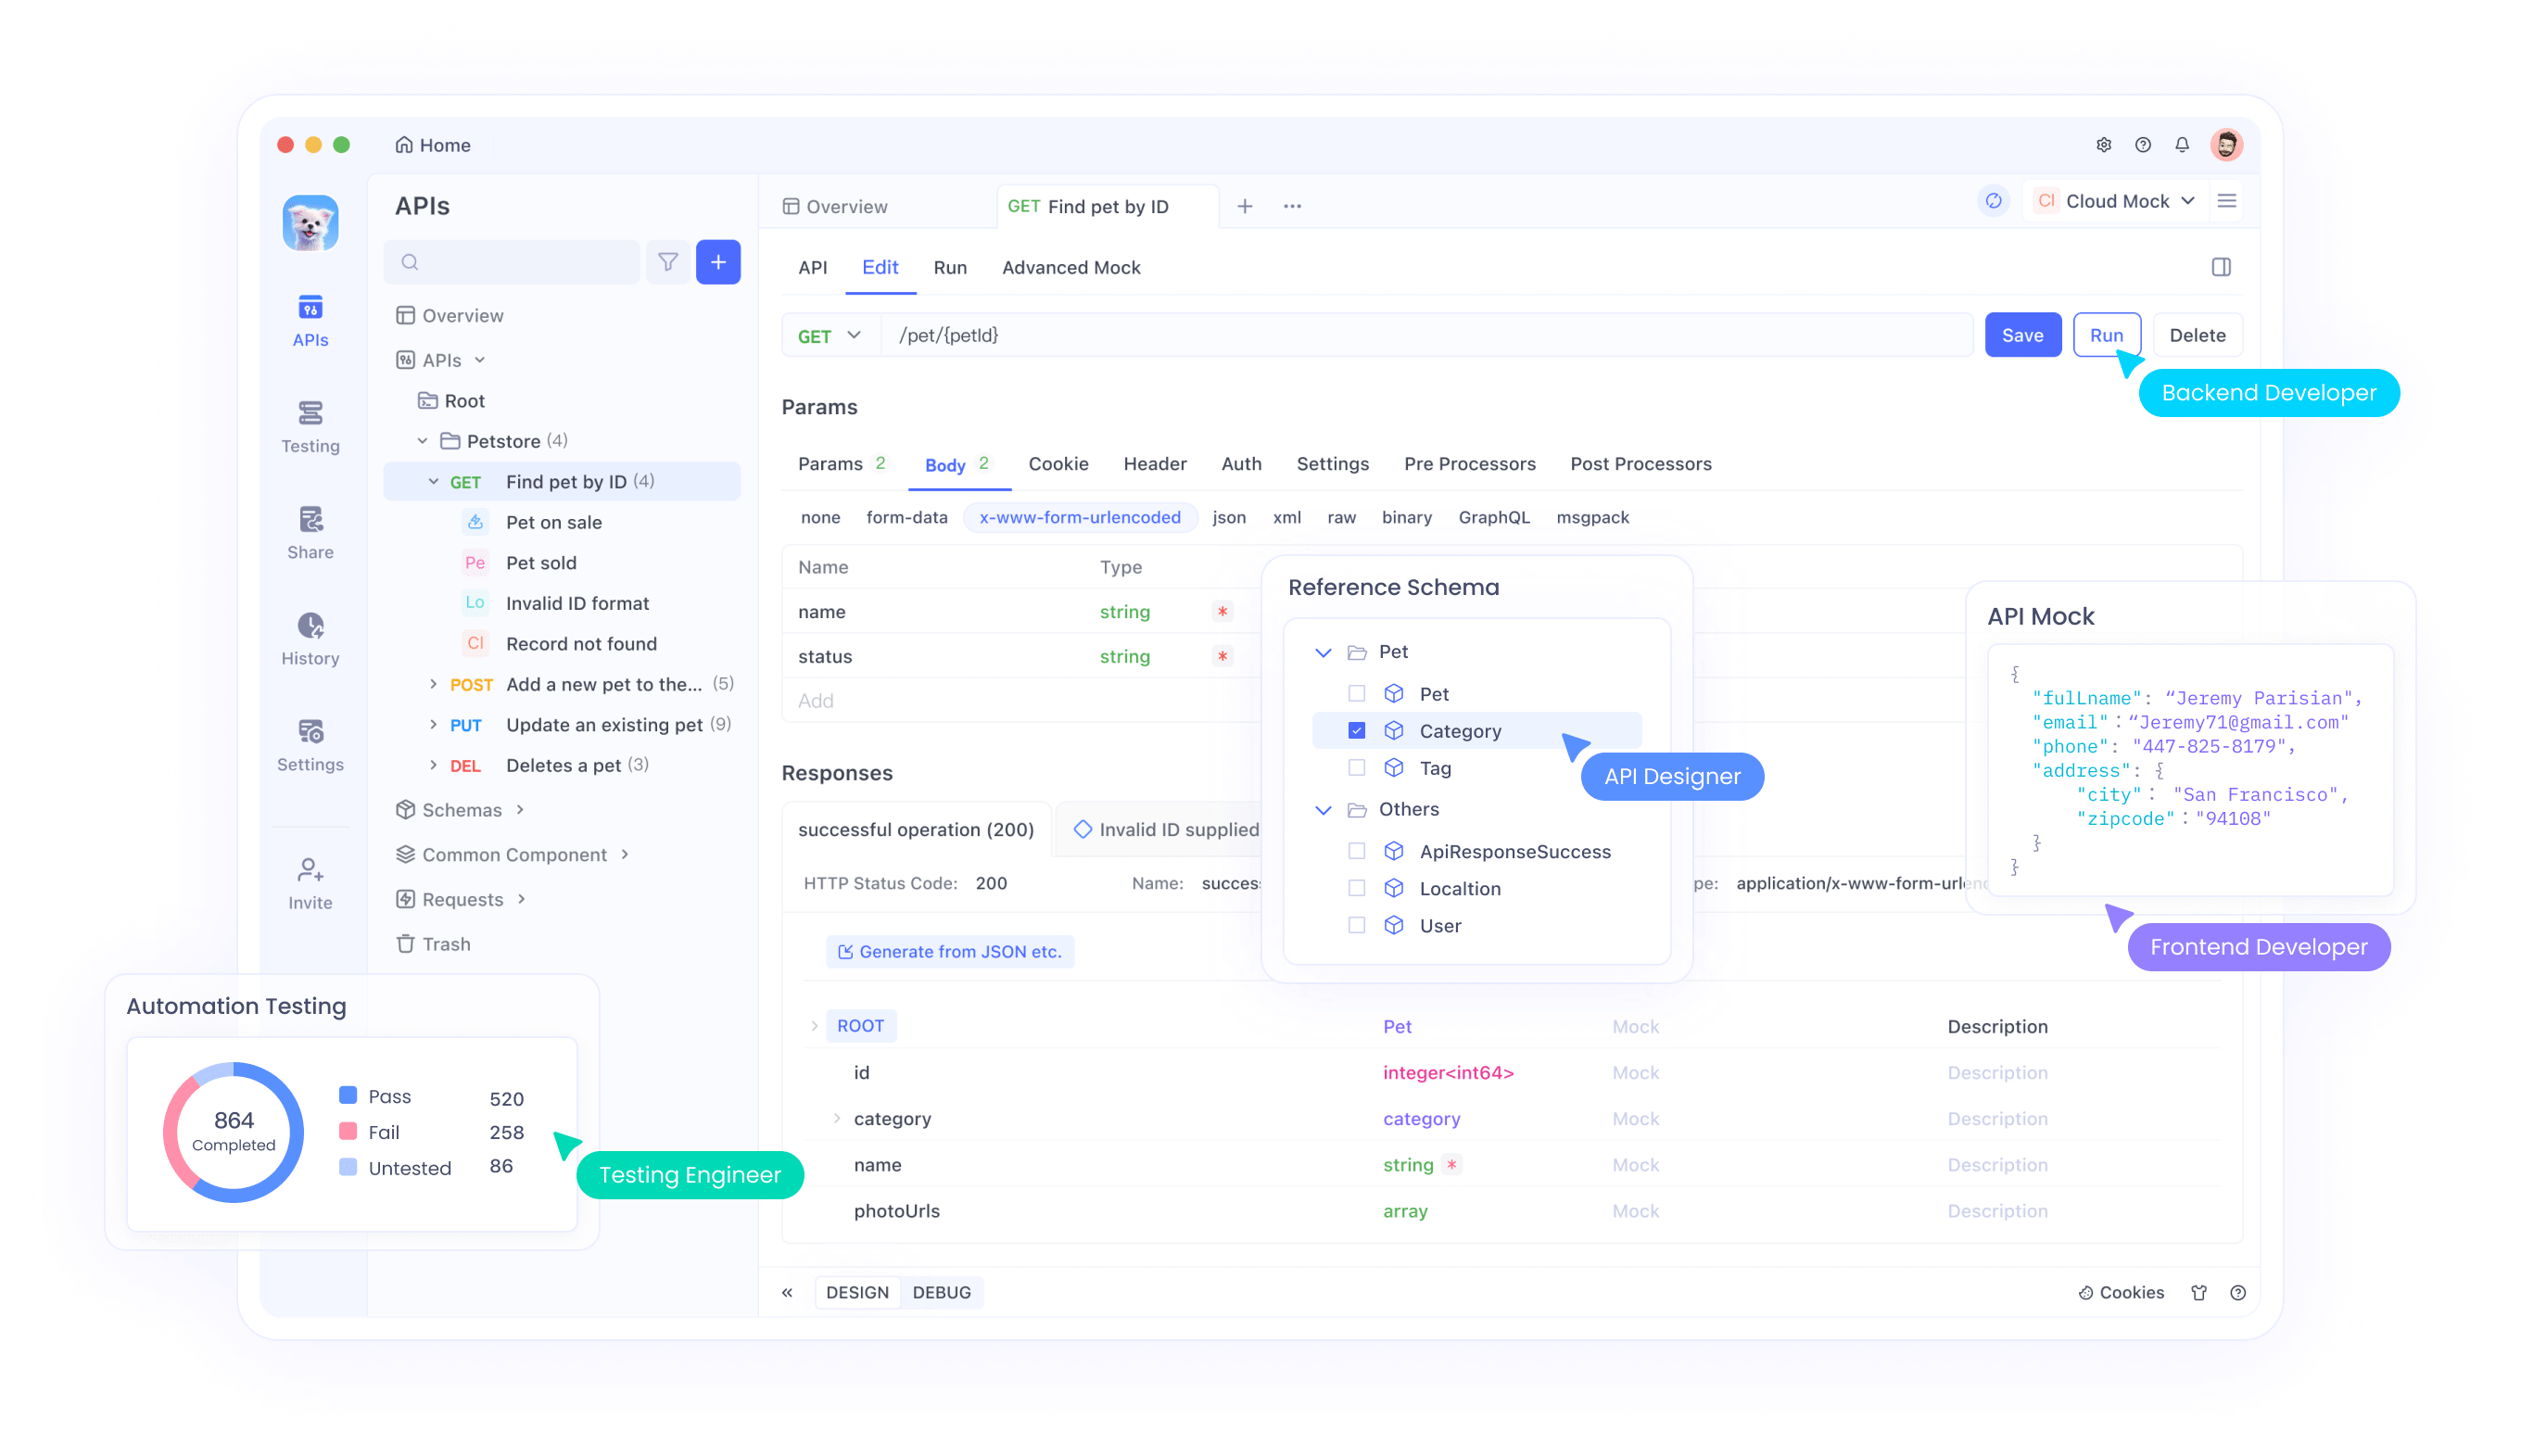
Selain itu, fitur kolaborasi Apidog memungkinkan tim untuk berbagi konfigurasi pengujian API, mendokumentasikan pola integrasi, dan mempertahankan standar pengujian yang konsisten di seluruh siklus pengembangan. Pendekatan kolaboratif ini mempercepat jadwal pengembangan sambil memastikan implementasi API yang kuat.
Optimasi Prompt Sistem
Model-model ini memerlukan prompt sistem yang dirancang dengan cermat untuk mencapai kinerja optimal. Struktur prompt sistem yang direkomendasikan mencakup instruksi penalaran, pedoman pemformatan, dan spesifikasi bahasa. Prompt harus secara eksplisit meminta proses berpikir menggunakan token khusus sambil mempertahankan pemformatan respons yang konsisten.
Selain itu, kustomisasi prompt sistem memungkinkan optimasi spesifik aplikasi. Pengembang dapat memodifikasi prompt untuk menekankan pola penalaran tertentu, menyesuaikan format keluaran, atau menggabungkan persyaratan pengetahuan khusus domain.
Pendalaman Implementasi Teknis
Persyaratan Memori dan Komputasi
Magistral Small 1.2 beroperasi secara efisien dalam lingkungan perangkat keras yang terbatas sambil mempertahankan kinerja tinggi. Arsitektur berparameter 24 miliar memungkinkan penerapan pada perangkat keras kelas konsumen ketika dikuantisasi dengan benar, membuat kemampuan penalaran canggih dapat diakses oleh pengembang individu dan tim kecil.
Selain itu, peningkatan efisiensi komputasi pada versi 1.2 mengurangi latensi inferensi sambil mempertahankan kualitas penalaran. Optimasi ini memungkinkan aplikasi real-time dan sistem interaktif yang memerlukan pembuatan respons segera.
Jendela Konteks dan Kemampuan Pemrosesan
Model-model ini mendukung jendela konteks 128.000 token, memungkinkan pemrosesan dokumen ekstensif, percakapan kompleks, dan tugas analitis skala besar. Meskipun kinerja dapat menurun di atas 40.000 token, model-model ini mempertahankan fungsionalitas yang wajar di seluruh rentang konteks penuh.
Selain itu, kemampuan konteks yang diperluas memungkinkan analisis dokumen komprehensif, tugas penalaran bentuk panjang, dan percakapan multi-giliran dengan kesadaran konteks yang terjaga. Kapasitas ini mendukung aplikasi perusahaan yang memerlukan pemrosesan informasi ekstensif.
Teknik Kuantisasi dan Optimasi
Model-model ini mendukung berbagai format kuantisasi melalui implementasi GGUF, memungkinkan penerapan di berbagai konfigurasi perangkat keras. Optimasi ini mengurangi persyaratan memori sambil mempertahankan kemampuan penalaran, membuat model dapat diakses di lingkungan dengan sumber daya terbatas.
Selain itu, teknik optimasi khusus mempertahankan kecepatan inferensi sambil mendukung operasi penalaran yang kompleks. Peningkatan teknis ini memastikan kelayakan penerapan praktis di berbagai lingkungan komputasi.
Pengujian dan Validasi dengan Apidog
Strategi Pengujian API Komprehensif
Apidog menyediakan alat penting untuk memvalidasi integrasi model Magistral melalui kerangka kerja pengujian komprehensif. Platform ini mendukung pengujian input multimodal, validasi jejak penalaran, dan tolok ukur kinerja. Tim dapat membuat rangkaian pengujian yang memverifikasi kebenaran fungsional dan karakteristik kinerja.
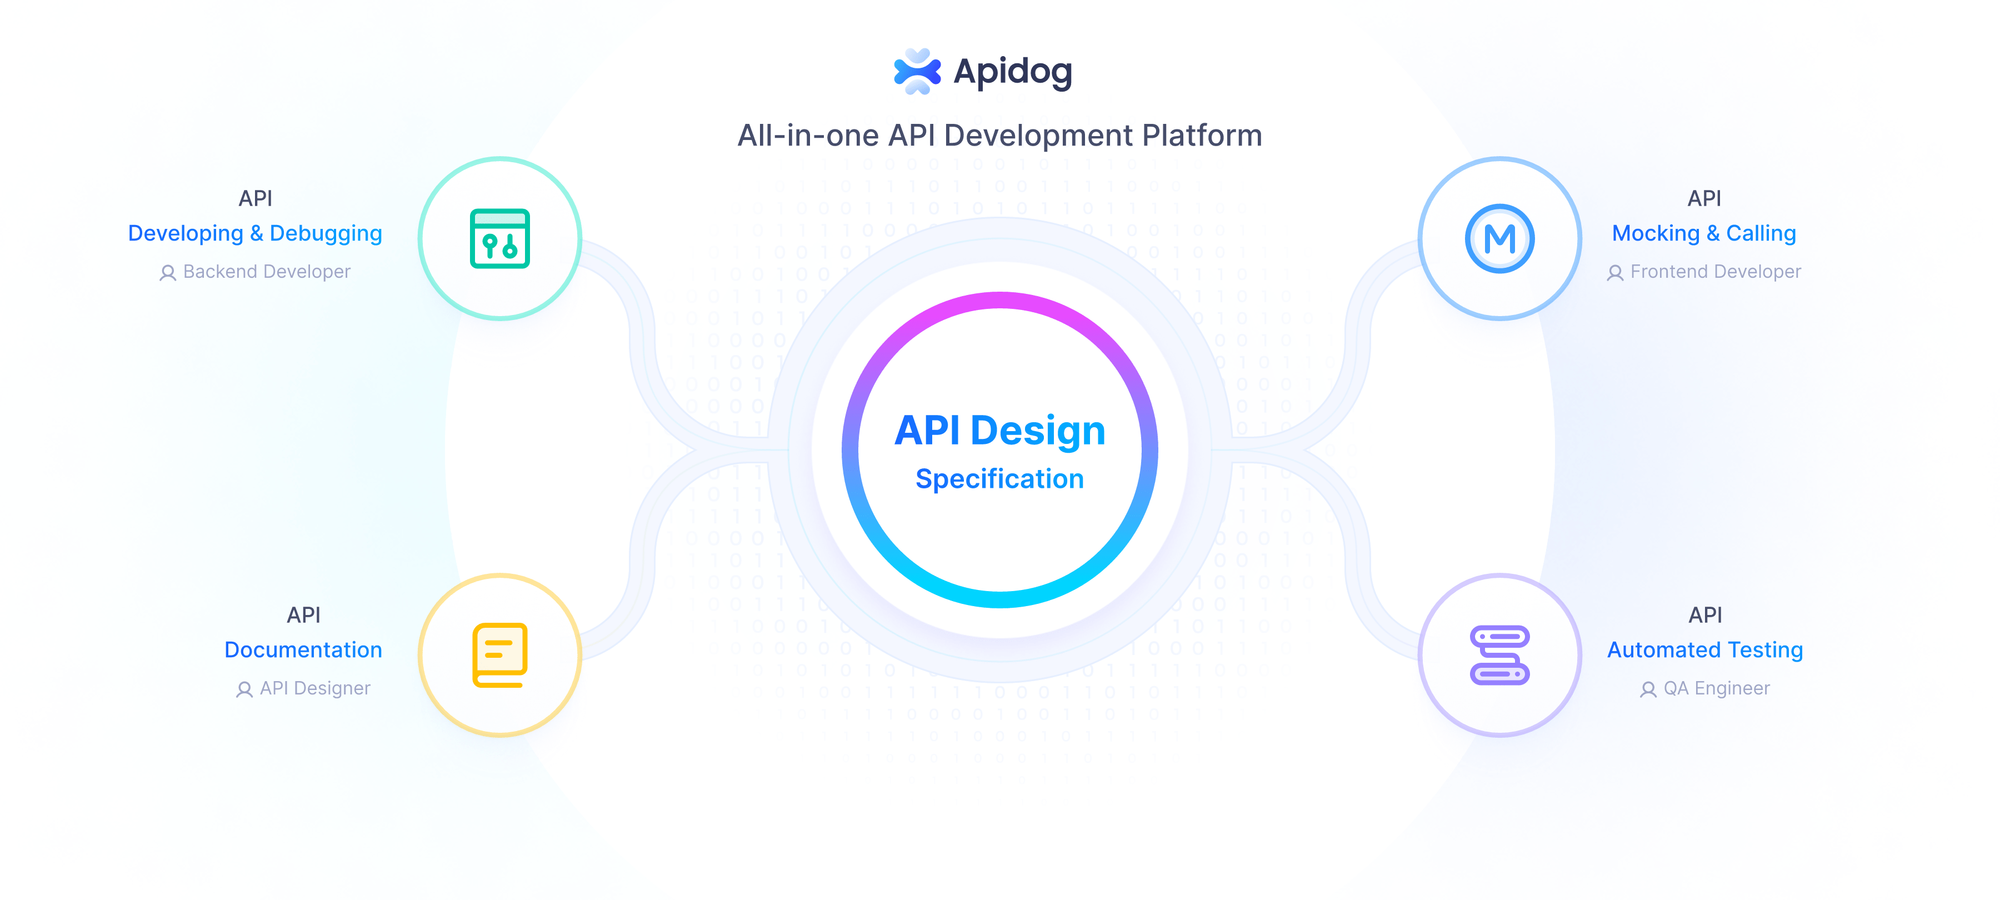
Kemampuan pengujian otomatis Apidog memungkinkan alur kerja integrasi berkelanjutan yang memastikan konsistensi kinerja model di seluruh siklus pengembangan. Otomatisasi ini mengurangi beban kerja pengujian manual sambil mempertahankan standar jaminan kualitas.
Pemantauan dan Optimasi Kinerja
Melalui kemampuan pemantauan Apidog, tim pengembangan dapat melacak metrik kinerja API, mengidentifikasi peluang optimasi, dan menjaga keandalan layanan. Platform ini menyediakan analitik terperinci tentang waktu respons, kualitas penalaran, dan pola pemanfaatan sumber daya.
Selain itu, data pemantauan memungkinkan strategi optimasi proaktif yang meningkatkan kinerja aplikasi dan pengalaman pengguna. Pendekatan berbasis data ini memastikan pemanfaatan model yang optimal di seluruh lingkungan produksi.
Kesimpulan
Magistral Small 1.2 dan Magistral Medium 1.2 merepresentasikan kemajuan signifikan dalam teknologi penalaran AI multimodal. Kombinasi kinerja matematika yang ditingkatkan, kemampuan visi, dan transparansi penalaran yang lebih baik menciptakan alat yang kuat untuk berbagai aplikasi mulai dari penelitian ilmiah hingga pengembangan perangkat lunak.
Peningkatan aksesibilitas melalui opsi penerapan lokal dan dukungan API komprehensif mendemokratisasi akses ke kemampuan penalaran canggih. Organisasi kini dapat mengintegrasikan penalaran AI yang canggih ke dalam alur kerja mereka tanpa memerlukan investasi infrastruktur yang besar.
Baik Anda mengembangkan aplikasi edukasi, melakukan penelitian ilmiah, atau membangun sistem perangkat lunak yang kompleks, Magistral Small 1.2 dan Magistral Medium 1.2 menyediakan kemampuan penalaran yang diperlukan untuk aplikasi AI generasi berikutnya. Dikombinasikan dengan alat pengujian dan integrasi yang kuat seperti Apidog, model-model ini memungkinkan alur kerja pengembangan komprehensif yang mempercepat inovasi sambil mempertahankan standar kualitas.