
Saat agen suara gagal pada panggilan nyata, penyebabnya seringkali bukan LLM atau suaranya. Masalahnya justru dimulai satu langkah lebih awal, yaitu pada audio yang didengar oleh agen, baik yang masuk ke speech-to-text (STT) maupun langsung ke model speech-to-speech. STT modern mampu menangani suara lalu lintas dan pendingin udara dengan baik. Yang tidak bisa ditanganinya adalah suara orang kedua yang ikut berbicara: seorang rekan kerja, TV, atau agen di meja sebelah di call center. STT juga mendengarkan mereka, dan agen bertindak berdasarkan kata-kata yang tidak pernah diucapkan oleh penelepon.
Krisp Voice Isolation berada di depan STT dan menghapus semua suara kecuali suara pembicara utama. Untuk ulasan ini, saya membaca benchmark dan dokumentasi Krisp, mendaftar untuk API self-serve, dan menjalankan delapan rekaman nyata dari dataset publik Krisp melaluinya. Kemudian saya mentranskripsi audio sebelum dan sesudahnya menggunakan model STT open-source untuk melihat apa yang sebenarnya berubah.
Kesimpulan singkatnya: jika agen Anda menerima panggilan dari kantor, rumah, call center, atau tempat mana pun yang ada orang berbicara di latar belakang, Voice Isolation layak dimasukkan ke dalam pipeline Anda. Dalam pengujian saya, suara latar belakang yang sempat menjadi 331 kata transkrip palsu turun menjadi nol. Trade-off-nya memang ada, tetapi kecil: sedikit penurunan kualitas pada audio telepon yang bersih, wilayah API hanya tersedia di AS, dan pilihan model di API lebih sedikit dibandingkan di SDK.
Masalahnya: suara latar, bukan derau latar
Model STT dilatih untuk menangkap ucapan, bukan untuk menentukan ucapan siapa yang penting. Derau bisa difilter karena tidak terlihat seperti ucapan. Suara kedua justru terlihat persis seperti ucapan, karena memang ucapan.
Contoh dari Krisp sendiri cukup menggambarkan hal ini. Seorang penelepon meminta untuk membatalkan langganan, sementara rekan kerja di dekatnya bertanya soal makan siang. STT mengembalikan satu aliran kata tanpa penanda mana yang berasal dari penelepon, sehingga agen menerima keduanya sebagai satu permintaan.
Hal ini merusak voice agent dalam tiga cara:
- Transkrip salah. Kata-kata orang di sekitar masuk ke transkrip, dan LLM menjawab hal-hal yang tidak pernah diucapkan penelepon.
- Interupsi palsu. Agen mendengar orang di sekitar, mengira penelepon memotong pembicaraan, dan berhenti berbicara di tengah kalimat.
- Pergantian giliran bicara kacau. Ucapan latar terdengar seperti penelepon masih berbicara, sehingga agen tidak bisa mengetahui kapan giliran bicara telah berakhir.
Dalam setiap kasus, logika agen bekerja sesuai desainnya. Ia hanya bereaksi terhadap suara yang seharusnya tidak pernah ia dengar.
Angka-angkanya menunjukkan seberapa besar kesenjangan ini. Dalam pengujian peluncuran Voice Isolation 2.5 dari Krisp, 10 sistem STT rata-rata mencatat tingkat kesalahan kata (WER) sebesar 2,10% pada audio bersih dengan satu pembicara. Ketika ada orang kedua yang berbicara menimpa penelepon, sistem yang sama rata-rata mencatat 35,92%. Supresi derau tidak bisa menutup kesenjangan itu, karena gangguannya berupa ucapan.
Apa itu Krisp Voice Isolation
Krisp Voice Isolation API & SDK menghilangkan suara latar dan derau dari aliran audio langsung serta hanya meneruskan suara pembicara utama. Teknologi ini dibangun untuk agen AI suara, dan merupakan inti teknologi yang sama yang Krisp sediakan untuk panggilan manusia dengan nama Background Voice Cancellation (BVC).
Teknologi ini dipasang di awal pipeline agen, sehingga setiap model setelahnya hanya mendengar satu suara:
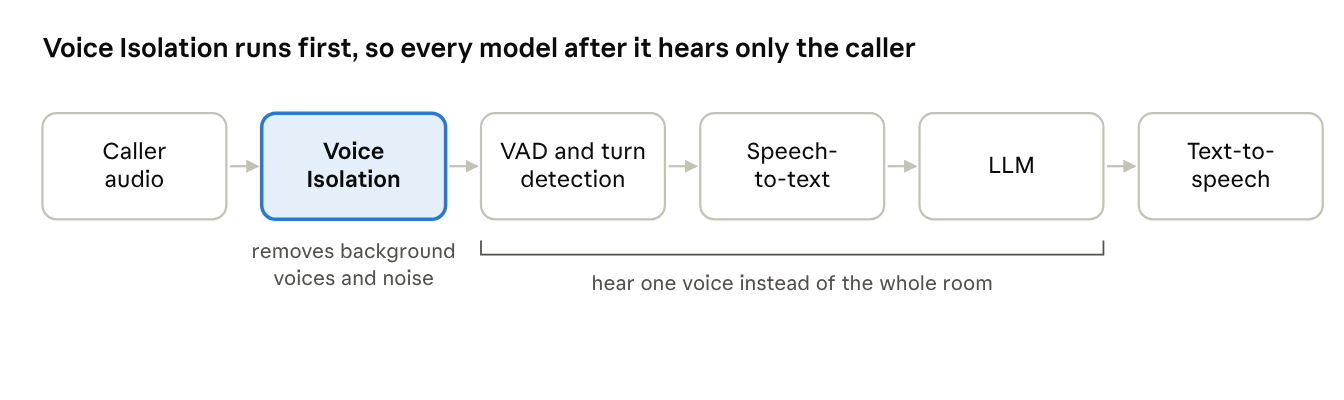
Posisi Voice Isolation dalam pipeline agen suara
Penempatan ini penting. Tanpa itu, VAD dan deteksi pergantian giliran juga akan mendengar orang di sekitar, dan di situlah sumber interupsi palsu.
Krisp telah menghabiskan sekitar sembilan tahun di bidang AI suara dan mengklaim memproses lebih dari 1 triliun menit suara per tahun. Voice Isolation adalah salah satu produk dalam lini voice AI API dan SDK-nya. Voice Isolation merupakan bagian dari VIVA, rangkaian model real-time Krisp untuk agen suara, bersama Turn-Taking, Interrupt Prediction, dan VAD. Ia bekerja bersama turn-taking, bukan menggantikannya.
Keempat model ini memberi Anda kendali atas seberapa agresif suara latar dan noise dihilangkan. Dengan agresivitas penuh (konfigurasi bawaan), Default menghilangkan paling banyak. Balanced memproses suara utama dengan lebih ringan, dengan komputasi yang sama. Lite menggunakan sekitar sepertiga komputasi Default. HD dirancang untuk aliran WebRTC 32 kHz, bukan audio telepon. Agresivitas adalah pengaturan run-time yang bisa Anda sesuaikan tanpa mengubah komputasi; di API, parameter ini disebut suppression_level, dengan nilai dari 0 hingga 100.
Satu batasan yang perlu Anda ketahui sejak awal: model penghapus suara mengasumsikan pembicara berada dekat dengan mikrofon. Sebagai perkiraan kasar, di atas jarak sekitar 30 cm, suara pembicara utama sendiri bisa ikut teredam. Ini bukan aturan mutlak; melainkan rekomendasi umum, dan jarak sebenarnya bergantung pada kondisi akustik. Untuk perangkat far-field seperti smart speaker, Krisp menyediakan model terpisah yang hanya menghilangkan noise.
Versi 2.5 dirilis pada Agustus 2026, dan Krisp menerbitkan benchmark terbuka beserta datasetnya pada September. Model ini kini tersedia sebagai API self-serve maupun SDK.
Apa yang Ditunjukkan Benchmark Krisp
Pada benchmark terbuka Krisp, Voice Isolation menurunkan rata-rata word error rate dari 23,24% menjadi 6,24%, penurunan sebesar 73%.
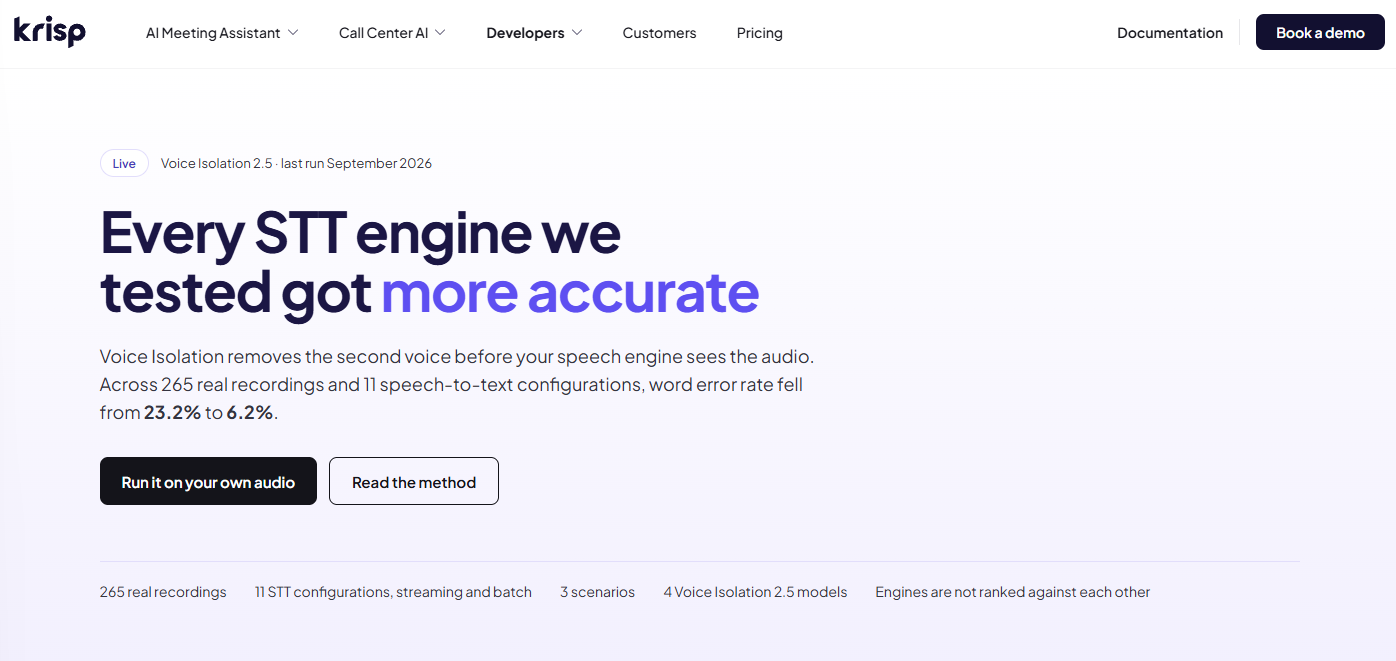
Halaman benchmark Krisp merangkum hasil utamanya.
Benchmark ini menggunakan 265 rekaman asli dari kantor, rumah, empat lantai call center yang sedang beroperasi, dan mobil. Tidak ada yang disimulasikan atau dicampur setelahnya. Sebagian besar rekaman mengikuti skrip yang sama: pembicara utama berbicara, orang kedua ikut masuk, pembicara utama terdiam sementara orang lainnya terus berbicara, lalu pembicara utama kembali. Jeda senyap itulah ujian sesungguhnya, karena transkrip yang benar untuk bagian tersebut kosong. Setiap file dijalankan melalui 11 konfigurasi STT dari sembilan engine, dengan dan tanpa isolasi.
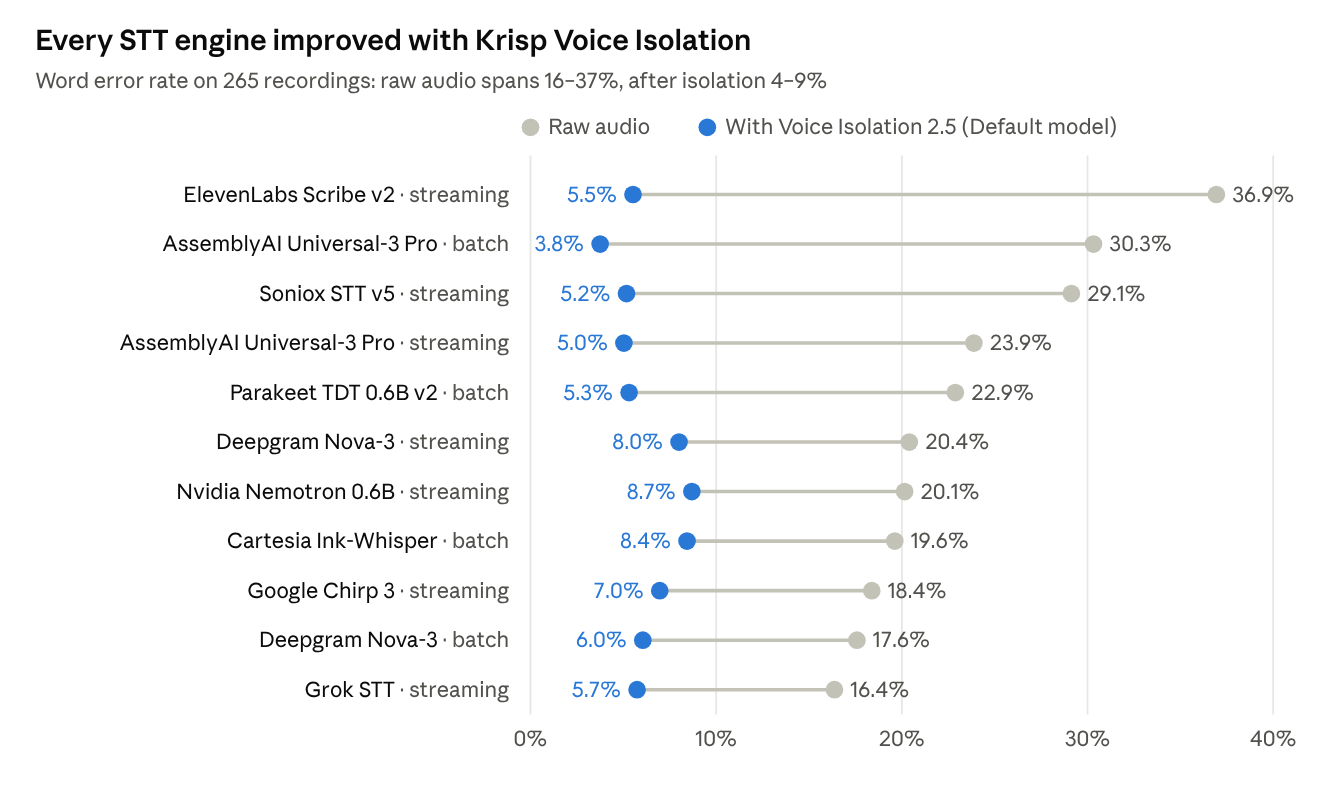
Sumber: Krisp voice isolation benchmark, Okt 2026 · 11 konfigurasi STT, semua skenario digabung
Semua engine mengalami perbaikan dan tidak ada yang memburuk. Hasil yang lebih berguna adalah apa yang terjadi pada jarak antar engine: pada audio mentah jaraknya sekitar 20 poin, dan setelah isolasi menyusut menjadi sekitar 5. Jika agent Anda mendengar suara latar belakang, membersihkan input lebih banyak mengubah WER Anda daripada memilih vendor STT yang berbeda.
Berdasarkan skenario, peningkatannya bergantung pada ada atau tidaknya suara kedua:
Kapan Ini Tidak Membantu
Krisp dengan terbuka mempublikasikan titik lemahnya, dan menurut saya itu adalah bagian paling meyakinkan dari tulisan ini.
- Audio telepon yang sudah bersih justru sedikit memburuk. Tanpa ada suara kedua untuk dihilangkan, isolasi hanya bisa menyentuh suara utama. WER panggilan telepon naik dari 3,48% menjadi 3,91%, dan satu file naik dari 9,42% menjadi 21,65%. Model Balanced berperforma paling baik di sini dengan 3,53%.
- Echo yang berat masih menjadi masalah. Dalam pengujian rilis 2.5 yang terpisah, rekaman satu pembicara dengan akustik yang sulit mendapat skor 11,61% dengan isolasi dibandingkan 8,02% tanpa isolasi. Ini jauh lebih baik daripada versi 2.1 (15,42%), tetapi tetap lebih buruk daripada tidak melakukan apa-apa.
- Isolasi berlebihan menyebabkan kesalahan senyap. Krisp menjelaskan bahwa model-model sebelumnya terkadang menghapus sebagian suara utama. Manusia masih bisa memahami audionya, tetapi STT menggugurkan seluruh klausa dan transkripnya terbaca lancar namun dengan lubang-lubang di dalamnya. Versi 2.5 disesuaikan untuk STT, bukan untuk telinga manusia, guna memperbaiki masalah ini.
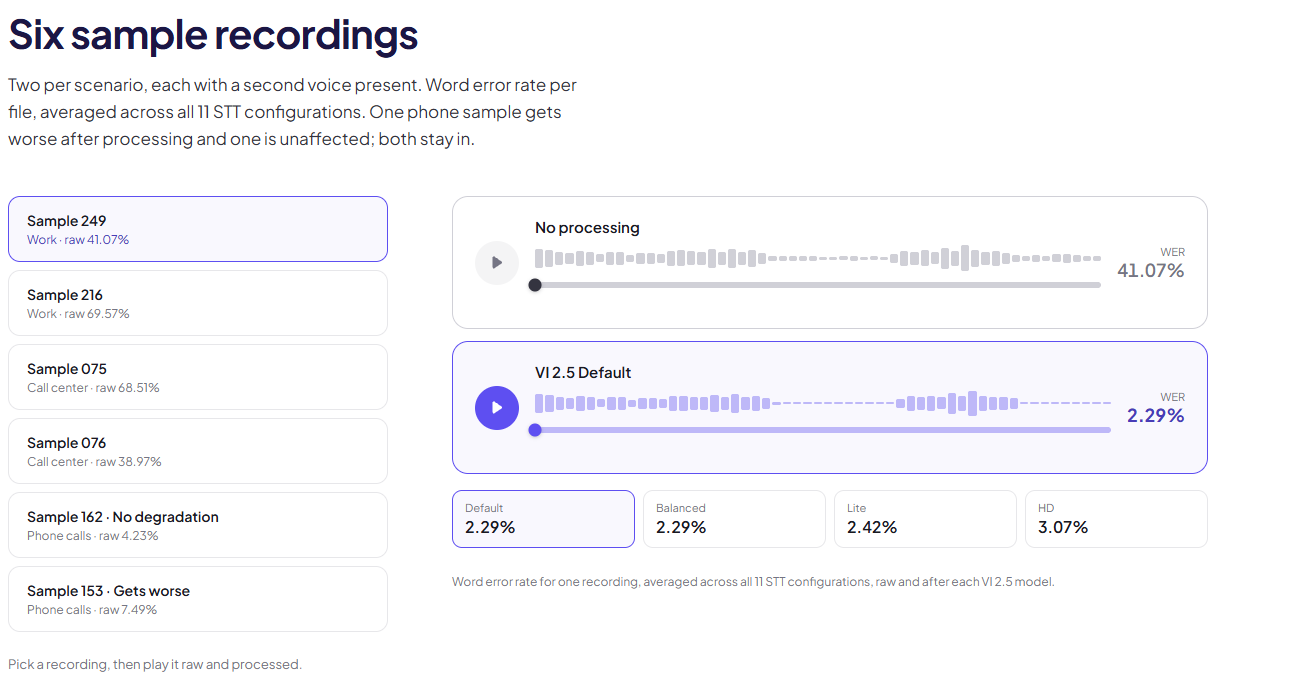
Halaman benchmark memungkinkan Anda memutar enam rekaman dalam kondisi mentah dan yang telah diproses. Sampel 153, sebuah panggilan telepon, diberi label "Gets worse" (Memburuk).
Ada dua hal lain yang perlu diingat. Angka 73% dan angka 46,4% yang akan Anda lihat di situs Krisp berasal dari pengujian yang berbeda: 265 rekaman dalam benchmark terbuka, dan 1.685 rekaman dalam pengujian rilis 2.5. Selain itu, hasil Krisp membandingkan audio dengan dan tanpa isolasi miliknya sendiri, bukan dengan produk isolasi dari vendor lain.
Rekaman, transkrip tulisan tangan, label segmen, dan keluaran setiap model tersedia publik di Hugging Face, sehingga siapa pun dapat mengulangi pengujian ini. Itulah yang saya lakukan berikutnya.
Uji Coba Langsung: Menguji API Voice Isolation
Dalam pengujian saya, Voice Isolation menghapus setiap kata percakapan latar belakang dari hasil transkrip, dan WER gabungan turun dari 40,1% menjadi 10,2%.
Persiapan
Mendaftar di Developers Portal itu cepat, dengan opsi masuk melalui Google, Microsoft, atau email. Uji coba memberi saya kredit senilai $30 dan batas dua sesi bersamaan. Setelah itu, buka API Keys → Create key, dan Anda akan mendapatkan kunci yang hanya bisa disalin satu kali.
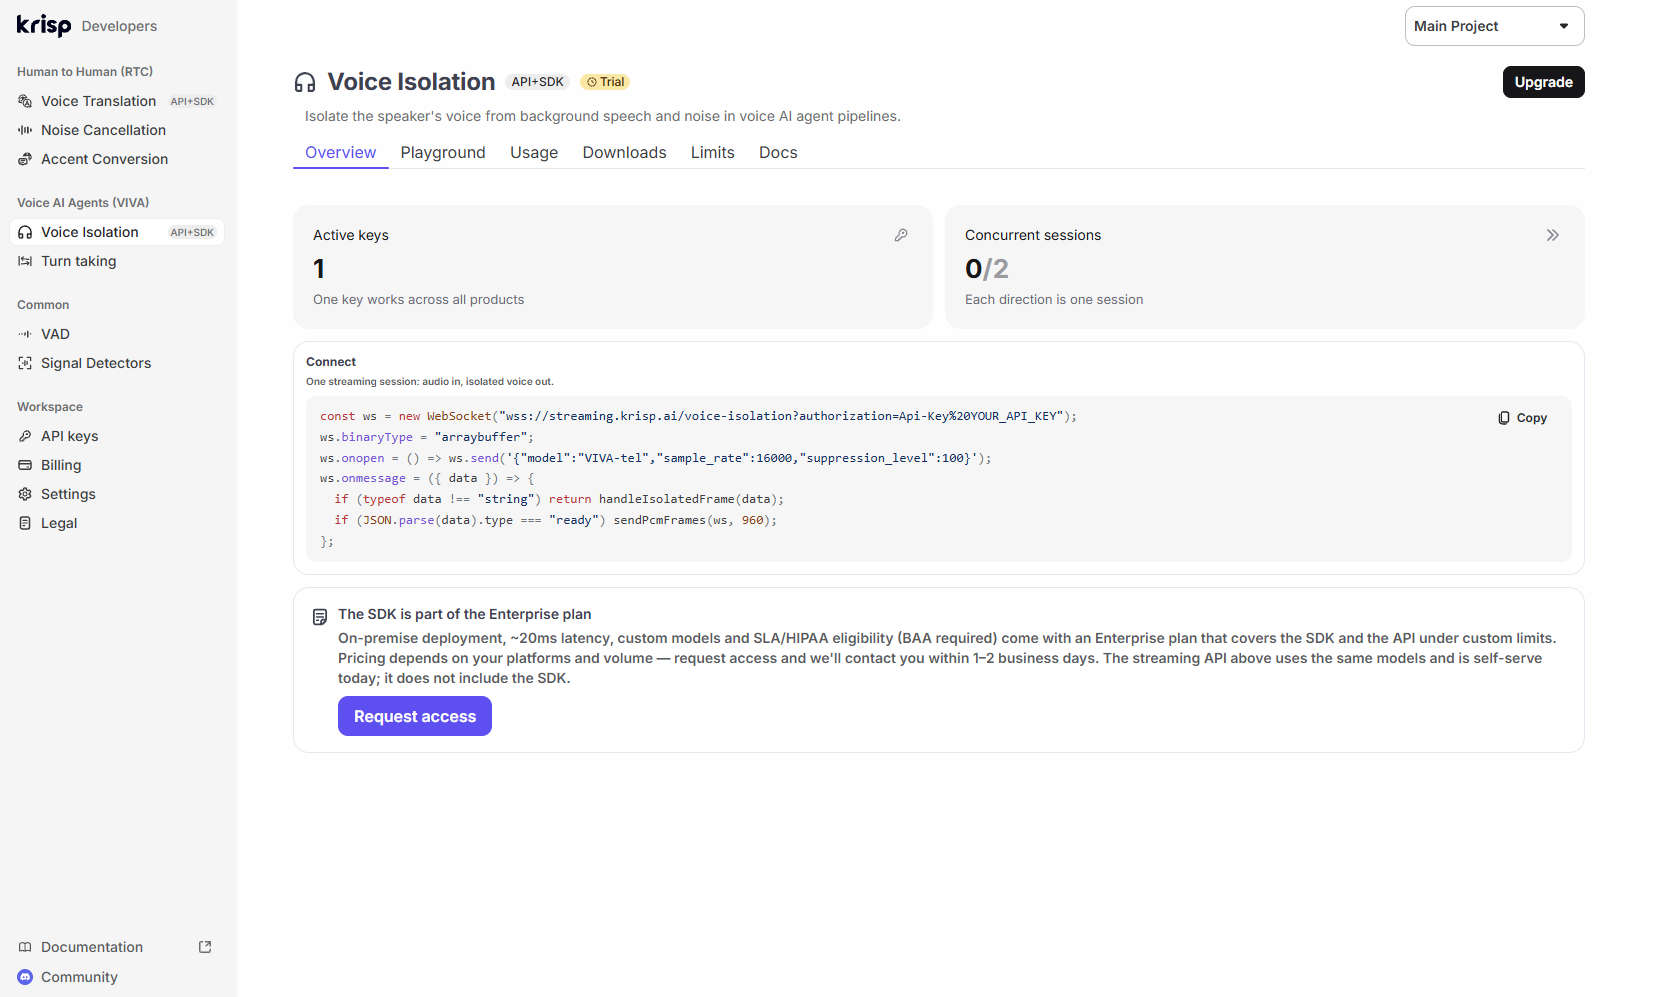
Halaman Voice Isolation di Developers Portal dengan paket uji coba.
Kunci API yang saya buat untuk ulasan ini. Satu kunci berfungsi untuk semua produk Krisp API, termasuk Voice Translation API.
API ini berbasis WebSocket. Backend Anda menukar kunci API dengan token sesi berumur pendek, klien mengirim pesan JSON pembuka kecil, menunggu status ready, lalu melakukan streaming PCM mono 16-bit dan menerima audio yang sudah dibersihkan frame demi frame:
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
Ini hampir sama dengan API quickstart milik Krisp, skrip Python singkat yang membersihkan file WAV. Ada satu aturan yang sering membuat orang terkejut: setiap pesan audio harus tepat 30 ms. Jika tidak, sesi akan berakhir dengan error invalid_frame_duration, jadi tambahkan bingkai terakhir dengan keheningan.
Untuk pengujian, saya memilih delapan rekaman dari dataset publik Krisp: tiga rekaman kantor, tiga dari lantai pusat panggilan, dan dua panggilan telepon dari dalam mobil, totalnya sekitar 11 menit. Saya melakukan streaming masing-masing melalui API dengan kecepatan real-time, dari Asia. Lalu saya mentranskrip audio mentah dan yang sudah dibersihkan menggunakan Parakeet TDT 0.6B v2 sumber terbuka dari NVIDIA, salah satu engine dalam benchmark Krisp, dan menilai setiap segmen berlabel dibandingkan transkrip manusia.
Hasil
Hampir seluruh perbaikan tersebut berasal dari satu tempat: jendela-waktu saat pembicara utama diam tetapi orang lain terus berbicara. Pada audio mentah, Parakeet mengubah ucapan latar belakang itu menjadi 331 kata transkrip. Setelah Voice Isolation, tidak ada satu kata pun yang dihasilkan. Suara latar belakang pada jendela tersebut 13 hingga 34 dB lebih pelan, sementara level pembicara utama hampir tidak berubah (dalam rentang 1 dB).
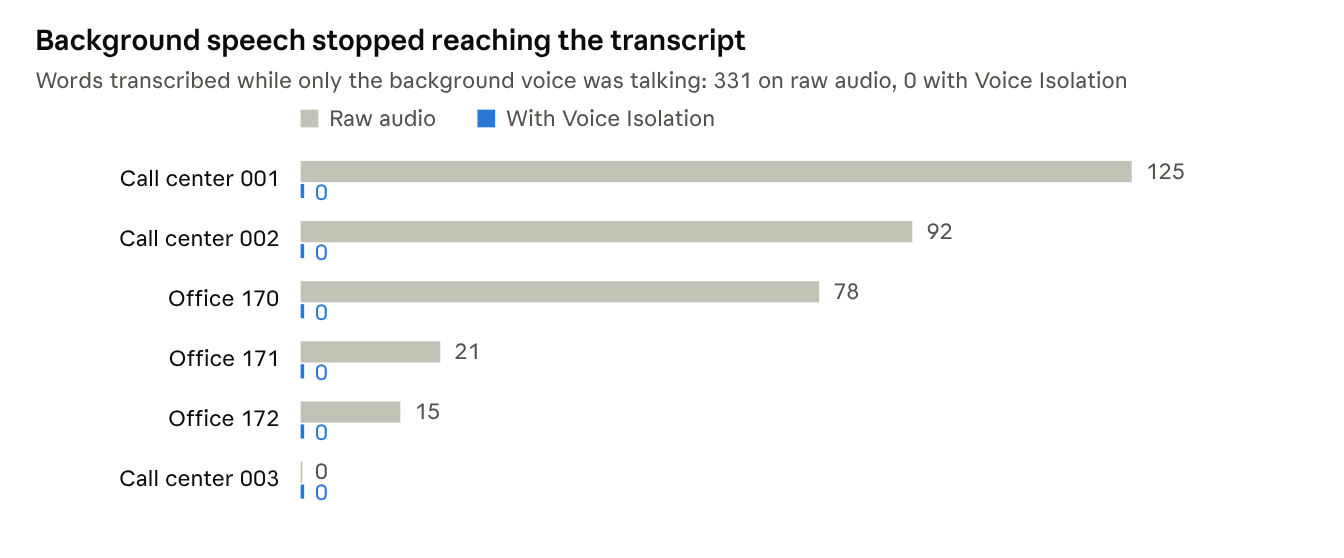
Uji saya · Krisp API (VIVA-tel), ditranskripsikan dengan Parakeet TDT 0.6B v2 · 6 rekaman dengan jendela yang hanya berisi suara latar belakang
Contoh call-center menunjukkan mengapa hal ini penting. Saat agen yang saya uji sedang berhenti sejenak, agen di meja sebelah sedang menangani panggilan lain. Transkrip mentah menangkap panggilan itu kata demi kata:
thank you for calling meridian bank before i begin i will need to confirm your identity for security could you give me your full name your date of birth...
Voice agent akan menganggap itu sebagai ucapan dari penelepon. Dengan Voice Isolation, jendela yang sama kembali dalam keadaan kosong.
Ketika kedua orang berbicara bersamaan, perubahannya kecil: 13,2% pada audio mentah dibandingkan 12,5% pada audio yang dibersihkan. Parakeet memang sudah lebih mengutamakan suara yang lebih keras dan lebih dekat pada bagian-bagian tersebut. Sebagian besar kesalahan yang tersisa di sana adalah masalah format angka dalam sistem penilaian saya (nomor telepon, harga, kode pos), yang mengenai kedua versi secara sama.
Pada dua panggilan telepon yang bersih, satu file mendapat satu kesalahan tambahan dan satu lainnya berkurang dua kesalahan. Ini sejalan dengan temuan Krisp sendiri bahwa kerugiannya pada audio yang bersih sangat kecil.
Latensi dan keandalan dari luar AS
API saat ini hanya berjalan di wilayah AS, dan dokumentasi Krisp memperingatkan bahwa klien di tempat lain akan mengalami latensi tambahan. Dari Asia, waktu tempuh pulang-pergi (round trip) median untuk satu frame (mengirim hingga audio yang dibersihkan kembali) adalah 260–520 ms tergantung pada sesinya, dan pembuatan sesi biasanya membutuhkan waktu 1,5–3 detik. Itu disebabkan oleh jarak jaringan, bukan modelnya: Krisp menyatakan latensi algoritmiknya adalah 15 ms. Namun jika agent Anda melayani pengguna yang jauh dari AS, efek ini akan terasa, dan SDK di server Anda sendiri dapat menghindarinya.
Satu dari sembilan sesi saya terputus sekitar 70 detik kemudian dengan abnormal close. Menjalankannya ulang berhasil. Saya cenderung menganggap itu karena rute jaringan yang panjang dari Asia, bukan karena layanannya, tetapi ini pengingat untuk menangani reconnect dengan baik di lingkungan produksi.
Tentang pengujian ini: delapan file adalah sampel yang kecil, bukan tolok ukur. Saya melakukan resampling rekaman 32 kHz menjadi 16 kHz untuk model teleponi (VIVA-tel), menggunakan satu mesin STT, dan menerapkan normalisasi teks yang sederhana, sehingga angka absolut saya tidak dapat dibandingkan dengan angka Krisp. Yang saya periksa adalah arah dan besarnya perubahan, dan hasilnya sesuai dengan apa yang dilaporkan Krisp.
Pengalaman developer: API atau SDK
Voice Isolation hadir dalam dua bentuk, dan pilihan mana yang bisa Anda gunakan bergantung pada paket Anda.
API adalah cara termudah untuk memulai: tidak ada file model yang perlu dikirim dan tidak ada yang perlu dijalankan di CPU Anda. Konsekuensinya adalah audio Anda dikirim ke cloud Krisp, dan Anda hanya mendapatkan dua model, bukan empat: VIVA-tel untuk audio telepon 8 atau 16 kHz, dan VIVA-pro untuk audio wideband 32 kHz. VIVA-pro belum ada di referensi API, tetapi sudah tersedia di Playground portal, API menerimanya saat saya mengujinya, dan Krisp mengonfirmasi bahwa model ini tersedia.
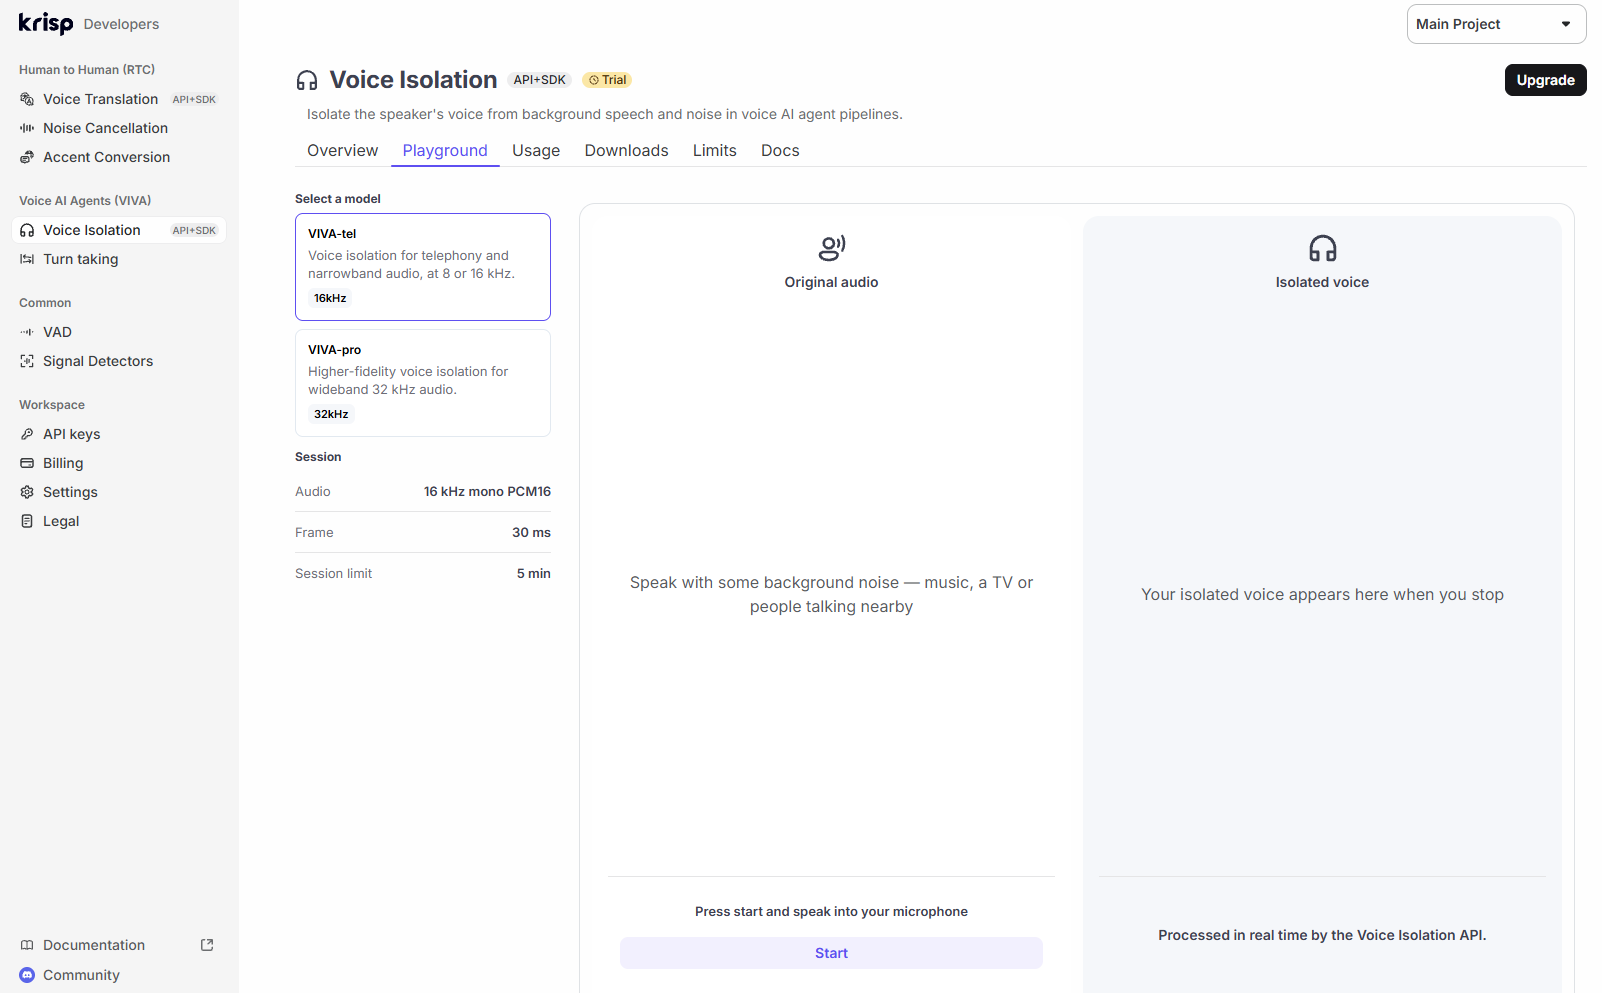
Playground di portal memungkinkan Anda menguji salah satu model API dengan mikrofon sendiri sebelum menulis kode apa pun.
SDK menjaga audio tetap berada di server Anda sendiri dan hanya terhubung ke internet untuk memeriksa lisensinya. Di sinilah juga kisah biayanya menjadi menarik. Tulisan tentang CPU dari Krisp menunjukkan bahwa satu flag SDK, enableLowPrecisionExecution, kira-kira menggandakan jumlah panggilan yang dapat dibersihkan sebuah server pada CPU dengan dukungan FP16. Instansi AWS Graviton3 dengan 16 vCPU naik dari 76 panggilan langsung menjadi 137, dan model Lite mampu menangani sekitar tiga kali lebih banyak stream dibandingkan model lengkapnya. Pada chip Intel Ice Lake yang lebih lama, flag ini tidak berpengaruh apa pun.
Integrasi
- Pipecat memiliki filter siap pakai. Anda tinggal menambahkan KrispVivaFilter() sebagai filter input audio pada transport Anda, dan Anda bisa memasangkannya dengan KrispVivaTurn untuk deteksi giliran bicara. Perlu dicatat bahwa ini menggunakan SDK, jadi Anda membutuhkan akses SDK dan file modelnya, bukan sekadar kunci API.
- LiveKit menawarkan model Krisp di LiveKit Cloud, termasuk pembatalan suara latar (noise_cancellation.BVC()) untuk agen. LiveKit mengenakan biaya tambahan untuk model isolasi suaranya.
- Pipeline WebRTC dan teleponi dapat menggunakan SDK secara langsung, dan API berfungsi dengan apa pun yang bisa membuka WebSocket.
Dokumentasinya jelas dan mutakhir. Quickstart berhasil langsung pada percobaan pertama, dan pesan error memberi tahu Anda dengan tepat apa yang salah, hingga ke ukuran frame yang diharapkan dan yang diterima. Satu keluhan saya adalah soal penamaan: blog menyebut Default, Balanced, Lite dan HD, unduhan SDK menggunakan nama file seperti krisp-viva-vi-tel-v2.5.1, dan API menyebut modelnya VIVA-tel dan VIVA-pro, dengan hanya yang pertama yang ada di referensi API. Tabel pemetaan di dokumentasi akan sangat membantu.
Harga
API ini ditagih per jam audio, dan harganya cukup murah sehingga biaya seharusnya bukan pertimbangan utama untuk menggunakannya.
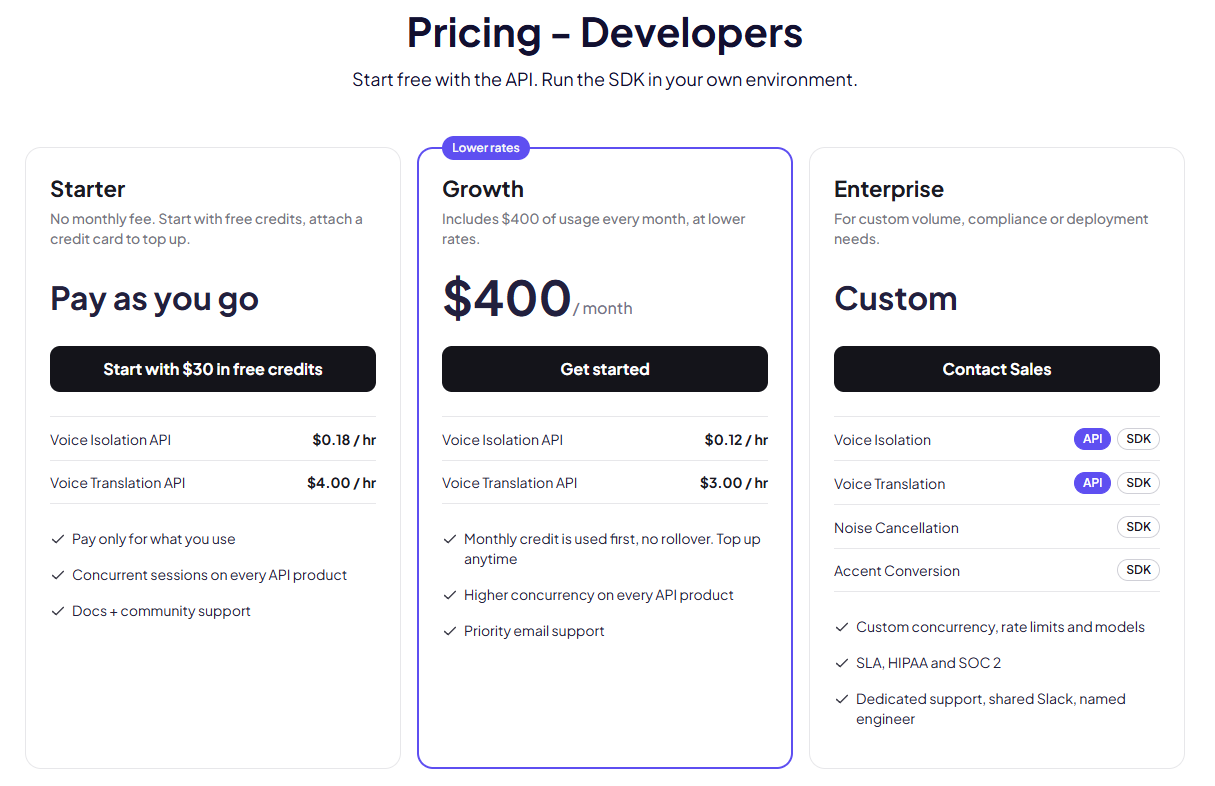
Harga developer Krisp, November 2026.
Pada paket Starter dengan sistem bayar sesuai pemakaian, API Voice Isolation berbiaya $0,18 per jam audio, tanpa biaya bulanan. Tarifnya sama untuk kedua model API, VIVA-tel dan VIVA-pro. Growth berbiaya $400 per bulan, mencakup kredit pemakaian $400 dan menurunkan tarif menjadi $0,12 per jam, dengan concurrency lebih tinggi dan dukungan prioritas. Enterprise harganya khusus dan merupakan satu-satunya paket yang mencakup SDK, SLA, serta sertifikasi HIPAA dan SOC 2.
Kredit awal $30 mencakup sekitar 166 jam audio dengan tarif Starter, yang sudah lebih dari cukup untuk pengujian. Kredit berlaku 12 bulan dan pemakaian ditagih per menit. Sebagai gambaran, membersihkan panggilan selama 5 menit hanya berbiaya sekitar 1,5 sen di paket Starter.
SDK hanya tersedia di paket Enterprise dengan harga yang disepakati, jadi Anda perlu menghubungi tim sales jika ingin menjalankan model di server Anda sendiri. Tarif diambil dari halaman harga Krisp, diverifikasi pada November 2026.
Alternatif
Krisp bukan satu-satunya pilihan untuk menghilangkan suara latar belakang, tetapi belum ada pengujian independen yang membandingkan produk-produk ini secara langsung. Setiap vendor menerbitkan angka versinya sendiri berdasarkan datanya sendiri, jadi anggaplah angka-angka di bawah ini sebagai klaim.
Keunggulan Krisp terletak pada buktinya. Krisp adalah satu-satunya vendor di sini yang memiliki benchmark terbuka dan dapat direproduksi di 11 konfigurasi STT, dan mereka juga mempublikasikan kasus-kasus di mana mereka kalah. Krisp juga paling fleksibel untuk diimplementasikan: melalui API cloud, SDK di server, atau terpasang langsung di LiveKit dan Pipecat.
Kesimpulan
Krisp Voice Isolation adalah solusi yang perlu dicoba ketika voice agent berjalan lancar di pengujian tapi bermasalah pada panggilan sungguhan. Ia menghilangkan suara-suara yang seharusnya tidak didengar oleh agent Anda, kompatibel dengan STT apa pun yang sudah Anda gunakan, dan baik benchmark dari Krisp maupun pengujian saya sendiri menunjukkan hal yang sama: percakapan latar belakang berhenti masuk ke transkrip.
Kelebihan
- Menghilangkan suara latar belakang, bukan sekadar derau, yang merupakan masalah yang tidak bisa ditangani STT sendirian
- Bekerja dengan mesin STT apa pun, tanpa pengaturan per bahasa atau voice enrollment
- Berjalan di CPU dengan latensi algoritmika 15 ms
- Benchmark yang terbuka dan dapat direproduksi, termasuk kasus-kasus di mana ia kalah
- API mandiri dengan kredit gratis $30, dan murah dengan harga $0,12–$0,18 per jam
- Filter Pipecat siap pakai dan dukungan LiveKit
Kekurangan
- Sedikit penurunan akurasi pada audio telepon yang bersih, dan tetap lebih buruk daripada audio mentah di ruangan dengan gema yang berat
- API hanya berjalan di region AS, yang menambah latensi yang cukup terasa di wilayah lain
- API hanya menawarkan dua model dibandingkan empat model pada SDK; penggunaan on-premise membutuhkan SDK Enterprise
Siapa yang sebaiknya menggunakannya: tim yang agent-nya menerima panggilan dari call center, kantor, rumah, mobil, atau tempat lain di mana ada orang lain yang berbicara di dekatnya. Mulailah dengan API untuk mengukur efeknya pada rekaman Anda sendiri, lalu beralih ke SDK jika Anda membutuhkan model lain, latensi lebih rendah di luar AS, atau audio yang tetap berada di server Anda.
Siapa yang bisa melewatkannya: agent yang pemanggilnya hampir selalu berada sendirian di ruangan yang tenang, atau perangkat far-field seperti smart speaker, di mana model penghilang suara ini tidak dirancang untuk berfungsi.
Anda bisa mencoba API Krisp Voice Isolation dengan kredit gratis dan menjalankan rekaman Anda sendiri dalam waktu satu sore.
FAQ
Apakah voice isolation sama dengan peredam bising (noise cancellation)? Tidak. Noise cancellation menghapus suara non-ucapan seperti lalu lintas dan ketikan keyboard. Voice isolation juga menghapus suara orang lain, yang justru tetap dibiarkan oleh noise cancellation.
Apakah Krisp Voice Isolation bekerja dengan penyedia STT saya? Ya. Ia memproses audionya sendiri, sehingga dapat bekerja di depan mesin STT apa pun. Krisp mengujinya dengan 11 konfigurasi, termasuk model Deepgram, AssemblyAI, ElevenLabs, Soniox, Google, Cartesia, dan NVIDIA. Ia juga dapat berada di depan model speech-to-speech. Krisp belum mempublikasikan hasil untuk pengaturan tersebut, tapi tidak ada yang menghalangi Anda untuk mencobanya.
Apakah ini menggantikan turn detection? Tidak. Ia berada sebelum VAD dan turn detection serta memberikan audio yang lebih bersih kepada keduanya. Krisp menyediakan Turn-Taking sebagai model terpisah dalam VIVA SDK yang sama.
Apakah pengguna perlu mendaftarkan suara mereka? Tidak. Ia tidak memerlukan pendaftaran maupun pelatihan pada suara pengguna.
Berapa banyak latensi yang ditambahkannya? Krisp menyebutkan 15 ms latensi algoritmik, dan dokumentasi SDK-nya menyebutkan latensi tambahan sekitar 20 ms. Dengan API cloud, waktu jaringan ke region AS ditambahkan di atasnya.
Apakah bekerja pada panggilan telepon? Ya. Ia mampu menangani audio telepon narrowband, codec umum seperti G.711, G.722, G.729, dan Opus, serta headset Bluetooth.
Bagaimana dengan panggilan antarmanusia? Teknologi yang sama tersedia sebagai Background Voice Cancellation (BVC) dalam RTC SDK Krisp, yang berjalan di perangkat pengguna di browser serta aplikasi desktop dan mobile. Contact center dengan agen manusia mendapatkannya melalui produk call center AI Krisp, di mana teknologi ini menjaga suara agen di sekitar agar tidak terdengar dalam panggilan pelanggan.


