
Moonshot Kimi K2.7 Code diluncurkan dengan tolok ukur (benchmark) dibandingkan dua model yang paling sering dibayar oleh pengembang: Claude Opus dan GPT-5.5. Singkatnya, model tertutup masih unggul dalam sebagian besar tugas pengodean, tetapi tidak dengan selisih yang disarankan oleh harganya. Kimi adalah model berbobot terbuka (open-weight) yang dapat Anda unduh dan host sendiri, dan skornya hanya terpaut beberapa poin dari model yang hanya bisa Anda sewa.
Perbandingan ini menyandingkan angka-angka, menimbangnya terhadap biaya dan keterbukaan, serta memberi tahu Anda mana yang harus dipilih untuk pekerjaan mana.
TL;DR
- Kualitas pengodean mentah: GPT-5.5 dan Claude Opus memimpin pada sebagian besar suite. Kimi K2.7 Code tertinggal beberapa poin.
- Biaya: Kimi jauh lebih murah ($0.95/$4.00 per juta token) dan gratis untuk di-host sendiri. Model tertutup berharga lebih mahal dan tidak dapat di-host di perangkat keras Anda sendiri.
- Keterbukaan: Kimi mengirimkan bobot terbuka di bawah lisensi MIT yang dimodifikasi. Opus dan GPT-5.5 bersifat tertutup.
- Putusan: pilih model frontier (terdepan) untuk kualitas sekali jalan (single-shot) tertinggi; pilih Kimi ketika biaya, volume, atau kontrol data lebih penting daripada beberapa poin terakhir.
Para Pesaing Sekilas
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| Tipe | Bobot terbuka (MIT yang dimodifikasi) | Tertutup | Tertutup |
| Arsitektur | MoE, total 1T / aktif 32B | Tidak diungkapkan | Tidak diungkapkan |
| Jendela konteks | 256K token | Besar | Besar |
| Host Mandiri | Ya | Tidak | Tidak |
| Harga (per Juta token) | $0.95 masuk / $4.00 keluar | Lebih tinggi, hanya sewa | Lebih tinggi, hanya sewa |
Perbedaan struktural adalah berita utama. Kimi memberi tahu Anda persis apa itu dan memungkinkan Anda menjalankannya sendiri. Dua lainnya adalah layanan yang Anda panggil.
Tolok Ukur Pengodean
Ini adalah skor yang dilaporkan oleh Moonshot. Anggaplah ini sebagai kerangka vendor, karena beberapa suite adalah milik Moonshot sendiri, tetapi polanya konsisten dan layak dibaca.
| Tolok Ukur | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5 menempati posisi teratas pada dua yang pertama; Claude Opus memimpin pada MLS Bench Lite dan tetap dekat di mana-mana. Kimi berada di bawahnya pada masing-masing. Jaraknya nyata tetapi kecil pada Kimi Code Bench v2, lebih lebar pada Program Bench. Jika pekerjaan Anda terlihat seperti tolok ukur kedua itu, model frontier (terdepan) layak dipertahankan.
Tolok Ukur Agen dan Penggunaan Alat
Agen pengodean hidup atau mati pada panggilan alat, bukan hanya generasi kode. Di sini gambaran menjadi lebih ketat.
| Tolok Ukur | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
Pada MCP Mark Verified, Kimi sebenarnya sedikit mengungguli Claude Opus, meskipun GPT-5.5 jauh di depan. Pada MCP Atlas, ketiganya berada dalam selisih sekitar lima poin. Untuk beban kerja agen, Kimi lebih dekat dengan yang lain daripada skor pengodean mentahnya, yang penting karena di situlah biaya token menumpuk.
Biaya adalah Kemenangan Kimi
Tolok ukur mengukur kualitas. Mereka tidak mengukur tagihan. Kimi K2.7 Code berharga $0.95 per juta token input dan $4.00 per juta token output, dengan cache hit seharga $0.19 per juta. Model frontier tertutup berharga jauh lebih mahal per token, dan Anda tidak bisa menghindarinya dengan menghostingnya; tidak ada unduhan.
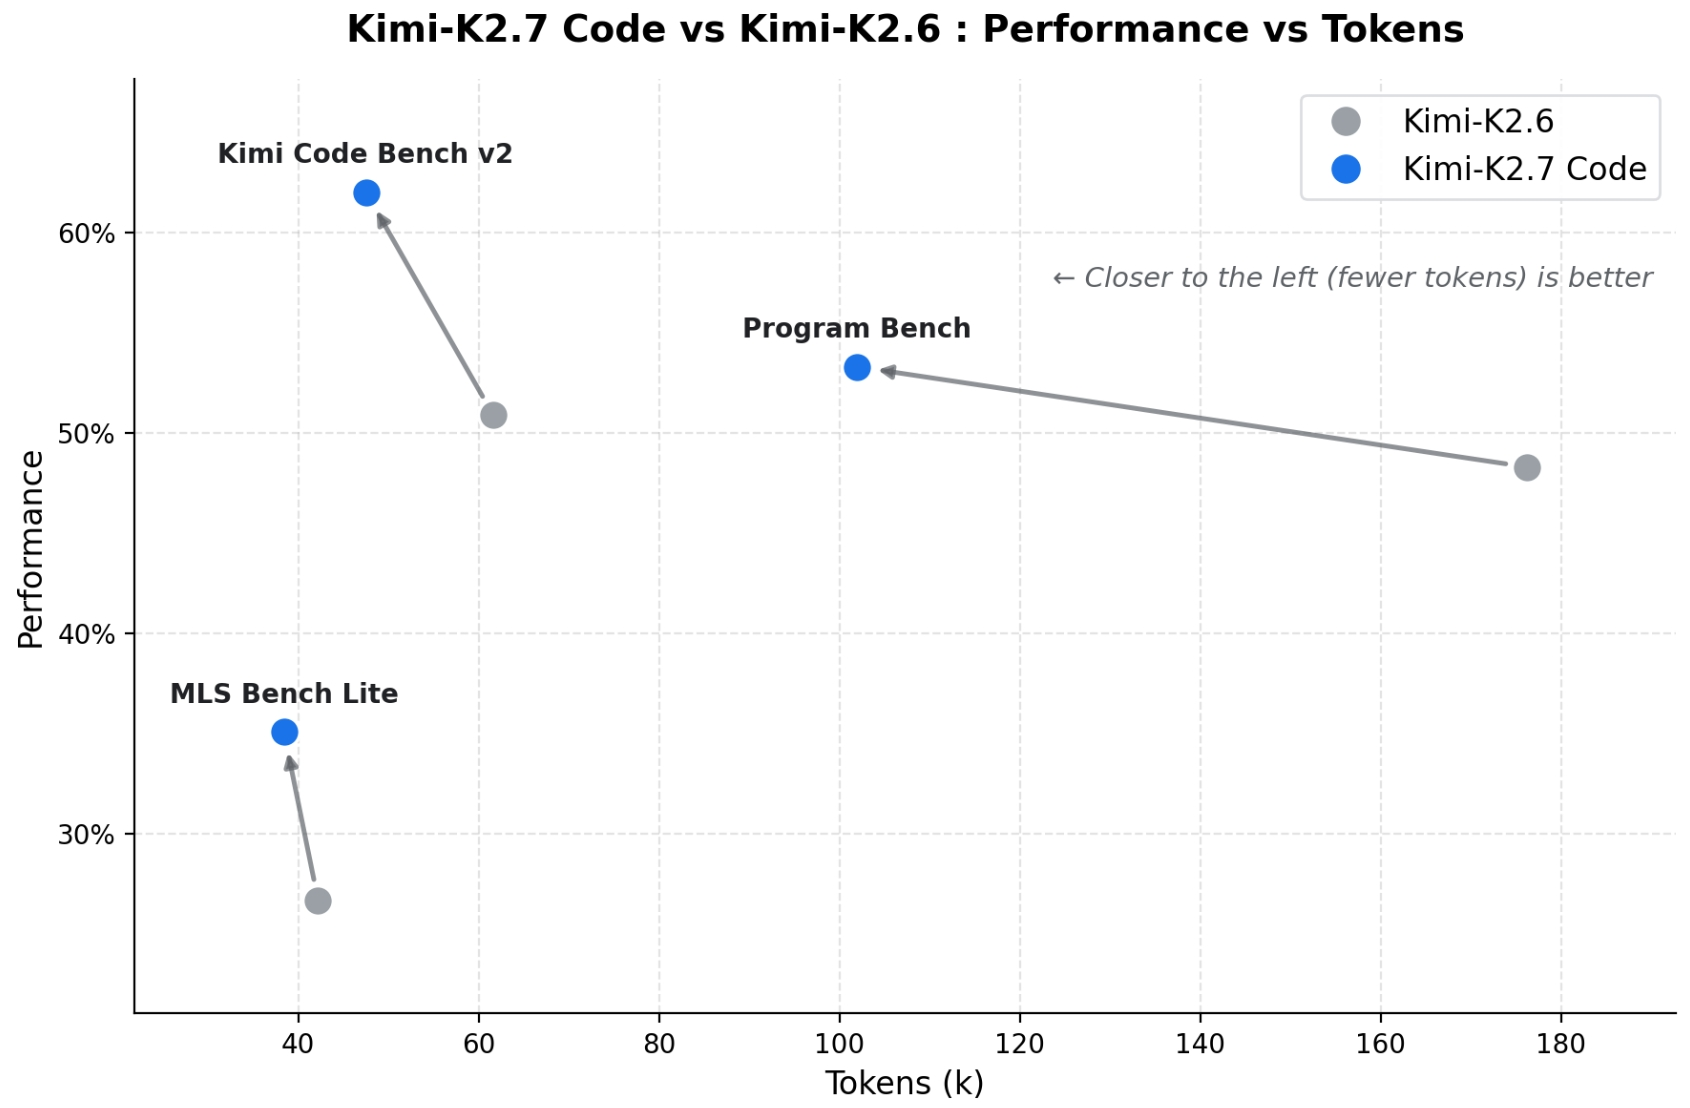
Dua faktor menggabungkan penghematan:
- Bobot terbuka berarti opsi tanpa token. Host sendiri di perangkat keras Anda dan biaya per token hilang sepenuhnya. Anda menukarnya dengan waktu GPU.
- Penalaran yang lebih ramping. K2.7 Code menggunakan sekitar 30% lebih sedikit token berpikir dibandingkan K2.6 untuk pekerjaan yang sama, jadi setiap langkah agen menagih lebih sedikit. Panduan kami tentang mengurangi biaya token agen menjelaskan lebih dalam mengapa hal itu penting.
Untuk agen yang membuat ratusan panggilan alat per tugas, model yang 90% sebagus dengan harga sepersekian seringkali menang dalam nilai total.
Konteks dan Keterbukaan
Ketiganya menangani konteks panjang dengan baik; jendela Kimi adalah 256K token, cukup untuk layanan lengkap ditambah pengujiannya dalam satu prompt. Pembeda yang lebih besar adalah lisensi. Bobot MIT Kimi yang dimodifikasi memungkinkan Anda menyetel halus (fine-tune), mengaudit, dan menjalankan model secara air-gapped. Untuk tim dengan aturan kepatuhan atau residensi data, itu bukan hal yang menyenangkan; itu adalah faktor penentu, dan model tertutup sama sekali tidak dapat dipertimbangkan.
Kapan Memilih Masing-Masing
Pilih GPT-5.5 atau Claude Opus jika:
- Anda membutuhkan kualitas pengodean sekali jalan (single-shot) tertinggi dan beberapa poin tolok ukur membenarkan biayanya.
- Anda baik-baik saja menyewa layanan tertutup dengan SLA yang dikelola.
- Tugas terberat Anda terlihat seperti Program Bench, di mana jaraknya paling lebar.
Pilih Kimi K2.7 Code jika:
- Anda menjalankan beban kerja agen bervolume tinggi di mana biaya token menentukan kelayakan.
- Data harus tetap berada di infrastruktur Anda sendiri.
- Anda ingin menyetel halus (fine-tune) atau mengaudit model.
- Anda mengoptimalkan nilai total, bukan posisi teratas di papan peringkat.
Untuk bidang yang lebih luas, perbandingan MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 kami mencakup penantang berbobot terbuka lainnya, dan DeepSeek V4 vs Claude Opus untuk pengodean membahas perbandingan terbuka-vs-tertutup lainnya. Jika Anda membandingkan agen daripada modelnya, lihat Claude Code vs OpenAI Codex.
Coba Perbandingan Sendiri
Tolok ukur adalah titik awal, bukan putusan untuk basis kode Anda. Uji coba yang jujur adalah menjalankan ketiga model pada tugas Anda sendiri dan membaca hasilnya. Kimi Code CLI memberi Anda agen secara gratis untuk memulai, dan Anda dapat memanggil API setiap model secara langsung untuk membandingkan output mentah.
Saat Anda melakukannya, uji titik akhir di Apidog: kirim prompt yang sama ke setiap model, simpan panggilannya secara berdampingan, dan bandingkan kualitas respons, latensi, serta penggunaan token di satu tempat. Unduh Apidog untuk menjalankan adu kompetisi.
FAQ
Apakah Kimi K2.7 Code lebih baik dari Claude Opus atau GPT-5.5? Berdasarkan tolok ukur pengodean yang dilaporkan Moonshot, tidak; model tertutup mencetak skor lebih tinggi pada sebagian besar suite. Keunggulan Kimi adalah bobot terbuka dan biaya yang jauh lebih rendah sambil tetap berada dalam beberapa poin.
Seberapa jauh lebih murah Kimi? Harganya $0.95 per juta token input dan $4.00 per juta token output, serta gratis untuk di-host sendiri. Model frontier tertutup berharga lebih mahal per token dan tidak dapat di-host sendiri.
Bisakah saya menjalankan Kimi K2.7 Code sendiri? Ya. Bobotnya terbuka di bawah lisensi MIT yang dimodifikasi; layani dengan vLLM, SGLang, atau KTransformers.
Mana yang terbaik untuk agen pengodean? Untuk kualitas mentah, GPT-5.5 memimpin. Untuk agen bervolume tinggi yang efisien biaya, Kimi adalah nilai yang lebih baik, dan skornya dekat pada tolok ukur agen.
Apakah tolok ukur ini netral? Beberapa suite adalah milik Moonshot sendiri, jadi bacalah sebagai kerangka vendor. Jarak konsisten ke model frontier adalah sinyal yang berguna, bukan angka persisnya.
Ringkasan
Kimi K2.7 Code tidak mengalahkan Claude Opus atau GPT-5.5 pada sebagian besar tolok ukur pengodean, dan Moonshot tidak berpura-pura demikian. Model ini mencetak beberapa poin lebih rendah sementara biayanya jauh lebih murah dan menyediakan bobot terbuka yang dapat Anda jalankan sendiri. Untuk kualitas setinggi mungkin, model frontier tertutup masih menang. Untuk agen bervolume tinggi, penerapan pribadi, atau siapa pun yang mempertimbangkan nilai total di atas posisi teratas, Kimi adalah pilihan yang lebih cerdas. Jalankan ketiga model pada kode Anda sendiri, bandingkan output di Apidog, dan biarkan beban kerja Anda yang memutuskan.