
Kebanyakan orang bertemu model baru dengan membuka kotak obrolan dan mengetik di dalamnya. Jev menghukum refleks itu. Ini adalah model Sistem Satu dari TypeSafe AI, dan sama sekali tidak menghasilkan prosa: Anda memberikan status program ditambah serangkaian pertanyaan berjenis, dan ia mengembalikan keputusan dengan probabilitas terlampir. Perubahan peran itulah keseluruhan tekniknya. Model bahasa Anda terus menulis; Jev memutuskan apa yang terjadi selanjutnya, dan kode Anda memutuskan apa yang harus dilakukan dengan keputusan tersebut.
Panduan ini mencakup arsitektur di sekitar panggilan, bukan panggilan itu sendiri. Jika Anda memerlukan pengantar terlebih dahulu, mulailah dengan apa itu Jev, lalu baca postingan peluncuran TypeSafe sendiri untuk kerangka perusahaan.
Apa yang membuat Jev luar biasa
Tiga primitif mencakup semua yang dilakukan Jev. noul mengembalikan probabilitas bahwa satu pernyataan tentang status adalah benar. choice memilih satu opsi dari peta kriteria (hingga 255 opsi) dan mengembalikan pilihan, distribusi probabilitas penuh, dan nilai kepercayaan. score menempatkan status pada rubrik terurut dari 2 hingga 10 level dan mengembalikan level, legenda, probabilitas, dan kepercayaan. Latar belakang tentang perusahaan dan keluarga model ada di artikel kami tentang TypeSafe AI.
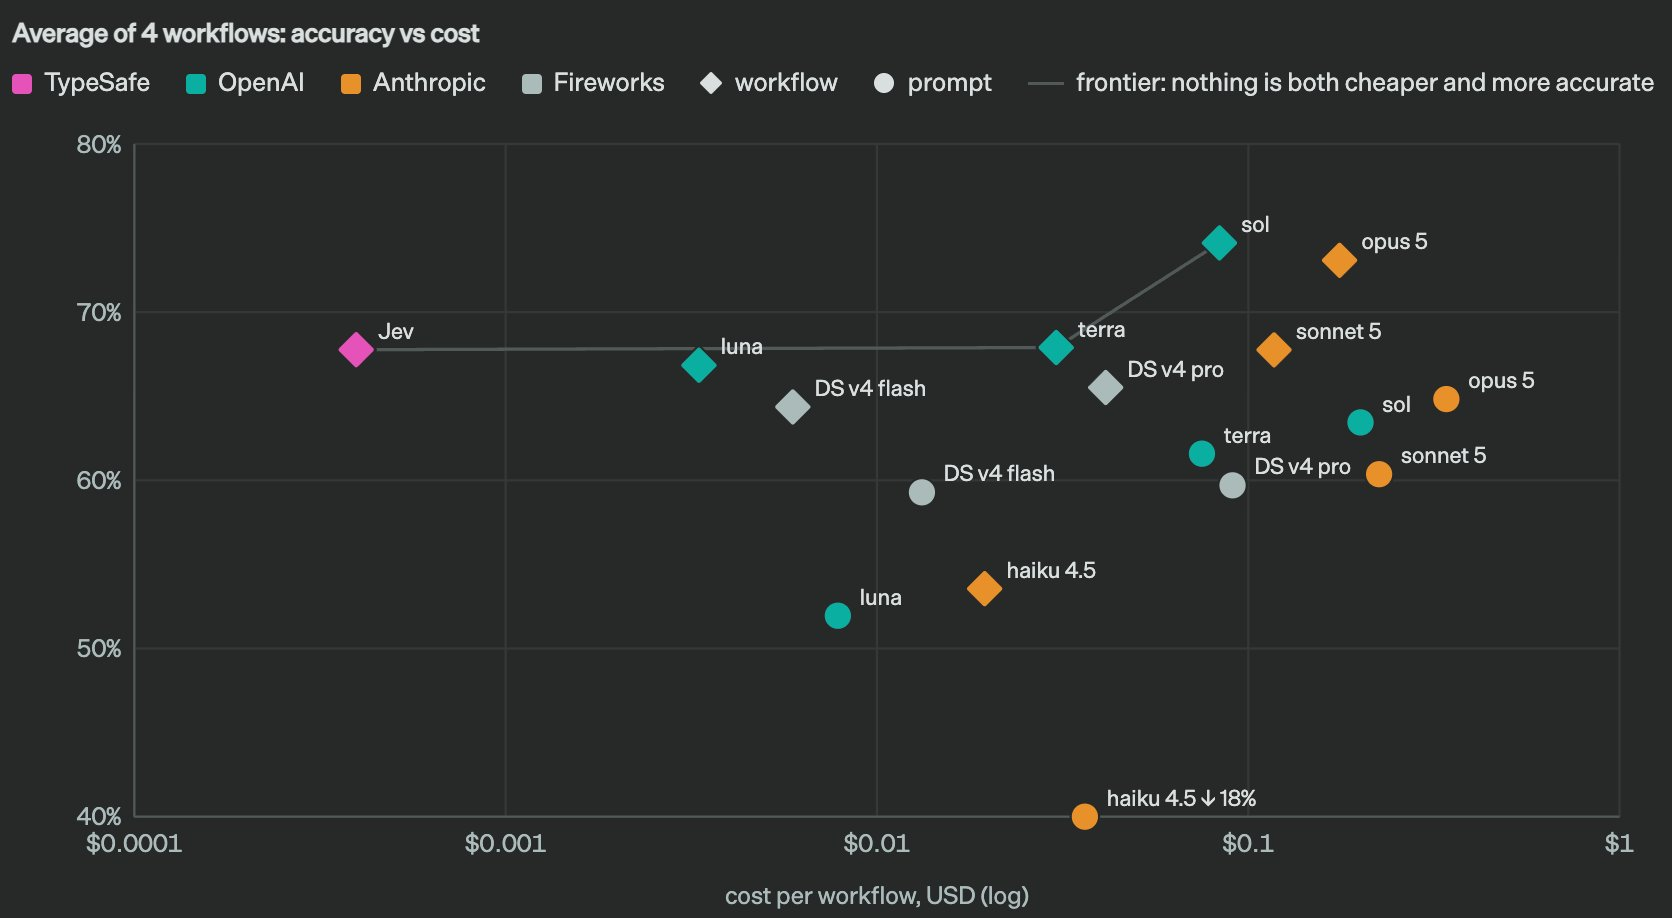
Empat properti penting untuk arsitektur. Setiap jawaban tiba dalam tipe yang sudah dipahami program Anda. Setiap jawaban membawa ketidakpastiannya sendiri, sehingga "tidak yakin" menjadi cabang alih-alih kejutan. Banyak pertanyaan tentang satu status terselesaikan dalam satu lintasan. Dan dengan biaya $0,042 per juta token input tanpa biaya token output, Anda mampu bertanya pada setiap peristiwa daripada pada sampel.
Jalankan Jev sebagai penilai, bukan penulis
Empat peran, terpisah secara rapi:
- LLM menghasilkan. Kode, draf email, ringkasan, rencana.
- Jev memutuskan. Ia mengklasifikasikan permintaan, menilai risiko, memilih rute, dan memeriksa output terhadap kriteria yang Anda tulis sebelumnya.
- Kode Anda mengontrol. Ambang batas dan aturan memutuskan apakah akan bertindak, mencoba lagi, meningkatkan, atau berhenti.
- Manusia menangani kasus-kasus ekstrem. Kepercayaan rendah ditambah risiko tinggi diteruskan ke manusia.
Inilah mengapa pembagian ini berhasil. Model bahasa fleksibel karena dapat mengeluarkan apa pun, dan kebebasan yang sama inilah yang membuatnya canggung untuk disembunyikan di dalam alur kerja yang Anda andalkan. Kerangka TypeSafe adalah bahwa Jev "menyerah menghasilkan string" dan sebagai imbalannya mendapatkan kontrak yang sempit: serangkaian jawaban yang mungkin diperbaiki sebelum permintaan meninggalkan server Anda, setiap hasil sesuai dengan bentuk yang dideklarasikan, dan ketidakpastian adalah angka yang dapat Anda bandingkan dengan ambang batas.
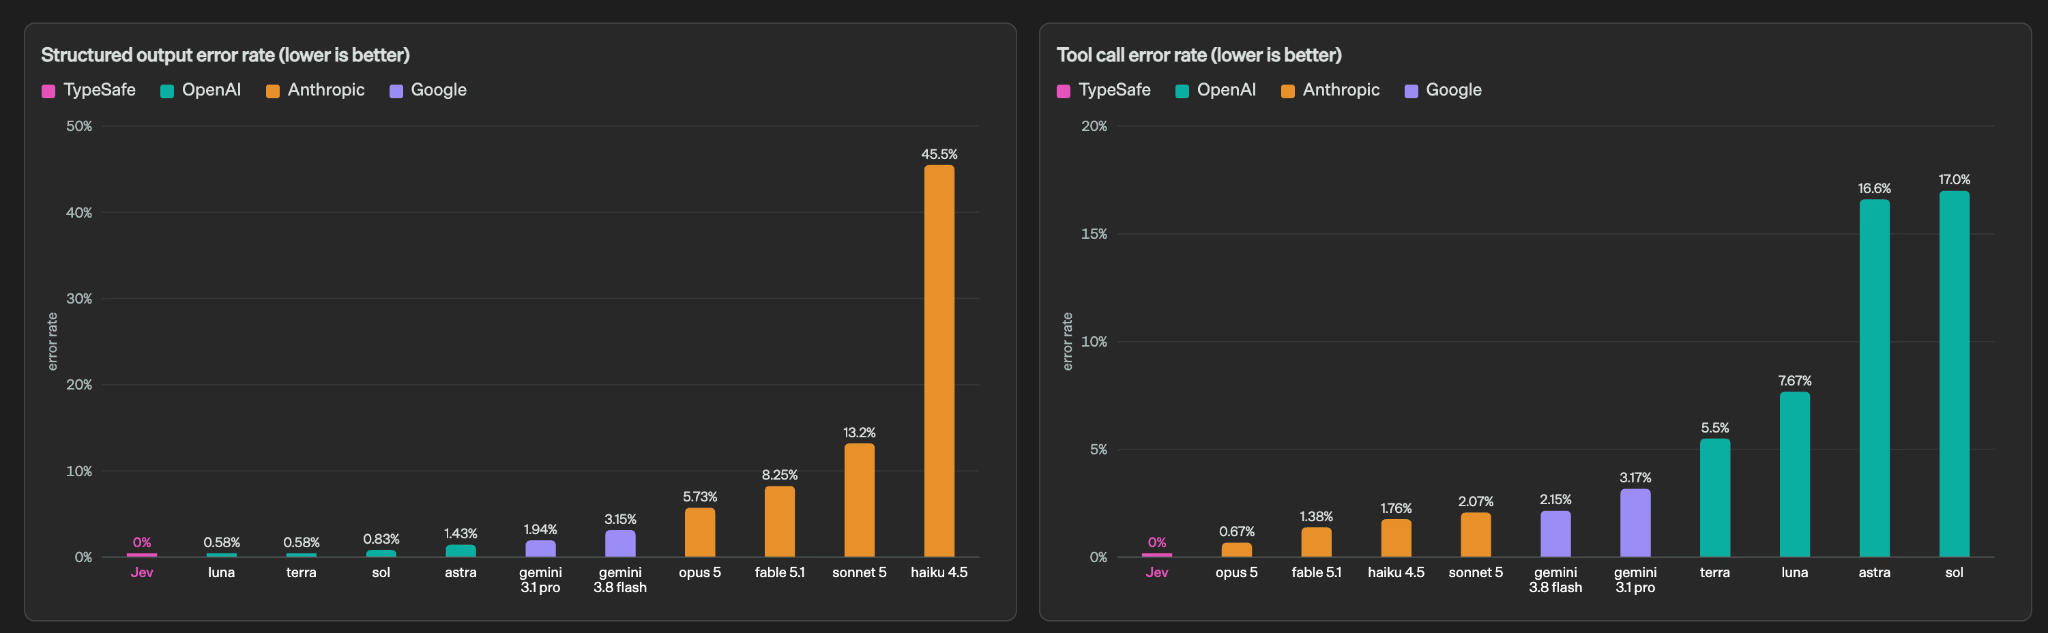
Sisi biaya mengikuti dari perdagangan yang sama. TypeSafe melaporkan waktu respons end-to-end 70ms hingga 500ms, dan mengklaim angka 193,6x lebih cepat dan 444,6x lebih murah pada alur kerja yang diujinya. Anggap itu sebagai angka vendor, bukan benchmark independen. Poin struktural tetap berlaku: model yang mahal hanya berjalan ketika sesuatu benar-benar harus ditulis, dan penilaian berulang di sekitarnya berjalan di tempat yang murah.
Mendesain pertanyaan yang bisa dijawab Jev
Setiap permintaan membawa satu state bersama dan serangkaian pertanyaan independen. Jev membaca status sekali dan menjawab semuanya. Panggilan triage dukungan terlihat seperti ini:
{
  "model": "jev-latest",
  "state": {
    "message": "Saya sudah mencoba menghubungkan Stripe selama tiga hari. Saya kehilangan penjualan dan ini perlu diperbaiki hari ini.",
    "plan": "Pro",
    "account_age_months": 14,
    "recent_technical_tickets": 3
  },
  "questions": {
    "department": {
      "type": "choice",
      "instruction": "Tim mana yang harus menangani tiket ini?",
      "criteria": {
        "billing": "Pembayaran, biaya, faktur, perubahan langganan",
        "technical": "Bug, perilaku rusak, integrasi gagal",
        "sales": "Harga, paket, pertanyaan yang diajukan sebelum pembelian"
      }
    },
    "frustration": {
      "type": "score",
      "instruction": "Seberapa frustrasi pelanggan ini?",
      "criteria": [
        "Tenang dan lugas",
        "Frustrasi tapi sopan",
        "Sangat frustrasi atau mengancam akan pergi"
      ]
    },
    "urgent": {
      "type": "noul",
      "instruction": "Pelanggan membutuhkan resolusi hari ini."
    }
  }
}
Tiga kebiasaan memisahkan pertanyaan yang berhasil dari pertanyaan yang goyah.
Berhenti menulis prompt. Persona, contoh kerja, dan pendahuluan panjang mengarahkan generator teks. Jev tidak membuat teks. Ia membutuhkan status, satu pertanyaan atomik, dan deskripsi persis tentang arti setiap jawaban. Kriteria deskriptif lebih baik daripada label kosong: "Pembayaran, biaya, faktur, perubahan langganan" mengarahkan lebih baik daripada kata "billing" saja. Jangan minta ia menjelaskan dirinya sendiri, karena responsnya berisi keputusan, probabilitas, dan kepercayaan, dan tidak ada yang lain.
Satu pertanyaan, satu penilaian. "Apakah prospek ini berharga, mendesak, dan kemungkinan akan membeli?" adalah tiga pertanyaan yang memakai mantel. Pisahkan dan gabungkan hasilnya dalam kode, di mana Anda dapat melihat bobot dan mengubahnya.
Jauhkan aritmatika dari model. Jev menilai makna. Program Anda melakukan perhitungan, menerapkan tabel diskon, dan memeriksa ketentuan kontrak. Pembagian itu yang membuat semuanya dapat diaudit.
TypeSafe juga menyediakan keterampilan siap pakai yang mengajarkan konvensi ini kepada agen pengkodean, dapat diinstal di Claude Code dengan claude plugin marketplace add typesafe-ai/skills atau di tempat lain dengan npx skills add typesafe-ai/skills. Halaman keterampilan agen memiliki detailnya.
Jaga agar status tetap bersih
Status yang relevan lebih baik daripada status maksimal. Tiga bagian biasanya mencakupnya: objek yang dinilai, konteks yang diperlukan untuk membaca objek itu, dan fakta yang akan mengubah keputusan jika berubah. Segala sesuatu yang lain adalah kebisingan yang Anda bayar untuk dikirim.
Hapus baris log yang duplikat, riwayat yang mendahului masalah saat ini, dan kalimat apa pun yang menyatakan kesimpulan yang Anda harapkan akan dicapai oleh model. Batas keras adalah 64k token per permintaan, dengan 32k tersedia untuk status ditambah pertanyaan terpanjang, tetapi akurasi dapat bergeser jauh sebelum Anda mencapainya. Ketika perutean menjadi tidak jelas, mengecilkan status biasanya merupakan perbaikan yang lebih cepat daripada menulis ulang kriteria.
Pertanyaan paralel dan gerbang kepercayaan
Karena Jev membaca status sekali, pertanyaan ketiga belas jauh lebih murah daripada putaran kedua. Kirimkan setiap penilaian independen yang dapat mengubah tindakan: niat, risiko, urgensi, sentimen, relevansi, langkah selanjutnya yang diperlukan. Kemudian hapus pertanyaan apa pun yang jawabannya tidak pernah mengubah apa yang dilakukan kode Anda. Sinyal yang tidak digunakan adalah biaya pemeliharaan tanpa imbalan.
Cocokkan primitif dengan bentuk penilaian. Gradien seperti tingkat keparahan, kualitas, dan kesesuaian termasuk dalam score, bukan dalam pilihan ya/tidak paksa. Pernyataan faktual tunggal termasuk dalam noul. Kumpulan tujuan tetap termasuk dalam choice.
Gerbang adalah tempat arsitektur sebenarnya berada. Jawaban yang diketik masih bisa menjadi jawaban yang salah, jadi kepercayaan memutuskan apa yang terjadi selanjutnya. Satu pola awal yang bisa diterapkan: bertindak secara otomatis di atas 0,85, serahkan 0,55 hingga 0,85 ke model yang lebih kuat atau putaran kedua, dan antrekan apa pun di bawah 0,55 untuk manusia. Angka-angka persis tersebut bersifat ilustratif. Pola perutean kepercayaan TypeSafe menetapkan ambang batas terpisah per tindakan berdasarkan biaya kesalahan, dan halaman kepercayaannya memberitahu Anda untuk "menguji dengan data Anda sendiri, dan sesuaikan saat Anda mengamati hasilnya." Setelah ambang batas Anda disetel, kunci model: jev-latest mengikuti rilis stabil terbaru, sementara jev-1.13.0 membekukan perilaku yang Anda ukur.
Uji lapisan keputusan di Apidog
Lapisan keputusan hanya layak dipercaya jika Anda dapat membuktikan bagaimana perilakunya. Itu berarti permintaan yang disimpan dan penegasan, bukan riwayat terminal dari curl satu kali. Apidog memberi Anda keduanya, dan penegasan terlihat berbeda dari tes API normal karena Anda memeriksa angka dan nilai enum alih-alih string.
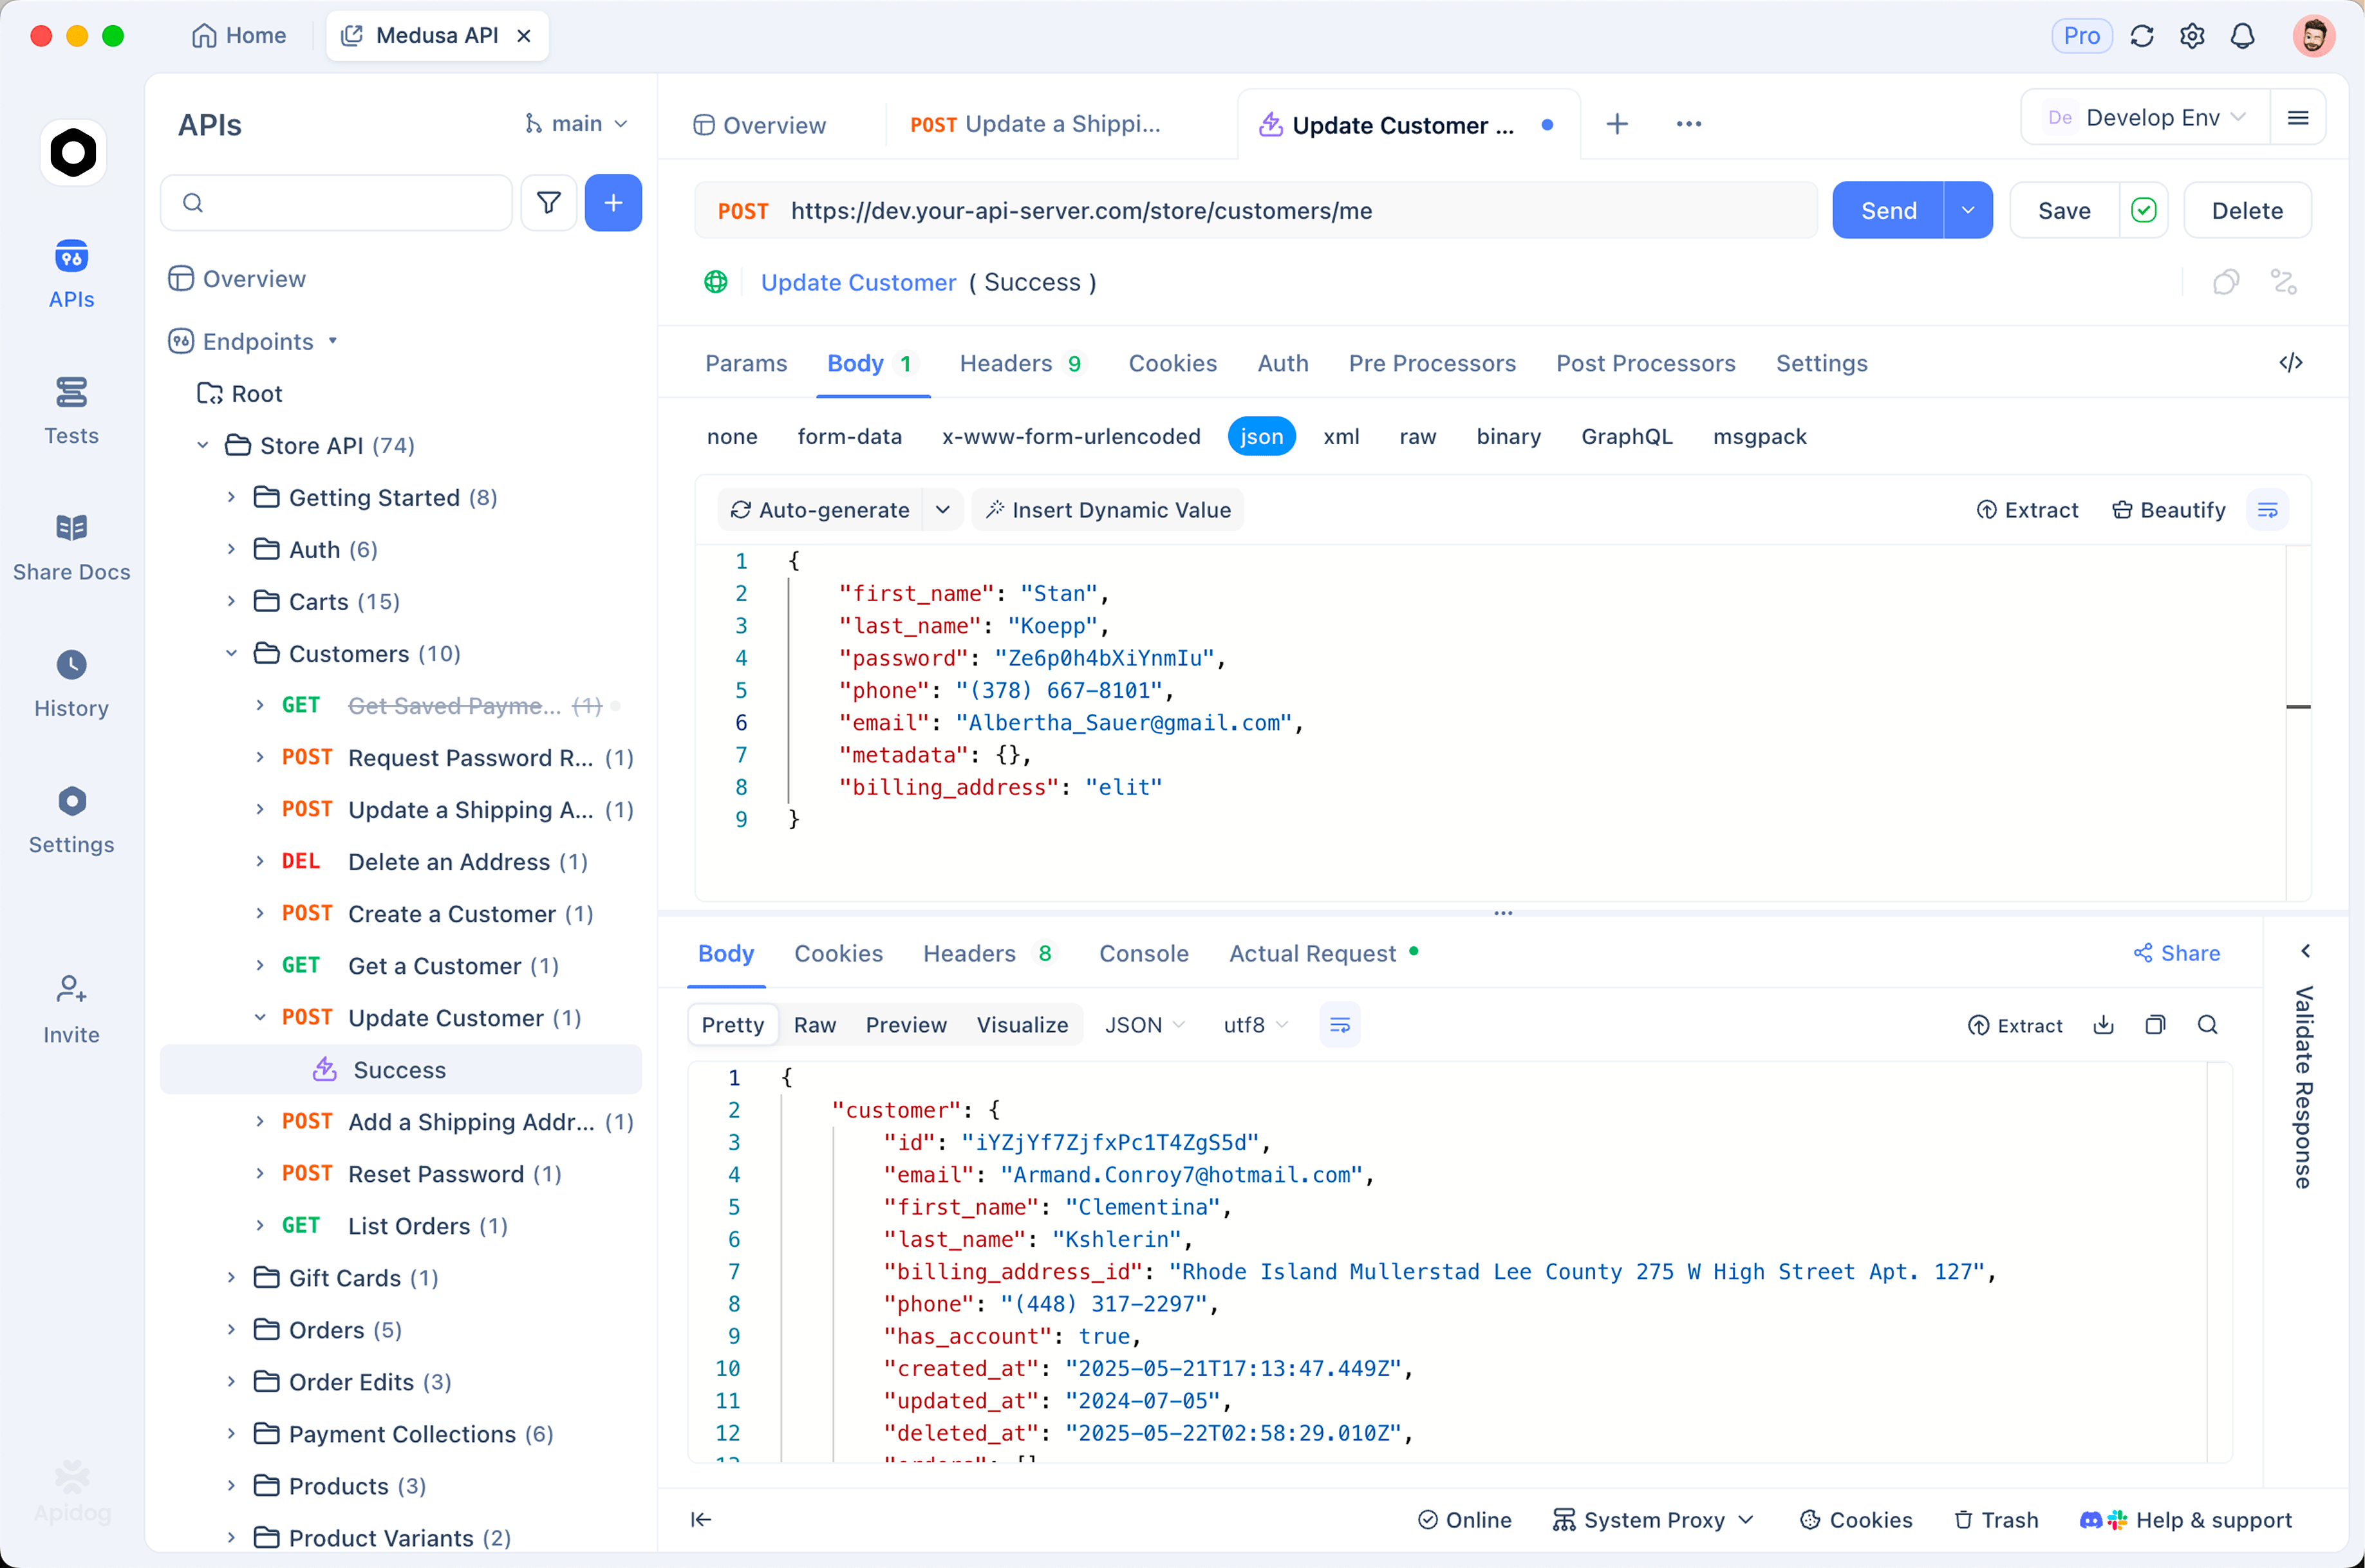
Simpan kunci sebagai variabel lingkungan. Buat lingkungan bernama TypeSafe, tambahkan TYPESAFE_API_KEY sebagai nilai lokal agar tetap di mesin Anda, dan referensikan sebagai {{TYPESAFE_API_KEY}} dalam token Bearer. Panduan kami tentang lingkungan dan variabel rahasia mencakup aturan cakupan.
Kirim panggilan sebenarnya. POST https://api.typesafe.ai/v1/systemone dengan badan status-plus-pertanyaan di atas.
Tegaskan pada keputusan. Tambahkan penegasan pasca-pemrosesan seperti answers.department.choice sama dengan billing, answers.urgent.noul lebih besar dari 0.9, dan answers.frustration.score lebih besar dari 1.5. Sekarang perubahan perilaku akan menggagalkan tes alih-alih salah merutekan tiket secara diam-diam.
Kemudian bangun skenario yang penting. Simpan sekumpulan kecil status berlabel sebagai skenario tes: pertanyaan tenang, ancaman pembatalan marah, dan satu pesan yang sengaja ambigu yang harus diwaspadai oleh router yang baik. Tegaskan kepercayaan tinggi pada dua yang pertama dan tegaskan bahwa kepercayaan turun di bawah gerbang Anda pada yang ketiga. Skenario tunggal itu mengubah penyetelan ambang batas menjadi bukti alih-alih dugaan, dan menangkap kegagalan yang paling sulit diperhatikan secara manual: seseorang mengubah deskripsi kriteria, setiap respons masih valid, dan perutean bergeser secara diam-diam. Jalankan di CI dan penulisan ulang menggagalkan build.
Buat tiruan bentuk respons agar pekerjaan frontend tidak membakar token. Karena objek answers dideklarasikan sebelum permintaan, tiruan dan respons langsung tidak dapat menyimpang. Unduh Apidog untuk menyiapkannya; paket gratis mencakup tim berisi empat orang.
Lima alur kerja di mana lapisan keputusan menguntungkan
- Pemeriksa universal. Bungkus setiap panggilan LLM yang mahal. Periksa prompt masuk untuk injeksi, alat yang dipilih untuk ketidaksesuaian yang jelas, output untuk persyaratan yang hilang, dan jawaban akhir untuk klaim yang tidak didukung oleh materi sumber. Pemeriksaan murah di sekitar otak yang mahal.
- Menara kontrol dukungan. Klasifikasikan tiket, deteksi urgensi, frustrasi, niat pengembalian dana, dan risiko pembatalan dalam satu panggilan, lalu rutekan. Keuntungannya adalah lebih sedikit tiket di antrean yang salah dan lebih sedikit akun berharga yang terabaikan.
- Kualifikasi prospek. Nilai kesesuaian perusahaan, kematangan teknis, masalah yang dinyatakan, niat membeli, dan urgensi sebagai sinyal terpisah, lalu gabungkan dengan bobot yang Anda miliki dan dapat Anda pertahankan dalam tinjauan pipeline.
- Router model. Putuskan per permintaan apakah kode deterministik, model kecil, model frontier, atau manusia yang harus menanganinya. Di sinilah penghematan biaya biasanya muncul pertama kali.
- Pekerjaan set data besar. Jalankan penilaian semantik yang sama di seluruh log dukungan, ulasan, daftar, transkrip, atau jejak agen untuk mengekstrak fitur terstruktur dan memberi peringkat rekaman yang layak diperiksa manusia. Analisis yang hanya menjadi praktis ketika setiap keputusan cepat dan hampir gratis.
FAQ
Apakah saya masih membutuhkan model bahasa? Ya. Jev tidak dapat menulis balasan, ringkasan, atau kode. Ia memutuskan sistem mana yang harus melakukannya, dan ia dapat menilai draf setelahnya terhadap kriteria eksplisit seperti kepatuhan kebijakan atau apakah jawabannya berisi janji yang tidak Anda buat.
Bagaimana ini berbeda dari mode JSON atau output terstruktur? Output terstruktur membatasi pemformatan model teks; model masih menghasilkan token dan masih dapat menyatakan sesuatu yang salah dalam bentuk yang valid. Jev mengembalikan distribusi probabilitas atas sekumpulan jawaban yang Anda definisikan, sehingga ketidakpastian adalah bidang kelas satu. Penjelasan kami tentang output terstruktur OpenAI mencakup sisi lain dari perbandingan itu.
Bagaimana cara mendapatkan akses? Jev sedang dalam akses awal dengan daftar tunggu, jadi ini belum swalayan. TypeSafe membawa pengembang dari daftar secara bertahap, dan Anda masuk di console.typesafe.ai setelah Anda diterima. Ini juga tersedia melalui Vercel AI Gateway sebagai typesafe-ai/jev melalui experimental_evaluate di AI SDK 7, yang khusus SDK dan tidak diekspos pada endpoint yang kompatibel dengan OpenAI. Penjelasan kami tentang mendapatkan kunci API Jev memiliki detail permintaan dan SDK.
Bisakah saya menjalankan sesuatu seperti ini secara lokal? Beberapa proyek mereproduksi bagian dari ide tersebut dengan decoding terbatas melalui bobot terbuka. Kami membandingkannya di OpenJev dan alternatif Jev sumber terbuka, termasuk seberapa setia masing-masing terhadap kepercayaan yang dikalibrasi.
Di mana ini menempatkan Anda
Jev bukanlah model yang menggantikan model Anda yang lain. Ini adalah lapisan yang memutuskan kapan, di mana, dan apakah mereka berjalan. Bangunlah seperti itu: satu status yang bersih, pertanyaan atomik dengan kriteria eksplisit, evaluasi paralel, dan gerbang kepercayaan di depan setiap tindakan. Kemudian buktikan gerbang itu berfungsi dengan skenario yang disimpan di Apidog sebelum merutekan satu tiket nyata.