
DeepSeek V4 Pro meninggalkan tahap pratinjau pada 12 Agustus 2026. Build GA, yang diberi cap 0813, kini melayani endpoint API deepseek-v4-pro, dan hadir dengan angka-angka yang terlihat seperti salah ketik: jendela konteks 1 juta token, output maksimum 384 ribu token, dan harga input yang turun menjadi $0,003625 per juta token pada cache hit. Seperti yang dilaporkan Unite.AI, model yang menghabiskan empat bulan dalam pratinjau kini menjadi unggulan DeepSeek.
Liputan peluncuran memberi tahu Anda apa yang dikirim, bukan cara memanggilnya. Panduan ini mencakup bagian praktis: permintaan pertama dengan OpenAI SDK, mode berpikir dan bidang reasoning_content, streaming, pemanggilan alat, dan perhitungan prompt-caching yang menentukan apakah konteks 1 juta itu terjangkau atau merugikan. Jika Anda ingin memahami latar belakang arsitekturnya terlebih dahulu, baca Apa itu DeepSeek V4 lalu kembali.
TL;DR
- DeepSeek-V4-Pro-0813 adalah snapshot GA di balik endpoint `deepseek-v4-pro` per 12 Agustus 2026, build yang akan ditargetkan dalam produksi.
- API ini kompatibel dengan OpenAI: arahkan SDK `openai` ke `https://api.deepseek.com`, atur `model="deepseek-v4-pro"`, selesai. Format Pesan Anthropic dan API Respons DeepSeek sendiri juga berfungsi.
- Konteks 1 juta token, output maksimal 384K, tiga mode berpikir (`non-think`, `think high`, `think max`) yang mengembalikan bidang `reasoning_content` bersamaan dengan jawaban.
- Harga: $0,435/Juta input (cache miss), $0,003625/Juta input (cache hit, 120x lebih murah), $0,87/Juta output. Caching otomatis pada awalan prompt yang berulang.
- DeepSeek memperingatkan pada 6 Agustus bahwa kenaikan harga API yang "signifikan" akan datang. Belum ada angka atau tanggal, jadi alokasikan anggaran dengan cadangan.
- Uji endpoint, periksa stream SSE, dan simpan lingkungan pro/flash secara berdampingan di Apidog sebelum Anda mengintegrasikannya ke dalam sesuatu yang nyata.
Apa yang diubah build GA 0813 bagi developer
Pratinjau dibuka pada April 2026, model V4 Flash yang lebih kecil dikirim pada Juli, dan pada 12 Agustus model Pro lulus ke ketersediaan umum sebagai build 0813, mengikuti konvensi cap tanggal DeepSeek yang biasa (dengan cara yang sama v3-0324 menandai snapshot V3).
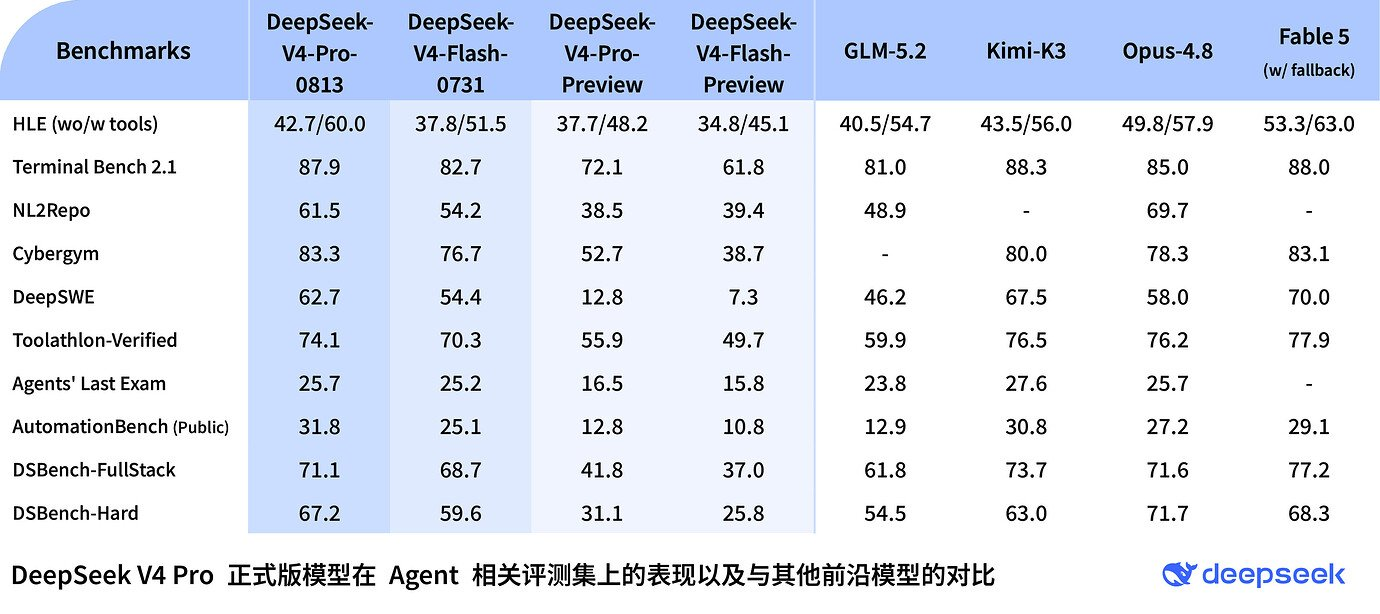
Tiga hal berubah dengan GA:
- Snapshot ini stabil. Model pratinjau dapat berubah sewaktu-waktu, yang secara diam-diam membatalkan evaluasi dan penyetelan prompt. Build 0813 adalah target tetap sampai DeepSeek mengumumkan snapshot baru.
- Endpoint adalah alias produksi. Pada API resmi Anda memanggil
deepseek-v4-prodan mendapatkan build 0813; untuk mengunci snapshot secara eksplisit, OpenRouter mencantumkannya sebagaideepseek/deepseek-v4-pro-0813. - Seluruh fitur sudah aktif. Mode berpikir, pemanggilan fungsi, output terstruktur, prompt caching, dan API multi-format (OpenAI, Anthropic, Responses) semuanya aktif pada endpoint GA.
Di balik layar, V4 Pro adalah model mixture-of-experts dengan total 1,6 triliun parameter dan 49 miliar aktif per token. Kisah rekayasa utamanya adalah efisiensi: dua skema perhatian, Compressed Sparse Attention dan Heavily Compressed Attention, menurunkan komputasi inferensi satu token menjadi 27% dari V3.2 dan cache KV menjadi 10%. Pengurangan cache KV itulah yang membuat konteks 1 juta token dapat dilayani dengan harga ini, bukan sekadar fitur demo.
DeepSeek V4 Pro 0813: spesifikasi sekilas
| Spesifikasi | DeepSeek V4 Pro 0813 |
|---|---|
| Rilis | GA pada 12 Agustus 2026 (snapshot 0813) |
| Arsitektur | Mixture-of-experts, total 1,6 T parameter, 49 M aktif per token |
| Perhatian | Compressed Sparse Attention + Heavily Compressed Attention |
| Biaya Inferensi vs V3.2 | 27% dari komputasi satu token, 10% dari cache KV |
| Jendela Konteks | 1,000,000 token |
| Output Maks | 384K tokens |
| Mode Berpikir | non-think, think high, think max |
| Harga Input | $0.435/M tokens (cache miss), $0.003625/M (cache hit) |
| Harga Output | $0.87/M tokens |
| Format API | OpenAI Chat Completions, Anthropic Messages, DeepSeek Responses |
| Model ID | deepseek-v4-pro |
| Saudara yang lebih kecil | deepseek-v4-flash (total 284B / aktif 13B), $0.14/M input, $0.28/M output |
Mengenai kemampuan, kartu model DeepSeek sendiri mencantumkan SWE-bench Verified pada 80,6%, Terminal Bench 2.0 pada 67,9%, GPQA Diamond pada 90,1%, dan LiveCodeBench pada 93,5% untuk V4-Pro-Max, konfigurasi berpikir maksimum. Angka-angka tersebut adalah laporan vendor sendiri yang belum diverifikasi pihak ketiga, jadi lakukan evaluasi spesifik tugas Anda sendiri sebelum memigrasikan hal penting apa pun.
Dapatkan kunci API dan lakukan permintaan pertama Anda
Pengaturan memakan waktu sekitar lima menit:
- Buat akun di platform DeepSeek (platform.deepseek.com) dan tambahkan kredit, API ini prabayar.
- Buka Kunci API, hasilkan kunci, dan salin segera (hanya ditampilkan sekali).
- Ekspor sebagai variabel lingkungan daripada menempelkannya ke dalam kode:
export DEEPSEEK_API_KEY="sk-..."
API ini berbicara protokol OpenAI Chat Completions, jadi paket openai standar adalah kliennya. Baik https://api.deepseek.com maupun https://api.deepseek.com/v1 berfungsi sebagai URL dasar; /v1 adalah kompatibilitas protokol, bukan versi model.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "system", "content": "You are a concise technical assistant."},
        {"role": "user", "content": "Explain idempotency in REST APIs in two sentences."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
Cetak response.usage sejak hari pertama. Dengan model yang begitu murah untuk cache hit dan begitu mahal untuk cache miss 1 juta token, akuntansi token adalah perbedaan antara kesalahan pembulatan dan tagihan yang nyata.
Permintaan yang sama melalui HTTP mentah, berguna untuk uji coba singkat dan untuk mengimpor ke alat API:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-pro",
    "messages": [
      {"role": "user", "content": "List three ways to version a REST API."}
    ]
  }'
Referensi parameter lengkap ada di dokumen resmi DeepSeek, termasuk endpoint yang kompatibel dengan Anthropic (dapat digunakan dari Anthropic SDK dan Claude Code tanpa menulis ulang apa pun) dan API Respons DeepSeek sendiri.
Bekerja dengan tiga mode berpikir
V4 Pro mengekspos penalaran sebagai dial daripada model terpisah. Satu endpoint, tiga mode:
- non-think: model langsung menjawab. Tercepat dan termurah, cocok untuk ekstraksi, klasifikasi, pemformatan, dan ringkasan.
- think high: model melakukan penalaran sebelum menjawab dan mengembalikan penalaran tersebut dalam bidang
reasoning_content. Default untuk pengodean, debugging, dan analisis multi-langkah. - think max: anggaran penalaran maksimum, konfigurasi di balik angka benchmark V4-Pro-Max. Simpan untuk masalah yang benar-benar sulit.
Mode-mode ini dipetakan ke parameter standar reasoning_effort, sehingga tidak diperlukan penyesuaian khusus vendor:
response = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high", # "none" | "high" | "max"
    messages=[
        {"role": "user", "content": "Our API returns 502s under load but only behind the CDN. Walk through likely causes in order of probability."},
    ],
)

message = response.choices[0].message
print("--- Reasoning ---")
print(message.reasoning_content)
print("--- Answer ---")
print(message.content)
Dua catatan praktis. Pertama, jangan pernah mengumpankan reasoning_content kembali ke riwayat percakapan; kirimkan hanya content dari giliran sebelumnya. Kedua, token penalaran ditagih sebagai token output seharga $0,87/Juta, jadi think max memakan biaya dan latensi yang nyata. Sesuaikan mode dengan tugas alih-alih menggunakan default maksimum.
Streaming respons
Dengan output maksimal 384K dan mode berpikir yang dapat melakukan penalaran panjang, permintaan non-streaming akan memberikan pengalaman pengguna yang buruk. Atur stream=True dan tangani kedua jenis delta, dalam mode berpikir, potongan reasoning_content tiba lebih dulu, lalu jawabannya:
stream = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high",
    stream=True,
    messages=[
        {"role": "user", "content": "Design a rate limiter for a public API. Compare token bucket and sliding window."},
    ],
)

for chunk in stream:
    if not chunk.choices:
        continue # final chunk may carry usage data only
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True) # thinking phase
    elif delta.content:
        print(delta.content, end="", flush=True) # answer phase
Pola UI yang masuk akal: render fase penalaran yang diciutkan sebagai indikator "berpikir", lalu beralih ke rendering normal ketika delta content dimulai. Di balik layar, ini adalah server-sent events standar; panduan kami tentang streaming respons API dengan SSE mencakup mekanismenya.
Pemanggilan alat dan output terstruktur
V4 Pro mendukung pemanggilan fungsi gaya OpenAI, yang berarti loop agen yang ada dapat di-porting tanpa modifikasi. Definisikan alat, baca tool_calls, jalankan, tambahkan hasil, ulangi:
tools = [{
    "type": "function",
    "function": {
        "name": "get_endpoint_status",
        "description": "Check the health of an internal API endpoint",
        "parameters": {
            "type": "object",
            "properties": {
                "endpoint": {"type": "string", "description": "Path, e.g. /v1/orders"}
            },
            "required": ["endpoint"],
        },
    },
}]

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "Is /v1/orders healthy right now?"}],
    tools=tools,
)

print(response.choices[0].message.tool_calls)
Output terstruktur bekerja melalui parameter standar response_format saat Anda membutuhkan JSON yang terjamin dapat diurai. Penjelasan lengkap tentang loop alat multi-langkah layak mendapatkan artikel tersendiri; dokumen resmi mencakup detail bentuk pesan.
Ekonomi prompt caching: angka yang mengubah arsitektur Anda
Berikut adalah spesifikasi yang layak mendapat perhatian lebih dari sekadar benchmark. DeepSeek menyimpan awalan prompt secara otomatis, tanpa header kontrol cache, tanpa konfigurasi TTL, dan awalan yang berulang akan ditagih $0,003625/Juta alih-alih $0,435/Juta. Itu diskon 120x untuk input yang sudah pernah dilihat API.
Jalankan angka-angka pada beban kerja yang realistis. Misalkan Anda sedang membangun agen pengodean yang menampung konteks repositori 200 ribu token dan melakukan 50 panggilan dalam satu sesi:
- Tanpa caching: 50 panggilan × 200K token × $0,435/Juta ≈ $4,35 dalam biaya input.
- Dengan caching otomatis: satu cache miss ($0,087) + 49 cache hit (≈ $0,0007 masing-masing) ≈ $0,12.
Sesi yang sama, kira-kira 35x lebih murah, dan yang dibutuhkan hanyalah struktur prompt: konten stabil terlebih dahulu (prompt sistem, dokumentasi, konteks repositori), konten volatil terakhir (pesan terbaru pengguna, stempel waktu, ID permintaan). Perubahan apa pun di awal prompt membatalkan awalan yang di-cache mulai saat itu, jadi stempel waktu di prompt sistem Anda secara diam-diam mengubah setiap panggilan menjadi cache miss dengan harga penuh.
Ini juga membingkai ulang jendela konteks 1 juta: mengisinya membutuhkan $0,435 pada miss, tetapi sebagai awalan sesi yang stabil, biayanya sekitar sepertiga sen per panggilan. Untuk teori umum, lihat Apa itu prompt caching.
Menguji deepseek-v4-pro di Apidog
Sebelum V4 Pro mendekati kode produksi, letakkan endpoint di bawah debugger yang tepat. Karena API DeepSeek kompatibel dengan OpenAI, Apidog dapat menggunakannya tanpa penanganan khusus:
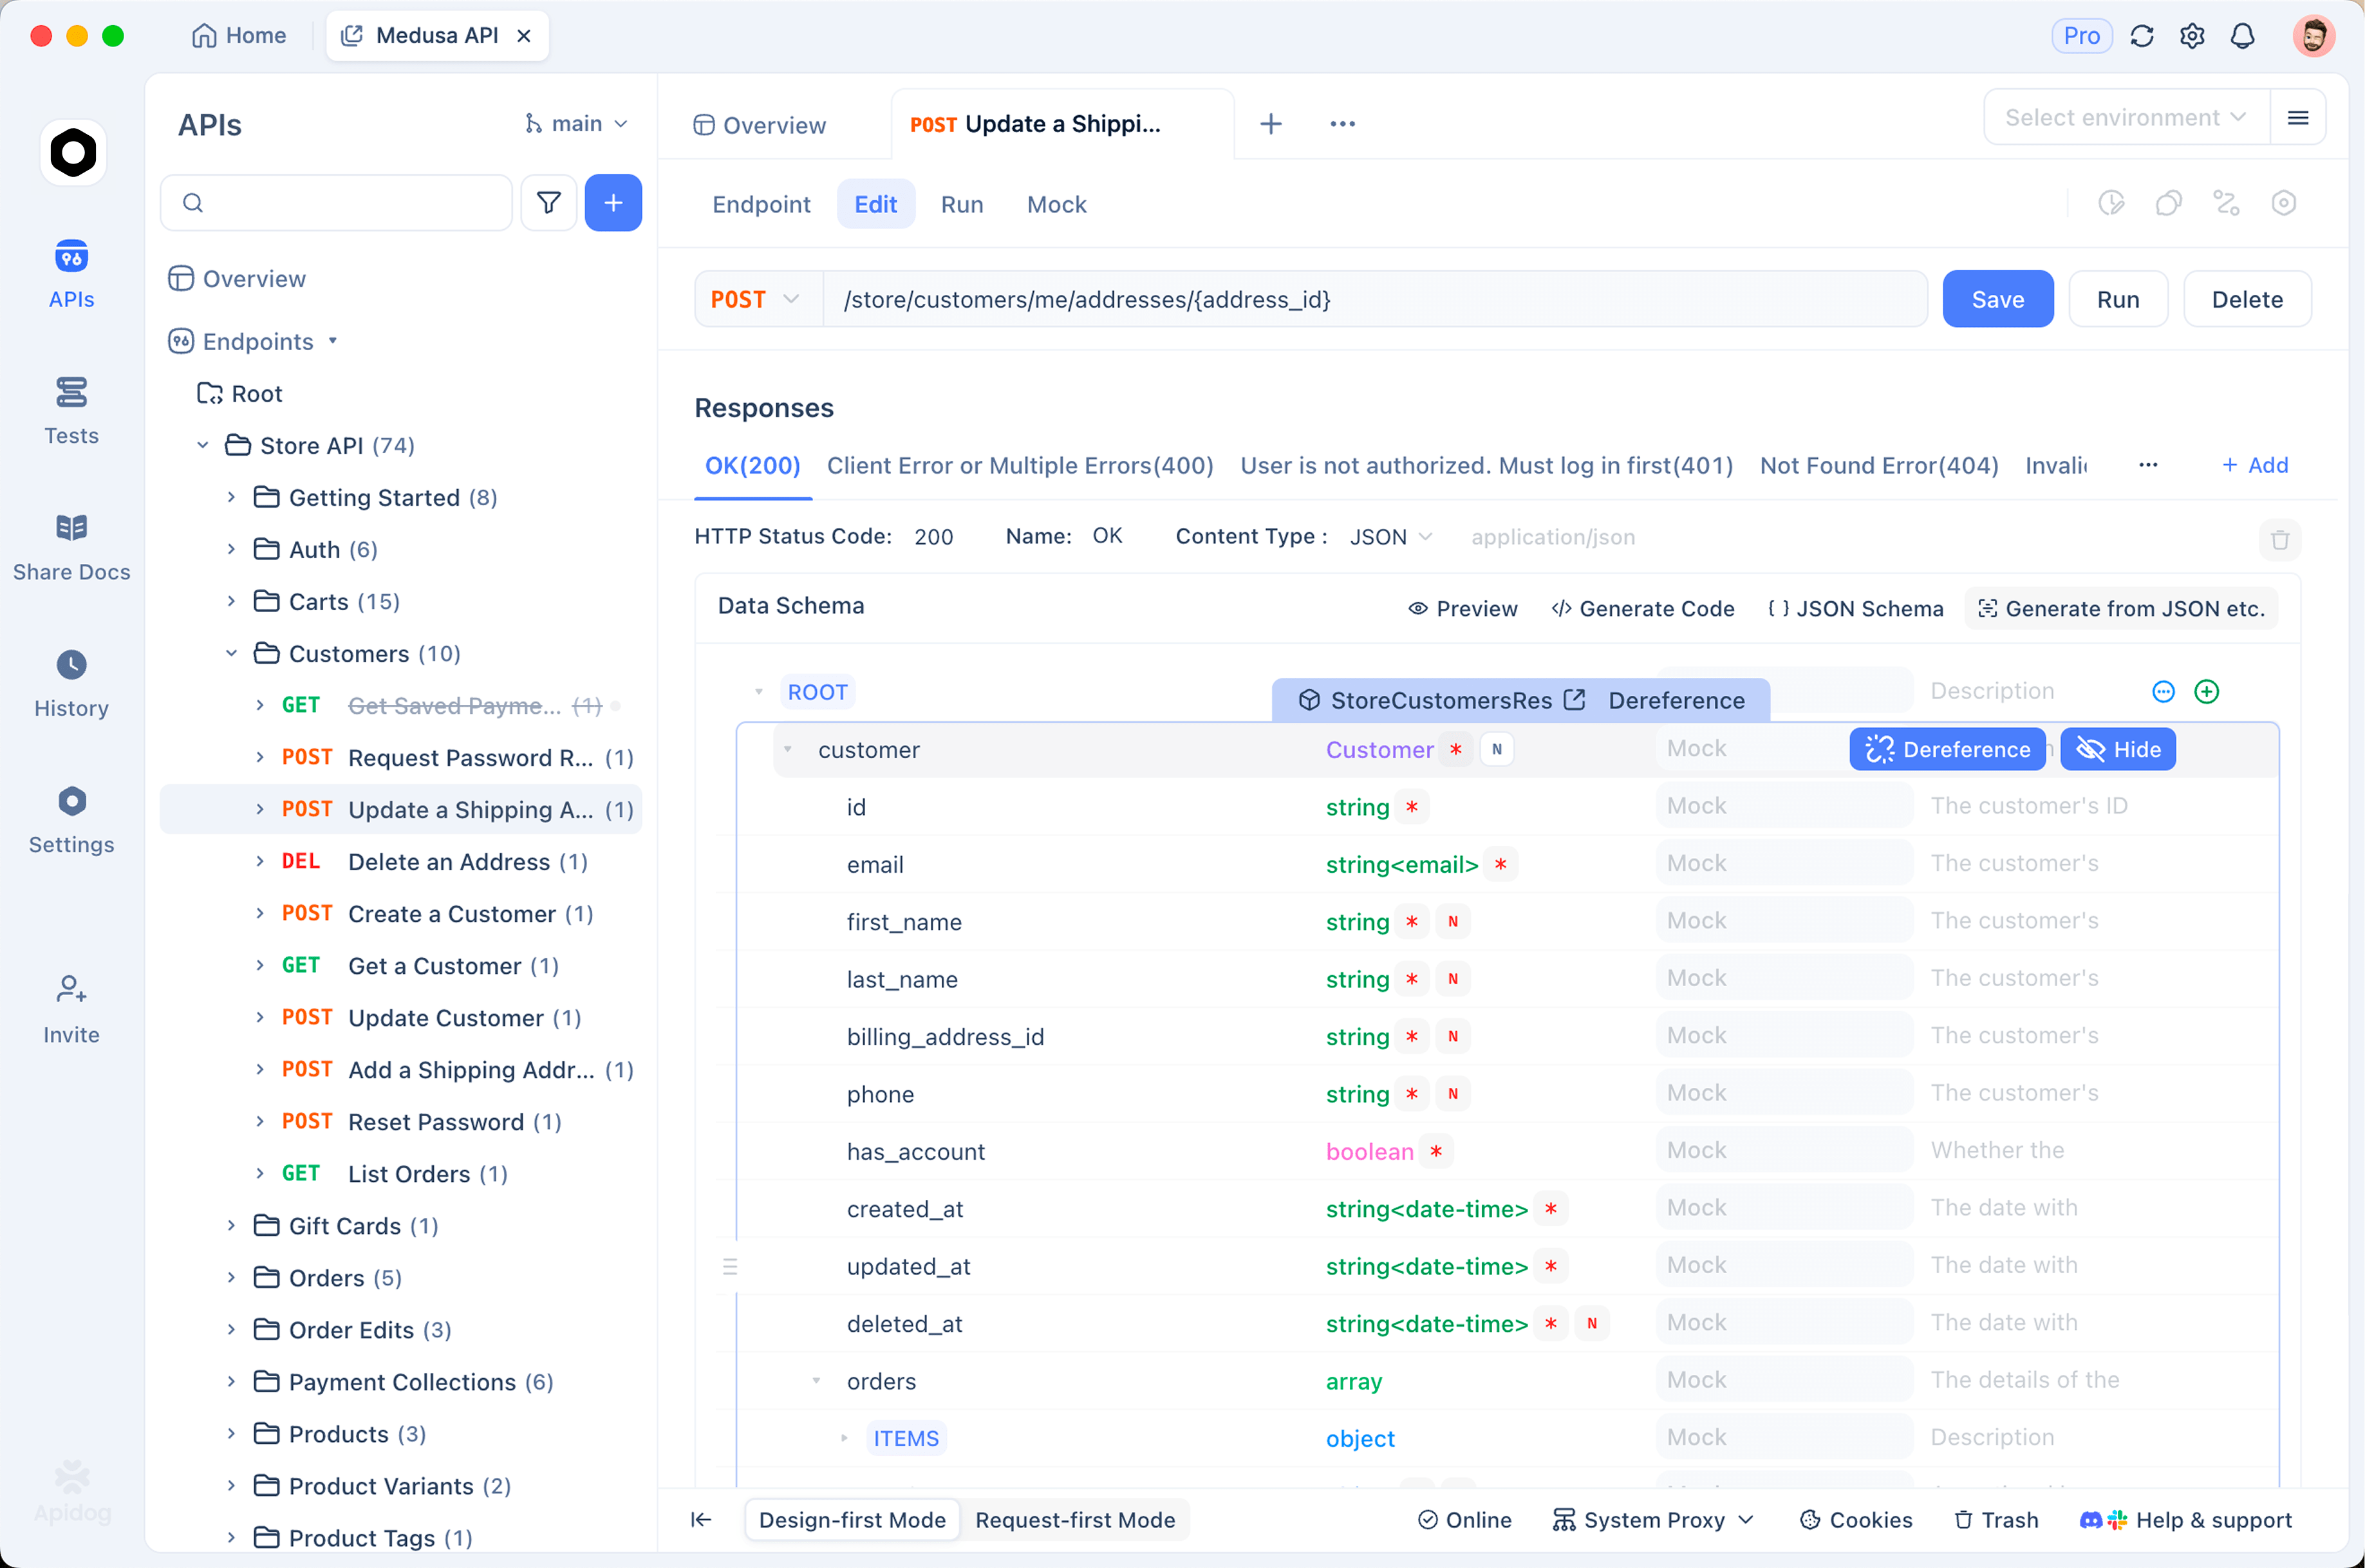
- Impor endpoint. Tempelkan perintah curl dari sebelumnya ke Apidog dan itu menjadi permintaan yang dapat diedit, header, otentikasi, dan body diurai secara otomatis.
- Siapkan lingkungan untuk Pro dan Flash. Simpan
base_urldan kunci API Anda sebagai variabel lingkungan, dan jadikan nama model juga sebagai variabel. Beralih antaradeepseek-v4-prodandeepseek-v4-flashmenjadi perubahan lingkungan sekali klik, yang membuat pertanyaan "apakah Pro sepadan dengan harga 3x Flash pada prompt ini?" menjadi pertanyaan empiris daripada perdebatan. - Periksa stream SSE. Kirim permintaan dengan
"stream": truedan Apidog akan merender stream peristiwa sebagai linimasa langsung alih-alih deretan barisdata:mentah, menggabungkan delta sehingga Anda dapat melihatreasoning_contenttiba sebelum jawaban. Ketika panggilan think-max terasa lambat, tampilan ini menunjukkan kepada Anda dengan tepat ke mana waktu itu pergi. - Simpan sesi sebagai koleksi. Ketika DeepSeek mengirimkan snapshot berikutnya, jalankan kembali permintaan yang sama dan bedakan perilaku sebelum Anda memutakhirkan, alur kerja yang sama yang umumnya digunakan tim untuk endpoint yang kompatibel dengan OpenAI.
Penampil respons juga menampilkan blok usage pada setiap permintaan, yang merupakan cara tercepat untuk memverifikasi rasio cache hit Anda saat Anda menyesuaikan struktur prompt.
Harga saat ini, dan kenaikan yang akan datang
Daftar harga saat ini untuk kedua endpoint V4:
| Model | Input (miss) | Input (cache hit) | Output |
|---|---|---|---|
deepseek-v4-pro |
$0.435/M | $0.003625/M | $0.87/M |
deepseek-v4-flash |
$0.14/M | $0.28/M |
Bahkan dengan harga Pro, ini memotong harga model frontier Barat dengan selisih yang lebar. Namun, rencanakan dengan satu peringatan: pada 6 Agustus 2026, enam hari sebelum GA, DeepSeek memperingatkan bahwa kenaikan harga API yang "signifikan" akan datang, tanpa angka, tanpa tanggal efektif.
Langkah-langkah praktis selagi angka belum diketahui:
- Ukur biaya per tugas Anda yang sebenarnya sekarang, dengan
usagedata dari beban kerja aktual, sehingga Anda dapat memodelkan kenaikan yang diumumkan dalam hitungan menit daripada menebak-nebak. - Maksimalkan cache hit. Jika kenaikan berlaku secara proporsional, arsitektur yang sangat bergantung pada prefix akan mempertahankan sebagian besar keuntungannya.
- Pertahankan V4 Flash sebagai fallback routing. Dengan $0,14/$0,28 dengan 13M parameter aktif, ia menangani tugas-tugas sederhana bervolume tinggi sehingga Pro dicadangkan untuk permintaan yang membutuhkannya.
Untuk perincian lebih lanjut tentang struktur harga V4 dan bagaimana perbandingannya di antara penyedia, lihat panduan harga API DeepSeek V4 kami.
FAQ
Apakah kode OpenAI SDK saya yang sudah ada akan berfungsi tanpa perubahan?
Hampir. Ubah base_url menjadi https://api.deepseek.com, ganti kunci API, dan atur model="deepseek-v4-pro". Chat Completions, streaming, alat, dan output terstruktur mengikuti bentuk OpenAI. Tim pada Anthropic SDK dapat menggunakan endpoint DeepSeek Anthropic Messages sebagai gantinya.
Kapan saya harus menggunakan V4 Flash alih-alih V4 Pro?
Flash (total 284B, aktif 13B) adalah model volume: klasifikasi, ekstraksi, obrolan sederhana, apa pun yang sensitif terhadap latensi yang tidak memerlukan penalaran mendalam. Pro memperoleh harga output 3x lipat pada pengodean agen, analisis konteks panjang, dan beban kerja mode berpikir. Arahkan berdasarkan tugas, bukan berdasarkan loyalitas.
Bisakah saya menggunakan V4 Pro 0813 di Cursor?
Ya, Cursor menerima endpoint kustom yang kompatibel dengan OpenAI, jadi build GA dapat langsung digunakan sebagai model kustom. Kami menjelaskan pengaturan persisnya di Cara menggunakan DeepSeek V4 Pro dengan Cursor.
Ringkasan
Hari pertama dengan model GA adalah waktu yang tepat untuk membangun memori otot: kunci, permintaan pertama, mode berpikir, streaming, dan tata letak prompt yang sadar caching. V4 Pro menghargai kebiasaan terakhir itu lebih dari model mana pun sebelumnya, diskon cache 120x menjadikan struktur prompt sebagai keputusan arsitektur. Hubungkan contoh-contoh di atas, perhatikan angka usage, dan simpan koleksi Apidog agar Anda dapat memverifikasi ulang perilaku ketika snapshot berikutnya atau perubahan harga yang diumumkan tiba.