
DeepSeek-V4.1-Flash dirilis secara umum (GA) pada API pada tanggal 10 September 2026, dan hadir dengan dua fakta yang membuat "gratis" menjadi pertanyaan nyata alih-alih sekadar daya tarik pemasaran. Bobot model ini berlisensi MIT di Hugging Face, sehingga model itu sendiri tidak berbayar. Dan API resmi mengenakan biaya untuk input *cache-hit* sebesar $0,003 per 1 juta token di luar jam sibuk, cukup mendekati nol sehingga perbedaan antara gratis dan hampir gratis tidak lagi penting untuk sebagian besar proyek sampingan.
Masih belum ada tingkatan gratis permanen di API DeepSeek. Siapa pun yang mengatakan sebaliknya sedang menjelaskan promo router atau aplikasi obrolan konsumen. Panduan ini mengurutkan setiap cara jujur untuk menggunakan V4.1-Flash tanpa membayar, kemudian menunjukkan perhitungan untuk jalur berbayar agar Anda dapat memutuskan apakah "hampir gratis" sudah cukup dekat. Jika Anda ingin mengetahui cerita arsitektur terlebih dahulu, baca apa itu DeepSeek-V4.1-Flash dan kembali lagi.
Satu catatan penting terlebih dahulu. Beberapa jalur gratis berjalan melalui *endpoint* pihak ketiga yang membatasi kecepatan Anda dan terkadang diam-diam menukar model. Menguji mereka dengan Apidog merekam respons dan menegaskan pada bidang model menjaga kuota gratis Anda dari *debugging* Anda sendiri. Alur kerja tersebut ada di bagian akhir.
TL;DR (Ringkasan)
Diurutkan dari "gratis tanpa syarat" hingga "hampir gratis dengan kartu yang terdaftar":
- Aplikasi obrolan DeepSeek di chat.deepseek.com. Gratis, tanpa kartu. Terbaik untuk menilai kualitas keluaran secara manual.
- Bobot terbuka di Hugging Face. Gratis di bawah lisensi MIT, tetapi 552 miliar parameter berarti perangkat keras adalah biayanya.
- *Router* pihak ketiga seperti OpenRouter. Tingkatan gratis ada untuk beberapa model pada waktu tertentu, dengan batasan kecepatan dan pertimbangan kebijakan data.
- Kredit percobaan yang dibundel dalam alat bantu pemrograman. Hanya berguna jika alat tersebut sudah menyediakan DeepSeek sebagai *backend*.
- API resmi. Tidak gratis, tetapi proyek hobi dapat berjalan sekitar $1,35 per bulan di luar jam sibuk.
Pilihan 1: Aplikasi obrolan DeepSeek
Aplikasi konsumen di chat.deepseek.com adalah jalur tanpa hambatan. Daftar dengan email atau nomor telepon, tanpa kartu, dan mulai memberi perintah (prompting).
Dua peringatan. Pertama, model apa yang dilayani aplikasi setelah rilis hari ini adalah [VERIFIKASI]. Catatan rilis mencakup API, dan aplikasi sebelumnya tertinggal dari API atau menjalankan versi yang disesuaikan secara terpisah. Kedua, aplikasi ini adalah antarmuka obrolan, bukan API. Anda tidak bisa membuat skripnya, memproses prompt secara batch, atau mengintegrasikannya ke dalam produk.
Jadi aplikasi ini menjawab satu pertanyaan: apakah V4.1-Flash menangani domain Anda dengan cukup baik untuk membenarkan integrasi? Tempelkan masukan yang dikirim pengguna Anda, termasuk gambar, karena model ini secara asli multimodal. Jika jawabannya sesuai, pindah ke salah satu jalur di bawah ini.
Pilihan 2: Bobot terbuka
DeepSeek menerbitkan bobot dan laporan teknis V4.1-Flash di bawah lisensi MIT. Anda dapat mengunduh, menjalankan, menyempurnakan, dan mengirimkan produk berdasarkan bobot tersebut tanpa membayar DeepSeek atau meminta izin.
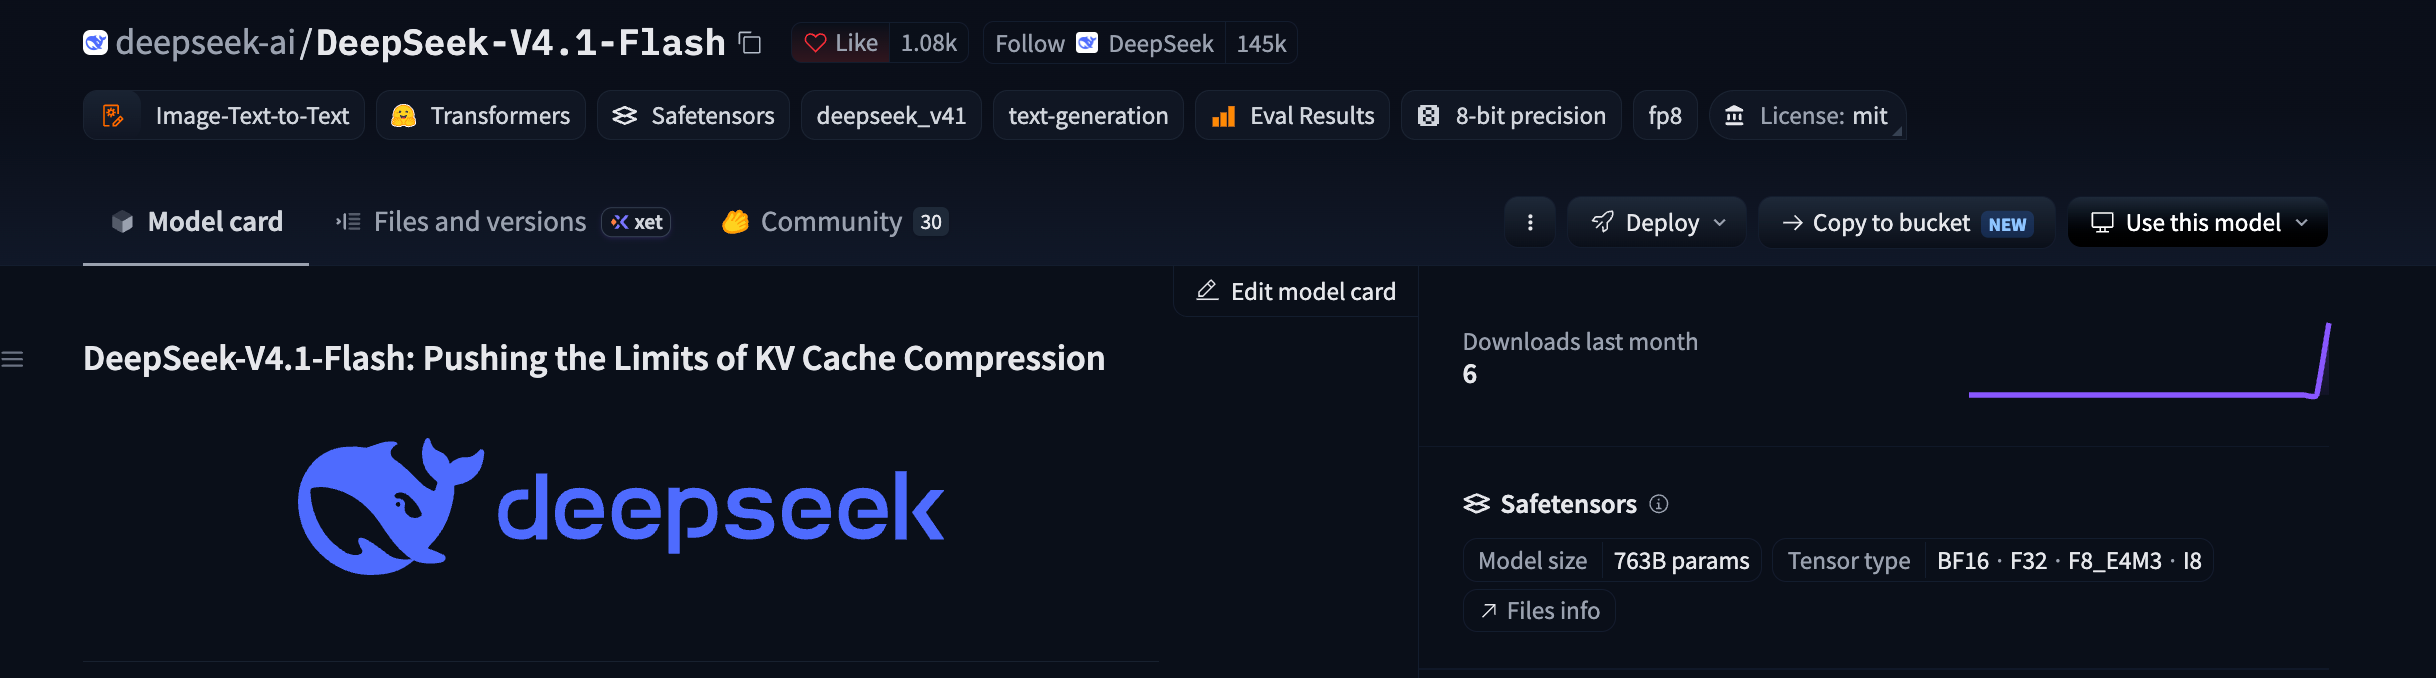
Masalahnya adalah ukuran. V4.1-Flash adalah *backbone* *mixture-of-experts* dengan 552 miliar parameter (763 miliar dengan *vision encoder*). Hanya 8 miliar parameter yang aktif selama *prefill* dan 16 miliar selama *decode*, tetapi seluruh set parameter harus tetap berada di suatu tempat. Pada 8-bit, itu kira-kira 552 GB untuk *backbone* saja; pada 4-bit, sekitar 280 GB. Sebuah GPU konsumen tunggal tidak akan mencukupi. *Cache* KV adalah kabar baiknya: pada 890 byte per token di bawah *caching* FP4, konteks 1 juta token penuh membutuhkan sekitar 0,9 GB.
"Gratis" di sini berarti gratis untuk dilisensikan, bukan gratis untuk dijalankan. Baca cara menjalankan DeepSeek-V4.1-Flash secara lokal untuk tingkatan perangkat keras dan *inference engine* mana yang harus diperiksa sebelum Anda mengunduh 280 GB. Jika Anda sudah memiliki perangkat kerasnya, ini adalah opsi gratis paling tahan lama di halaman ini: tidak ada batasan kecepatan, tidak ada kebijakan data, tidak ada penggantian model secara diam-diam.
Pilihan 3: API resmi tidak gratis, tetapi mendekati
Platform DeepSeek adalah sistem bayar-sesuai-pakai. Anda mengisi saldo, membuat kunci, dan ditagih per token. Tidak ada tingkatan gratis permanen.
Yang membuatnya layak berada di halaman "gratis" adalah harganya. Berikut adalah tabel harga USD lengkap dari halaman harga resmi, berlaku mulai 10 September 2026 pukul 04:00 UTC, per 1 juta token:
| Jenis Token | deepseek-flash di luar jam sibuk | deepseek-flash di jam sibuk |
|---|---|---|
| Masukan, cache hit | $0,003 | $0,006 |
| Masukan, cache miss | $0,15 | $0,30 |
| Keluaran | $0,60 | $1,20 |
Jam sibuk adalah Senin hingga Jumat, pukul 01:00 hingga 04:00 dan 06:00 hingga 10:00 UTC (09:00 hingga 12:00 dan 14:00 hingga 18:00 Beijing). Segala waktu lainnya, termasuk akhir pekan, adalah di luar jam sibuk dengan harga separuh. Caching konteks bersifat otomatis, jadi *prompt* sistem yang diulang akan mengenai *cache* tanpa kode tambahan.
Sekarang perhitungannya. Misalkan sebuah proyek sampingan mengirimkan 5 juta token input baru (*cache-miss*) dan menghasilkan 1 juta token output dalam sebulan, semuanya di luar jam sibuk:
- 5 juta input *cache-miss* dengan $0,15 per 1 juta = $0,75
- 1 juta output dengan $0,60 per 1 juta = $0,60
- Total: $1,35 per bulan
Jika sebagian dari input tersebut adalah *prompt* sistem yang diulang, biayanya akan turun lebih jauh. 1 juta token *cache-hit* di luar jam sibuk berharga $0,003, jadi *prompt* sistem 2.000 token yang digunakan kembali di 10.000 permintaan (20 juta token yang di-*cache*) hanya menambah enam sen. Tagihan akan menjadi sangat kecil, dan Anda mendapatkan model persis yang Anda minta dengan batas konkurensi 2.500 permintaan. Penjelasan harga V4.1-Flash mencakup bagaimana perhitungan bergeser dengan struktur *prompt*.
Panggilan minimal, dengan blok penggunaan dicetak agar Anda dapat melihat pembagian *cache*:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "You classify support tickets as billing, bug, or feature request."},
        {"role": "user", "content": "Customer says their August invoice shows two charges for one seat."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
Pilihan 4 dan 5: Router, tingkatan gratis, dan kredit yang dibundel
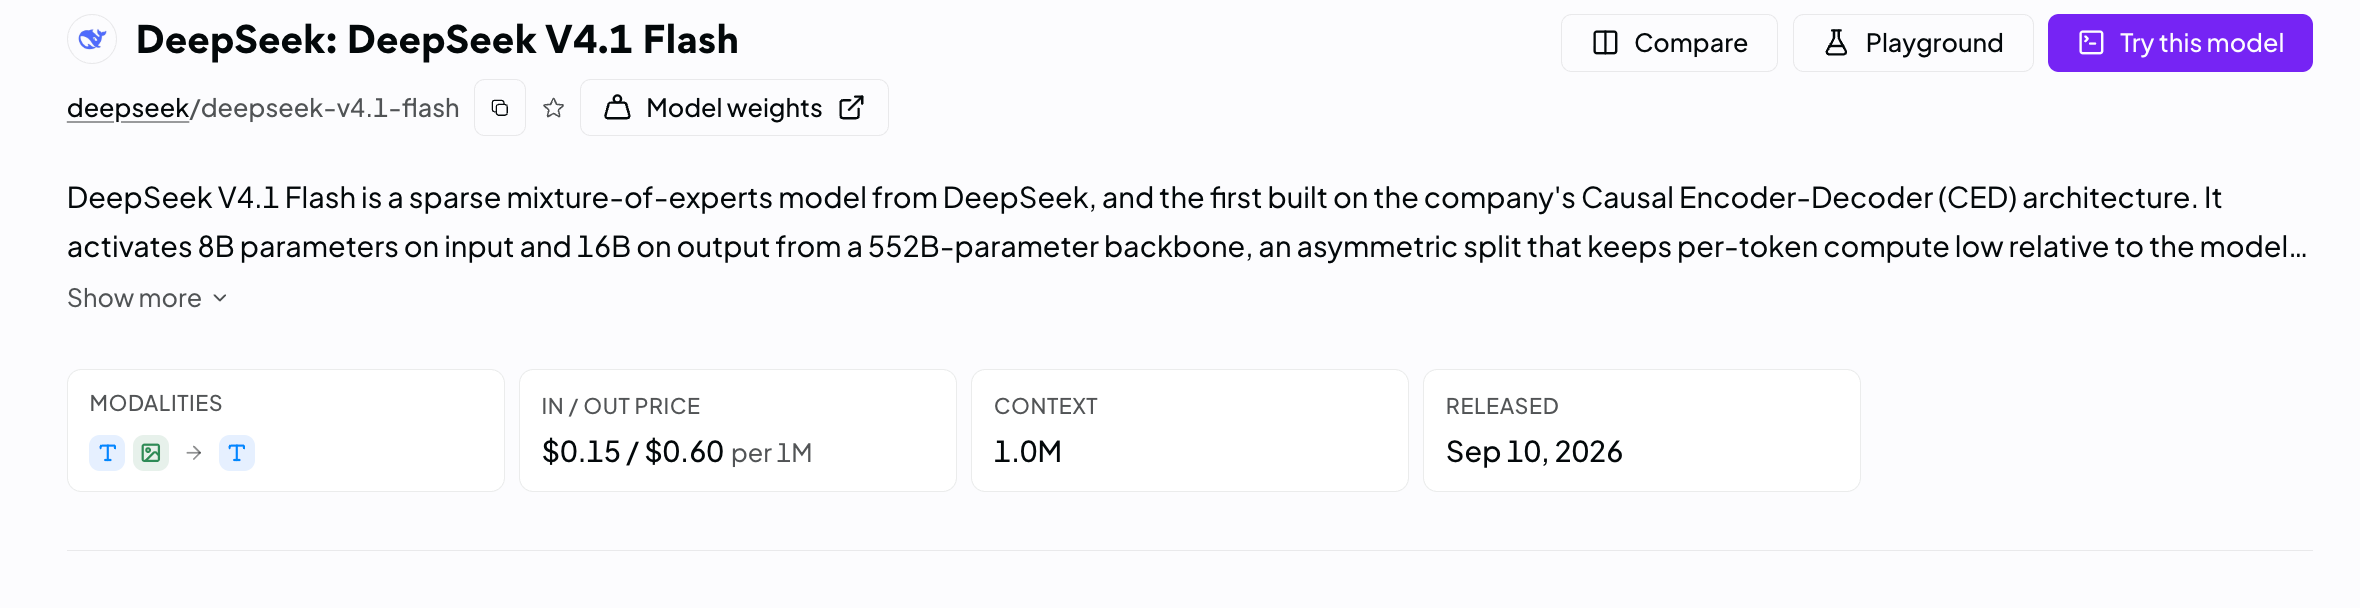
OpenRouter adalah tempat yang biasa dicari untuk *endpoint* gratis ke model *open-weight* baru. *Router* mengumpulkan beberapa host di belakang satu API yang kompatibel dengan OpenAI, dan host terkadang menjalankan tingkatan gratis pada suatu model untuk menarik lalu lintas. Apakah V4.1-Flash terdaftar di sana hari ini, dan apakah ada host yang menawarkan tingkatan gratis untuk itu, adalah [VERIFIKASI]; model ini baru beberapa jam dirilis dan daftar bergerak cepat.
Tiga peringatan berlaku untuk setiap tingkatan gratis *router*:
- Batasan kecepatan sangat ketat. Batasan per menit dan per hari berarti *loop* pengujian dapat menghabiskan kuota sehari dalam satu jam.
- Kebijakan data berbeda per host. Lalu lintas gratis seringkali diizinkan untuk dicatat atau dilatih oleh host. Baca kebijakan sebelum mengirimkan informasi pribadi apa pun.
- Tingkatan gratis berubah setiap minggu. Gratis pada hari Senin bisa menjadi berbayar pada hari Jumat, atau dialihkan ke host lain. Jangan membangun ketergantungan produksi pada salah satunya.
Kegagalan yang harus diwaspadai adalah penggantian model secara diam-diam: Anda meminta V4.1-Flash dan model yang lebih lama menjawab karena host gratisnya tidak berfungsi. Bidang model pada respons adalah garis pertahanan pertama Anda, dan alur kerja di bawah ini menegaskannya.
Beberapa alat bantu pemrograman, termasuk Cursor dan agen bergaya Codex, menyertakan kredit percobaan yang dapat Anda gunakan pada *backend* apa pun yang didukung alat tersebut. Jika alat yang sudah Anda gunakan mencantumkan DeepSeek sebagai model yang dapat dipilih, kredit tersebut adalah jalur gratis yang sah selama masa percobaan. Jangan mendaftar alat hanya untuk mencapai DeepSeek dengan cara ini; jumlah kredit dan model yang memenuhi syarat sering berubah sehingga sulit untuk didokumentasikan.
Pilihan mana yang sesuai dengan situasi Anda
| Pilihan | Biaya | Model terjamin? | Batasan kecepatan | Terbaik untuk |
|---|---|---|---|---|
| Aplikasi obrolan DeepSeek | Gratis | Tergantung pada versi aplikasi | Batasan penggunaan aplikasi | Evaluasi manual, pemeriksaan cepat |
| Bobot terbuka (MIT) | Lisensi gratis, perangkat keras Anda | Ya, Anda menjalankannya | Tidak ada | Privasi, *fine-tuning*, GPU milik sendiri |
| API resmi | Sekitar $1,35/bulan pada skala hobi | Ya | 2.500 permintaan bersamaan | Apa pun yang Anda kirimkan |
| Tingkatan gratis router | Gratis selama persediaan ada | Tidak, host berganti | Batasan per menit dan per hari | Prototipe, perbandingan |
| Kredit alat yang dibundel | Gratis selama masa percobaan | Tergantung pada alatnya | Ditentukan oleh alat | Pemrograman di dalam alat tersebut |
Jika Anda berencana untuk mengirimkan produk, habiskan uang untuk API resmi. Jika Anda sedang mengevaluasi, mulailah dengan aplikasi obrolan. Jika Anda memiliki GPU, bobot model mengungguli setiap baris lainnya.
Uji *endpoint* gratis di Apidog tanpa menghabiskan kuota
Jalur gratis memiliki dua mode kegagalan: Anda mencapai batasan kecepatan saat men-debug kode Anda sendiri, dan *router* memberi Anda model yang berbeda tanpa memberitahu. Keduanya murah untuk dicegah dengan Apidog, yang menguji lapisan API di depan *endpoint* mana pun yang Anda pilih.
- Tambahkan *endpoint* sekali saja. Buat
POST {{BASE_URL}}/chat/completionsdenganBearer {{API_KEY}}di header Otorisasi. Setiap opsi kecuali aplikasi obrolan menggunakan bentuk yang kompatibel dengan OpenAI yang sama, jadi satu permintaan yang disimpan mencakup semuanya. - Buat satu lingkungan per penyedia. Lingkungan
officialmengaturBASE_URLkehttps://api.deepseek.comdengan kunci DeepSeek Anda; lingkunganroutermenunjuk ke host gratis. Beralihnya hanyalah melalui *dropdown*. - Rekam respons asli, lalu *mock* mereka. Kirim beberapa *prompt* representatif melalui *endpoint* gratis, simpan responsnya, dan sajikan dari *mock server* Apidog. Saat Anda membangun *parsing*, percobaan ulang, dan UI, aplikasi Anda akan mengenai *mock* dan kuota gratis tetap tidak tersentuh.
- Tegaskan pada bidang model. Simpan permintaan sebagai kasus uji yang menegaskan bahwa
modeldalam respons berisi string yang dikembalikan host untuk V4.1-Flash. Jalankan ini di awal setiap sesi, dan model yang diganti akan menggagalkan pengujian sebelum Anda menghabiskan satu jam mencari "regresi" dalam *prompt* Anda. - Tegaskan pada blok penggunaan. Periksa bahwa
usage.prompt_tokensdanusage.completion_tokenslebih besar dari nol, dan baca jumlah *cache-hit* pada API resmi dari blok yang sama. Setelah seminggu Anda akan tahu apa yang telah dihemat oleh tingkatan gratis dan apakah *prompt* Anda di-*cache* sebaik yang Anda kira.
Unduh Apidog dan prosesnya memakan waktu kurang dari sepuluh menit. Setelah penegasan ada, apidog-cli menjalankannya di CI sehingga penggantian *router* akan merusak *build* alih-alih demo.
FAQ
Apakah DeepSeek-V4.1-Flash gratis untuk digunakan? Model ini gratis untuk dilisensikan di bawah MIT dan gratis untuk digunakan di dalam aplikasi obrolan DeepSeek. API resmi adalah sistem bayar-sesuai-pakai tanpa tingkatan gratis permanen. Apakah DeepSeek gratis melacak bagaimana pembagian ini berlaku di seluruh jajaran model.
Apakah DeepSeek API memiliki uji coba gratis? Tidak ada yang permanen. Jalur termurah adalah API resmi di luar jam sibuk: 5 juta token input *cache-miss* ditambah 1 juta token output berharga $1,35.
Apa cara termurah untuk memanggil V4.1-Flash melalui API? Kirim di luar jam sibuk dan strukturkan *prompt* agar awalan yang sama mengenai *cache*, karena *hit* berharga 50 kali lebih murah daripada *miss*. Apa itu *prompt caching* menjelaskan cara menyusun *prompt* untuk itu.
Bisakah saya menjalankan V4.1-Flash di laptop? Tidak untuk model lengkap. 552 miliar parameter membutuhkan sekitar 280 GB pada 4-bit hanya untuk *backbone*. Panduan lokal yang tertaut di atas mencakup apa yang realistis pada setiap tingkatan perangkat keras.
Apakah versi *router* gratis adalah model yang sama dengan API resmi? Hanya jika host mengatakannya demikian dan pengujian Anda mengkonfirmasinya. Tegaskan pada bidang model dan bandingkan *output* pada set *prompt* tetap dengan *endpoint* resmi. Panduan untuk DeepSeek V4 secara gratis dan API V4 secara gratis menjalankan pemeriksaan yang sama untuk generasi sebelumnya.
Kesimpulan
V4.1-Flash gratis dalam dua cara yang paling penting: bobotnya adalah MIT, dan aplikasi obrolan tidak berbayar. Segala sesuatu di antara kedua kutub tersebut adalah tingkatan gratis yang akan berubah atau API resmi yang dihargai cukup rendah sehingga "gratis" tidak lagi layak untuk dioptimalkan. Dengan $1,35 per bulan, jalur termurah biasanya adalah membayar.
Apa pun *endpoint* yang Anda pilih, tempatkan Apidog di depannya: *mock* respons saat Anda membangun, tegaskan pada bidang model, catat penggunaan. Kuota gratis adalah sumber daya. Gunakan untuk model, bukan untuk *bug* Anda sendiri.