
Groq memberikan setiap akun kunci Free Plan untuk endpoint yang kompatibel dengan OpenAI, dan kunci itu langsung berfungsi saat Anda mendaftar. Bagian yang sering membuat orang tersandung bukanlah mendapatkan akses, melainkan tetap berada dalam batas setelah aplikasi Anda benar-benar memanggil model. Groq menerbitkan angka Free Plan per model di dokumentasinya, tetapi angka-angka itu berubah dan akun Anda sendiri bisa berbeda. Kebiasaan yang andal adalah memeriksa pengaturan akun Anda, lalu membaca header respons pada setiap panggilan, karena batas dapat bergeser di tengah sesi.
Panduan ini mencakup cara mendapatkan kunci, mengarahkan klien OpenAI standar ke endpoint Groq, dan bagian yang dilewatkan sebagian besar postingan “free tier”: memantau batas Anda secara real time alih-alih mengetahuinya dari 429 di produksi. Lalu agen coding Anda mengubah pemeriksaan itu menjadi pengujian CLI Apidog, sehingga dapat diulang, bukan perintah curl sekali pakai yang Anda lupakan.
TL;DR
Groq menjalankan dua tier: Free Plan dan Developer Plan. Batas laju berlaku di tingkat organisasi (bukan per pengguna), Anda akan mencapai batas mana pun yang lebih dulu tercapai di antara permintaan, token, atau total harian, dan token yang di-cache tidak dihitung terhadap Anda. Groq menerbitkan angka Free Plan per model, tetapi angka yang berlaku untuk akun Anda ada di halaman batas di konsol Anda, jadi langkah yang andal adalah membacanya dari header respons x-ratelimit-* pada setiap panggilan alih-alih memercayai tabel yang dapat berubah tanpa pemberitahuan.
Mendapatkan kunci dan memanggil endpoint
Buat akun di console.groq.com dan buat kunci dari halaman keys. Groq mengekspos kunci itu melalui API yang kompatibel dengan OpenAI, jadi jika Anda pernah memanggil SDK OpenAI sebelumnya, Anda sudah tahu bentuknya. Arahkan base URL ke Groq alih-alih OpenAI dan biarkan semua hal lain sama:
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-8b-instant",
    "messages": [{"role": "user", "content": "Summarize this ticket in one sentence."}]
  }'
Atau dengan klien Python OpenAI resmi:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GROQ_API_KEY"],
    base_url="https://api.groq.com/openai/v1",
)

response = client.chat.completions.create(
    model="llama-3.3-70b-versatile",
    messages=[{"role": "user", "content": "List three causes of API timeout errors."}],
)

print(response.choices[0].message.content)
Dokumentasi kompatibilitas OpenAI Groq mencatat beberapa celah yang perlu diketahui sebelum Anda menyalin kode yang ada: logprobs, logit_bias, top_logprobs, dan messages[].name semuanya mengembalikan error 400, n harus sama dengan 1 jika Anda mengaturnya, dan temperature 0 diubah menjadi float positif yang sangat kecil alih-alih decoding greedy yang sebenarnya.
Free Plan vs Developer Plan
Kata-kata Groq sendiri langsung: “Tingkatkan ke paket Developer untuk mengakses batas yang lebih tinggi, pemrosesan Batch dan Flex, dan lainnya.” Free Plan adalah yang menjadi awal setiap kunci baru, dan ini benar-benar dapat digunakan untuk pengujian dan proyek sampingan kecil.
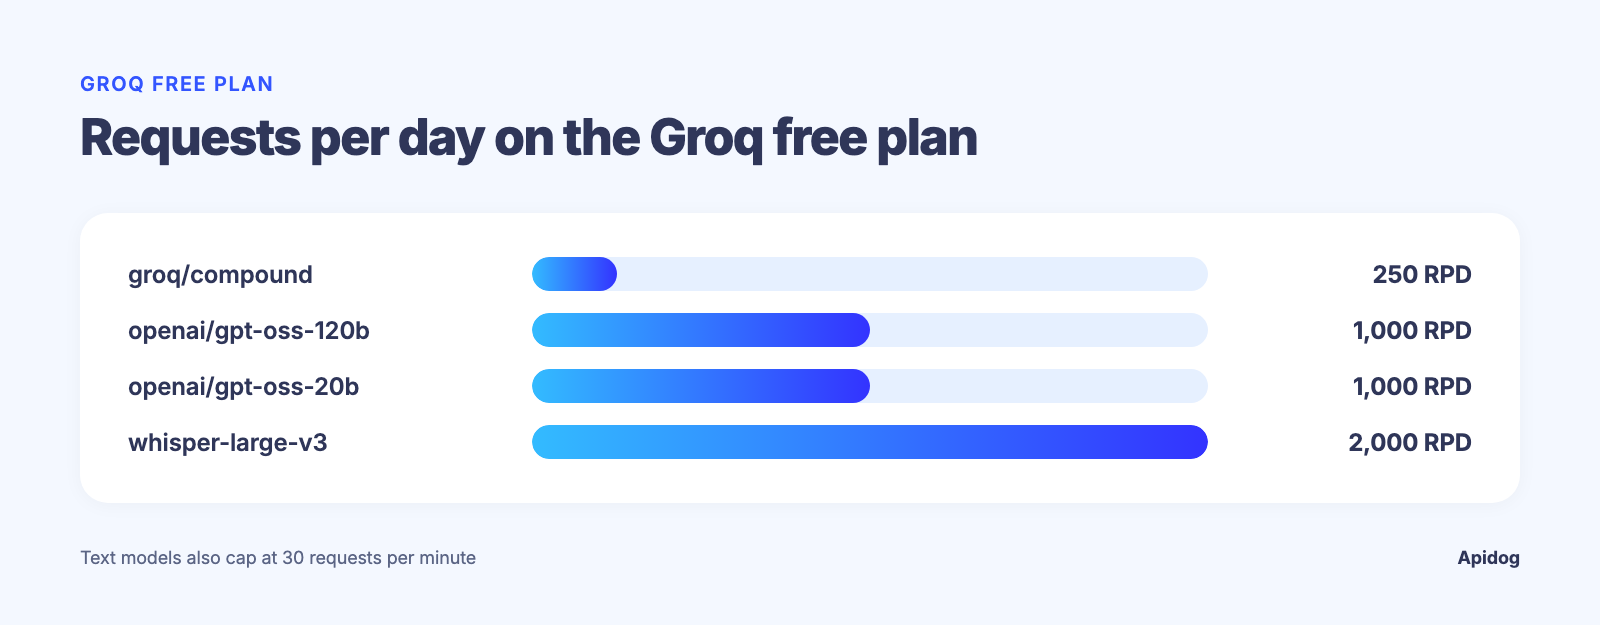
Berikut adalah yang diizinkan Free Plan untuk beberapa model, menurut dokumentasi batas laju Groq per 2026-09-15:
| Model | RPM | RPD | TPM | TPD | Audio |
|---|---|---|---|---|---|
groq/compound |
30 | 250 | 70K | - | - |
openai/gpt-oss-120b |
30 | 1K | 8K | 200K | - |
openai/gpt-oss-20b |
30 | 1K | 8K | 200K | - |
whisper-large-v3 |
20 | 2K | - | - | 7.2K ASH / 28.8K ASD |
Halaman yang sama memiliki tab Developer Plan dengan batas atas yang lebih tinggi untuk setiap model, plus pemrosesan Batch dan Flex. Anggap tabel di atas sebagai snapshot, karena Groq dapat mengubah angka-angka ini tanpa pemberitahuan. Angka Anda sendiri ada di halaman batas di pengaturan akun Anda: percayai halaman itu daripada halaman ini jika keduanya berbeda.
Dua detail kebijakan lebih penting daripada angka mentah. Batas laju berlaku “di tingkat organisasi, bukan pengguna individual,” jadi lima orang yang berbagi satu org Groq berbagi satu batas, bukan lima batas terpisah. Dan “token yang di-cache tidak dihitung terhadap batas laju Anda,” yang berarti struktur prompt yang di-cache dengan baik memberi Anda throughput nyata lebih banyak daripada yang disiratkan angka utama.
Model yang perlu diketahui sebelum Anda mencapai batas
Batas yang penting bergantung pada model yang Anda panggil. Model teks dan sistem Compound Groq berjalan pada konteks 131.072 token:
| ID Model | Jenis |
|---|---|
llama-3.1-8b-instant |
Teks serbaguna cepat |
llama-3.3-70b-versatile |
Teks serbaguna lebih besar |
openai/gpt-oss-120b |
Model penalaran open-weight |
openai/gpt-oss-20b |
Model penalaran open-weight lebih kecil |
groq/compound |
Sistem agentic |
groq/compound-mini |
Sistem agentic lebih ringan |
Model Whisper, whisper-large-v3 dan whisper-large-v3-turbo, tidak cocok dengan tabel ini. Itu adalah model transkripsi audio, dan Groq mengukur throughput-nya dalam detik audio per jam dan per hari (ASH/ASD) bersama batas RPM dan RPD mereka sendiri, bukan dalam token.
Setiap model memiliki batas RPM, RPD, dan token sendiri, jadi jangan menganggap batas llama-3.1-8b-instant berlaku untuk openai/gpt-oss-120b.
Baca header batas laju alih-alih menebak
Setiap respons dari api.groq.com membawa serangkaian header yang memberi tahu Anda persis posisi Anda, tanpa perlu mengunjungi konsol:
x-ratelimit-limit-requestsdanx-ratelimit-limit-tokens, batas atas Anda untuk jendela saat inix-ratelimit-remaining-requestsdanx-ratelimit-remaining-tokens, yang tersisa saat inix-ratelimit-reset-requestsdanx-ratelimit-reset-tokens, kapan jendela disegarkanretry-after, dikirim pada 429, memberi tahu Anda berapa lama harus menunggu
Baca x-ratelimit-remaining-tokens setelah setiap panggilan dan Anda memiliki pengukur langsung, bukan angka statis yang Anda cari sekali dan lupa untuk ditinjau kembali. Berikut pemeriksaan cepat dengan cURL, hanya mencetak header:
curl -sD - https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "llama-3.1-8b-instant", "messages": [{"role": "user", "content": "hi"}]}' \
  -o /dev/null | grep -i ratelimit
Jalankan itu beberapa kali dalam loop terhadap skrip pengujian yang banyak bicara dan Anda akan melihat x-ratelimit-remaining-tokens menghitung mundur. Jika aplikasi Anda suatu saat memerlukan logika backoff, lihat panduan kami tentang cara menerapkan pembatasan laju API untuk pola yang menghormati header retry-after alih-alih menebak jeda.
Biarkan agen coding Anda menjalankan pemeriksaan dengan Apidog CLI
Melakukan tarian curl-dan-grep secara manual berfungsi untuk satu sesi debugging. Itu tidak berskala untuk tim, dan tidak ada yang menjalankan ulang perintah shell sekali pakai sebelum setiap deploy. Serahkan pemeriksaan itu kepada agen coding Anda: dengan Apidog CLI, ia menulis pengujian sekali dan menjalankannya kapan pun Anda minta. Siapkan sekali:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Token berasal dari Apidog di bawah Account Settings, API Access Token. Lalu beri agen satu prompt:
Use Apidog CLI on project <id>. Create a Groq environment with base URL
https://api.groq.com/openai/v1 and add POST /chat/completions with Bearer auth
from {{GROQ_API_KEY}}. Create one test case per model we run in production
(llama-3.1-8b-instant, openai/gpt-oss-120b) that asserts status 200 and fails
when x-ratelimit-remaining-tokens drops below 10% of x-ratelimit-limit-tokens.
Put both cases in a "Groq limits" test suite, run it, and report the headers.
Perintah yang dijalankannya, diperiksa terhadap Apidog CLI 2.2.7:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog endpoint create --project <id> --file groq-chat.json
apidog cli-schema validate test-case-create --file groq-8b-case.json
apidog test-case create --project <id> --file groq-8b-case.json
apidog test-suite create --project <id> --name "Groq limits"
apidog run --test-suite <suiteId> --project <id> -e <envId> \
  --env-var "GROQ_API_KEY=$GROQ_API_KEY" -r cli,junit
Anggaran yang menyusut kini muncul sebagai pengujian yang gagal alih-alih 429 yang mengejutkan saat demo. Letakkan baris terakhir itu di job CI pra-deploy Anda, seperti dalam panduan pipeline CI/CD Apidog CLI kami, atau minta agen untuk apidog scheduled-task create, yang menjalankan suite pada runner dengan cron. Ini lebih penting mengingat pengumpulan tingkat organisasi Groq: satu rekan tim yang menjalankan job batch dapat memakan anggaran bersama yang dibutuhkan endpoint produksi Anda satu jam kemudian. Ini ide yang sama di balik postingan kami tentang menguji API untuk batas laju GPT.
Apa yang harus dilakukan saat Anda benar-benar mencapai batas
Saat 429 kembali, hormati retry-after alih-alih mencoba ulang segera. Loop retry yang ketat terhadap batas tingkat permintaan hanya menghabiskan anggaran tersisa Anda lebih cepat dan mendorong jendela reset lebih jauh. Jika Anda membangun ini ke dalam layanan produksi alih-alih skrip pengujian, panduan lengkap kami untuk error batas laju terlampaui membahas strategi backoff yang berfungsi di berbagai penyedia, bukan hanya Groq.
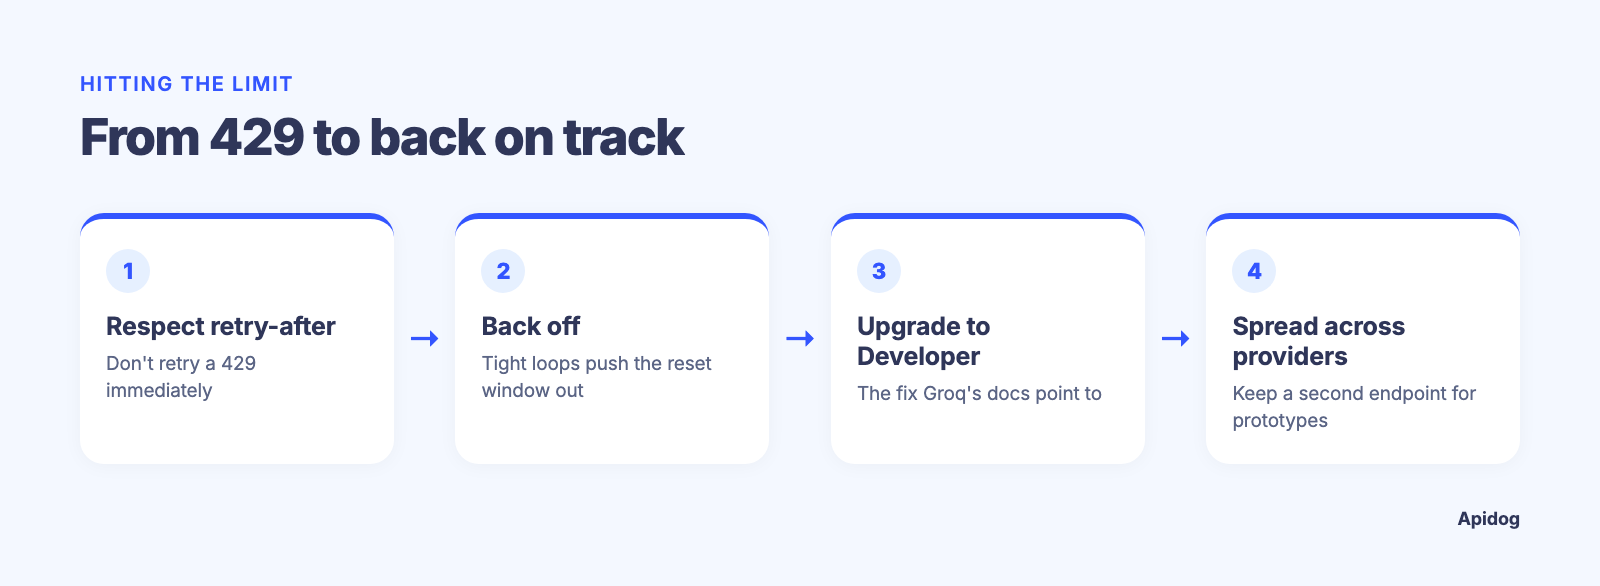
Jika Anda terus-menerus menabrak batas atas di Free Plan, perbaikan tercepat adalah upgrade Developer Plan yang ditunjukkan Groq langsung di dokumentasinya. Perbaikan tercepat kedua, terutama untuk prototipe, adalah menyebarkan traffic ke lebih dari satu penyedia. Rangkuman kami tentang alternatif OpenRouter mencakup endpoint lain yang layak disimpan sebagai cadangan untuk situasi seperti ini.
FAQ
Apakah Groq memiliki tier gratis untuk API-nya? Ya. Setiap akun baru dimulai pada Free Plan dengan akses ke endpoint yang kompatibel dengan OpenAI. Groq menerbitkan contoh batas Free Plan untuk beberapa model, tetapi batas yang benar-benar berlaku untuk akun Anda ada di halaman batas di pengaturan konsol Anda.
Bagaimana cara memeriksa batas laju Groq saya saat ini? Dua cara: buka halaman batas di pengaturan akun Anda, atau baca header x-ratelimit-limit-requests dan x-ratelimit-limit-tokens pada respons API mana pun. Header mencerminkan batas nyata akun Anda pada saat Anda memanggil, yang lebih andal daripada angka yang Anda lihat sekali dan ingat.
Apa yang terjadi saat saya melebihi batas laju Groq? Anda mendapat respons 429 dengan header retry-after yang memberi tahu berapa detik harus menunggu. Lihat panduan batas laju terlampaui kami untuk menangani ini dalam kode alih-alih menebak jeda.
Apakah token yang di-cache dihitung terhadap batas laju Groq saya? Tidak. Groq menyatakan secara langsung bahwa token yang di-cache tidak dihitung terhadap batas laju Anda, jadi struktur prompt yang menggunakan ulang pesan sistem yang di-cache mendapatkan throughput nyata lebih banyak daripada yang disiratkan batas token mentah.
Apakah batas laju Groq per pengguna atau per organisasi? Per organisasi. Setiap kunci di bawah org Groq yang sama berbagi satu kumpulan permintaan dan token, jadi skrip rekan tim dapat memakan anggaran yang dibutuhkan aplikasi produksi Anda.
Model Groq mana yang memiliki jendela konteks terbesar? llama-3.1-8b-instant, llama-3.3-70b-versatile, openai/gpt-oss-120b, openai/gpt-oss-20b, dan sistem Compound semuanya berjalan pada konteks 131.072 token. Model Whisper adalah transkripsi audio, bukan teks, jadi Groq mengukur batasnya dalam durasi audio. Batas laju berbeda antar model bahkan dalam jendela konteks yang sama, jadi periksa masing-masing secara terpisah.
Apa artinya bagi Anda
Cara gratis menggunakan API Groq bukanlah angka rahasia, melainkan kebiasaan. Dapatkan kunci, arahkan endpoint yang kompatibel dengan OpenAI ke sana, dan baca header respons pada setiap panggilan alih-alih memercayai angka yang Anda temukan di postingan blog, termasuk yang ini.
Minta agen coding Anda membangun pemeriksaan itu sekali dengan CLI Apidog, dengan assertion pada token tersisa untuk setiap model, dan pemeriksaan itu berjalan pada setiap deploy sejak saat itu. Penyiapannya memakan waktu lebih singkat daripada membaca sisa dokumentasi Groq. Untuk cakupan lebih mendalam tentang menguji lapisan API AI di bawah beban, panduan kami tentang alat pengujian API terbaik untuk agen AI adalah langkah berikutnya yang baik.