
Grok 4.6 diluncurkan pada 12 Agustus dengan klaim yang mengubah keputusan model terdepan: kecerdasan yang menyamai GPT-5.6 Sol pada Artificial Analysis Index, dengan harga $6 per juta token keluaran, bukan $30. Sebagian besar artikel perbandingan yang akan Anda temukan masih membandingkan Grok 4.5, yang jauh tertinggal dari model terdepan sehingga harganya tidak menjadi masalah. Itu bukan lagi situasinya, jadi perbandingan ini dimulai lagi dengan angka-angka 4.6.
Jawaban singkatnya: GPT-5.6 Sol tetap menjadi pilihan terkuat untuk agen pengkodean skala repositori, Claude Fable 5 memimpin pekerjaan otonom jangka panjang dengan selisih tipis, dan Grok 4.6 kini menjadi pilihan bernilai yang cukup dekat dalam kemampuan untuk membuat dua lainnya membenarkan harga mereka. Pilihan yang tepat tergantung pada beban kerja Anda, jadi di bawah ini adalah angka-angka, pertimbangan API, dan cara yang dapat direproduksi untuk menguji ketiganya pada tumpukan Anda sendiri. Jika Anda ingin menjalankan pengujian itu hari ini, Apidog memungkinkan Anda mengakses ketiga API secara berdampingan dari satu ruang kerja, gratis.
tombol
TL;DR
- Indeks Kecerdasan: Claude Fable 5 memimpin dengan 62; Grok 4.6 dan GPT-5.6 Sol seri dengan 61.
- Harga (output, per 1 juta token): Grok 4.6 seharga $6, Claude Opus 4.8 seharga $25, GPT-5.6 Sol seharga $30, selisih 5x.
- Kontek: GPT-5.6 Sol 1.05 juta token, Claude Fable 5 1 juta, Grok 4.6 500 ribu.
- Pengkodean: Sol Max memimpin DeepSWE (73.0% vs 65.9% milik Grok); Fable 5 Max memimpin FrontierCode (63.6% vs 61.3%).
- Agen: Fable 5 Max memimpin APEX-Agents dengan 59.2%; Grok 4.6 (57.5%) sedikit unggul dari Sol Max (56.7%).
- Biaya per tugas yang selesai: Grok 4.6 diukur seharga $0.84 oleh Artificial Analysis, yang terendah di antara model terdepan.
- Jangan memutuskan hanya berdasarkan tolok ukur: lakukan pengujian 20 prompt pada beban kerja Anda sendiri (metode di bawah).
Spesifikasi dan harga berdampingan
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| Pengembang | xAI | OpenAI | Anthropic |
| Indeks Kecerdasan | 61 | 61 | 62 |
| Jendela kontek | 500K | 1.05M | 1M |
| Harga masukan / 1 juta | $2 | $12 | $10 |
| Harga keluaran / 1 juta | $6 | $30 | $25* |
| Varian cepat/premium | Harga 2x | Tingkat Sol Max | Tingkat Fable 5 Max |
| Gaya API | Kompatibel dengan OpenAI | API asli OpenAI | Pesan Anthropic |
| Batasan pengetahuan | Feb 2026 |
*Harga Claude ditampilkan untuk Opus 4.8; harga tingkat Fable 5 bervariasi berdasarkan pengaturan upaya. Lihat panduan harga GPT-5.6 dan analisis pemotongan biaya Claude kami untuk matriks lengkapnya.
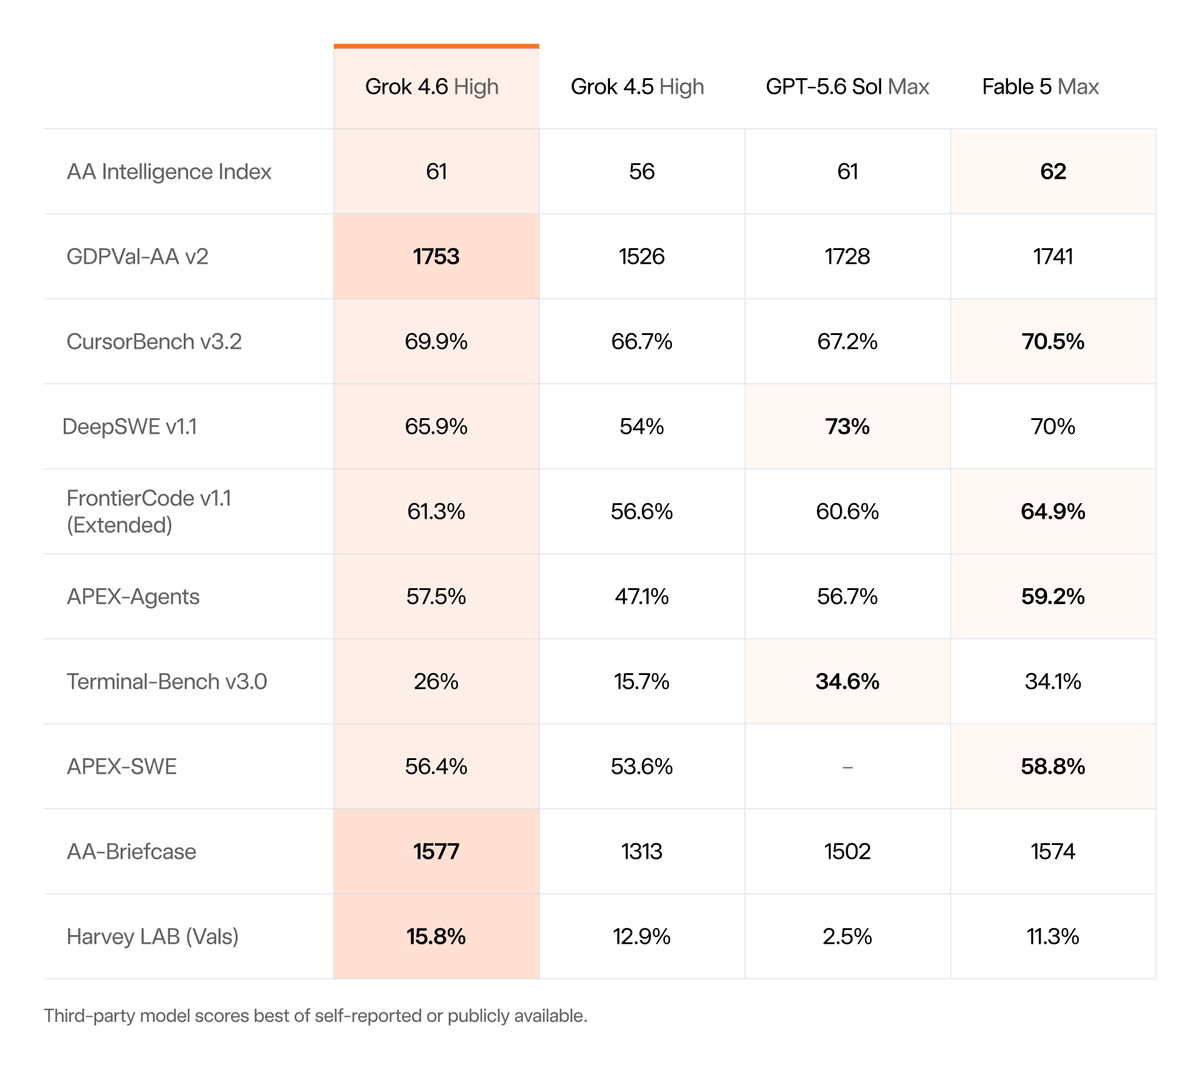
Asimetri harga adalah intinya. Pada sisi masukan, Grok mengenakan biaya seperenam dari OpenAI; pada sisi keluaran, seperlima. Untuk beban kerja obrolan, itu bagus; untuk beban kerja agen, di mana satu tugas dapat menghasilkan puluhan panggilan model dan transkrip penggunaan alat yang panjang, ini menjadi perbedaan antara agen seharga $50/hari dan agen seharga $250/hari.
Tolok ukur pengkodean: Sol untuk kedalaman, Grok untuk nilai
Berdasarkan angka peluncuran, setiap model memiliki wilayahnya sendiri:
| Tolok Ukur | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (perbaikan skala repositori) | 65.9% | 73.0% | |
| FrontierCode v1.1 Diperpanjang | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
Bacalah seperti ini:
- Keunggulan 7 poin DeepSWE GPT-5.6 Sol Max adalah nyata dan penting. Perbaikan bug skala repositori adalah tolok ukur pengkodean yang paling sulit dan paling bernilai secara ekonomi. Jika agen Anda bekerja di seluruh basis kode yang ada dengan pengawasan minimal, Sol masih merupakan pilihan teraman. Perbandingan GPT-5.6 Sol vs Claude Fable 5 kami membahas pertarungan itu secara mendalam.
- Claude Fable 5 menang dalam konsistensi. Ia memimpin indeks komposit, FrontierCode, dan APEX-Agents. Tidak ada yang tajam, ia jarang sekali lebih buruk dari posisi kedua. Profil itu cocok untuk pekerjaan otonom jangka panjang di mana satu langkah yang salah dapat menggagalkan satu jam kemajuan.
- Grok 4.6 tidak pernah jauh tertinggal, dan terkadang di depan. Memimpin CursorBench dan Terminal-Bench sambil tetap berada dalam jangkauan di tempat lain, dengan biaya yang lebih rendah, adalah persis profil model yang akan Anda arahkan sebagian besar lalu lintas Anda, hanya meningkatkan kasus-kasus sulit.
Satu catatan jujur: ini adalah angka-angka minggu peluncuran, sebagian besar dilaporkan oleh vendor. Tolok ukur peluncuran Grok 4.5 membutuhkan pembacaan yang cermat, dan kehati-hatian yang sama berlaku untuk setiap vendor di sini.
Biaya per tugas, bukan biaya per token
Harga token menyesatkan ketika model berbeda dalam verbositas dan tingkat percobaan ulang. Model murah yang gagal dalam eksekusi terminal menciptakan pekerjaan peninjauan dan perbaikan yang biayanya lebih mahal daripada token yang dihemat. Metrik yang lebih baik adalah biaya per tugas yang selesai, dan di sini pengukuran independen Artificial Analysis sangat mencolok: Grok 4.6 rata-rata $0.84 per tugas di seluruh evaluasi agennya, yang terendah di antara model-model terdepan, dibantu oleh penggunaan token yang relatif disiplin daripada hanya harga rendah.
Contoh yang sudah dikerjakan. Misalkan agen pengkodean Anda rata-rata menggunakan 500 ribu token masukan dan 100 ribu token keluaran per tugas yang selesai:
| Model | Biaya masukan | Biaya keluaran | Per tugas |
|---|---|---|---|
| Grok 4.6 | $1.00 | $0.60 | $1.60 |
| Claude Opus 4.8 | $5.00 | $2.50 | $7.50 |
| GPT-5.6 Sol | $6.00 | $3.00 | $9.00 |
Dengan 1.000 tugas sebulan, Grok menghemat sekitar $6.000–7.400 dibandingkan alternatif, jika tingkat keberhasilannya pada beban kerja Anda tetap terjaga. Kondisi itu adalah inti dari segalanya, itulah mengapa Anda harus menguji sebelum berkomitmen.
Ergonomi API: berapa biaya integrasi sebenarnya bagi Anda
- Grok 4.6 kompatibel dengan OpenAI. Jika Anda memiliki klien bergaya OpenAI, Anda mengarahkan
base_urlkehttps://api.x.ai/v1dan Anda siap menjalankannya. Ini juga tersedia di OpenRouter, Vercel, dan Cloudflare untuk pengguna gateway. - GPT-5.6 Sol memiliki ekosistem terdalam: API Respons, panggilan alat secara terprogram, dan SDK pihak pertama di mana-mana. Lihat cara menggunakan API GPT-5.6 untuk struktur tingkatnya.
- Claude Fable 5 menggunakan API Pesan Anthropic, bentuk permintaan yang berbeda, keandalan penggunaan alat yang sangat baik, dan parameter upaya yang menukar biaya dengan kemampuan dalam satu model.
Gesekan migrasi paling rendah antara Grok dan OpenAI (format bersama), paling tinggi saat berpindah ke atau dari Anthropic. Jika Anda mengantisipasi beralih atau merutekan antar model, asimetri itu harus dipertimbangkan dalam keputusan arsitektur Anda.
Jendela konteks: kapan 500 ribu sudah cukup
Secara teori, jendela 1.05 juta token GPT-5.6 Sol dua kali lipat dari 500 ribu Grok 4.6, dengan 1 juta milik Claude Fable 5 menyusul ketat. Dalam praktiknya, pertanyaannya adalah apa yang sebenarnya ditahan oleh beban kerja Anda dalam konteks.
Jendela 500 ribu muat sekitar 350.000 kata: seluruh basis kode layanan menengah, transkrip dukungan selama setahun, atau beberapa ratus halaman dokumen hukum. Sebagian besar tugas agen tidak pernah mendekatinya. Beban kerja yang benar-benar membutuhkan tingkat jutaan token terbatas: analisis seluruh monorepo, transkrip agen multi-sesi yang sangat panjang yang Anda tolak untuk ringkas, dan pemrosesan satu kali set dokumen besar.
Dua catatan praktis menentang pemilihan berdasarkan ukuran jendela saja. Pertama, setiap model mengalami penurunan kualitas saat konteks terisi; kualitas pengambilan pada kapasitas 80% lebih buruk daripada pada 20% pada ketiganya, jadi arsitektur yang memenuhi jendela jarang mengalahkan arsitektur yang mengambil secara selektif. Kedua, token masukan adalah tempat anggaran habis: mengisi jendela penuh Sol membutuhkan biaya sekitar $12.60 per permintaan dengan harga daftar, sedangkan mengisi Grok membutuhkan biaya $1. Jika prompt Anda secara rutin melebihi 400 ribu token, Anda tidak hanya membutuhkan jendela yang lebih besar, Anda membutuhkan strategi caching dan pengambilan, vendor mana pun yang Anda pilih.
Batasan pengetahuan dan kematangan ekosistem
Grok 4.6 dikirimkan dengan batasan pengetahuan per 1 Februari 2026, yang paling baru dari ketiganya, yang penting untuk agen pengkodean yang mereferensikan kerangka kerja yang bergerak cepat. Ini adalah keunggulan nyata tetapi kecil: setiap tumpukan agen yang serius mendasarkan dirinya dengan alat pengambilan dan dokumentasi daripada mempercayai pengetahuan parametrik.
Ekosistem adalah cerita sebaliknya. OpenAI memiliki permukaan integrasi pihak ketiga terdalam, Anthropic memiliki pangsa pikiran kerangka kerja agen terkuat, dan xAI adalah pendatang baru yang mengandalkan kompatibilitas OpenAI untuk meminjam keduanya. Taruhan itu sebagian besar berhasil: apa pun yang berbicara format penyelesaian obrolan berjalan melawan Grok hari ini, dan ketersediaan gateway melalui OpenRouter, Vercel, dan Cloudflare berarti Anda dapat mengadopsinya tanpa menyentuh infrastruktur Anda. Apa yang Anda lepaskan adalah polesan pihak pertama, API batch, tingkatan caching, dan kontrol penggunaan yang terperinci yang kurang matang dibandingkan para pemain lama.
Model mana untuk pekerjaan mana
- Agen pengkodean otonom skala repositori, kualitas utama: GPT-5.6 Sol. Keunggulan DeepSWE berarti lebih sedikit kesalahan dalam eksekusi pada basis kode besar.
- Pekerjaan pengetahuan jangka panjang dan sesi agen multi-jam: Claude Fable 5. Skor komposit terbaik, tolok ukur agen terbaik, rekam jejak terkuat dalam menjaga stabilitas.
- Lalu lintas agen bervolume tinggi, produk yang sensitif biaya, atau model default router: Grok 4.6. Keluaran tingkat terdepan dengan harga tingkat komoditas; tingkatkan 10% tugas tersulit ke Sol atau Fable.
- Pengkodean interaktif di IDE: Keunggulan CursorBench Grok 4.6 ditambah varian cepat 2x-nya menjadikannya pesaing serius; ia secara efektif dibangun untuk ini setelah dilatih pada sesi Cursor yang sebenarnya.
Uji ketiganya di tumpukan Anda dalam satu sore
Tolok ukur memprediksi rata-rata, bukan beban kerja Anda. Berikut adalah pengujian yang dapat direproduksi menggunakan Apidog:
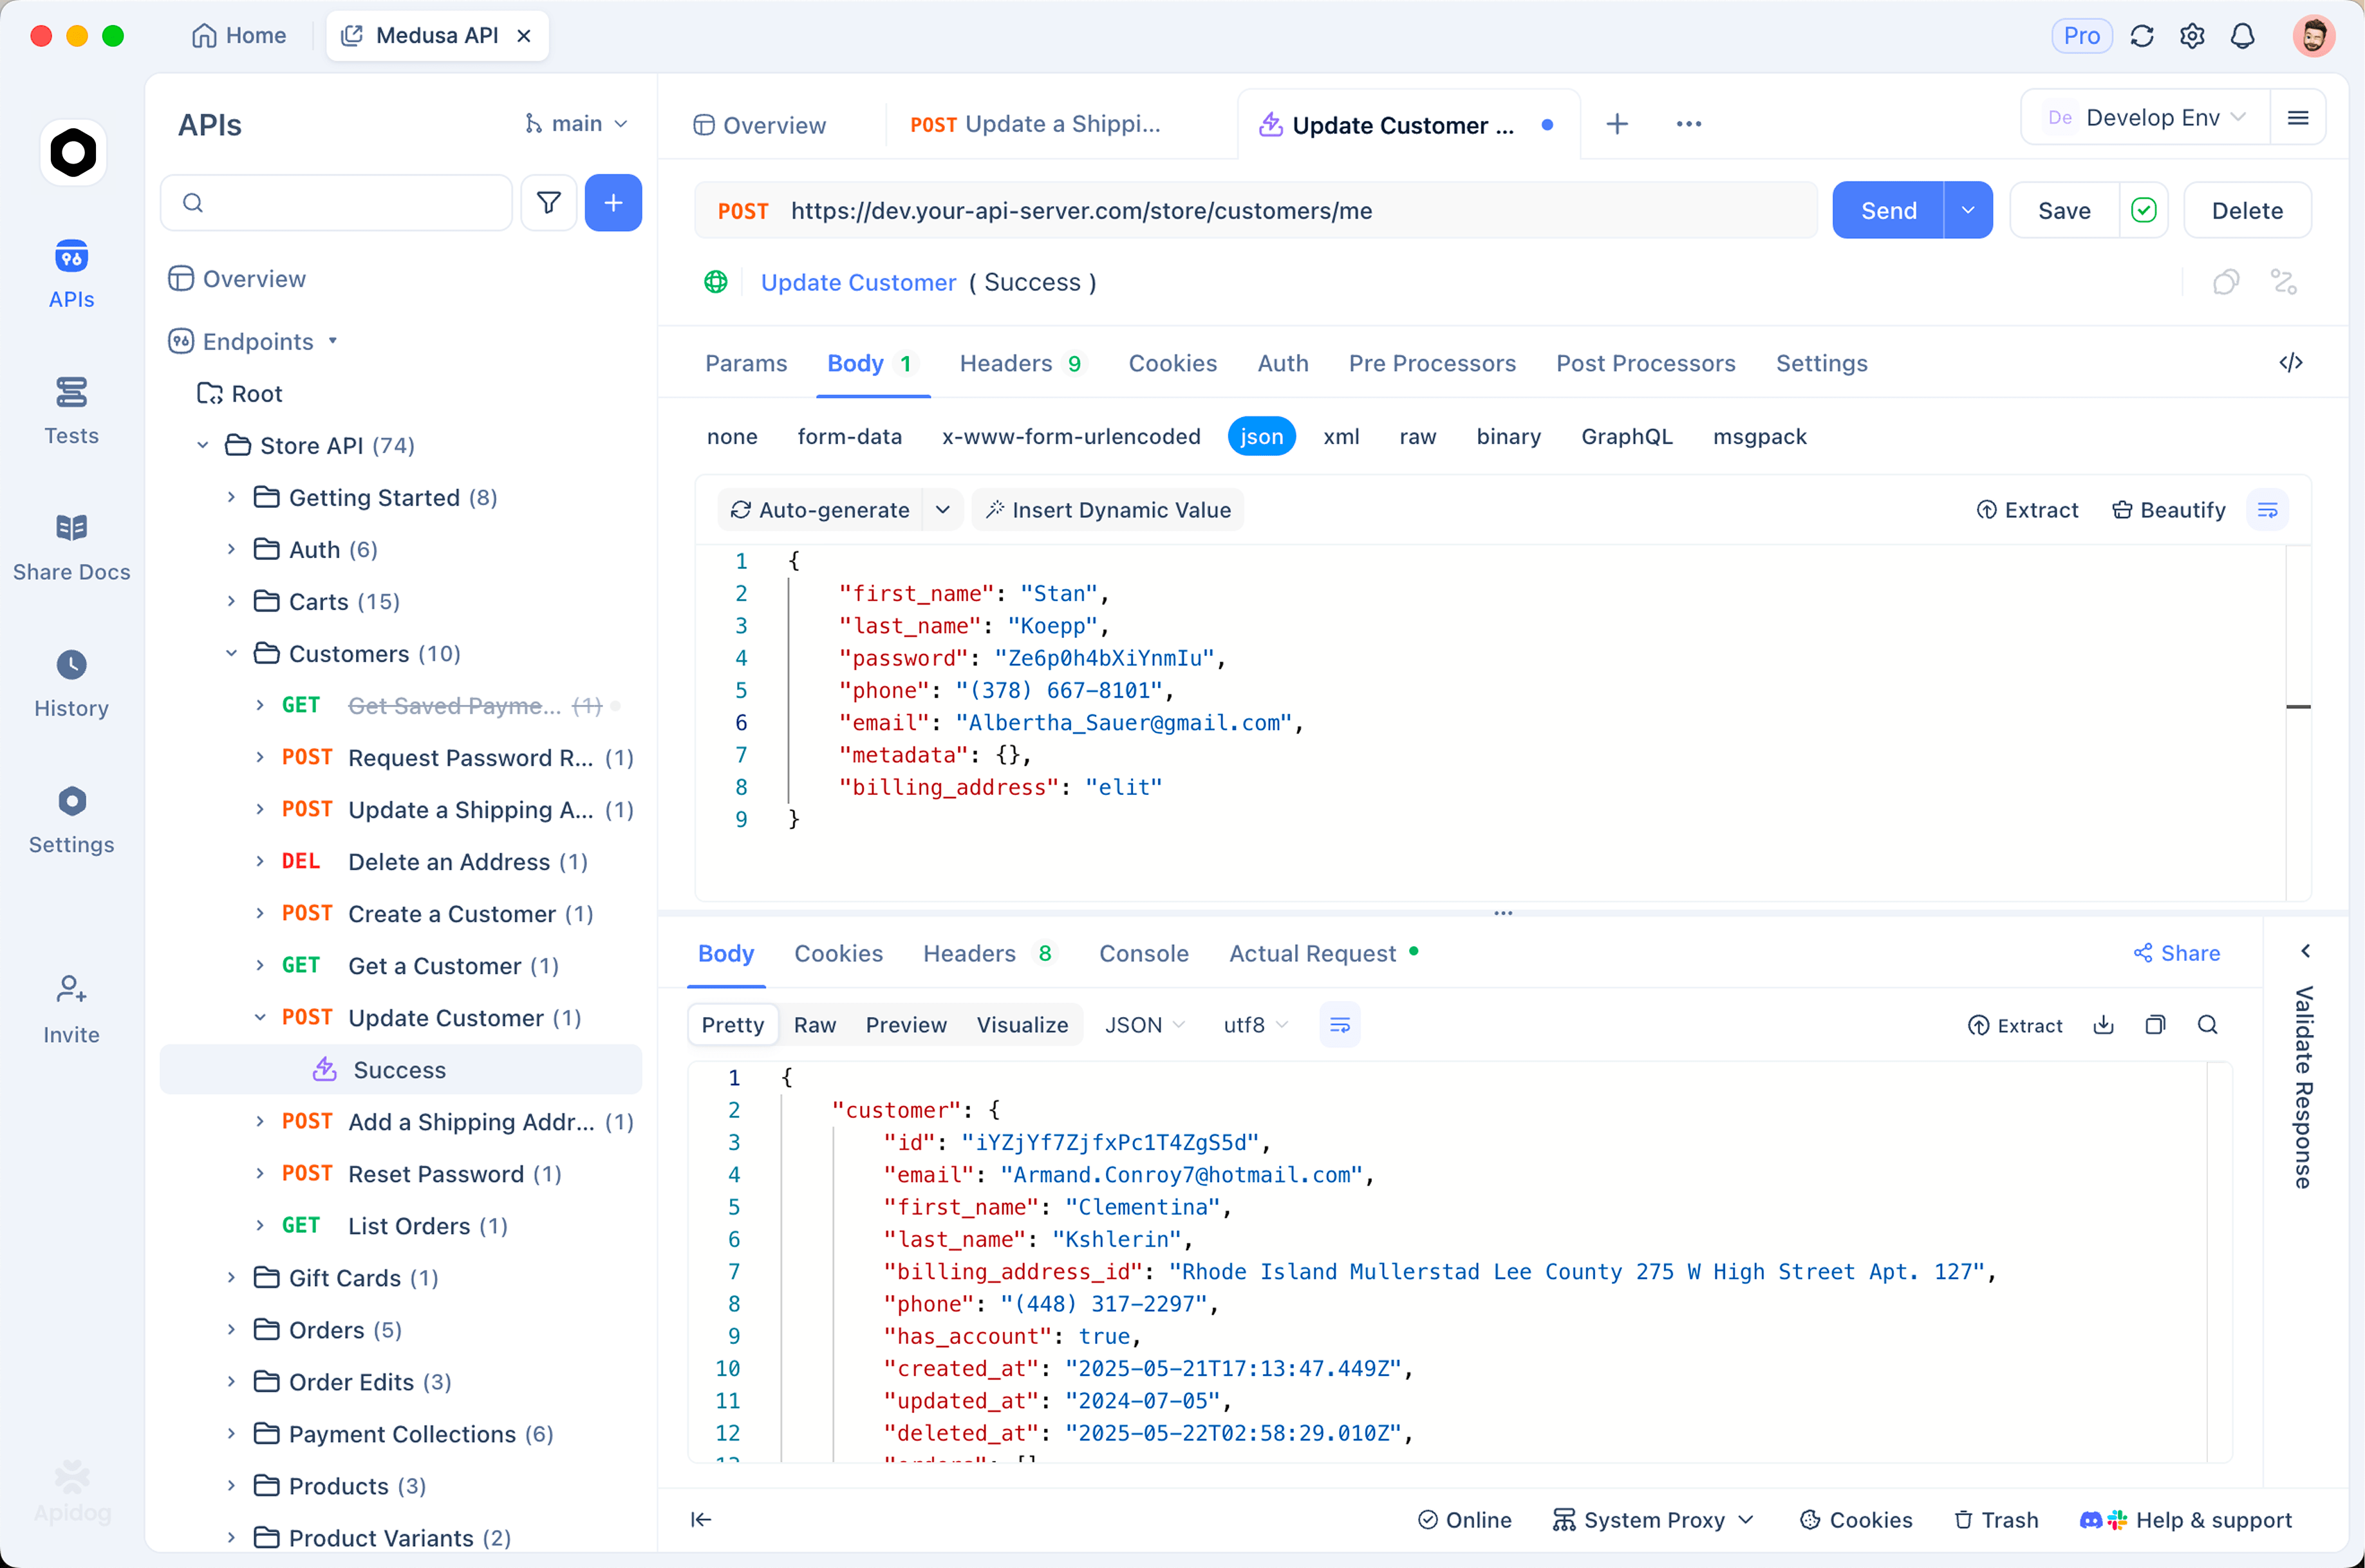
- Satu proyek, tiga lingkungan. Buat lingkungan untuk xAI (
api.x.ai/v1), OpenAI, dan Anthropic, masing-masing dengan otentikasi sendiri. Permintaan yang sama beralih penyedia dengan satu dropdown. - Kumpulkan 20 prompt nyata. Ambil tugas aktual dari produk Anda, bukan pertanyaan main-main. Sertakan prompt sistem Anda, definisi alat Anda jika Anda menggunakan panggilan fungsi, dan setidaknya lima kasus sulit yang diketahui.
- Tegaskan apa yang Anda pedulikan. Tambahkan pernyataan Apidog untuk validitas respons, penggunaan token dari objek
usage, dan ambang batas latensi. Untuk beban kerja panggilan alat, tegaskan bahwa JSON panggilan alat diurai dan cocok dengan skema Anda, model lebih sering gagal di sini daripada dalam prosa. - Jalankan sebagai skenario pengujian, tiga kali per model. Keluaran LLM bervariasi; tiga kali eksekusi menunjukkan variasi yang disembunyikan oleh satu demo. Ekspor hasilnya dan bandingkan tingkat keberhasilan serta biaya per keberhasilan, bukan biaya per token.
- Pertahankan suite ini. Ketika versi model berikutnya dikirimkan (dengan irama saat ini, dalam beberapa bulan), jalankan lagi. Pemilihan model sekarang adalah keputusan triwulanan, dan tim dengan alat evaluasi yang tetap beralih lebih cepat beberapa minggu daripada tim yang memutuskan kembali berdasarkan anekdot.
FAQ
Apakah Grok 4.6 lebih baik dari GPT-5.6 Sol? Keduanya seri pada indeks komposit dengan 61. Sol jelas memimpin pengkodean skala repositori (DeepSWE 73.0% vs 65.9%); Grok memimpin CursorBench dan Terminal-Bench dan biayanya 5x lebih murah pada sisi keluaran. "Lebih baik" tergantung pada apakah beban kerja Anda lebih mirip DeepSWE atau lebih mirip sesi IDE.
Apakah Grok 4.6 lebih baik dari Claude Fable 5? Fable 5 memimpin pada indeks (62 vs 61), FrontierCode, dan APEX-Agents, semuanya dengan selisih tipis. Keunggulan Grok adalah harga. Untuk pekerjaan otonom yang kritis akurasi, Fable 5; untuk volume yang sensitif biaya, Grok.
Model AI mana yang termurah di garis depan pada tahun 2026? Grok 4.6, dengan $2/$6 per juta token dan terukur secara independen $0.84 per tugas agen. Token keluaran pesaing terdepan terdekat berharga sekitar 4x lebih mahal.
Haruskah saya mengganti agen produksi saya ke Grok 4.6? Jangan hanya berdasarkan tolok ukur. Jalankan pengujian di atas pada beban kerja Anda yang sebenarnya terlebih dahulu, selisih harga 5x hanya akan terbayar jika tingkat keberhasilan tetap terjaga pada tugas-tugas Anda.
Bisakah saya menggunakan ketiga model di balik satu format API? Sebagian besar bisa. Grok 4.6 berbicara format penyelesaian obrolan OpenAI secara native, jadi ia berbagi kode klien dengan GPT-5.6. Claude memerlukan API Pesan Anthropic, atau gateway seperti OpenRouter yang menormalisasi ketiganya di balik satu antarmuka dengan sedikit markup.
Apakah jendela konteks Grok 4.6 yang lebih kecil menjadi masalah? Untuk sebagian besar beban kerja agen dan obrolan, tidak; 500 ribu token jauh di atas penggunaan umum, dan ketiga model tetap mengalami penurunan kualitas mendekati batasnya. Ini menjadi masalah jika Anda secara rutin memproses seluruh monorepo atau set dokumen besar dalam satu panggilan, di mana jendela 1.05 juta milik Sol memberikan ruang kepala yang nyata.
tombol