
Perbandingan GPT-Live-1.1 vs GPT-Realtime pada dasarnya bermuara pada arsitektur. GPT-Live-1.1 adalah frontend suara full-duplex yang menyerahkan proses penalaran dan penggunaan tool ke model backend terpisah, dengan tarif $0,05 per menit aktif. Sementara GPT-Realtime-2.1 adalah satu model speech-to-speech yang mendengar, bernalar, memanggil tool, dan berbicara, dengan penagihan per token. Pilih GPT-Live-1.1 jika Anda sudah memiliki agen teks; pilih Realtime jika Anda ingin satu model mengerjakan semuanya.
OpenAI merilis GPT-Live-1.1 ke API pada 20 November 2026, jadi sekarang Anda punya dua stack suara dengan endpoint, skema penagihan, dan model tool yang berbeda. Artikel kami di bulan Juli, GPT-Live vs GPT-Realtime, membandingkan fitur ChatGPT dengan API; artikel kali ini membandingkan API dengan API.
Sekilas perbandingan GPT-Live-1.1 vs GPT-Realtime
Berikut perbandingan kedua stack tersebut, diambil dari halaman model GPT-Live-1.1, halaman model gpt-realtime-2.1, dan halaman harga OpenAI pada 20 November 2026:
| GPT-Live-1.1 | gpt-realtime-2.1 | |
|---|---|---|
| Endpoint | v1/live/sessions |
v1/realtime |
| Desain | Suara full-duplex ditambah backend terdelegasi | Satu model penalaran speech-to-speech |
| Input | Audio, teks | Audio, teks, gambar |
| Output | Audio, teks | Audio, teks |
| Penagihan | $0,05/menit aktif, $0,02/menit standby | $32 masuk, $64 keluar per 1 juta token audio |
| Penalaran dan tool | Model backend, ditagih terpisah | Termasuk dalam model dan harga yang sama |
| Function calling | Melalui delegasi | session.tools |
| Transport | WebRTC, WebSocket, SIP (masuk dan keluar) | WebRTC, WebSocket, SIP (masuk) |
| Batas laju | Sesi bersamaan | Permintaan dan token per menit |
Panduan voice agent dari OpenAI merangkum perbedaan ini dalam tabel arsitekturnya. GPT-Live ditujukan untuk “percakapan full-duplex dengan backend terpisah.” Realtime API ditujukan untuk “speech, penalaran, dan penggunaan tool dalam satu sesi.”
Arsitektur: delegasi vs satu model
GPT-Live-1.1 memisahkan aktivitas berbicara dari aktivitas berpikir. Model suara menangani percakapan secara real time dan mendengarkan sambil berbicara. Ketika ada permintaan yang membutuhkan penalaran, pencarian, atau tool, model ini mendelegasikan pekerjaan tersebut ke model backend dan tetap melanjutkan percakapan selama proses itu berjalan.
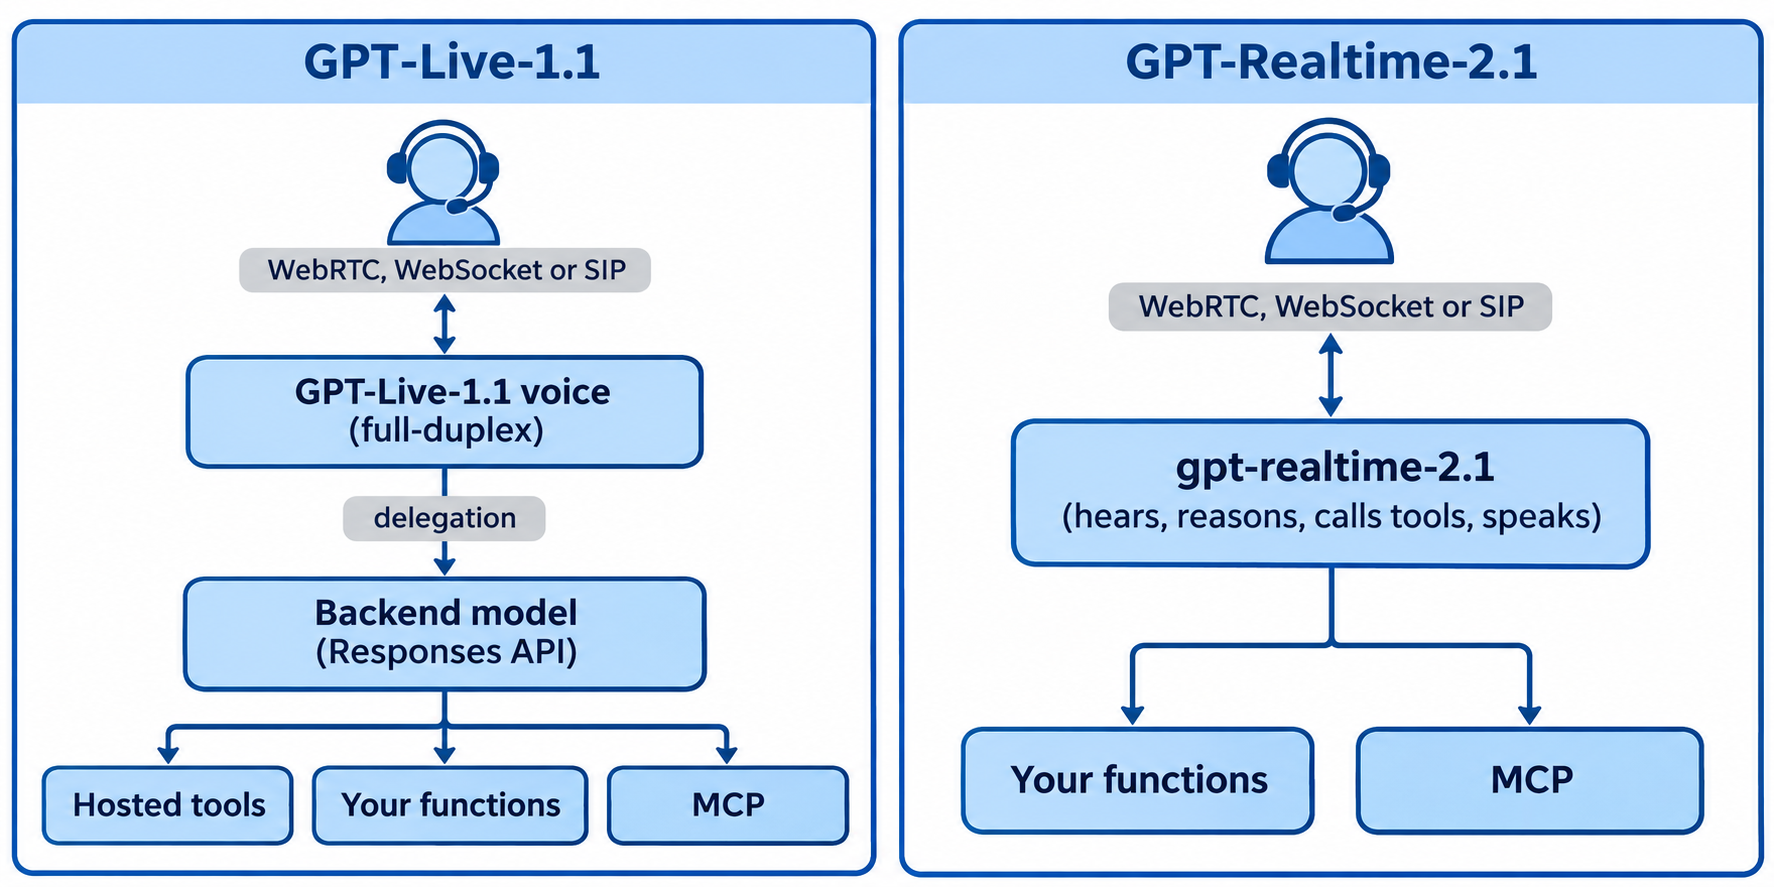
Anda mengatur delegasi satu kali, saat membuat sesi, sesuai panduan live conversations. Ada dua mode:
responses: OpenAI menjalankan backend melalui Responses API. Anda memilih model didelegation.responses.modeldan menambahkaninstructions,tools,tool_choice,reasoning, danservice_tier. Dokumentasi menyarankan memulai dengangpt-6-lunadan beralih kegpt-6-soluntuk tugas yang lebih sulit.client: aplikasi Anda yang menjalankan backend. GPT-Live mengirim eventsession.delegation.created, dan Anda mengembalikan hasilnya melalui event sepertisession.instructions.append.
Mode tidak dapat diubah di tengah sesi; peralihan mode berarti sesi baru. Pengaturan backend di dalamnya dapat diubah dengan session.update.
gpt-realtime-2.1 mengambil pendekatan sebaliknya: satu model penalaran menafsirkan audio, memanggil tool, dan menjawab dengan suara. Tidak ada model kedua, tidak ada handoff, dan seluruh konteks berada di satu tempat.
Dengan GPT-Live-1.1, Anda dapat mengganti backend atau mempertahankan agen teks yang sudah ada tanpa menyentuh lapisan suara. Dengan Realtime, model suara itulah agennya.
Harga: per menit vs per token
GPT-Live-1.1 menagih berdasarkan waktu, sedangkan Realtime menagih berdasarkan token. Hal ini membuat perilaku biaya keduanya sangat berbeda begitu penelepon berhenti bicara, berbicara bertele-tele, atau menahan sambungan.
| Komponen biaya | GPT-Live-1.1 | gpt-realtime-2.1 | gpt-realtime-2.1-mini |
|---|---|---|---|
| Audio | $0,05/menit aktif, $0,02/menit standby | $32 masuk, $64 keluar per 1 juta token | $10 masuk, $20 keluar per 1 juta token |
| Teks | Ditagih berdasarkan durasi sesi | $4 masuk, $24 keluar per 1 juta token | $0,60 masuk, $2,40 keluar per 1 juta token |
| Input cache | t/a | $0,40 per 1 juta token | $0,30 audio, $0,06 teks per 1 juta |
| Penalaran dan tool | Model backend dengan tarifnya sendiri | Termasuk dalam harga token | Termasuk dalam harga token |
GPT-Live menagih per detik, sehingga panggilan 90 detik memakan biaya $0,075 untuk waktu suara, bukan $0,10. Sesi WebRTC menagih 15 detik selama inisialisasi, lalu dikreditkan kembali begitu sesi mulai berjalan.
Standby adalah pengungkit biaya yang tidak dimiliki Realtime. Pada WebRTC, atur wake_policy.type ke "speech" dan idle_timeout_s ke bilangan bulat dari 5 sampai 60. Setelah sekian detik tanpa suara, sesi turun ke $0,02 per menit sampai ada yang berbicara lagi. Standby hanya didokumentasikan untuk WebRTC, jadi sesi WebSocket dan SIP menagih setiap detik tersambung dengan tarif aktif.
Untuk membandingkan keduanya sesuai trafik Anda sendiri, gunakan angka titik impas alih-alih menebak. $0,05 setara dengan sekitar 1.560 token audio input atau 780 token audio output pada gpt-realtime-2.1, dan sekitar 5.000 token input atau 2.500 token output pada 2.1-mini. Ambil jumlah token audio per menit dari event penggunaan Realtime Anda. Jika rata-rata satu menit aktif Anda memakai lebih dari itu, waktu suara GPT-Live lebih murah; setelah itu tambahkan tagihan token model backend untuk melihat gambaran lengkapnya.
Realtime membundel penalaran ke dalam harga token; GPT-Live menambahkan tagihan backend per tugas terdelegasi, tetapi memangkas biaya saat ada jeda hening berkat standby. Untuk sisi token, lihat panduan gpt-realtime-2.1-mini kami.
Function calling dan tool
Kedua stack sama-sama memanggil fungsi Anda, tetapi dari tempat yang berbeda.
Pada Realtime, tool berada di level sesi. Panduan tool Realtime menunjukkan tool "type": "function" di session.tools, yang dikirim dengan session.update. Klien Anda menjalankan fungsi tersebut dan mengembalikan item function_call_output. Server MCP jarak jauh juga bisa digunakan: tambahkan tool dengan "type": "mcp", server_label, dan server_url, lalu Realtime API akan memanggil server tersebut untuk Anda. Anda juga dapat membatasi cakupan tool untuk satu giliran dengan response.tools.
Pada GPT-Live-1.1, tool berada di level backend. Anda menempatkan tool fungsi, server MCP, dan tool terhosting seperti web search, file search, dan Code Interpreter di delegation.responses.tools. Event dari backend sampai ke Anda dengan dibungkus dalam amplop response.event, dan hasil fungsi Anda dikirim kembali sebagai item function_call_output yang diikuti dengan response.create.
Keuntungannya: suara tetap responsif saat tool yang lambat berjalan di backend. Biayanya: dua model, dua aliran event, dan dua tagihan.
Pergantian giliran, interupsi, dan transport
Di sinilah perbedaan keduanya paling terasa bagi penelepon.
Pergantian giliran. GPT-Live-1.1 bersifat full-duplex: ia memproses audio masuk saat menghasilkan output, sehingga dapat mendengarkan, memberi respons singkat (backchannel), dan menyesuaikan diri di tengah kalimat. Realtime bekerja dalam giliran yang dideteksi oleh voice activity. Panduan VAD Realtime mencantumkan dua mode pada session.audio.input.turn_detection.type:
server_vad, default, disetel denganthreshold,prefix_padding_ms, dansilence_duration_ms.semantic_vad, disetel denganeagerness(low,medium,high, atauauto, yang setara denganmedium).
Realtime menangani barge-in dengan interrupt_response. GPT-Live tidak memerlukan pengaturan itu, karena ia sudah mendengarkan sambil berbicara.
Transport. Keduanya mendukung WebRTC di browser dan WebSocket di server. Panggilan telepon berbeda. Menurut panduan SIP, GPT-Live mendukung SIP masuk dan keluar, dan panggilan keluar “tersedia untuk semua organisasi melalui Live API, bukan melalui endpoint pembuatan panggilan Realtime API.” Panggilan SIP GPT-Live yang tersambung dibatasi hingga 2 jam. Panduan SIP Realtime mencakup panggilan masuk melalui webhook realtime.call.incoming.
Batas dan konteks
| Batas | GPT-Live-1.1 | gpt-realtime-2.1 |
|---|---|---|
| Konteks | 128.000 token per sesi, dikelola otomatis | 128.000 token |
| Token output maksimum | Tidak dipublikasikan | 32.000 |
| Instructions | Hingga 16.384 token | Tidak dipublikasikan |
| Batas laju | Sesi bersamaan, per model | 400 RPM dan 200.000 TPM pada tier Build |
GPT-Live menghitung konkurensi, bukan token. Halaman GPT-Live-1 mencantumkan 50 sesi bersamaan pada tier Build, 300 pada Launch, dan 500 pada Grow, tanpa akses tier Free. GPT-Live-1.1 memiliki batas tersendiri yang terpisah, dan halamannya belum mempublikasikan angkanya, jadi periksa halaman batas organisasi Anda sebelum peluncuran.
Batas Realtime dapat diskalakan hingga 10.000 RPM pada Launch dan 20.000 RPM pada Grow.
API suara OpenAI mana yang sebaiknya Anda gunakan?
Gunakan GPT-Live-1.1 ketika suara merupakan lapisan di atas agen yang sudah Anda percaya, dan gunakan Realtime ketika model suara seharusnya menjadi agen itu sendiri.
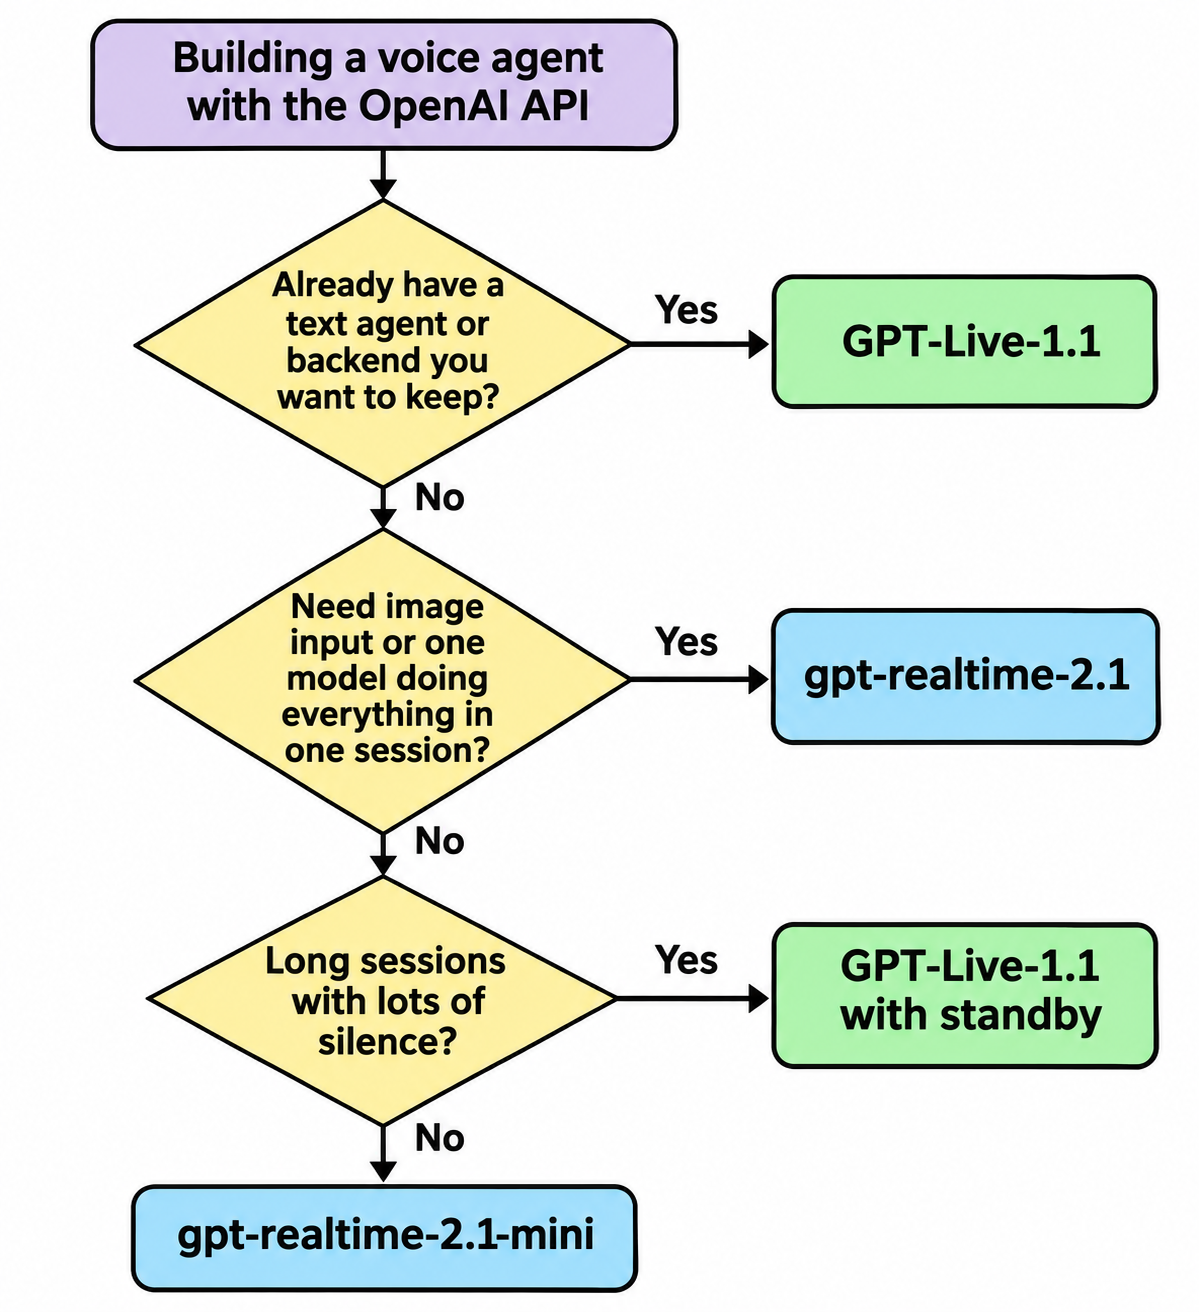
Pilih GPT-Live-1.1 untuk:
- Menambahkan suara ke agen teks, bot dukungan, atau alur kerja yang sudah ada tanpa membangunnya ulang.
- Sesi panjang dengan banyak jeda, seperti tutoring, coaching, atau companion, di mana standby memberikan penghematan.
- Panggilan telepon keluar, yang hanya ditawarkan oleh Live API.
- Percakapan yang membutuhkan tumpang-tindih alami dan backchanneling.
Pilih gpt-realtime-2.1 untuk:
- Agen suara mandiri di mana satu model seharusnya bernalar dan bertindak.
- Aplikasi yang mengirim gambar bersamaan dengan suara.
- Tim yang menginginkan satu aliran event dan satu tagihan.
Pilih gpt-realtime-2.1-mini untuk tugas suara singkat, bervolume tinggi, dan berbiaya rendah di mana harga per token lebih hemat daripada per menit. Panduan GPT-Realtime-2 API kami membahas penyiapan Realtime secara mendalam.
Biarkan coding agent Anda menguji API tool dengan Apidog CLI
Apa pun stack yang menang, keduanya memanggil hal yang sama: API tool Anda. Pencarian yang lambat berarti waktu hening dalam kedua kasus, jadi ujilah latensi dan kontraknya sebelum ada penelepon yang mendengarnya. Biarkan Claude Code, Codex, atau Cursor melakukannya dengan Apidog CLI.
Siapkan sekali:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Lalu berikan satu prompt ke agent Anda:
Import ./voice-tools-openapi.yaml into Apidog project <projectId>. Build a test scenario
that calls GET /orders/{order_id} and GET /customers/{id} in sequence, asserts 200 and
the fields my voice agent reads aloud, and fails any request slower than 800 ms.
Run it 20 times against staging and tell me which step is slowest.
Agent akan mengimpor spesifikasi tersebut, memeriksa bentuk payload, membangun skenario, dan menjalankannya:
apidog import --project <projectId> --format openapi --file ./voice-tools-openapi.yaml
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointIds> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <envId> -n 20 --timeout-request 800 -r cli,json
-n 20 mengulang eksekusi sehingga satu respons yang kebetulan baik tidak menyembunyikan ekor yang lambat, dan --timeout-request 800 membuat panggilan apa pun yang cukup lambat hingga membuat penelepon menunggu akan gagal. Ganti -r cli,json dengan -r junit di CI agar regresi memblokir deployment, seperti yang ditunjukkan dalam panduan Apidog CLI CI/CD kami. Baru mengenal alur kerja agent? Mulailah dengan Apidog CLI di Claude Code. Paket Free Apidog mencakup hingga 4 pengguna.
FAQ
Mana yang lebih murah, GPT-Live-1.1 atau GPT-Realtime? Tergantung pada jumlah token audio per menit dan backend Anda. Suara GPT-Live berbiaya $0,05 per menit aktif ditambah token model backend. Pada gpt-realtime-2.1, $0,05 setara dengan sekitar 1.560 token audio input atau 780 token audio output. Bandingkan dengan log penggunaan Anda sendiri.
Bisakah saya menggunakan function calling dengan GPT-Live-1.1? Ya, melalui delegasi. Letakkan tool fungsi di delegation.responses.tools, atau jalankan backend sendiri dalam mode delegasi client. Model suara tidak menerima daftar tool secara langsung seperti session.tools pada Realtime.
Apakah GPT-Realtime mendukung penagihan standby? Tidak. Standby dengan tarif $0,02 per menit adalah fitur GPT-Live, dan hanya untuk sesi WebRTC yang dikonfigurasi dengan wake_policy dan idle_timeout_s. Realtime menagih token yang digunakan setiap sesi.
Bisakah GPT-Live-1.1 melakukan panggilan telepon keluar? Ya. Buat sesi dengan transport.type: "sip" dan detail SIP trunk Anda pada POST /v1/live/sessions. Dokumentasi OpenAI menyatakan bahwa SIP keluar berjalan melalui Live API, bukan melalui endpoint pembuatan panggilan Realtime API.
Apakah GPT-Live-1.1 menerima input gambar? Tidak. Halaman model mencantumkan audio dan teks sebagai input dan output. Jika agen suara Anda perlu melihat gambar, gpt-realtime-2.1 menerima input gambar dengan tarif $5 per 1 juta token.