
Harga GPT-Live-1.1 dihitung berdasarkan waktu, bukan token. OpenAI menagih sesi suara sebesar $0,05 per menit aktif dan $0,02 per menit standby, dibayar per detik tanpa pembulatan ke menit berikutnya. Model backend dan pemanggilan tool ditagih terpisah sesuai tarif normalnya. Satu jam percakapan tanpa henti berbiaya $3,00 untuk biaya suara; satu jam yang parkir dalam mode standby berbiaya $1,20.
Kartu tarifnya singkat. Yang penting adalah bagaimana perilakunya di aplikasi nyata, tempat penelepon berhenti sejenak, backend berpikir, dan sesi terbuka terlalu lama. Berikut ini tiga contoh perhitungan beserta pengaturan yang membuat tagihan tetap terprediksi.
Sekilas harga GPT-Live-1.1
GPT-Live-1.1 memiliki dua tarif suara dan satu tagihan terpisah untuk backend. Berikut yang tercantum di halaman model GPT-Live-1.1 dan halaman harga OpenAI per 20 November 2026:
| Biaya | Tarif | Per jam | Catatan |
|---|---|---|---|
| Waktu sesi aktif | $0,05 per menit | $3,00 | Ucapan, keheningan sebelum idle timeout, menunggu pekerjaan backend |
| Waktu sesi standby | $0,02 per menit | $1,20 | Hanya WebRTC, saat inference dijeda |
| Model backend Responses | Tarif token normal | Bervariasi | Model apa pun yang Anda pilih untuk delegasi |
| Hosted tools | Tarif tool normal | Bervariasi | Web search, file search, Code Interpreter, dan lainnya |
Tiga detail lebih penting daripada tarif utamanya:
- Penagihan per detik. Panggilan 90 detik berbiaya $0,075, bukan $0,10; durasi tidak dibulatkan ke menit penuh.
- Harga sama dengan GPT-Live-1. Kedua model memiliki tarif identik, jadi upgrade tidak mengubah tagihan suara.
- Biaya awal 15 detik. Pembuatan sesi WebRTC menagih 15 detik saat inisialisasi, yang dikreditkan begitu sesi berjalan. Biaya ekstra hanya muncul untuk sesi yang Anda buat lalu tinggalkan.
Untuk latar belakang tentang stack suara, lihat GPT-Live vs GPT-Realtime.
Apa yang dihitung sebagai menit aktif vs standby
Menit aktif adalah setiap waktu ketika inference sedang berjalan. Menit standby adalah waktu ketika sesi WebRTC tetap terhubung dengan inference dijeda, menunggu ucapan. Selisih $0,03 per menit di antara keduanya menentukan sebagian besar tagihan suara Anda.
Panduan biaya OpenAI menjelaskan apa saja yang masuk ke kategori aktif:
- Waktu ketika pengguna atau model sedang berbicara.
- Keheningan sebelum idle timeout Anda berakhir.
- Waktu yang dihabiskan menunggu pekerjaan backend selagi inference berjalan.
Mematikan mikrofon tidak memicu standby; sesi tetap ditagih $0,05 per menit.
Standby membutuhkan dua pengaturan saat pembuatan sesi, yang didokumentasikan dalam panduan live conversations:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech" memberi tahu sesi untuk menunggu ucapan sebelum memulai inference. idle_timeout_s menerima bilangan bulat dari 5 hingga 60 dan mengembalikan sesi ke standby setelah sekian detik tanpa transkrip masukan maupun keluaran. Jika timeout dihilangkan, inference tetap aktif hingga sesi berakhir, sehingga Anda tidak pernah mendapatkan tarif standby.
Dua catatan penting: standby hanya untuk WebRTC, sehingga sesi WebSocket dan SIP menagih setiap detik terhubung dengan tarif aktif, dan balasan pertama setelah standby bisa lebih lambat.
Contoh perhitungan biaya
Tarif suara adalah yang dipublikasikan; jumlah token backend adalah asumsi ilustratif. Harga backend berasal dari halaman harga OpenAI: gpt-6-luna seharga $0,10 input dan $0,50 output per 1M token, gpt-6-sol seharga $2,00 input dan $10,00 output per 1M token (tier standar, konteks pendek). Panduan delegasi OpenAI menyarankan untuk memulai dengan gpt-6-luna dan mencoba gpt-6-sol untuk tugas backend yang lebih berat.
Contoh 1: saluran dukungan pelanggan
Panggilan dukungan via telepon atau WebSocket berlangsung 6 menit. Standby tidak berlaku, sehingga seluruh 6 menit ditagih sebagai aktif. GPT-Live mendelegasikan 4 pencarian ke gpt-6-luna, masing-masing menggunakan sekitar 6.000 token input dan 400 token output.
| Rincian | Perhitungan | Biaya |
|---|---|---|
| Suara | 6 menit x $0,05 | $0,30 |
| Input backend | 24.000 token x $0,10 / 1M | $0,0024 |
| Output backend | 1.600 token x $0,50 / 1M | $0,0008 |
| Per panggilan | $0,3032 |
Pada 10.000 panggilan per bulan, itu sekitar $3.032, dan $3.000 di antaranya adalah waktu suara. Memangkas 30 detik dari rata-rata panggilan menghemat lebih banyak daripada seluruh tagihan backend.
Contoh 2: tutor bahasa di browser
Sesi tutor WebRTC selama 30 menit dengan idle_timeout_s diatur ke 15. Siswa menghabiskan waktu lama untuk membaca dan berpikir, sehingga sesi berjalan 18 menit aktif dan 12 menit standby. Tutor mendelegasikan 10 penjelasan ke gpt-6-sol dengan sekitar 8.000 token input dan 600 token output masing-masing.
| Rincian | Perhitungan | Biaya |
|---|---|---|
| Suara aktif | 18 menit x $0,05 | $0,90 |
| Suara standby | 12 menit x $0,02 | $0,24 |
| Input backend | 80.000 token x $2,00 / 1M | $0,16 |
| Output backend | 6.000 token x $10,00 / 1M | $0,06 |
| Per sesi | $1,36 |
Tanpa standby, 30 menit suara yang sama akan berbiaya $1,50 alih-alih $1,14, sehingga standby memangkas tagihan suara sebesar 24%.
Contoh 3: asisten desktop yang selalu aktif
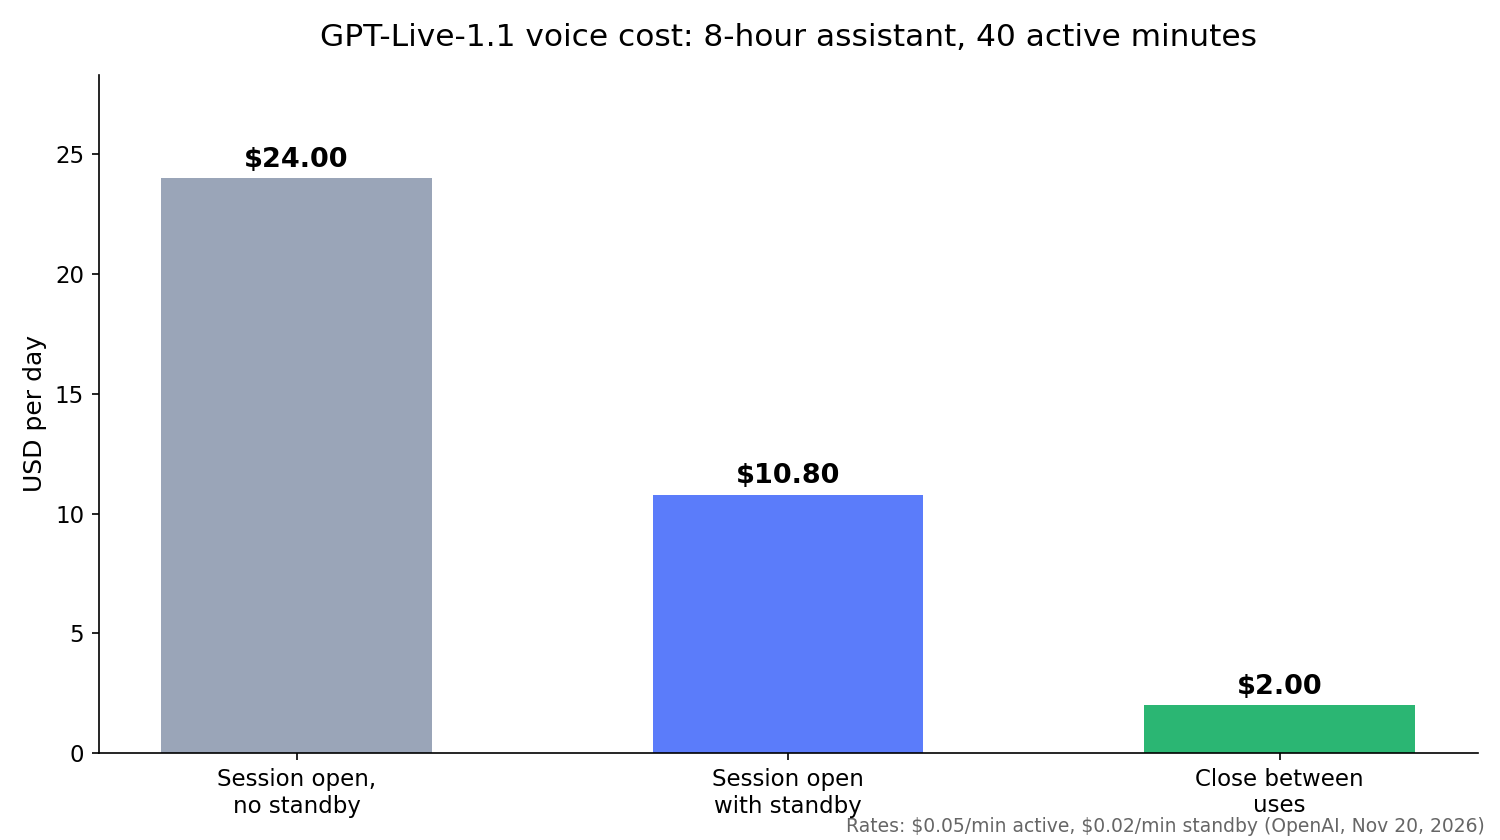
Sebuah asisten tetap terbuka selama hari kerja 8 jam, tetapi pengguna hanya berbicara dengannya selama 40 menit dalam beberapa sesi singkat. Di sini strategi yang Anda pilih mengubah tagihan lebih dari 10x:
| Strategi | Perhitungan | Per hari | Per bulan (22 hari) |
|---|---|---|---|
| Sesi terbuka, tanpa standby | 480 menit x $0,05 | $24,00 | $528,00 |
| Sesi terbuka dengan standby | 40 x $0,05 + 440 x $0,02 | $10,80 | $237,60 |
| Menutup sesi di antara penggunaan | 40 menit x $0,05 | $2,00 | $44,00 |
Standby tetap berbiaya $1,20 per jam menganggur. Panduan OpenAI menyarankan untuk menutup sesi selama jeda panjang dan memulai sesi baru, yang diberi riwayat tersimpan, saat pengguna kembali. Biaya awal 15 detik dikreditkan begitu sesi baru berjalan, jadi dari sisi biaya suara saja, menutup sesi lebih menguntungkan. Anda mengorbankan bangun seketika: sesi yang ditutup tidak bisa mendengar pengguna, sehingga Anda perlu push-to-talk atau pemicu bangun sendiri.
Bagaimana idle timeout mengubah tagihan Anda
Setiap jeda menimbulkan biaya waktu aktif hingga idle timeout berbunyi. Timeout yang lebih pendek mencapai tarif standby yang lebih murah lebih cepat, dengan konsekuensi lebih banyak siklus jeda-lanjut dan balasan pertama yang lebih lambat setelah setiap siklus.
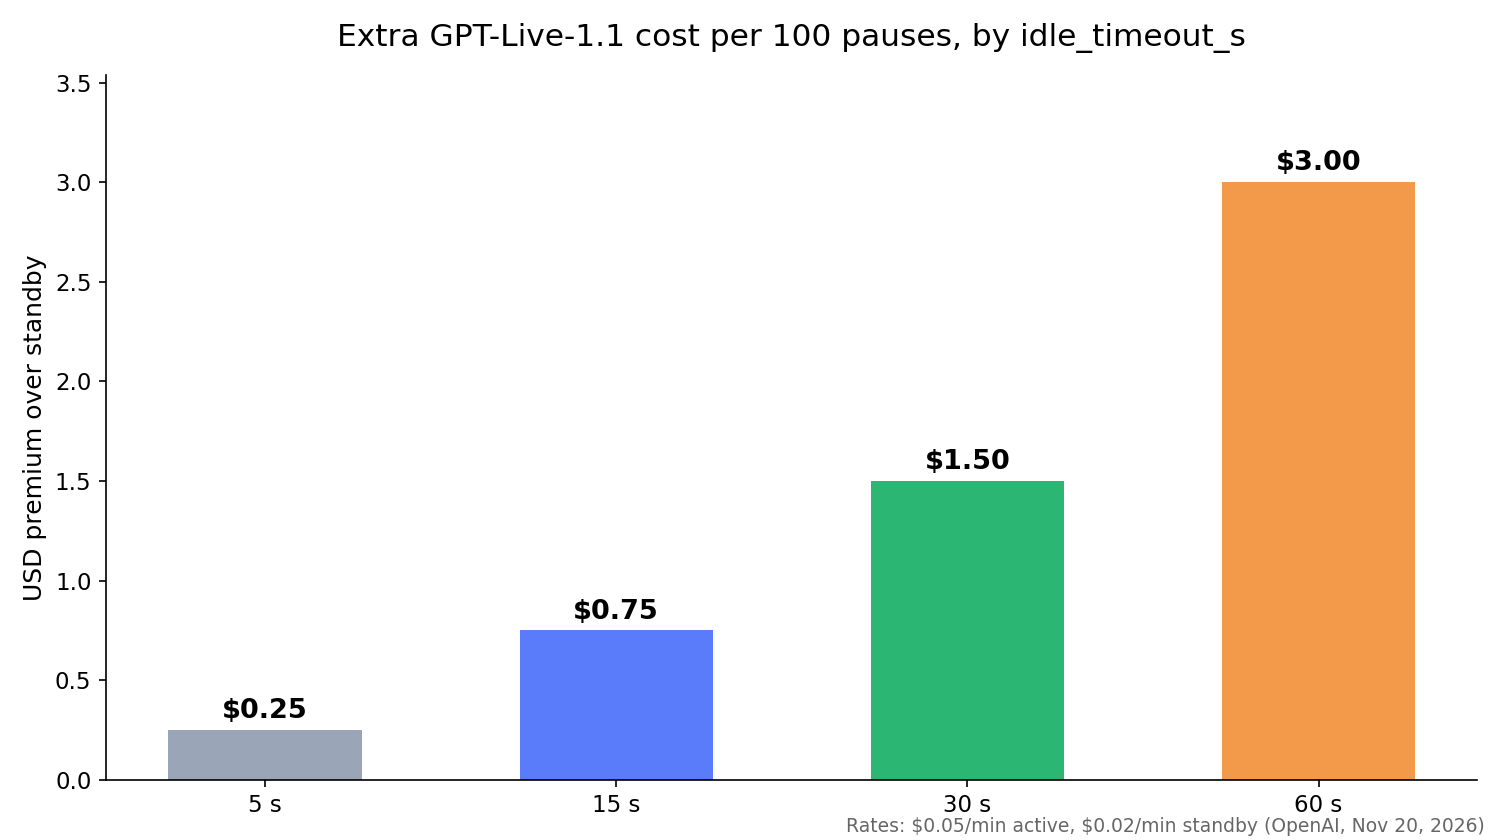
Premi per jeda adalah panjang timeout yang ditagih dengan selisih $0,03 antara kedua tarif. Dalam 100 jeda per sesi atau per hari:
idle_timeout_s |
Detik aktif per jeda | Premi di atas standby, per 100 jeda |
|---|---|---|
| 5 | 5 | $0,25 |
| 15 | 15 | $0,75 |
| 30 | 30 | $1,50 |
| 60 | 60 | $3,00 |
Angkanya kecil, dan itulah intinya: timeout sebagian besar adalah pengaturan pengalaman pengguna. Pilih nilai yang tidak memotong pengguna di tengah pikiran, lalu biarkan standby menangani jeda panjang dan penutupan sesi menangani jeda sangat panjang.
Perbandingan harga GPT-Live-1.1 dengan GPT-Realtime
GPT-Live-1.1 menagih per menit; model GPT-Realtime menagih per token. Halaman harga OpenAI mencantumkan audio gpt-realtime-2.1 seharga $32,00 per 1M token input dan $64,00 per 1M token output, serta audio gpt-realtime-2.1-mini seharga $10,00 dan $20,00.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Unit penagihan | Detik sesi | Token input dan output |
| Tarif suara | $0,05/menit aktif, $0,02/menit standby | $32 / $64 per 1M token audio |
| Reasoning dan tools | Model backend terpisah | Di dalam model yang sama |
| Kurva biaya | Flat per menit | N per giliran seiring konteks bertambah |
Panduan biaya OpenAI mencatat bahwa sesi Realtime mengirimkan seluruh percakapan ke model pada setiap respons, sehingga giliran selanjutnya berbiaya lebih mahal. Satu menit GPT-Live berbiaya sama di menit ke-2 dan menit ke-40, membuat proyeksi biaya menjadi sederhana. Panduan API GPT-Realtime-2 kami membahas pengaturan berbasis token.
Lacak penggunaan dan hindari tagihan yang mengejutkan
GPT-Live melaporkan penggunaan suara kumulatif dalam detik melalui event session.usage.updated:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
Setiap pembaruan menggantikan total sebelumnya, jadi jangan pernah menjumlahkannya. Kirim session.close, tunggu session.closed, dan catat usage.seconds final. Untuk memisahkan aktif dari standby, catat waktu di antara event session.paused dan session.resumed.
Kebiasaan yang menjaga biaya tetap stabil:
- Tutup sesi yang sudah selesai. Sesi terbuka yang ditinggalkan terus ditagih.
- Percepat backend. Menunggu tugas yang didelegasikan adalah waktu aktif; menyelesaikan satu menit lebih cepat menghemat $0,05.
- Tutup sesi selama pekerjaan panjang. Tutup suara selagi backend bekerja dan buka kembali saat hasil siap.
- Rencanakan konkurensi. Batasan menghitung sesi konkuren, dan GPT-Live-1.1 memiliki batas terpisah dari GPT-Live-1, yang batas terpublikasinya adalah 50 (Build), 300 (Launch), dan 500 (Grow). Tier Free tidak didukung.
Uji buku besar biaya Anda dengan Codex dan Apidog CLI
Buku besar penggunaan Anda adalah kode yang Anda miliki, dan bug di sana salah menetapkan harga setiap panggilan. Uji di setiap commit tanpa membuka sesi suara, dengan $0 biaya waktu suara, dan biarkan coding agent Anda menjalankan pengujian dengan Apidog CLI.
Instal CLI, login, dan tambahkan skill Apidog ke agent Anda:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan Codex satu prompt:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
Agent membaca skema, memvalidasi payload-nya, membuat test case, dan menjalankannya:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Ganti -r cli,json dengan -r junit dan run yang sama langsung masuk ke CI; lihat menjalankan Apidog CLI dalam pipeline CI/CD. Panduan Apidog CLI di Codex membahas pengaturan agent. Paket Free Apidog mencakup tim hingga 4 pengguna.
FAQ
Berapa biaya GPT-Live-1.1 per menit? $0,05 per menit aktif dan $0,02 per menit standby, ditagih per detik. Penggunaan backend dikenakan biaya tambahan.
Apakah GPT-Live-1.1 lebih mahal dari GPT-Live-1? Tidak. OpenAI mencantumkan keduanya dengan tarif aktif dan standby yang sama.
Apakah standby berfungsi pada panggilan telepon? Tidak. Tarif standby yang lebih rendah hanya berlaku untuk sesi WebRTC saat inference dijeda. Sesi WebSocket dan SIP menagih waktu terhubung dengan tarif aktif.
Apakah pemanggilan model backend termasuk dalam harga per menit? Tidak. Pemanggilan Responses yang didelegasikan ditagih sesuai tarif token model yang dipilih, ditambah biaya tool.
Apa yang terjadi dengan pertanyaan API GPT-Live bulan Juli? Saat itu GPT-Live adalah fitur suara ChatGPT tanpa API, seperti yang dicatat penjelasan API GPT-Live kami pada masa itu. GPT-Live-1.1 adalah model API-nya, dilayani di v1/live/sessions.