
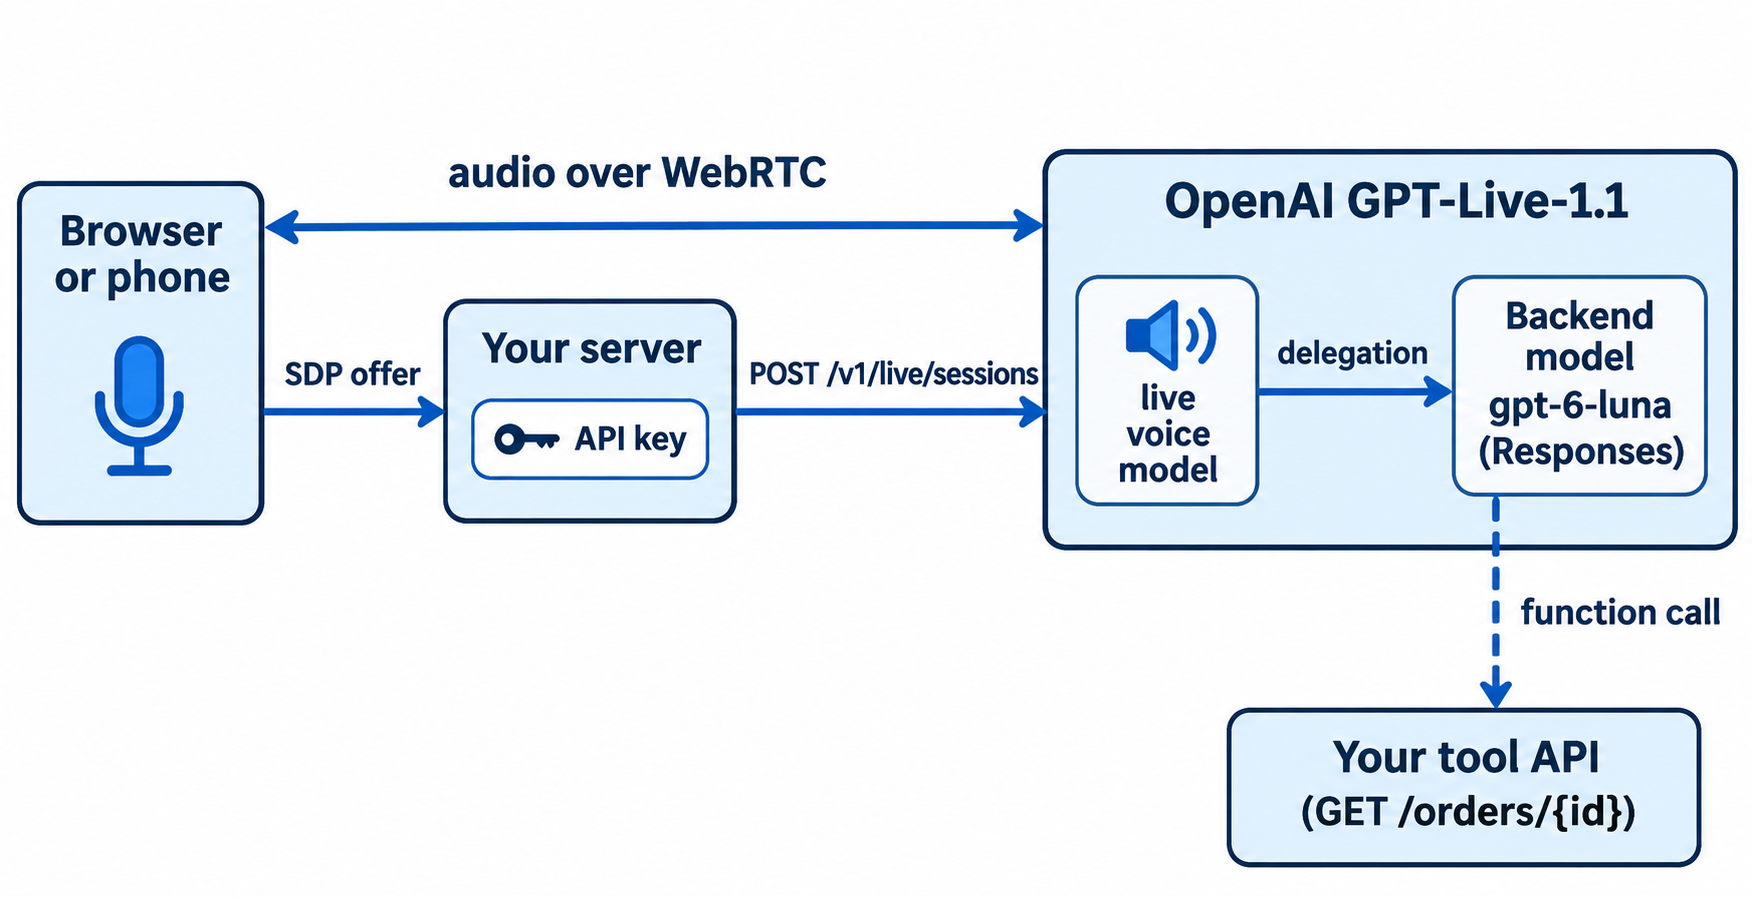
API GPT-Live-1.1 adalah model suara full-duplex milik OpenAI, yang dilayani di v1/live/sessions. Anda membuka sesi melalui WebRTC, WebSocket, atau SIP, mengirimkan konfigurasi session berisi model, instruksi, dan suara, lalu membiarkannya menyerahkan penalaran dan pemanggilan tool ke model Responses di backend melalui delegation. Harganya $0,05 per menit aktif dan $0,02 per menit standby.
OpenAI membuat GPT-Live-1.1 tersedia di API pada 20 November 2026, sesuai pengumuman OpenAI Developers. Jika Anda membaca artikel kami bulan Juli, Apakah ada GPT-Live API? menjawab "belum ada". Kini itu sudah berubah. Panduan ini memandu Anda melalui contoh sesi yang berfungsi, konfigurasi delegation, function tool, serta penyiapan pengujian untuk backend yang dipanggil oleh voice agent Anda.
Apa itu API GPT-Live-1.1?
GPT-Live-1.1 adalah model speech-in, speech-out yang tetap mendengarkan saat berbicara. Model ini berjalan di endpoint v1/live/sessions, bukan v1/realtime atau v1/responses. Tugas utamanya adalah percakapan. Penalaran yang lebih berat dan penggunaan tool dialihkan ke model backend yang Anda konfigurasikan, sehingga suara tetap responsif selama pekerjaan berjalan.
Berikut yang tercantum saat ini di halaman model GPT-Live-1.1:
| Item | GPT-Live-1.1 |
|---|---|
| Model ID | gpt-live-1.1 (satu snapshot) |
| Input / output | Audio dan teks masuk, audio dan teks keluar |
| Endpoint | Hanya v1/live/sessions |
| Transport | WebRTC (direkomendasikan), WebSocket, SIP |
| Harga aktif | $0,05 per menit |
| Harga standby | $0,02 per menit (WebRTC, inferensi dijeda) |
| Model backend dan tools | Ditagih terpisah sesuai tarif normalnya |
| Concurrency | Batas terpisah dari GPT-Live-1, per organisasi |
Untuk latar belakang produknya, lihat apa itu GPT-Live dan bagaimana perbedaannya dengan GPT Realtime.
GPT-Live-1.1 vs GPT-Live-1: apa yang berubah
Halaman model dan panduan prompting mencantumkan empat perbedaan praktis:
- Transkripsi: 1.1 "mentranskripsi ucapan dengan lebih akurat".
- Suara: 1.1 mempertahankan "aksen dan suara yang lebih konsisten di berbagai bahasa".
- Prompt delegation: 1.1 menerima bahasa biasa ("Delegate to the backend when:"). GPT-Live-1 membutuhkan penanda
<|SpawnThinking|>dalam kebijakannya. - Perumusan penagihan: GPT-Live-1 ditagih per detik dan tidak pernah dibulatkan ke menit penuh. Halaman 1.1 hanya menyebutkan "ditagih berdasarkan durasi".
Kedua model berbagi endpoint, harga, dan struktur sesi yang sama, sehingga bermigrasi ke 1.1 sebagian besar hanya mengubah string model ditambah prompt yang lebih rapi.
Cara membuka sesi GPT-Live-1.1
Panduan memulai GPT-Live merekomendasikan WebRTC untuk audio di browser, mobile, dan server. WebSocket adalah jalur yang lebih sederhana untuk prototipe sisi server, jadi mulailah dari sana:
- Buka
wss://api.openai.com/v1/live/sessionsdenganAuthorization: Bearer $OPENAI_API_KEYtanpa parameter query. - Kirim
session.startsebagai pesan pertama, beserta konfigurasisessionAnda. - Tunggu
session.startedsebelum mengirim audio. - Streaming audio dalam format yang Anda pilih. Defaultnya adalah PCM 24 kHz.
import WebSocket from "ws";

const ws = new WebSocket("wss://api.openai.com/v1/live/sessions", {
  headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
});

ws.on("open", () => {
  ws.send(JSON.stringify({
    type: "session.start",
    event_id: "start_1",
    session: {
      model: "gpt-live-1.1",
      instructions: "You are the voice agent for Acme order support. Keep answers short.",
      audio: {
        format: { type: "audio/pcm", rate: 24000 },
        output: { voice: "marin" },
      },
    },
  }));
});

ws.on("message", (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type === "session.started") console.log("Session ready");
});
Beberapa aturan konfigurasi dari panduan percakapan:
instructionsmenerima hingga 16.384 token. Tambahkan lebih banyak di tengah sesi dengansession.instructions.append(500 token per append).audio.output.voicesecara default adalahmarin. Nama API lainnya meliputiquartz,stone,meridian, danwillow.- Format WebSocket adalah
audio/pcmpada 24.000 atau 16.000 Hz, sertaaudio/pcmuatauaudio/pcmapada 8.000 Hz untuk telefoni. storesecara defaultfalse. Mengubahmodelmemerlukan sesi baru.
Untuk produksi di browser, beralihlah ke WebRTC. Server Anda menyimpan API key dan meneruskan SDP offer dari browser:
const res = await fetch("https://api.openai.com/v1/live/sessions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    session: { model: "gpt-live-1.1", instructions: "..." },
    transport: { type: "webrtc", sdp: offerSdp },
  }),
});
const { session, transport } = await res.json(); // HTTP 201
// session.id looks like "live_123"; return transport.sdp to the browser
Jangan sertakan audio.format dalam permintaan WebRTC, dan jangan kirim session.start di data channel. Perhatikan satu detail penagihan: pembuatan sesi WebRTC menagih 15 detik selama inisialisasi, yang dikreditkan kembali begitu sesi berjalan.
Delegation GPT-Live-1.1: biarkan model backend yang berpikir
Delegation adalah alasan API ini dibuat. Model suara tetap berbicara sementara model backend menalar, mencari, atau memanggil tool. Anda memilih salah satu dari dua mode saat pembuatan sesi, dan mode tidak bisa diganti di tengah sesi.
| Mode | delegation.type |
Siapa yang menjalankan backend | Paling cocok untuk |
|---|---|---|---|
| Responses | "responses" |
OpenAI, menggunakan model dan tools yang Anda konfigurasikan | Sebagian besar aplikasi; hosted tools, function calling |
| Client | "client" (juga merupakan default) |
Aplikasi Anda | Agent loop milik Anda sendiri atau backend non-OpenAI |
Panduan delegation menyarankan untuk memulai dengan gpt-6-luna dan mencoba gpt-6-sol untuk tugas backend yang lebih berat. Jika Anda belum memilih, tinjauan GPT-6 Luna kami membahas pertimbangannya.
"delegation": {
  "type": "responses",
  "responses": {
    "model": "gpt-6-luna",
    "instructions": "Look up orders with get_order. Answer in one sentence.",
    "tools": [{ "type": "web_search" }],
    "tool_choice": "auto",
    "parallel_tool_calls": false
  }
}
Blok responses juga menerima max_output_tokens (16 atau lebih), service_tier (auto, default, flex, atau priority, dengan priority sebagai mode cepat) serta pengaturan reasoning dan text yang didukung model backend Anda. Anda bisa mengubah field-field ini di tengah sesi dengan session.update. Validasi bersifat asinkron: konfigurasi yang salah masuk sebagai error dengan kode responses_validation_failed, dan sesi tetap terbuka.
Kemudian beri tahu model suara kapan harus mendelegasikan. Di 1.1, ini cukup dengan bahasa biasa di instructions:
Delegate to the backend when: the caller asks about an order, a refund or anything you must look up.
Do not delegate when: the caller greets you, asks you to repeat, or says goodbye.
While the backend works, briefly say what you are checking.
Panduan prompting memperingatkan bahwa ucapan "Saya sedang memeriksanya" tidak membuktikan pekerjaan backend telah dimulai. Pantau session.delegation.created di log Anda sebagai gantinya.
Menambahkan function calling ke sesi GPT-Live-1.1
Hosted tools seperti web search berjalan di dalam OpenAI. Function milik Anda sendiri berjalan di aplikasi Anda. Letakkan function tool Responses standar di delegation.responses.tools:
{
  "type": "function",
  "name": "get_order",
  "description": "Get the shipping status of an order by its ID.",
  "parameters": {
    "type": "object",
    "properties": { "order_id": { "type": "string" } },
    "required": ["order_id"],
    "additionalProperties": false
  },
  "strict": true
}
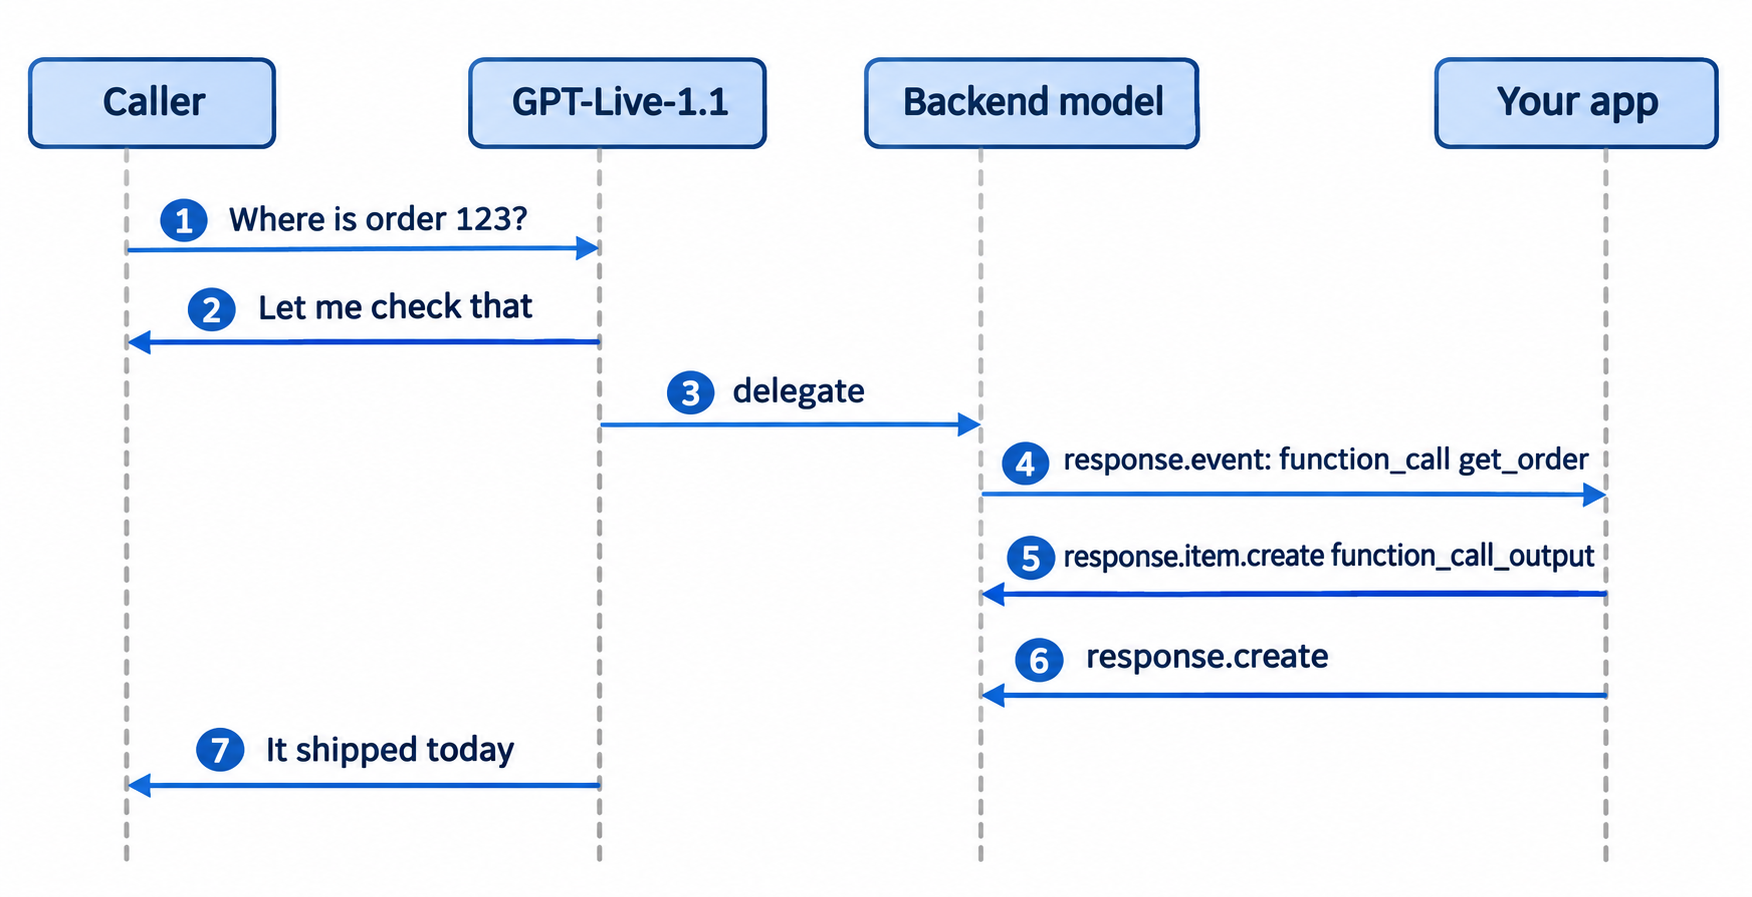
Event dari backend sampai kepada Anda dibungkus dalam amplop response.event yang membawa delegation_id dan event bersarang. Pemanggilan function yang selesai masuk sebagai response.output_item.done bersarang yang itemnya memiliki call_id, name, dan arguments. Jalankan function tersebut, kirim response.item.create dengan hasilnya, lalu kirim response.create:
ws.on("message", async (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type !== "response.event") return;
  const ev = msg.event;
  if (ev.type !== "response.output_item.done" || ev.item?.type !== "function_call") return;

  const { order_id } = JSON.parse(ev.item.arguments);
  const order = await fetch(`${ORDERS_API}/orders/${order_id}`).then((r) => r.json());

  ws.send(JSON.stringify({
    type: "response.item.create",
    item: { type: "function_call_output", call_id: ev.item.call_id, output: JSON.stringify(order) },
  }));
  ws.send(JSON.stringify({ type: "response.create" }));
});
Tiga detail yang sering membuat orang keliru:
- Menambahkan output saja tidak melanjutkan backend. Anda membutuhkan
response.create. - Melewatkan hasil yang tertunda akan menghasilkan
function_call_outputs_required. Nilaicall_idyang duplikat atau tidak cocok akan ditolak. - Event
response.completedyang diteruskan membawaresponse.outputyang kosong. Baca event output-item satu per satu.
Harga dan batasan GPT-Live-1.1
Biaya waktu suara mudah dihitung. Panggilan dukungan 5 menit yang aktif selama seluruh sesi berbiaya 5 × $0,05 = $0,25 untuk waktu suara. Seribu panggilan seperti itu berbiaya $250, ditambah apa pun yang ditagihkan model backend dan tools sesuai tarif normalnya.
| Baris biaya | Tarif |
|---|---|
| Suara aktif | $0,05 per menit |
| Suara standby (WebRTC, inferensi dijeda) | $0,02 per menit |
| Inisialisasi WebRTC | 15 detik, dikreditkan begitu sesi berjalan |
| Model backend dan tools | Harga normal untuk model dan tool tersebut |
Rate limit dihitung berdasarkan sesi konkuren, bukan token. GPT-Live-1.1 dan GPT-Live-1 memiliki batas terpisah yang berlaku di seluruh wilayah inferensi. Halaman GPT-Live-1 mencantumkan 50, 300, dan 500 sesi konkuren untuk tier Build, Launch, dan Grow, tanpa akses tier Free. Halaman 1.1 tidak mencantumkan angka, jadi periksa halaman batas organisasi Anda sebelum peluncuran.
Minta coding agent Anda menguji backend tool dengan Apidog CLI
Voice agent Anda hanya seandal API yang ada di balik get_order. Respons yang lambat atau rusak formatnya berubah menjadi keheningan atau jawaban salah yang diucapkan dengan lantang. Jadi, uji backend itu sebelum ada penelepon yang mendengarnya, dan biarkan coding agent Anda melakukannya dengan Apidog CLI.
Lakukan penyiapan sekali saja:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Lalu berikan satu prompt kepada Claude Code, Codex, atau Cursor:
Import ./orders-openapi.yaml into Apidog project <projectId>. Create test cases for
GET /orders/{order_id}: a known ID returns 200 with a status field in under 800 ms,
and an unknown ID returns 404 with a JSON error. Run them against the staging
environment and tell me what failed.
Agent membaca skema, memvalidasi payload-nya, membuat test case, dan menjalankannya:
apidog import --project <projectId> --format openapi --file ./orders-openapi.yaml
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Anggaran 800 ms penting untuk suara: penelepon mendengar setiap milidetik yang dihabiskan tool Anda. Letakkan apidog run yang sama dengan -r junit di CI agar regresi menggagalkan build, seperti ditunjukkan dalam panduan CI/CD Apidog CLI kami. Baru mengenal workflow agent? Mulailah dengan Apidog CLI di Claude Code. Paket Free Apidog mencakup hingga 4 pengguna.
FAQ
Apakah GPT-Live-1.1 tersedia di API? Ya. Sejak 20 November 2026, Anda dapat memanggil gpt-live-1.1 di v1/live/sessions melalui WebRTC, WebSocket, atau SIP. Model ini tidak dilayani di v1/realtime, v1/responses, atau Chat Completions.
Berapa biaya API GPT-Live-1.1? $0,05 per menit aktif dan $0,02 per menit standby. Pemanggilan model backend dan tools ditagih terpisah sesuai tarif masing-masing.
Apa perbedaan antara GPT-Live-1.1 dan GPT Realtime? GPT-Live berjalan di endpoint sendiri, menagih berdasarkan durasi suara, dan menyerahkan penalaran ke model backend melalui delegation. GPT Realtime berjalan di v1/realtime. Lihat perbandingan GPT-Live vs GPT Realtime kami.
Model backend apa yang sebaiknya saya gunakan untuk delegation? Panduan OpenAI menyarankan gpt-6-luna untuk memulai dan gpt-6-sol untuk tugas backend yang lebih kompleks. Atur service_tier ke priority jika latensi lebih penting daripada biaya.
Bisakah saya menggunakan agent sendiri alih-alih model Responses? Ya. Atur delegation.type ke client. Aplikasi Anda menjalankan pekerjaan backend dan mengirimkan hasil kembali dengan session.commentary.append. Anda juga mengelola transkrip sendiri.
Apakah GPT-Live-1.1 mendukung function calling? Ya, melalui delegation Responses. Definisikan function di delegation.responses.tools, baca pemanggilan dari response.event, dan kembalikan hasil dengan response.item.create ditambah response.create.