
OpenAI meluncurkan ChatGPT Images 2.5 pada 8 September 2026, dengan dua model API: gpt-image-2.5-flare dan gpt-image-2.5-sunburst. Keduanya ditagih dengan tarif per-token yang sama dengan gpt-image-2, dan keduanya berbagi satu entri di kalkulator harga OpenAI. Jadi, tabel per-token tidak akan membantu Anda memilih. Yang berubah adalah tingkatan kualitas di bawahnya, dan pelabelan ulang menggeser harga gambar dengan quality: "high" sekitar 4 kali lipat.
Ini adalah halaman keputusan: tarif per-token, estimasi per-gambar untuk kelima tingkat kualitas 2.5 di samping angka gpt-image-2, pemetaan ulang label, anggaran bulanan 10.000 gambar, rumor "harga 2x", dan daftar periksa migrasi. Jika Anda ingin sintaks permintaan terlebih dahulu, baca cara menggunakan API gpt-image-2.5. Halaman harga OpenAI adalah sumber untuk setiap tarif di bawah ini. Setiap angka per-gambar adalah estimasi kalkulator, karena OpenAI memperingatkan bahwa konsumsi token "dapat berbeda berdasarkan model dan pengaturan kualitas"; tagihan Anda berasal dari usage.output_tokens dalam respons.
Tarif per-token: identik di ketiga model
Halaman harga OpenAI mencantumkan tarif tingkat Standar yang sama untuk kedua model 2.5, dan setiap halaman model menyatakan bahwa "Tarif tokennya cocok dengan GPT Image 2". Berikut adalah tabel lengkapnya, termasuk baris Batch yang menyebabkan kebingungan saat peluncuran.
| Model | Input gambar | Input gambar di-cache | Output gambar | Input teks | Input teks di-cache |
|---|---|---|---|---|---|
gpt-image-2.5-sunburst |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2.5-flare |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Standar) |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Batch, diskon 50%) |
$4.00 | $1.00 | $15.00 | $2.50 | $0.625 |
Semua angka adalah per 1 juta token. Output hanya berupa gambar di setiap model di sini, jadi output teks tidak pernah muncul di tagihan.
Mengenai klaim "harga 2x" dalam beberapa liputan awal: itu berasal dari perbandingan baris Standar 2.5 dengan baris Batch gpt-image-2, yang merupakan diskon 50%. Sejajarkan Standar dengan Standar di halaman harga dan setiap tarif tidak berubah.
Biaya setiap gambar pada setiap tingkat kualitas
Kesetaraan per-token adalah batas kemiripan. Kalkulator OpenAI (dibaca 2026-09-09) melaporkan jumlah token output gambar ini di bawah satu entri bersama, "GPT Image 2.5 (Sunburst dan Flare)". Biaya adalah token dikalikan $30 per 1 juta, hanya token output.
| Kualitas | Token 1024x1024 | Biaya 1024x1024 | Token 1536x1024 | Biaya 1536x1024 |
|---|---|---|---|---|
| low | 196 | $0.00588 | 158 | $0.00474 |
| medium | 439 | $0.01317 | 343 | $0.01029 |
| high | 1,756 | $0.05268 | 1,372 | $0.04116 |
| xhigh | 3,122 | $0.09366 | 2,459 | $0.07377 |
| max | 7,024 | $0.21072 | 5,488 | $0.16464 |
Berikut adalah tabel gpt-image-2 dari halaman dokumen yang sama, untuk ukuran yang sama.
| Kualitas | 1024x1024 | 1536x1024 (dan 1024x1536) |
|---|---|---|
| low | $0.006 | $0.005 |
| medium | $0.053 | $0.041 |
| high | $0.211 | $0.165 |
Ada dua hal yang menonjol. Ukuran lanskap lebih murah daripada ukuran persegi di setiap baris, sebuah pola yang disebutkan dalam dokumen OpenAI. Dan baris 2.5 high tidak mendekati baris high gpt-image-2. Itulah pelabelan ulang.
Teks prompt dan gambar referensi ditagih secara terpisah. Sebuah gambar referensi yang dikirim ke images/edits menghabiskan token input gambar seharga $8 per 1 juta; OpenAI tidak memublikasikan jumlah token input per gambar, jadi bacalah dari usage.input_tokens.
Tingkatan kualitas telah dilabel ulang
Cocokkan anggaran token dan pemetaannya menjadi jelas. Pada 2.5, high adalah 1.756 token output, anggaran yang dihabiskan gpt-image-2 pada medium. Pada 2.5, max adalah 7.024 token, anggaran yang dihabiskan gpt-image-2 pada high. low tidak berubah pada 196 token.
| Label 2.5 | Token (1024x1024) | Biaya 2.5 | Anggaran yang sama pada gpt-image-2 | Biaya gpt-image-2 |
|---|---|---|---|---|
| low | 196 | $0.00588 | low | $0.006 |
| medium | 439 | $0.01317 | tidak ada (di bawah medium lama) | n/a |
| high | 1,756 | $0.05268 | medium | $0.053 |
| xhigh | 3,122 | $0.09366 | tidak ada (antara medium lama dan high lama) | n/a |
| max | 7,024 | $0.21072 | high | $0.211 |
Jadi, migrasi yang mempertahankan quality: "high" menjadi sekitar 4 kali lebih murah per gambar dan dirender pada anggaran medium yang lama. Yang menginginkan anggaran high yang lama harus beralih ke max, dengan harga yang secara efektif sama dengan harga lama. xhigh adalah tingkatan menengah baru tanpa padanan gpt-image-2.
Perhitungan bulanan, yang berasal dari estimasi kalkulator OpenAI pada 1024x1024:
- 10.000 gambar pada 2.5
high: 10.000 x $0.05268 = $526.80 - 10.000 gambar pada gpt-image-2
high: 10.000 x $0.211 = $2,110 - 10.000 gambar pada 2.5
max: 10.000 x $0.21072 = $2,107.20, secara efektif sama dengan `high` lama - Streaming dengan
partial_images: 3menambahkan 300 token, atau $0.009 per gambar, karena setiap parsial menghabiskan 100 token output gambar
Flare vs Sunburst: apa yang didapat dari premium
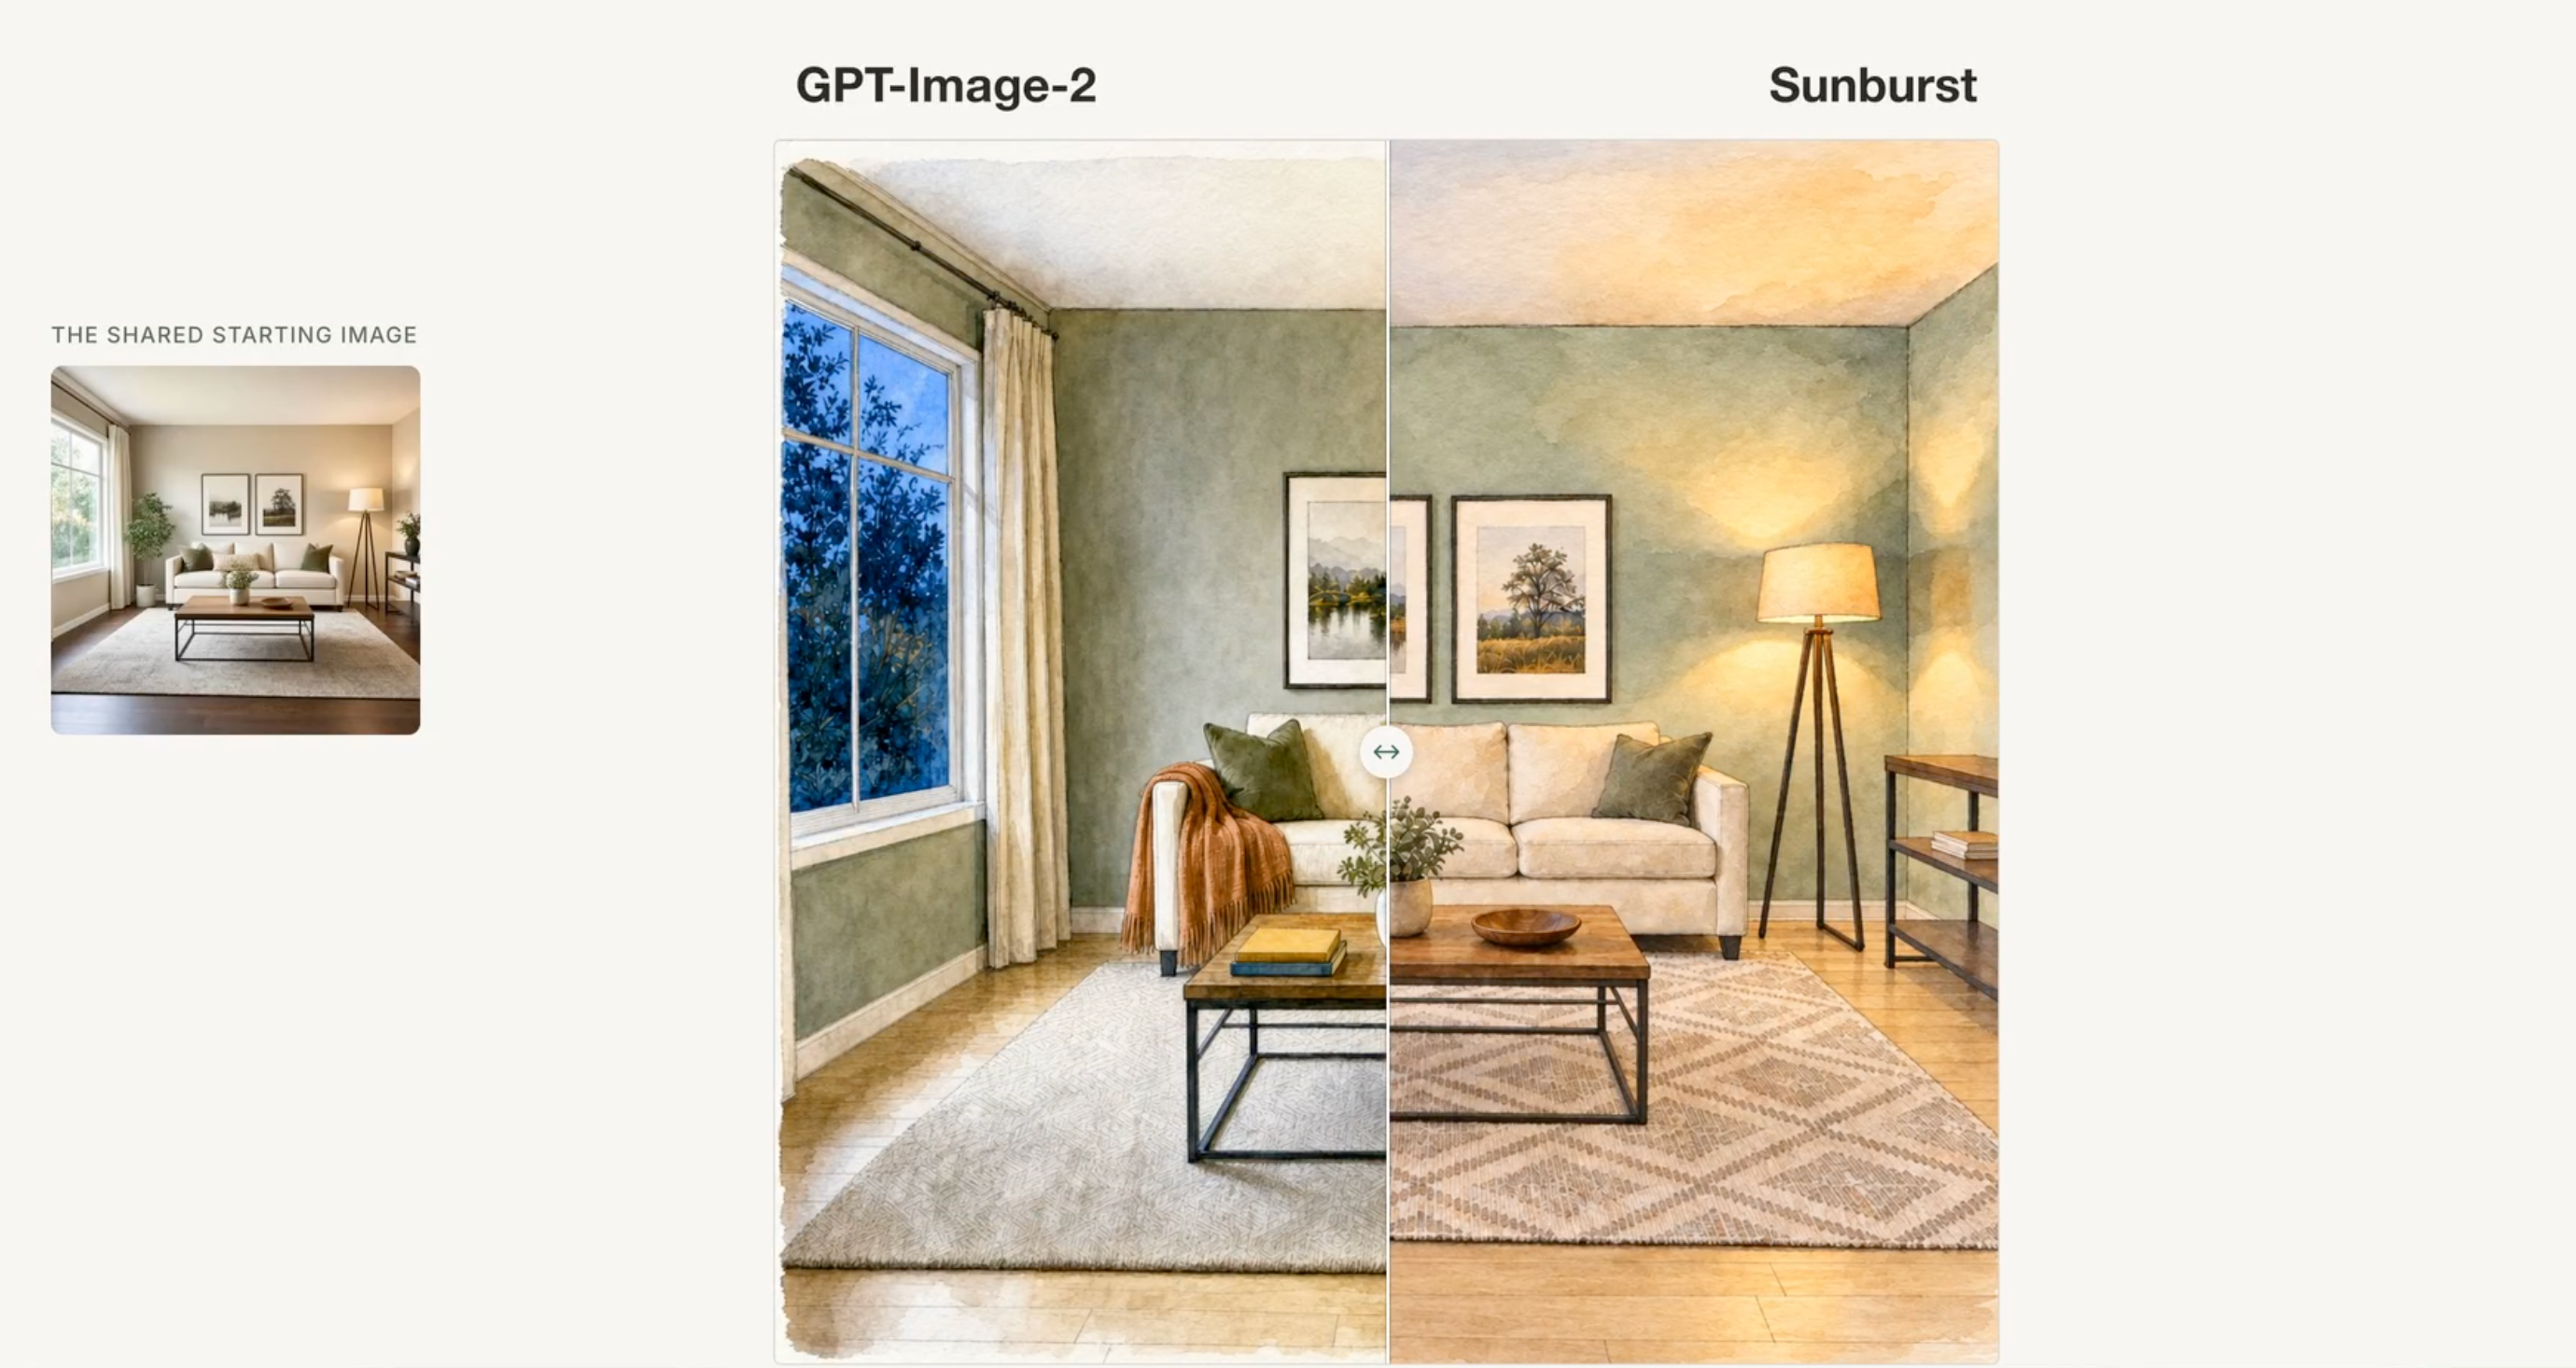
Kedua model berbagi entri kalkulator, sehingga jumlah token yang didokumentasikan identik. Sunburst tidak memakan biaya lebih per gambar; premiumnya adalah waktu. Posting peluncuran OpenAI menargetkan Flare untuk "generasi volume tinggi" dan Sunburst untuk "alur kerja visual premium yang mendapat manfaat dari kontrol yang lebih ketat dalam pengeditan". Dokumen tersebut meringkasnya menjadi satu baris: "Pilih Sunburst untuk alur kerja di mana presisi pengeditan paling penting, dan Flare untuk pembuatan gambar sehari-hari yang cepat dan berkualitas tinggi."
Sinyal komunitas, dilabeli demikian:
- Dalam utas HN, pengguna jjcm, yang melaporkan sekitar 50.000 gambar melalui gpt-image-2 untuk alat desain UI AI, mengatakan latensi rata-rata "bertahan di sekitar 104 detik" pada gpt-image-2 dan gambar 2.5 "masuk sekitar 35-40 detik". Satu titik data, satu beban kerja; klaim OpenAI sendiri adalah latensi "hingga 50%" lebih rendah.
- Papan peringkat text-to-image Arena (suara komunitas, diperbarui 7 September 2026) menempatkan Sunburst pertama pada 1421, Flare kedua pada 1399, gpt-image-2 pada medium ketiga pada 1381, kemudian mai-image-2.6 milik Microsoft pada 1331; Nano Banana 2 berada pada 1261. Pada papan peringkat pengeditan gambar, celahnya melebar: Sunburst 1520, Flare 1491, gpt-image-2 1461. Ini adalah skor preferensi publik, bukan tolok ukur OpenAI.
Aturan keputusannya: gunakan Flare secara default. Beralih ke Sunburst untuk alur kerja pengeditan multi-putaran di mana subjek referensi harus bertahan melalui beberapa putaran instruksi. Kesenjangan Arena adalah 22 poin pada text-to-image dan 29 pada pengeditan, yang mendukung kerangka OpenAI bahwa pengeditan adalah di mana Sunburst layak ditunggu. Jika celah tersebut tidak muncul pada prompt Anda sendiri, Anda membayar latensi tanpa hasil.
Kapan gpt-image-2 masih masuk akal
- Diskon Batch. Tab Batch di halaman harga hanya mencantumkan
gpt-image-2, seharga $15 per 1 juta token output; apakah/v1/batchmenerima ID 2.5 belum didokumentasikan saat penulisan. Jika beban kerja Anda mentolerir waktu pemrosesan Batch API, gpt-image-2 pada Batchmedium(setengah dari $0.053) mengungguli 2.5highpada tarif Standar untuk anggaran token yang sama. - Snapshot yang dipin.
gpt-image-2-2026-04-21telah diluncurkan sejak April tanpa pemberitahuan penghentian per 2026-09-09. Jika pipeline Anda bergantung pada output yang telah ditinjau secara visual oleh seseorang, snapshot yang tidak berubah adalah sebuah fitur; panduan API gpt-image-2 kami mencakup parameternya. Untuk perbandingan antar-vendor, bandingkan harga API Nano Banana 2 dan API FLUX.2 pada ukuran output yang sama; 2.5highdengan sekitar lima sen per gambar persegi adalah angka yang harus dikalahkan.
Daftar periksa migrasi dari gpt-image-2 ke 2.5
- Tukar ID model.
gpt-image-2menjadigpt-image-2.5-flare(atau-sunburst); pingpt-image-2.5-flare-2026-09-08untuk output yang stabil. - Petakan ulang label kualitas.
mediumlama menjadihighbaru,highlama menjadimaxbaru,lowtetaplow. Lakukan di konfigurasi, bukan per lokasi panggilan. - Pertimbangkan
xhighdanmax. Keduanya baru di 2.5;xhighdengan 3.122 token berada di antara anggaran medium lama dan high lama. - Hilangkan asumsi
thinking. Dokumen 2.5 tidak menjelaskan parameterthinking; hapus dari templat daripada mengasumsikan itu diterima atau diabaikan. - Ukur ulang
usage. Catatusage.output_tokensdanusage.input_tokensselama seminggu dengan prompt sungguhan; angka kalkulator adalah estimasi. - Periksa kelayakan Batch. Jika Anda mengandalkan diskon Batch 50%, konfirmasikan
/v1/batchmenerima ID 2.5 sebelum Anda beralih.
Bandingkan ketiga model di Apidog dengan satu permintaan tersimpan
Apidog adalah klien API dan platform pengujian. Ini mengirimkan permintaan images/generations dan menegaskan respons; tidak menghasilkan gambar atau menjalankan model. Itu menjadikannya tempat untuk membandingkan Flare vs Sunburst vs gpt-image-2 dengan prompt Anda sendiri.
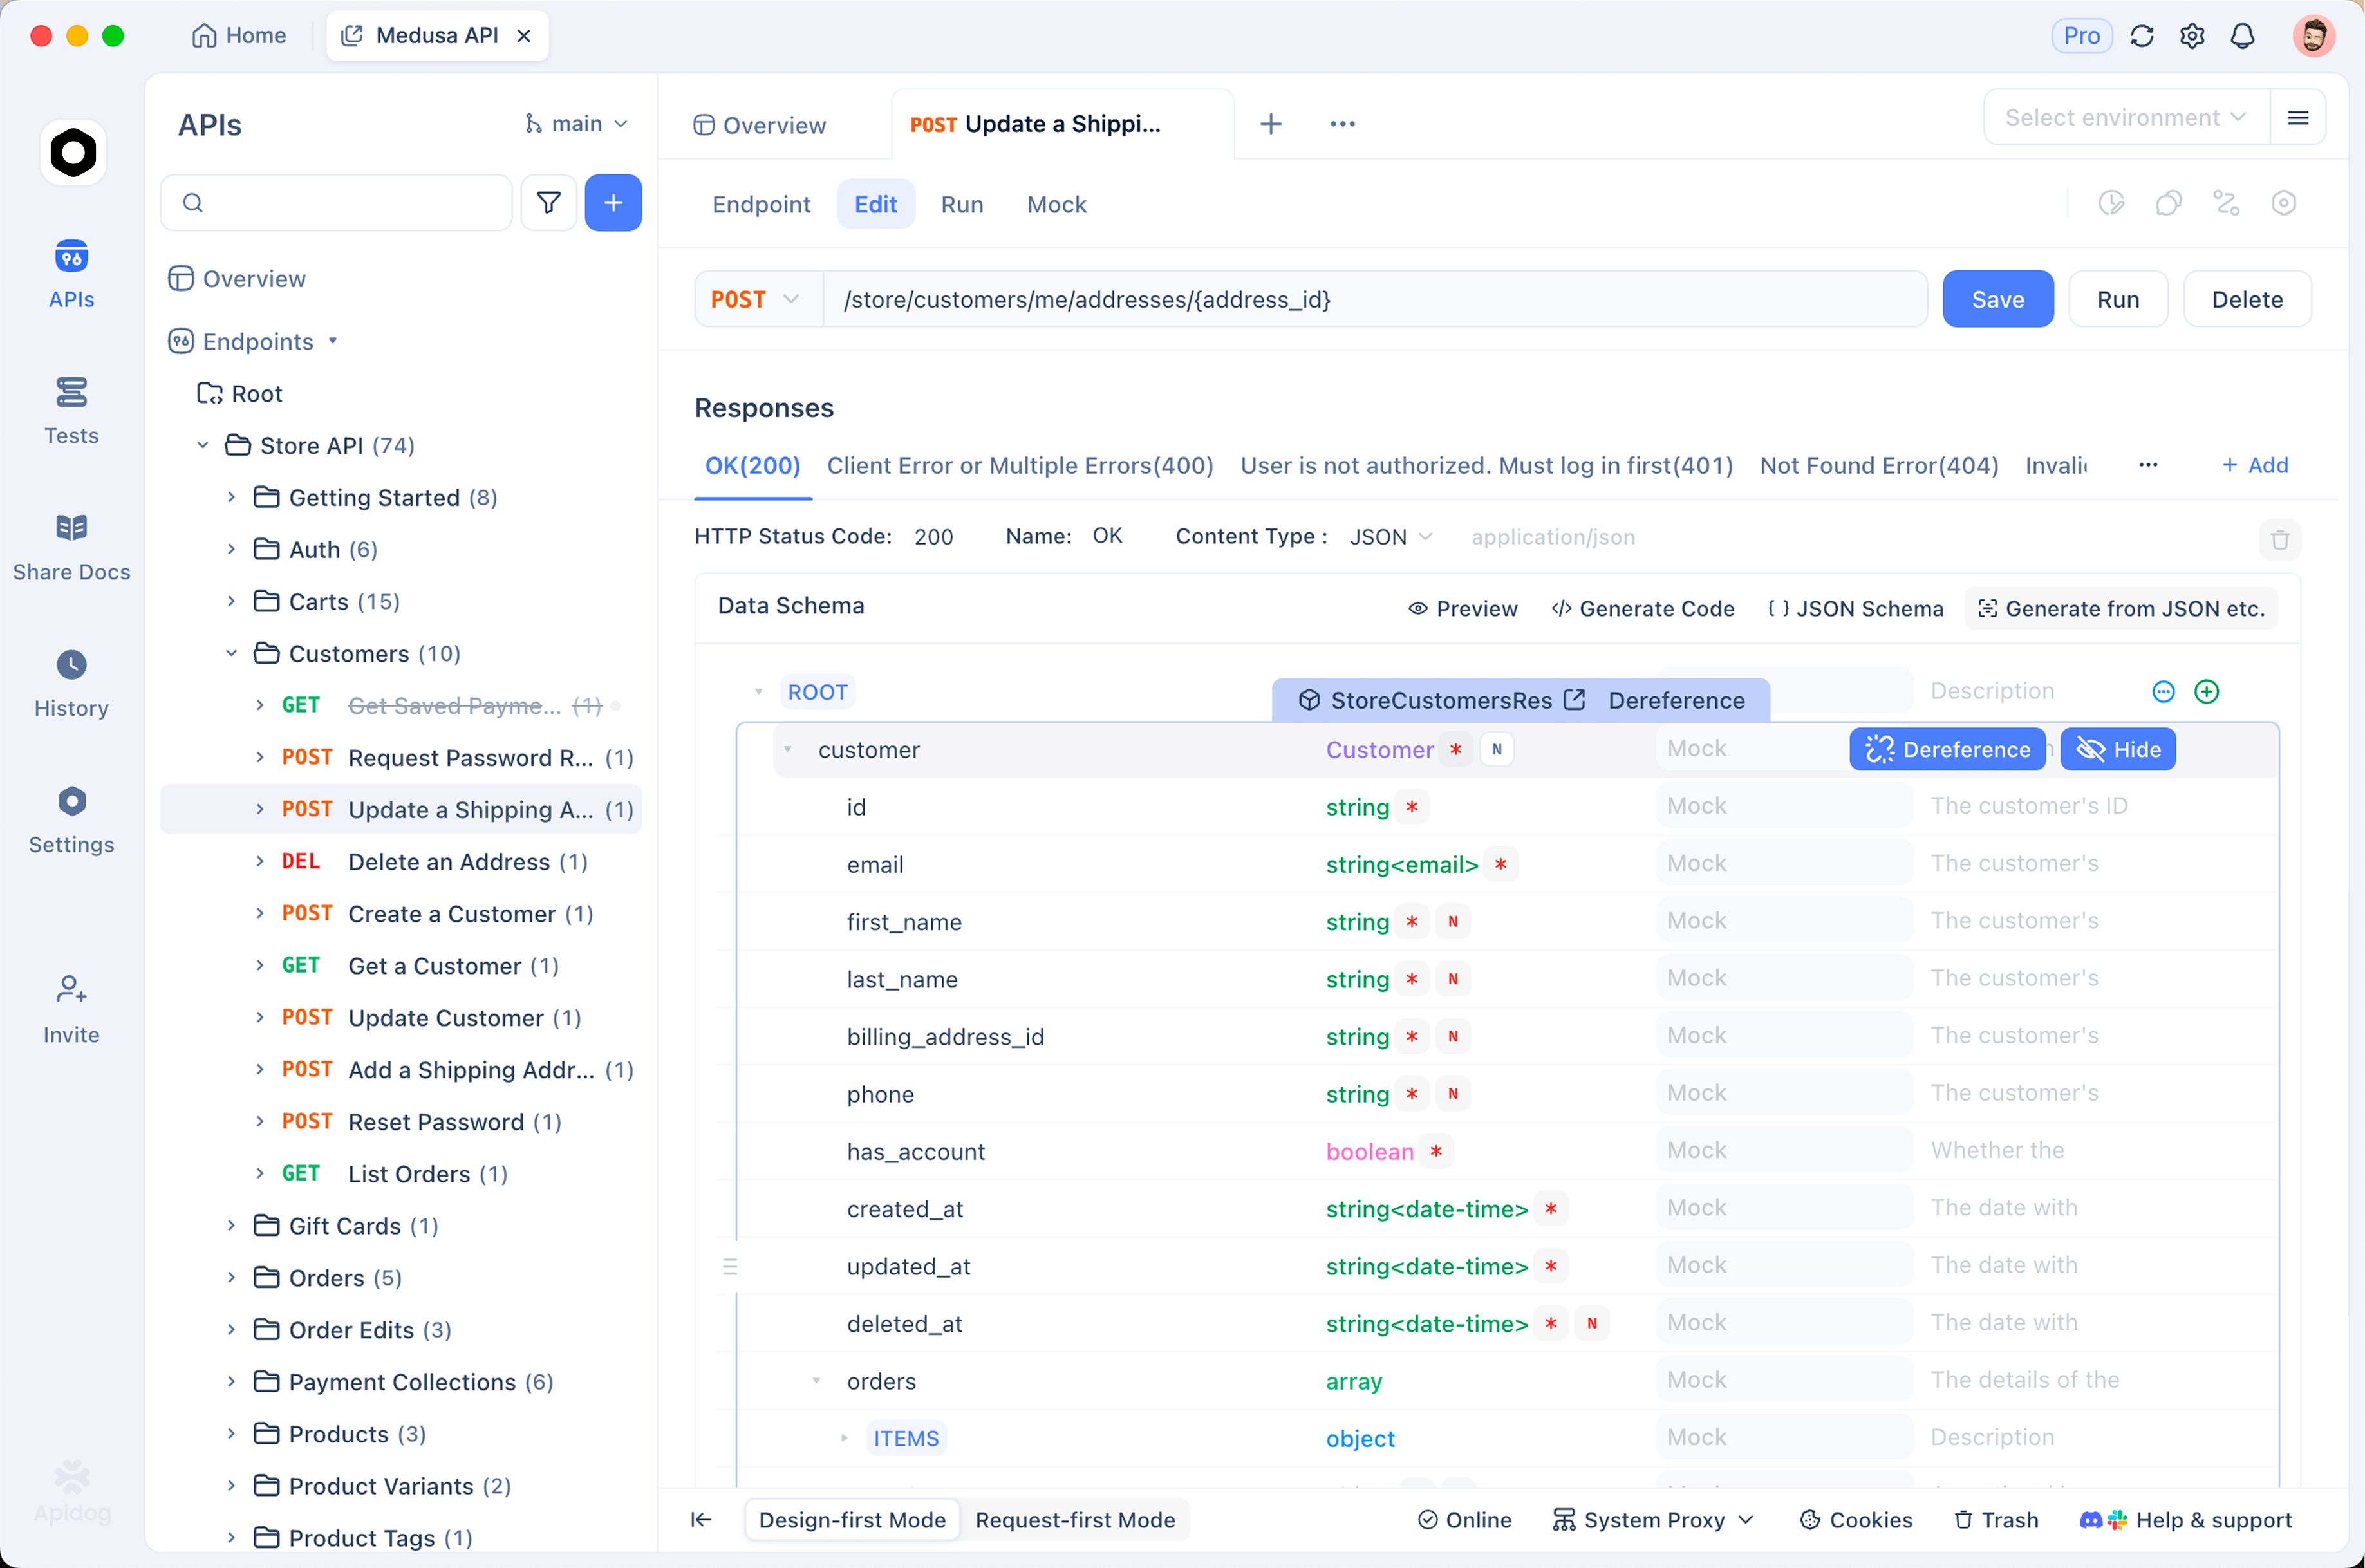
Buat satu permintaan ke POST https://api.openai.com/v1/images/generations dengan model sebagai variabel, lalu buat tiga lingkungan bernama flare, sunburst, dan gpt-image-2. Masing-masing mengatur {{model}} dan menyimpan OPENAI_API_KEY sebagai variabel lingkungan, sehingga kunci tidak pernah masuk ke dalam body permintaan.
{
  "model": "{{model}}",
  "prompt": "Product photo of a matte black ceramic mug on a walnut desk, soft window light",
  "size": "1024x1024",
  "quality": "high",
  "output_format": "jpeg",
  "output_compression": 80
}
Tambahkan skrip pasca-pemrosesan yang merekam angka dan menggagalkan eksekusi jika anggaran token terlampaui:
const body = pd.response.json();
const tokens = body.usage.output_tokens;
pd.environment.set("last_output_tokens", tokens);
pd.environment.set("last_wall_clock_ms", pd.response.responseTime);
pd.test("output tokens within budget", () => {
  pd.expect(tokens).to.be.below(2000);
});
Jalankan permintaan di setiap lingkungan. Waktu respons Apidog adalah angka waktu jam dinding Anda, last_output_tokens adalah jumlah terukur yang akan dibandingkan dengan 1.756 kalkulator, dan celah antara eksekusi flare dan sunburst adalah premium Sunburst untuk prompt Anda. Pergantian lingkungan yang sama berfungsi untuk panggilan multipart images/edits; pastikan usage.input_tokens di sana untuk mengetahui berapa biaya foto referensi. Unduh Apidog untuk menjalankan perbandingan sebelum Anda mengubah kode produksi.
FAQ
Apakah gpt-image-2.5 lebih mahal daripada gpt-image-2? Per token, tidak. Kedua model 2.5 dan gpt-image-2 Standar ditagih $30 per 1 juta token output gambar, $8 per 1 juta input gambar, dan $5 per 1 juta input teks. Per gambar, permintaan 2.5 high berharga sekitar $0.053 pada 1024x1024, dibandingkan dengan $0.211 untuk gpt-image-2 high.
Apakah Sunburst lebih mahal daripada Flare? Tidak. Kedua model berbagi satu entri kalkulator, sehingga jumlah token yang didokumentasikan identik pada setiap tingkat kualitas dan ukuran. Premium Sunburst adalah waktu generasi yang lebih lama, yang oleh OpenAI disebut sebagai "tingkat presisi ekstra" untuk pekerjaan yang banyak pengeditan.
Pengaturan kualitas mana yang menggantikan high gpt-image-2 lama saya? max. Ini menggunakan 7.024 token pada 1024x1024, anggaran yang sama dengan high gpt-image-2, dan berharga $0.21072 menurut kalkulator. Biarkan high di tempat dan Anda akan mendapatkan anggaran medium lama dengan sekitar seperempat harga. Postingan utama tentang ChatGPT Images 2.5 mencakup perubahan lainnya.
Adakah cara gratis untuk mencoba Images 2.5 sebelum membayar API? Ya. Model ini tersedia di setiap tingkatan ChatGPT dengan batasan generasi per paket, yang dibahas dalam cara menggunakan ChatGPT Images 2.5 secara gratis. API tidak memiliki tingkat gratis untuk endpoint gambar; kualitas low sekitar $0.006 per gambar persegi adalah jalur riil termurah.
Model mana yang harus dipilih
Flare untuk apa pun yang bervolume tinggi atau sensitif terhadap latensi, pada high untuk sebagian besar pekerjaan dan max ketika tampilan high gpt-image-2 lama adalah persyaratan. Sunburst untuk pengeditan multi-putaran di mana subjek referensi harus bertahan, setelah perbandingan berdampingan pada prompt Anda; gpt-image-2 untuk pekerjaan Batch dan pipeline yang dipin yang belum siap Anda tinjau ulang. Apa pun yang Anda pilih, baca usage.output_tokens dari respons sungguhan; tiga lingkungan di Apidog dan satu permintaan tersimpan akan memberi Anda angka tersebut dalam satu sore.