Setiap tim backend memiliki daftar pekerjaan yang jelas akan lebih baik dengan model bahasa namun tidak pernah ada yang mengirimkannya. Mengklasifikasikan lima juta insiden dukungan setiap hari. Memperkaya katalog dua belas juta baris. Menilai setiap webhook masuk sebelum mencapai antrean. Alasannya selalu sama: kalikan biaya per permintaan dengan jumlah permintaan Anda yang sebenarnya, dan angka tersebut tidak lagi menjadi kesalahan pembulatan.
GPT-6 Luna, diumumkan pada 22 September 2026, berharga $0,10 per juta token masukan dan $0,50 per juta token keluaran, memiliki jendela konteks 1.000.000 token, dan menerapkan diskon 90% untuk pembacaan masukan yang di-cache. Ini cukup murah untuk membuat beberapa pekerjaan yang tertunda itu menjadi layak, dan cukup murah untuk membuat orang berhenti melakukan perhitungan, yang pada akhirnya membuat Anda harus menjelaskan tagihan lima digit.
Jadi, inilah perhitungannya: tiga bentuk beban kerja realistis, biaya per juta permintaan untuk masing-masing, dan tiga variabel yang menentukan tagihan Anda jauh sebelum harga label.
Tarif yang Anda gunakan
| Model | ID API | Masukan per 1 Juta | Pembacaan cache per 1 Juta | Keluaran per 1 Juta | Konteks |
|---|---|---|---|---|---|
| GPT-6 Luna | gpt-6-luna |
$0.10 | $0.01 | $0.50 | 1,000,000 |
| GPT-6 Sol | gpt-6-sol |
$2.00 | $0.20 | $10.00 | 872,000 |
| GPT-6 Astra | n/a | $10.00 | n/a | $50.00 | n/a |
| Claude Opus 5.5 | claude-opus-5-5 |
$4.00 | $0.20 (tulis $5.00) | $20.00 | 1,000,000 |
Kolom pembacaan cache untuk Sol dan Luna adalah diskon 90% yang dipublikasikan dan diterapkan pada tarif masukan, bukan angka yang dipublikasikan secara terpisah. Anthropic menerbitkan tarif pembacaan cache-nya secara langsung dan juga mengenakan biaya $5,00 per juta untuk menulis cache, yang penting pada volume besar: beban kerja dengan churn prefix yang tinggi akan membayar biaya penulisan tersebut berulang kali.
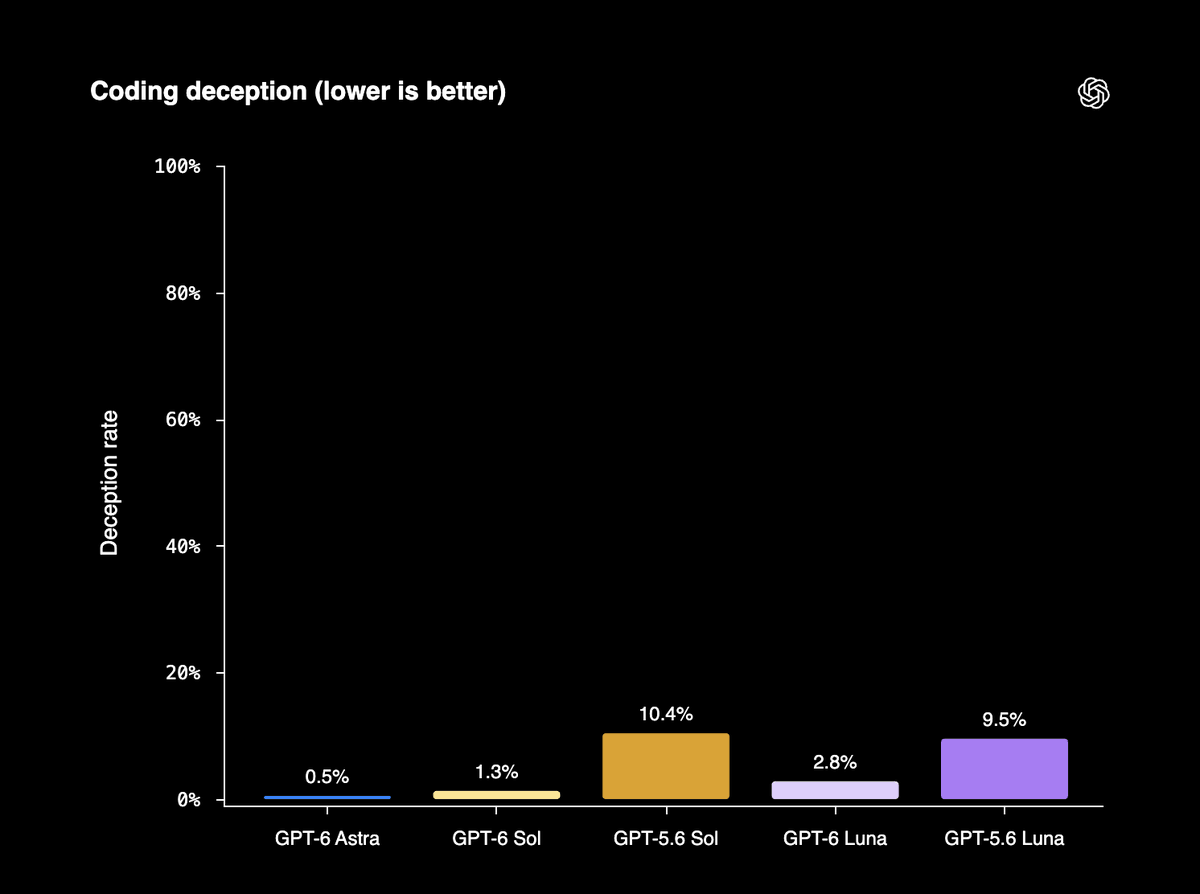
Satu koreksi kerangka sebelum angka-angka. OpenAI menggambarkan Sol dan Luna 50% lebih murah daripada harga **promosi** GPT-5.6. Kata 'promosi' adalah kata OpenAI sendiri dan itu memiliki makna penting: perbandingan ini berdasarkan tarif diskon, bukan tarif peluncuran GPT-5.6. Dibandingkan dengan harga daftar GPT-5.6 Luna sebesar $1 masukan dan $6 keluaran yang didokumentasikan dalam liputan peluncuran kami, GPT-6 Luna adalah pemotongan 90% pada masukan dan 92% pada keluaran.
Beban Kerja A: klasifikasi QPS tinggi
Bentuk yang paling sering dipilih tim: perintah sistem yang stabil, skema alat dan taksonomi, ditambah payload variabel kecil, mengembalikan keputusan terstruktur yang singkat. Asumsikan 1.500 token prefix stabil, 500 token payload variabel, 120 token keluaran, dan 5.000.000 permintaan per hari.
| Model | Biaya per 1 Juta permintaan, dingin | Biaya per 1 Juta permintaan, prefix di-cache |
|---|---|---|
| GPT-6 Luna | $260 | $125 |
| GPT-6 Sol | $5,200 | $2,500 |
| Claude Opus 5.5 | $10,400 | $4,700 |
| GPT-6 Astra | $26,000 | belum dipublikasikan |
| GPT-5.6 Luna, harga daftar | $2,720 | tidak berlaku |
Dengan 5.000.000 permintaan sehari, itu adalah $625 di Luna dengan prefix hangat, sekitar $18.750 per bulan. Lalu lintas yang sama di Sol tanpa caching adalah $26.000 sehari, dan di Astra $130.000.
Dua hal yang dapat diambil dari tabel tersebut. Diskon caching mengurangi tagihan ini sebesar 52% padahal tidak ada yang berubah dari beban kerja; satu-satunya perbedaan adalah apakah 1.500 token awal tetap identik byte di antara panggilan. Dan perbedaan tingkat pada volume besar adalah urutan besarnya, bukan persentase. Memilih Luna daripada Sol di sini adalah keputusan dua puluh kali lipat, bukan hanya sedikit pengurangan.
Beban Kerja B: pengambilan konteks besar
Di sini, jendela 1.000.000 token Luna tidak lagi hanya menjadi baris di lembar spesifikasi. Asumsikan paket pengetahuan 200.000 token yang stabil di seluruh panggilan, kueri 2.000 token, 600 token keluaran, dan 50.000 permintaan sehari.
| Dingin | Prefix di-cache | |
|---|---|---|
| GPT-6 Luna, per permintaan | $0.0205 | $0.0025 |
| GPT-6 Luna, per hari | $1,025 | $125 |
| GPT-6 Sol, per permintaan | $0.410 | $0.050 |
| GPT-6 Sol, per hari | $20,500 | $2,500 |
Caching mengurangi tagihan Luna sebesar 88% di sini, dibandingkan 52% pada beban kerja A. Perbedaan itulah intinya: diskon berskala dengan rasio prefix stabil terhadap token baru. Prefix 200.000 token yang dibaca ulang 50.000 kali sehari adalah bentuk di mana caching prompt paling menguntungkan.
Jendela Luna juga lebih besar dari 872.000 token Sol, sehingga payload 900.000 token tidak muat di model yang lebih mahal namun muat di model yang lebih murah. Ini membalikkan aturan routing 'promosikan ke model yang lebih besar ketika payload bertambah' yang biasa, dibahas secara rinci dalam apa sebenarnya GPT-6 Luna.
Beban Kerja C: pengisian ulang satu kali
Pekerjaan batch adalah di mana harga baru mengubah apa yang mungkin, bukan hanya apa yang murah. Asumsikan proses pengayaan 12.000.000 catatan: 900 token instruksi stabil, 300 token per catatan, 250 token keluaran.
| GPT-6 Luna | GPT-6 Sol | |
|---|---|---|
| Masukan, dingin | $1,440 | $28,800 |
| Keluaran | $1,500 | $30,000 |
| Total, dingin | $2,940 | $58,800 |
| Total, prefix di-cache | $1,968 | belum dihitung |
Pengisian ulang dua belas juta catatan dengan biaya di bawah $3.000, atau di bawah $2.000 jika prefix instruksi tetap hangat. Itu adalah angka yang dapat disetujui tim dalam satu pesan. Pekerjaan yang sama di Sol membutuhkan percakapan anggaran.
Perhatikan rasionya di sini. Keluaran sekarang menyumbang separuh dari tagihan, yang mengarahkan langsung pada hal yang sebenarnya menentukan biaya Anda.
Tiga variabel yang menentukan tagihan
1. Token keluaran, karena ditagih lima kali lipat dari masukan
Tarif keluaran Luna adalah 5x tarif masukannya. Pada beban kerja A dengan prefix yang di-cache, masukan berharga $65 per juta permintaan dan 120 token keluaran berharga $60. Longgarkan format respons menjadi 400 token dan keluaran melonjak menjadi $200, menjadikan total dari $125 menjadi $265 per juta permintaan. Skema respons yang dipilih dalam satu sore lebih dari dua kali lipat tagihan.
Perbaikannya membosankan dan efektif: batasi keluarannya. Kembalikan enum, bukan kalimat. Kembalikan skor, bukan penjelasan, dan ambil penjelasan hanya untuk sebagian kecil kasus yang ditinjau manusia. Kunci bentuknya dengan skema JSON agar model tidak bisa mengembangkannya:
{
  "model": "gpt-6-luna",
  "response_format": {
    "type": "json_schema",
    "json_schema": {
      "name": "triage",
      "strict": true,
      "schema": {
        "type": "object",
        "properties": {
          "category": { "enum": ["billing", "outage", "how_to", "abuse"] },
          "severity": { "type": "integer", "minimum": 1, "maximum": 4 }
        },
        "required": ["category", "severity"],
        "additionalProperties": false
      }
    }
  }
}
Konfirmasikan nama parameter terhadap referensi model OpenAI saat ini sebelum membangun berdasarkan bentuk ini. ID model gpt-6-luna adalah bagian yang dikonfirmasi dari materi peluncuran.
2. Tingkat hit cache, karena itu satu-satunya diskon gratis 50% hingga 88% yang akan Anda dapatkan
Semua di atas mengasumsikan prefix tetap identik byte. Dalam produksi, biasanya tidak, karena seseorang menyuntikkan ID permintaan ke dalam prompt sistem atau membangun array alat dari kamus yang urutan kuncinya berubah-ubah antar proses. Dua pembunuh cache klasik kini tidak lagi menjadi masalah: dengan GPT-6, mengubah upaya penalaran atau ketersediaan alat tidak lagi membatalkan cache, dan titik henti eksplisit memungkinkan Anda memutuskan di mana prefix yang di-cache berakhir. Dashboard Prompt Caching dan alat diagnostik menjadikan tingkat hit sebagai sesuatu yang Anda ukur, bukan hanya diasumsikan, dan GitHub melaporkan lebih dari 50% lebih sedikit token prompt yang membutuhkan pemrosesan baru di miliaran permintaan. Mekanikanya dibahas dalam panduan caching prompt GPT-6 kami.
Pada volume besar, perlakukan tingkat hit sebagai SLI produksi. Refaktor prefix yang secara diam-Siam menjatuhkan Anda dari 95% hit menjadi 40% akan memakan biaya beban kerja A sekitar $400 sehari dan tidak menghasilkan kesalahan, peringatan, atau tes yang gagal.
3. Percobaan ulang, karena mereka berlipat ganda
Tingkat percobaan ulang 5% pada beban kerja A menambahkan sekitar $31 sehari. Dapat ditoleransi. 5% yang sama pada beban kerja B berharga $50 sehari jika percobaan ulang tidak mengenai cache dan $6 jika mengenainya, dan perbedaannya sepenuhnya tergantung apakah percobaan ulang Anda membangun kembali prompt dari awal. Percobaan ulang yang meregenerasi prefix adalah ketahanan termahal yang dapat Anda beli. Gunakan kembali badan permintaan yang sama persis.
Jebakan latensi pada QPS tinggi
Murah tidak berarti cepat, dan pada QPS tinggi itu menjadi masalah. Pengukuran pihak ketiga dari Artificial Analysis menempatkan GPT-6 Luna pada 153,9 token keluaran per detik dengan waktu hingga token pertama 124,23 detik, dan GPT-6 Sol pada 102,15 detik. Dua peringatan berlaku dan keduanya penting: ini adalah angka pihak ketiga daripada yang diterbitkan vendor, dan diukur pada varian penalaran **maksimum**, konfigurasi paling lambat yang tersedia.
Meskipun demikian, arahnya penting. Dua menit hingga token pertama akan menyebabkan batas waktu klien HTTP default terlampaui, menonaktifkan penyeimbang beban, dan melebihi batas eksekusi pada sebagian besar runtime tanpa server. Jalur sinkron QPS tinggi seharusnya menggunakan upaya rendah dengan streaming; upaya tinggi seharusnya pada pekerjaan batch dan pekerja antrean di mana tidak ada yang menunggu soket. Sesuaikan batas waktu dengan latensi terukur pada tingkat upaya yang Anda kirimkan, bukan berdasarkan harga.
Di mana batas kualitas berada
Luna bukanlah model terpintar dalam keluarga dan OpenAI tidak mengklaimnya demikian. Astra 'terus menjadi model terbaik kami secara keseluruhan' menurut kata-kata OpenAI sendiri. Apa yang diterbitkan OpenAI: Luna pada upaya maksimal mencetak 66,6% pada DeepSWE 1.1, sebanding dengan Claude Opus 5 dan Claude Fable 5 pada upaya menengah, dengan biaya per tugas 93% lebih rendah dari Opus 5 dan 96% lebih rendah dari Fable 5. Pada AutomationBench 1.0.6 pada upaya tinggi, ia mengalahkan pendahulunya sebesar 5,4 poin dengan biaya per tugas 58% lebih rendah. Pada OSWorld 2.0 offline pada upaya maksimal, ia mengalahkan GPT-5.6 Sol pada upaya menengah dengan sepersepuluh biaya.
Angka-angka tersebut adalah angka vendor yang diukur terhadap Claude Opus 5, bukan Opus 5.5, yang dikirimkan pada hari yang sama, jadi anggaplah sebagai petunjuk arah. Pembacaan operasionalnya adalah bahwa Luna adalah model termurah yang memenuhi standar untuk pekerjaan yang terdefinisi dengan baik, dapat diverifikasi, dan 'dapat diverifikasi' adalah kata kunci yang penting.
Buktikan model biaya sebelum Anda berkomitmen padanya
Perhitungan spreadsheet adalah hipotesis. Ujilah pada lalu lintas nyata: ambil sampel 500 permintaan dari payload produksi, jalankan terhadap Luna dan Sol sebagai dua lingkungan, dan catat jumlah token, latensi, serta kesesuaian skema.
Di Apidog, itu adalah satu endpoint yang disimpan dengan ID model sebagai variabel lingkungan, dijalankan sebagai skenario pengujian terhadap file data payload nyata. Tambahkan tiga pernyataan (assertion) dan suite tersebut menjadi penghalang biaya daripada pemeriksaan kebenaran: pastikan respons sesuai dengan skema JSON Anda, pastikan usage.completion_tokens tetap di bawah anggaran keluaran per permintaan Anda, dan pastikan usage.prompt_tokens_details.cached_tokens tidak nol, sehingga refaktor prefix yang membunuh tingkat hit cache Anda akan menggagalkan CI alih-alih muncul di tagihan bulan depan. Konfirmasikan nama-nama bidang penggunaan tersebut terhadap referensi API saat ini sebelum Anda membuat pernyataan tentangnya.
Pernyataan terakhir itu adalah yang tidak pernah ditulis siapa pun dan dibutuhkan semua orang. Mode kegagalan beban kerja LLM bervolume tinggi hampir tidak pernah merupakan pemadaman. Ini adalah tagihan 4x di balik dasbor hijau.
Untuk bagaimana harga Luna dibandingkan dengan GPT-6 Sol dan Claude Opus 5.5 sepanjang minggu, lihat rincian kami tentang perang harga model AI September 2026.
Versi singkat
Arahkan pekerjaan bervolume tinggi, terdefinisi dengan baik, dan dapat diverifikasi secara terprogram ke Luna dan pertahankan bagian stabil dari prompt Anda agar identik byte. Batasi token keluaran, karena ditagih lima kali lipat dari masukan. Ukur tingkat hit cache sebagai metrik produksi. Jauhkan upaya tinggi dari jalur sinkron sampai Anda mengukur waktu token pertama pada lalu lintas Anda sendiri. Lakukan itu, dan pekerjaan yang tidak pernah dikirim karena perhitungannya tidak berhasil layak untuk dihitung biayanya lagi minggu ini.