
GPT-6 Astra meningkatkan skor MATH-500 Qwen3.5-0.8B dari 7,9% menjadi 48,1% tanpa pelatihan apa pun. Ia membaca bobot model, menemukan satu arah yang membuat model berputar-putar dalam pemikirannya, dan menguranginya dari dua lapisan MLP. Penyuntingan itu menyentuh 131.072 bobot, 0,016% dari model. Angka-angka ini berasal dari pos 2 November oleh empat peneliti MIT CSAIL, dan model hasil suntingan tersedia publik, jadi Anda dapat memeriksa klaimnya sendiri.
Di bawah ini: apa itu pemrograman ruang-bobot, apa yang diubah Astra, di mana metode ini berhenti bekerja, dan bagaimana membuat agen coding Anda membandingkan kedua model dengan Apidog CLI.
Apa itu pemrograman ruang-bobot?
Pemrograman ruang-bobot adalah LLM serbaguna yang membaca dan menulis bobot jaringan saraf secara langsung, dipandu oleh tujuan berbahasa biasa, tanpa penurunan gradien dan tanpa loop pelatihan. Model menalar tentang apa yang dihitung setiap bagian jaringan, lalu mengubah angka-angkanya secara manual, seperti cara seorang programmer menyunting kode sumber.
Istilah ini berasal dari Sparks of Weight-Space Programming oleh Rikiya Takehi, Jayden Teoh, Alex Zhang dan Omar Khattab, yang diterbitkan 2 November 2026. Para penulis menyebut setiap hasil “sangat awal”, dan beberapa berasal dari satu atau beberapa kali percobaan. Untuk latar belakang tentang model yang melakukan penyuntingan, lihat ulasan langsung GPT-6 Astra.
Bagaimana GPT-6 Astra memperbaiki Qwen3.5-0.8B
Hasil utamanya adalah Eksperimen 8. Para peneliti meminta GPT-6 Astra membuat Qwen3.5-0.8B lebih baik dalam matematika dengan menyunting bobotnya. Berikut yang terjadi, langkah demi langkah:
- Persiapannya. Astra mendapat sesi Python (seperti notebook) dengan bobot model dimuat, tanpa GPU, dan 7.469 soal latihan GSM8K plus 7.275 MATH dari set pelatihan. Ia tidak pernah melihat set pengujian.
- Anggarannya. Alih-alih pelatihan, Astra dapat menghabiskan 10, 25, atau 50 forward pass. Satu forward pass memungkinkan model menjawab hingga 512 soal atau membaca hingga 1.024 teks.
- Diagnosisnya. Astra melihat bahwa model dasar berputar-putar: 85 dari 96 jawaban latihan pertamanya mencapai batas 32.768 token tanpa mencapai jawaban. Para penulis mencatat bahwa kartu model Qwen sendiri memperingatkan model ini rentan terhadap loop berpikir.
- Penelusurannya. Astra melacak perulangan itu ke satu arah yang ditulis oleh MLP lapisan 15 dan 19.
- Penyuntingannya. Ia mengurangi arah itu dari 64 kolom keluaran
down_projdi masing-masing dari dua lapisan. Itu 131.072 bobot dari 0,8 miliar.
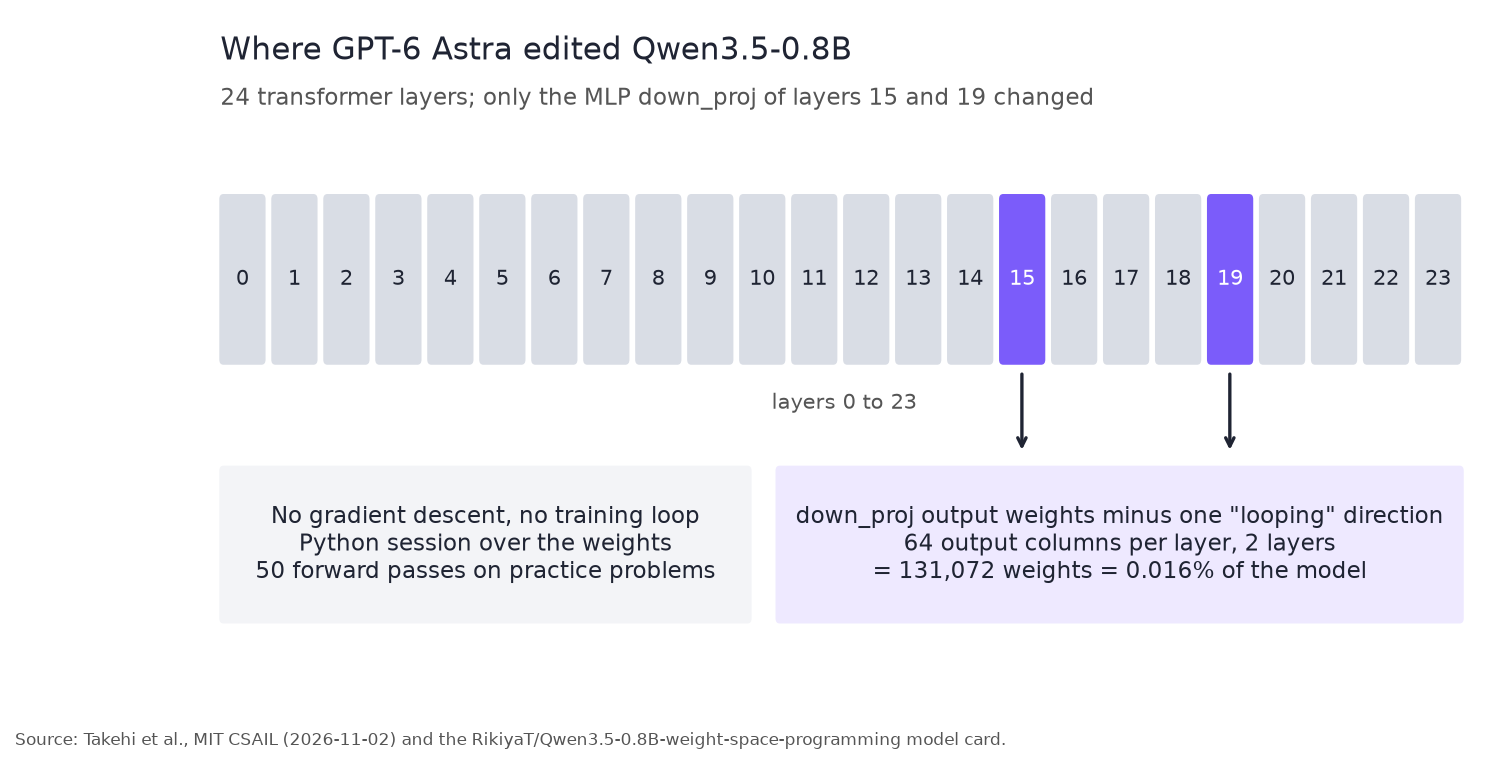
Menurut kartu model Hugging Face, hanya kedua tensor down_proj itu yang berbeda dari checkpoint dasar Qwen/Qwen3.5-0.8B, dan setiap tensor yang dibangun ulang diverifikasi sha256 terhadap tensor yang dievaluasi para penulis. Model hasil suntingan dirilis di bawah Apache 2.0.
Hasil: dasar vs hasil suntingan Qwen3.5-0.8B
Setiap angka di sini berasal dari pos para penulis (thinking aktif, hingga 32.768 token, beberapa sampel per soal). “Mencapai batas token” adalah proporsi jawaban MATH-500 yang kehabisan token.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Mencapai batas token |
|---|---|---|---|---|
| Dasar | 7,9% | 13,8% | 21,0% | 93,0% |
| Hasil suntingan, 10 forward pass | 12,3% | 25,7% | 49,0% | 87,2% |
| Hasil suntingan, 25 forward pass | 14,1% | 25,1% | 39,9% | 86,4% |
| Hasil suntingan, 50 forward pass | 48,1% | 67,1% | 62,3% | 33,1% |
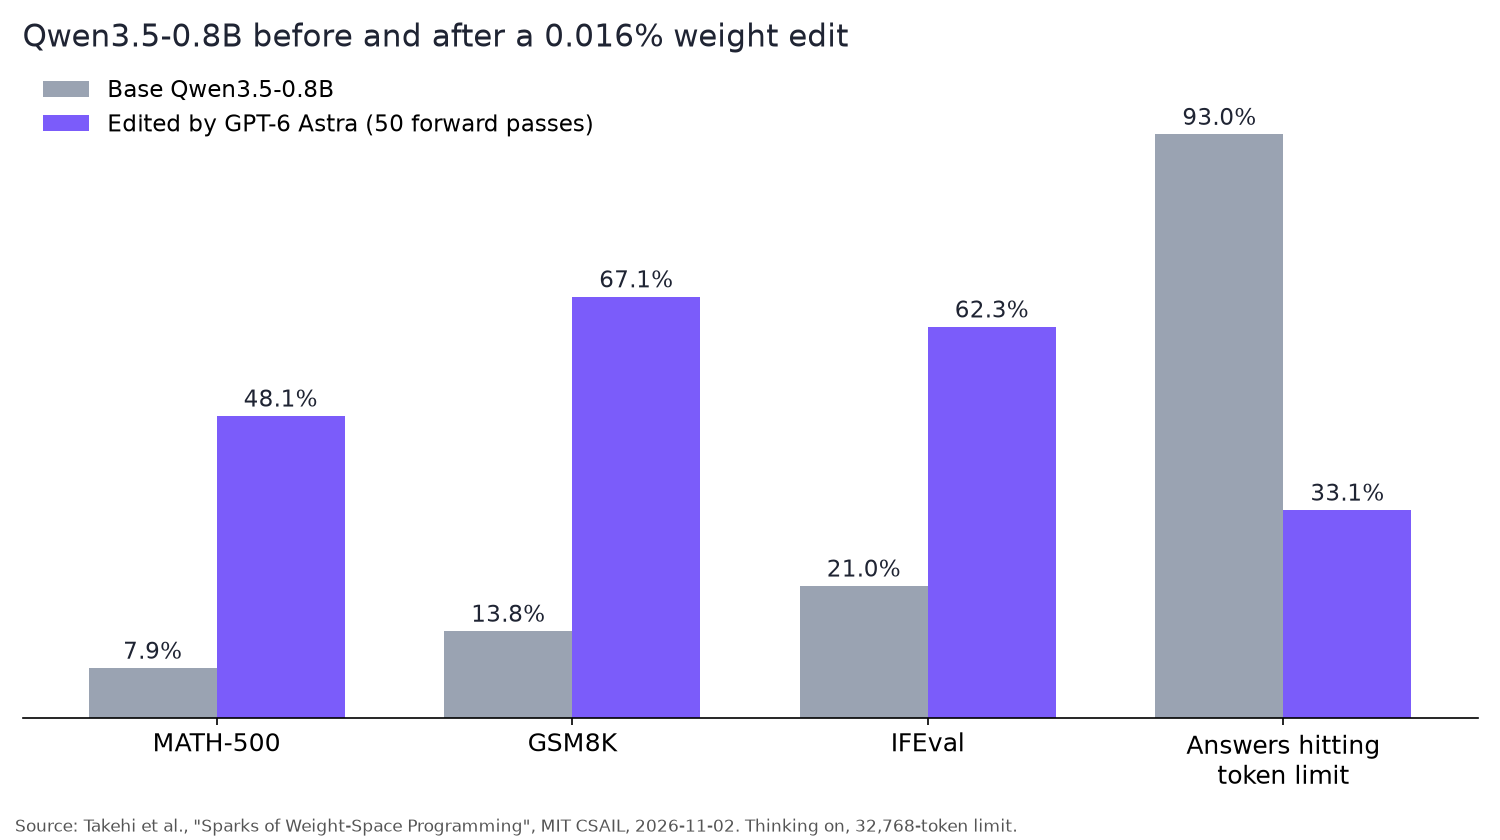
- Perbaikannya menggeneralisasi. Perulangan tidak spesifik untuk matematika, jadi IFEval juga naik sekitar tiga kali lipat.
- Anggarannya penting. Pada 10 atau 25 forward pass, perulangannya hampir tidak hilang.
- Orang lain mereproduksinya. Ahsen Khaliq di Hugging Face membangun ulang checkpoint dari log dan menjalankan ulang MATH-500 penuh (500 soal, 4 sampel masing-masing). Model hasil suntingan mencetak 51,0%, dengan 31,6% jawaban mencapai batas. Uji cepat 25 soal pada model dasar menghasilkan 5,0%.
Space demo memungkinkan Anda mengetik soal dan melihat kedua model menjawab.
Apa yang tidak bisa dilakukan penyuntingan bobot
Para penulis menjalankan kontrol yang lebih penting daripada hasil utamanya. Mereka mencoba pendekatan yang sama pada Gemma 3 270M, model yang jarang berputar-putar (8,5% jawabannya mencapai batas, dibandingkan 93% untuk Qwen).
| Gemma 3 270M | MATH-500 |
|---|---|
| Dasar | 6,8% |
| Suntingan terbaik (25 forward pass) | 7,7% |
Kesalahan Gemma adalah kesalahan biasa, seperti aritmetika yang salah, tanpa satu komponen tunggal untuk dimatikan. Kesimpulan para penulis: penyuntingan menghilangkan hambatan yang menyembunyikan kemampuan, tetapi tidak dapat menambahkan kemampuan yang tidak dimiliki model. Qwen sebenarnya sudah bisa menyelesaikan banyak jawaban. Hanya saja tidak pernah menuntaskannya.
Jadi ini bukan “pelatihan sudah berakhir”. Ini adalah model frontier yang menemukan dan menghilangkan satu kegagalan yang berada di satu tempat.
Sisa makalah pemrograman ruang-bobot
Eksperimen 8 adalah satu dari delapan. Eksperimen lainnya menggunakan jaringan yang jauh lebih kecil:
- Membaca bobot. Hanya dari bobot mentah, Astra menamai permainan untuk 4 dari 4 kebijakan game yang dilatih PPO dan bahasa pelatihan untuk 3 dari 3 model bahasa tingkat karakter kecil.
- Memperbaiki kebijakan. Kebijakan mobil Kinetix yang gagal di 256 dari 256 episode berhasil di 1.024 dari 1.024 setelah Astra menyunting 3,5% bobotnya dalam satu balasan.
- Menulis bobot dari nol. Astra menulis bobot MinAtar Breakout yang mencetak 517,4 berbanding 25,3 untuk PPO yang dilatih selama 500 juta langkah. Ia kalah di Seaquest, 53,1 berbanding 88,9.
- Go. Ia menulis jaringan Go 9x9 berbobot 1,48 juta dari nol yang, dengan 50 forward pass, mengalahkan jaringan PPO berukuran sama.
- Satu kegagalan. Hanya dari bobot, ia tidak dapat membedakan mana dari dua salinan Gemma 3 270M yang dilatih menjadi penjilat. Dengan akses ke pola attention, ia memilih si penjilat di ketiga pasangan.
Log eksperimen lengkap mencakup setiap prompt, ringkasan penalaran Astra, dan setiap potongan kode yang dijalankannya.
Periksa sendiri perbaikan loop berpikir Qwen3.5-0.8B
Uji paling bersih adalah menyajikan kedua checkpoint di balik API yang kompatibel dengan OpenAI yang sama dan mengirimkan prompt identik ke keduanya. vLLM melakukan ini dengan satu perintah per model:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
Kedua server merespons nama qwen, jadi satu body permintaan berfungsi di port mana pun. --max-model-len 34816 cocok dengan contoh di kartu model.
Setiap permintaan meniru pengaturan sampling para penulis dan mengaktifkan thinking:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
Nilai \boxed{} terakhir adalah jawabannya, dan finish_reason menunjukkan apakah model berhenti (stop) atau kehabisan token (length). Penyelesaian length berarti loop.
Jika Anda lebih memilih tidak menjalankan GPU, Anda dapat menguji GPT-6 Astra API dengan cara yang sama, atau membandingkan model Qwen kecil secara lokal dengan penyiapan Qwen3.5 Ollama gratis.
Biarkan agen coding Anda menguji kedua model dengan Apidog CLI
Menilai dua puluh generasi panjang secara manual adalah pekerjaan untuk agen coding Anda. Apidog CLI memberi agen lingkungan, skenario pengujian, eksekusi berbasis data, dan laporan, dan berjalan di mesin Anda, sehingga endpoint localhost berfungsi.
Pasang dan beri agen Anda skill:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu beri Claude Code, Codex, Cursor, atau OpenCode satu prompt:
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
Agen membaca skema payload, memvalidasi JSON-nya, lalu menjalankan perintah-perintah ini:
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d memberikan setiap baris CSV sebagai satu iterasi. --timeout-request dalam milidetik, dan jawaban yang berputar-putar bisa memakan waktu beberapa menit untuk menghabiskan 32.768 token. -r cli,json mencetak ringkasan dan menulis laporan JSON yang dapat di-diff oleh agen. 10 soalnya berasal dari split pengujian GSM8K.
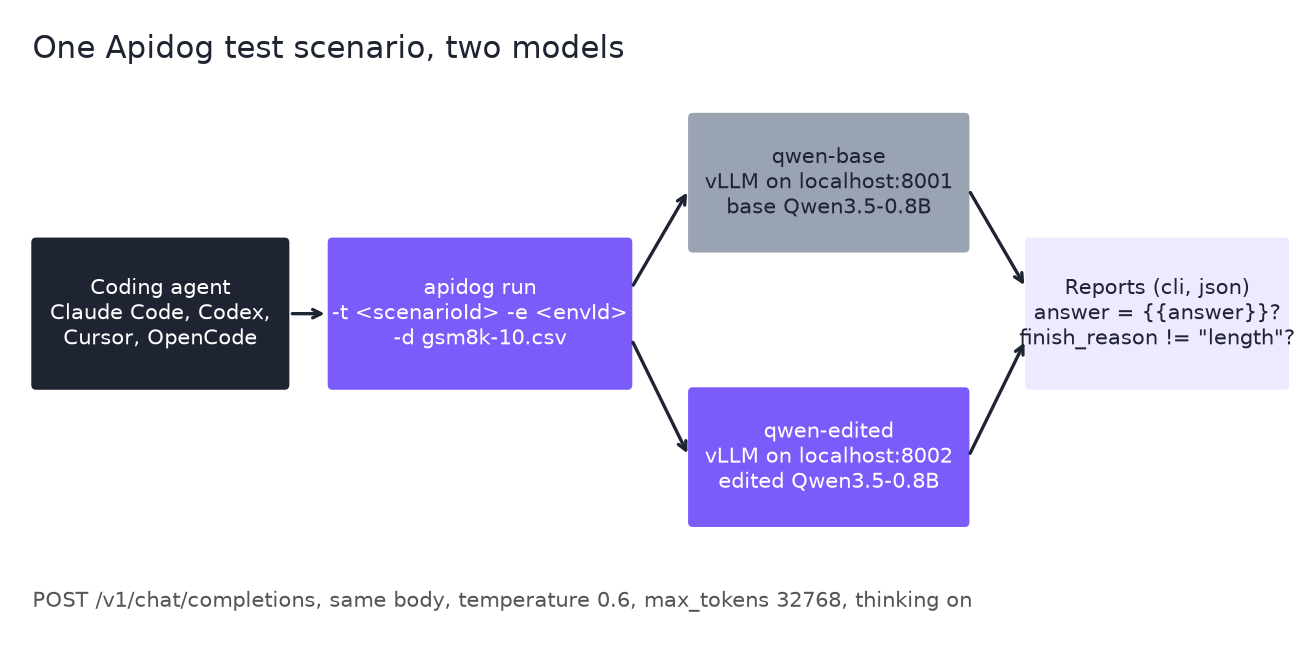
Jika eksekusi Anda terlihat seperti milik para penulis, sebagian besar jawaban dasar gagal pada assertion finish_reason dan sebagian besar jawaban hasil suntingan lolos. Sepuluh soal adalah uji cepat, bukan tolok ukur, jadi anggap selisih sebagai sinyal, bukan skor. Tambahkan --upload-report untuk melihat eksekusi di aplikasi, dan lihat referensi perintah apidog run untuk setiap flag.
Skenario yang sama berfungsi sebagai uji regresi untuk setiap penggantian model; panduan CI/CD Apidog CLI menunjukkan penyiapan -r junit.
Apa artinya ini jika Anda merilis model kecil
- Ukur pemotongan, bukan hanya akurasi. 7,9% milik Qwen menyembunyikan model yang sebagian besar tidak pernah selesai. Pemeriksaan
finish_reasonmenangkap itu. - Carilah kegagalan penyebab tunggal. Loop dan pengulangan bisa berada di bagian jaringan yang sempit.
- Ingat kontrolnya. Jika model Anda salah, bukan macet, suntingan seperti ini tidak akan membantu.
Memilih tier GPT-6 untuk pekerjaan agen? Lihat GPT-6 Luna vs Sol vs Astra.
Pertanyaan Umum
Apakah GPT-6 Astra melatih Qwen3.5-0.8B? Tidak. Para penulis tidak mengizinkan penurunan gradien dan tidak ada loop pelatihan. Astra menyunting bobot dalam sesi Python dan mengamati model hanya melalui 10, 25, atau 50 forward pass.
Berapa banyak bobot yang diubah oleh suntingan itu? 131.072 bobot, yang menurut para penulis adalah 0,016% dari model. Perubahannya berada di matriks down_proj dari MLP di lapisan 15 dan 19, 64 kolom keluaran di masing-masingnya.
Apakah model hasil suntingan tersedia? Ya, sebagai RikiyaT/Qwen3.5-0.8B-weight-space-programming di Hugging Face di bawah Apache 2.0, dengan hash dari dua tensor yang diubah dan eksekusi ulang independen (51,0% pada MATH-500).
Mengapa skor matematika melonjak begitu banyak? Karena model dasarnya berputar-putar. Pada MATH-500, 93,0% jawabannya mencapai batas 32.768 token. Suntingan itu menurunkannya menjadi 33,1%, sehingga model menuntaskan jawaban yang sebenarnya sudah bisa diselesaikannya. Ia tidak mempelajari matematika baru.
Apakah pemrograman ruang-bobot berfungsi pada model apa pun? Belum, menurut pengakuan para penulis sendiri. Pada Gemma 3 270M, yang jarang berputar-putar, suntingan terbaik menggerakkan MATH-500 dari 6,8% ke 7,7%. Para penulis menyebut semua hasil mereka masih sangat awal.
Bisakah saya menguji model hasil suntingan tanpa menulis kode? Ya. Space demo Hugging Face menjalankan kedua model pada soal yang Anda ketik. Untuk pemeriksaan yang dapat diulang, gunakan vLLM plus Apidog CLI seperti yang ditunjukkan di atas.