
Perbandingan GPT-6.2 Astra vs Claude Fable 5.2 pada dasarnya bermuara pada ini: keduanya berharga $8 per juta token input dan $40 per juta token output, keduanya menawarkan konteks sekitar satu juta token dan output 128K, dan keduanya ditargetkan untuk pekerjaan coding agentic yang panjang. Perbedaan yang menentukan pilihan Anda adalah harga cache, penagihan konteks panjang, keanehan API yang harus ditangani oleh agent harness Anda, dan cara masing-masing model berperilaku pada tugas-tugas Anda sendiri.
OpenAI merilis GPT-6.2 Astra pada 17 November 2026, delapan hari setelah Anthropic meluncurkan Claude Fable 5.2. Panduan ini membahas spesifikasi, biaya sesi agent nyata, error permintaan yang bisa merusak harness yang dibangun untuk model lainnya, dan cara menguji keduanya dengan Apidog CLI.
GPT-6.2 Astra vs Claude Fable 5.2: kesimpulan singkat
Pilih Claude Fable 5.2 jika agent Anda mengirim prompt panjang dan membaca ulang konteks cache yang besar, karena biaya cache read-nya setengah lebih murah dan seluruh jendela 1M-nya ditagih dengan tarif standar. Pilih GPT-6.2 Astra jika stack Anda sudah berjalan di OpenAI Responses API dan Anda ingin menggunakan hosted tools-nya, seperti apply_patch, hosted shell, dan subagent multi-agent. Untuk keperluan lainnya, uji keduanya pada tugas-tugas Anda sendiri sebelum memutuskan.
Ulasan awal cenderung memihak Fable dalam hal kemampuan mentah. Simon Willison menulis pada hari peluncuran bahwa Astra "tidak mendapatkan skor setinggi Fable 5.2 pada berbagai benchmark" dan beberapa penguji menganggap gaya komunikasinya membingungkan. Anggap itu sebagai sinyal untuk menguji sendiri, bukan sebagai vonis akhir.
Bagaimana perbandingan GPT-6.2 Astra dan Claude Fable 5.2 dari segi spesifikasi dan harga?
Kedua model mencantumkan harga dasar yang sama, jadi perbandingannya terletak pada detail. Setiap angka di bawah ini berasal dari halaman model GPT-6.2 Astra dan ikhtisar Claude Fable 5.2, yang diverifikasi pada 18 November 2026.
| Spesifikasi | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| ID model API | gpt-6.2-astra |
claude-fable-5-2 |
| Tanggal rilis | 17 Nov 2026 | 9 Nov 2026 |
| Input / output per 1 juta token | $8 / $40 | $8 / $40 |
| Input cache (cache read) | $0.40 | $0.20 |
| Cache write | $10 (30 menit), $20 (12 jam) | $10 (5 menit), $16 (1 jam) |
| Jendela konteks | 1.050.000 (maks. input 922.000) | 1M |
| Output maksimum | 128.000 | 128K |
| Prompt panjang | Input di atas 272K: input 2x, output 1,5x | Seluruh 1M dengan harga standar |
| Batch | Diskon 50% | Diskon 50% |
| Batas pengetahuan | 18 Mei 2026 | Juni 2026 |
| Kontrol reasoning | reasoning.effort (none ditolak) |
effort, default high, thinking selalu aktif |
Harga keduanya turun 20% dari generasi sebelumnya. GPT-6 Astra dan Claude Fable 5 keduanya berharga $10 / $50, seperti dicatat Willison. Jika Anda masih menggunakan model lama, panduan API GPT-6 Astra dan rincian harga Claude Fable 5.2 menjelaskan apa saja yang berubah.
Berapa biaya sebenarnya satu sesi coding agent?
Sebuah coding agent jarang mengirim satu prompt pendek. Ia memuat ulang konteks repo, definisi tool, dan riwayat percakapan di setiap giliran, sehingga cache read dan aturan prompt panjang lebih menentukan daripada harga utamanya.
Berikut dua contoh beban kerja yang dihitung dari daftar tarif resmi, dengan pemrosesan Standard.
| Beban kerja | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Sesi agent: 150K token ditulis ke cache, 1,35 juta cache read, 150K output (setiap permintaan di bawah 272K) | $1,50 + $0,54 + $6,00 = $8,04 | $1,50 + $0,27 + $6,00 = $7,77 |
| Satu permintaan panjang: 400K input, 8K output, tanpa cache | $6,40 + $0,48 = $6,88 | $3,20 + $0,32 = $3,52 |
Biaya sesinya hampir sama karena komponen output yang mendominasi: 150K token output berharga $6,00 di kedua model. Selisih cache read menghemat 27 sen di sini, dan selisihnya akan membesar seiring sesi yang lebih panjang.
Pada permintaan panjang tunggal itulah tagihannya terpecah. Begitu permintaan Astra melewati 272K token input, OpenAI menggandakan tarif input menjadi $16 dan menaikkan output menjadi $60 untuk seluruh permintaan tersebut. Fable 5.2 menagih prompt 400K dengan tarif $8 yang sama seperti prompt 4K.
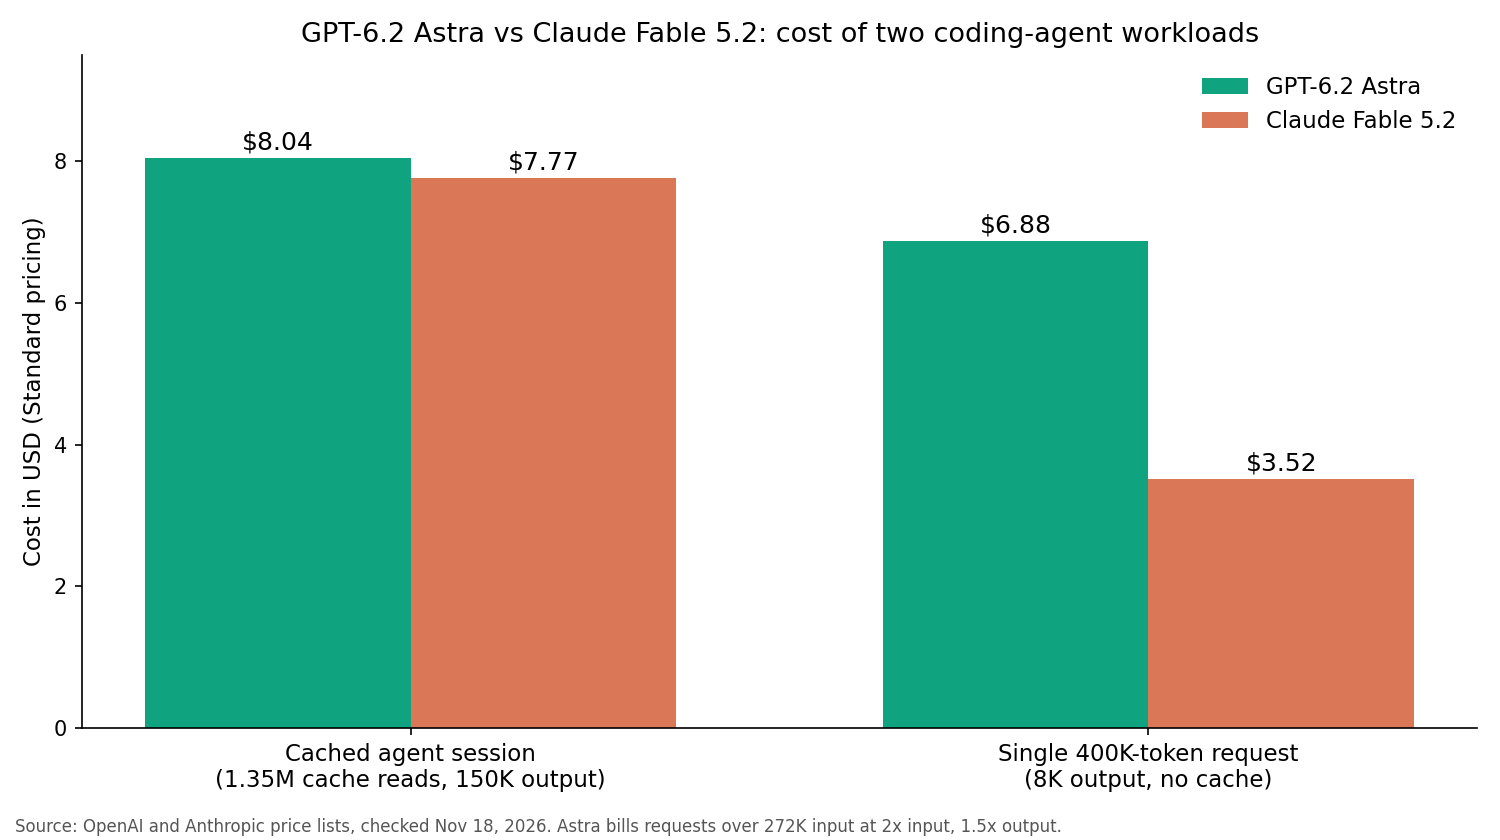
Jika agent Anda memasukkan monorepo besar atau log panjang ke dalam satu permintaan, jaga agar tetap di bawah 272K di Astra, atau bersiap membayar hampir dua kali lipat.
Keanehan API mana yang bisa merusak harness yang dibangun untuk model lainnya?
Berganti model bukan sekadar mengganti string model. Setiap API menolak pengaturan yang diterima oleh yang lain, dan kedua kegagalan tersebut muncul sebagai error HTTP 400.
Claude Fable 5.2 menolak:
- Pemakaian tool yang dipaksa (forced tool use). Menyetel
tool_choicekeanyatautoolmengembalikan 400, sesuai catatan Fable 5.2 dari Anthropic. - Parameter sampling. Hilangkan
temperature,top_p, dantop_k; nilai yang tercantum oleh Anthropic akan mengembalikan 400. - Mematikan thinking. Adaptive thinking selalu aktif, sehingga parameter effort adalah satu-satunya kendali Anda atas kedalaman, latensi, dan biaya.
GPT-6.2 Astra menolak:
reasoning.effortyang disetel kenone(Responses API) ataureasoning_effort: "none"(Chat Completions), sesuai panduan reasoning dari OpenAI.- Endpoint Realtime, Assistants, dan fine-tuning, yang tercantum sebagai tidak didukung di halaman model.
Jika harness Anda memaksa pemanggilan tool untuk mendapatkan output terstruktur, itu berhasil di Astra dan gagal di Fable; pindahkan strukturnya ke prompt atau skema tool. Jika ia menyetel temperature: 0, hapus itu untuk Fable.
Penanganan data juga berbeda. Anthropic menyatakan bahwa Fable 5.2 mewajibkan retensi data 30 hari dan tidak tersedia di bawah zero data retention kecuali diizinkan secara eksplisit oleh Anthropic. Periksa hal ini terhadap kebijakan keamanan Anda sebelum mengalirkan kode produksi melaluinya.
Di mana GPT-6.2 Astra unggul?
Kekuatan Astra terletak pada kotak perkakas di sekitarnya. Di Responses API, OpenAI mencantumkan apply_patch, hosted_shell, computer_use, code_interpreter, mcp, skills, dan tool_search sebagai tool yang didukung. Sebuah beta multi-agent memungkinkan Astra mendelegasikan pekerjaan ke subagent.
Ini penting jika Anda tidak ingin membangun sendiri patch applier dan shell runner.
Masukan prarilis dari Theo Browne, yang dikutip Willison, menyebutkan bahwa Astra "bisa menarik banyak subagent dan mengelolanya dengan cukup baik" pada tugas panjang, tetapi kadang berhenti untuk menanyakan detail internal yang tidak bisa dijawab oleh pengguna. Berikan kondisi penghentian yang jelas.
Astra juga menawarkan lebih banyak tingkatan biaya: Batch dengan diskon 50%, Fast mode dengan 2x harga Standard, dan jendela background 30% di bawah Standard untuk penyelesaian 2 jam dan 40% di bawah untuk penyelesaian 8 jam. Pembuatan test semalaman bisa berjalan di sana dengan biaya lebih murah.
Di mana Claude Fable 5.2 unggul?
Fable unggul pada konteks panjang yang padat cache. Cache read-nya berharga $0,20 per juta token, atau 2,5% dari harga input, dan seluruh jendela 1M-nya ditagih dengan tarif standar tanpa pengali prompt panjang.
Anthropic memosisikan Fable 5.2 untuk sesi agent yang berjalan berjam-jam. Kontrol effort-nya berjalan dari low hingga max; Anthropic menyarankan untuk memulai dari high, yaitu nilai default, dan naik ke xhigh hanya jika Anda telah mengukur adanya keuntungan.
Fable juga mendapat penerimaan awal yang lebih kuat pada coding kreatif yang sulit. Dalam uji peluncuran Willison, sebuah prompt animasi Three.js dijalankan pada kedua model OpenAI baru dengan effort Ultra di Codex CLI, dan tidak ada yang menyaingi hasil yang ia dapatkan dari Fable 5.2.
Fable juga berjalan di Amazon Bedrock, Google Cloud, dan Microsoft Foundry, serta Fast mode-nya memberikan kecepatan output hingga 2,5x lebih tinggi dengan harga $16 / $80 per juta token. Untuk contoh permintaan, lihat panduan API Claude Fable 5.2.
Bagaimana menguji GPT-6.2 Astra dan Claude Fable 5.2 pada beban kerja API Anda sendiri?
Benchmark mengukur tugas-tugas orang lain. Sebaiknya jalankan prompt yang sama melalui kedua API:
- Pilih 5 hingga 10 prompt nyata dari riwayat agent Anda, misalnya perbaikan bug, refactor, dan tugas penulisan test.
- Tulis satu permintaan per model dengan konten identik, menggunakan format masing-masing API.
- Buat assertion untuk status 200, jawaban tidak kosong, dan bentuk struktur yang di-parse oleh agent Anda.
- Jalankan setiap permintaan beberapa kali dan bandingkan token, latensi, serta tingkat keberhasilan.
Kedua pemanggilan adalah HTTP biasa. Berikut permintaan Astra pada Responses API:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6.2-astra", "reasoning": {"effort": "high"},
       "input": "Review this diff and list the bugs."}'
Fable 5.2 menggunakan Messages API dari Anthropic dengan claude-fable-5-2 sebagai model dan tanpa field temperature.
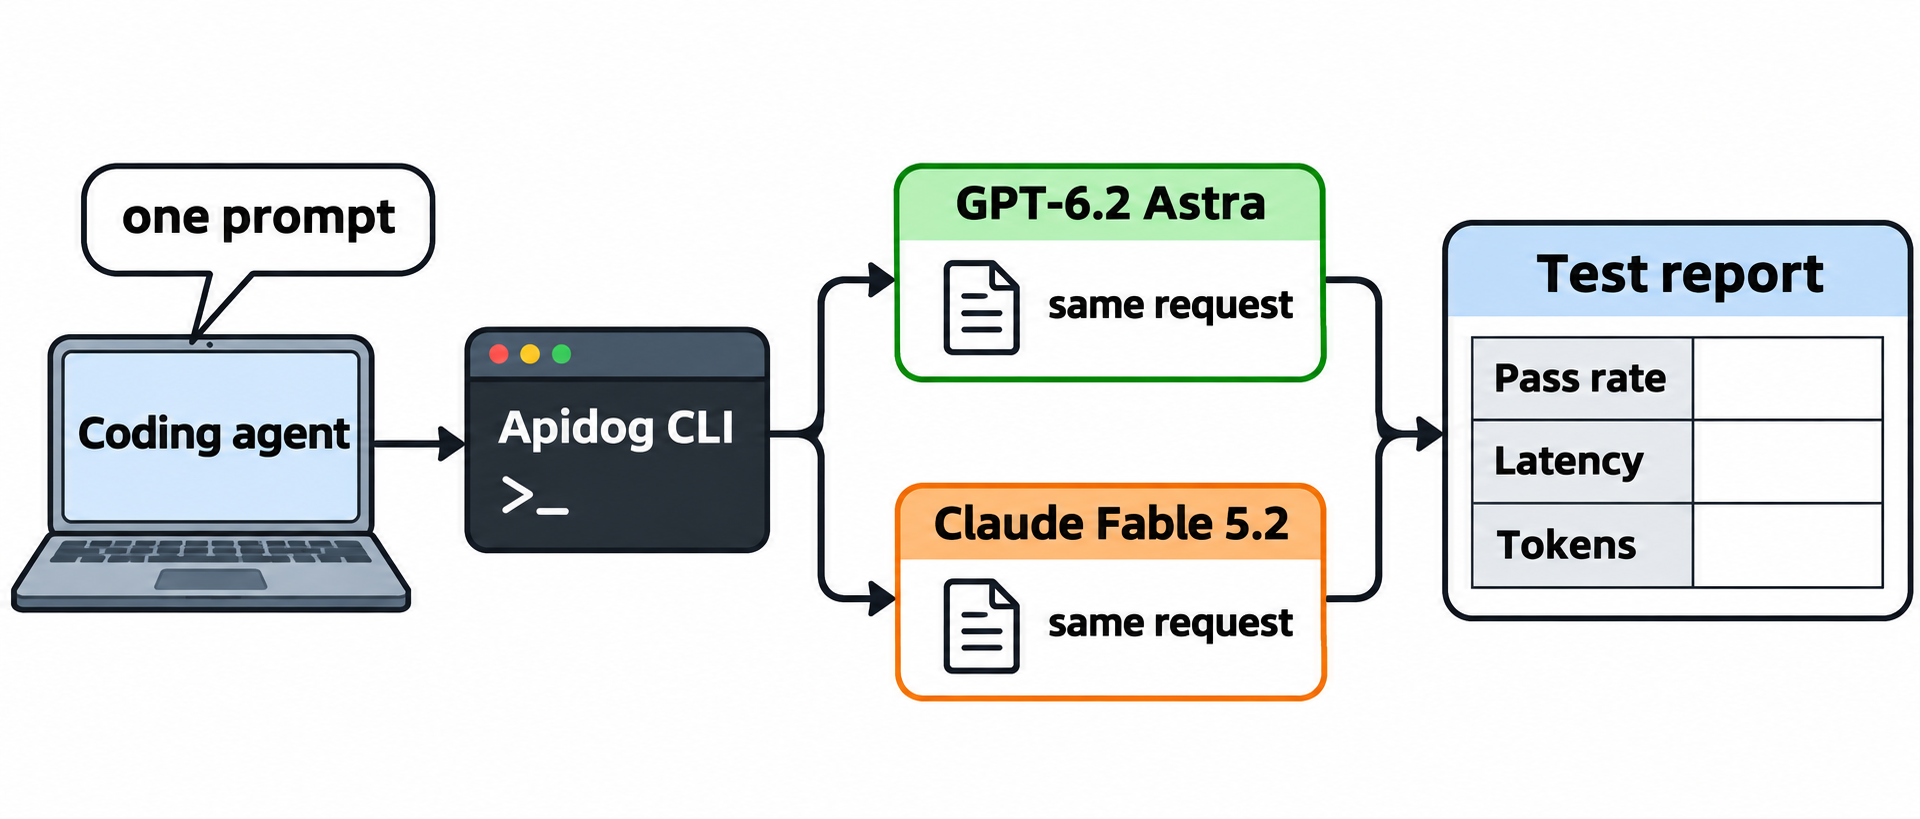
Biarkan coding agent Anda menjalankan A/B dengan Apidog CLI
Menjalankan pasangan permintaan secara manual cepat membuat lelah. Biarkan Claude Code, Codex, atau Cursor yang menggerakkan Apidog CLI. Penyiapannya hanya tiga perintah:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt ke agent Anda:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gpt-6.2-astra through the OpenAI Responses
API, and one that sends the same prompt to claude-fable-5-2 through
the Claude Messages API with no temperature field. Keep both API keys
in private environment variables. Assert a 200 status and a non-empty
answer, record token usage and response time, run each case 5 times
and summarize cost per run. Validate every payload before you write it.
Agent akan memeriksa skema payload, menulis test case, dan menjalankannya. Flag di bawah ini berasal dari apidog run --help pada CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <ASTRA_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 mengulang setiap test case lima kali, sehingga satu respons yang lambat tidak menentukan hasilnya. Tambahkan --upload-report untuk melihat hasil run di aplikasi Apidog. Ini adalah template alur kerja; kami belum menjalankannya terhadap Astra dari mesin ini.
Anda juga bisa mengubah bagian keanehan API menjadi test. Minta agent membuat negative case yang mengirim tool_choice: any ke Fable dan mengharapkan 400, serta satu lagi yang mengirim effort: none ke Astra dan mengharapkan 400. Jika salah satu penyedia mengubah aturannya, suite pengujian Anda akan memberi tahu Anda sebelum agent Anda melakukannya. Panduan Apidog CLI di Claude Code dan panduan Apidog CLI di Codex membahas penyiapan agent-nya.
Paket Free Apidog mencakup hingga 4 pengguna, cukup untuk menjalankan perbandingan ini.
FAQ
Apakah GPT-6.2 Astra lebih murah dari Claude Fable 5.2? Harga dasarnya identik, yaitu $8 untuk input dan $40 untuk output per juta token. Fable lebih murah pada cache read ($0,20 vs $0,40) dan pada permintaan apa pun di atas 272K token input, di mana Astra menggandakan tarif inputnya.
Model mana yang memiliki jendela konteks lebih besar? Astra mencantumkan 1.050.000 token konteks dengan batas input 922.000 token. Fable 5.2 mencantumkan 1M token. Keduanya membatasi output pada 128K token per permintaan.
Bisakah saya memaksa pemanggilan tool dengan Claude Fable 5.2? Tidak. tool_choice berupa any atau tool mengembalikan error 400. Biarkan model memilih tool dengan sendirinya, dan jelaskan struktur yang diharapkan di prompt atau skema tool.
Bisakah saya mematikan reasoning pada GPT-6.2 Astra? Tidak. API menolak reasoning.effort yang disetel ke none dengan error 400. Pilih tingkat effort yang lebih rendah yang didukung untuk pemanggilan yang cepat dan murah.
Model mana yang sebaiknya saya gunakan untuk coding agent saya? Mulailah dari beban kerja Anda. Prompt panjang yang padat cache menguntungkan Fable 5.2, sementara stack berbasis OpenAI yang menginginkan tool patch, shell, dan subagent bawaan menguntungkan Astra. Jalankan keduanya pada 5 hingga 10 prompt nyata sebelum beralih.