
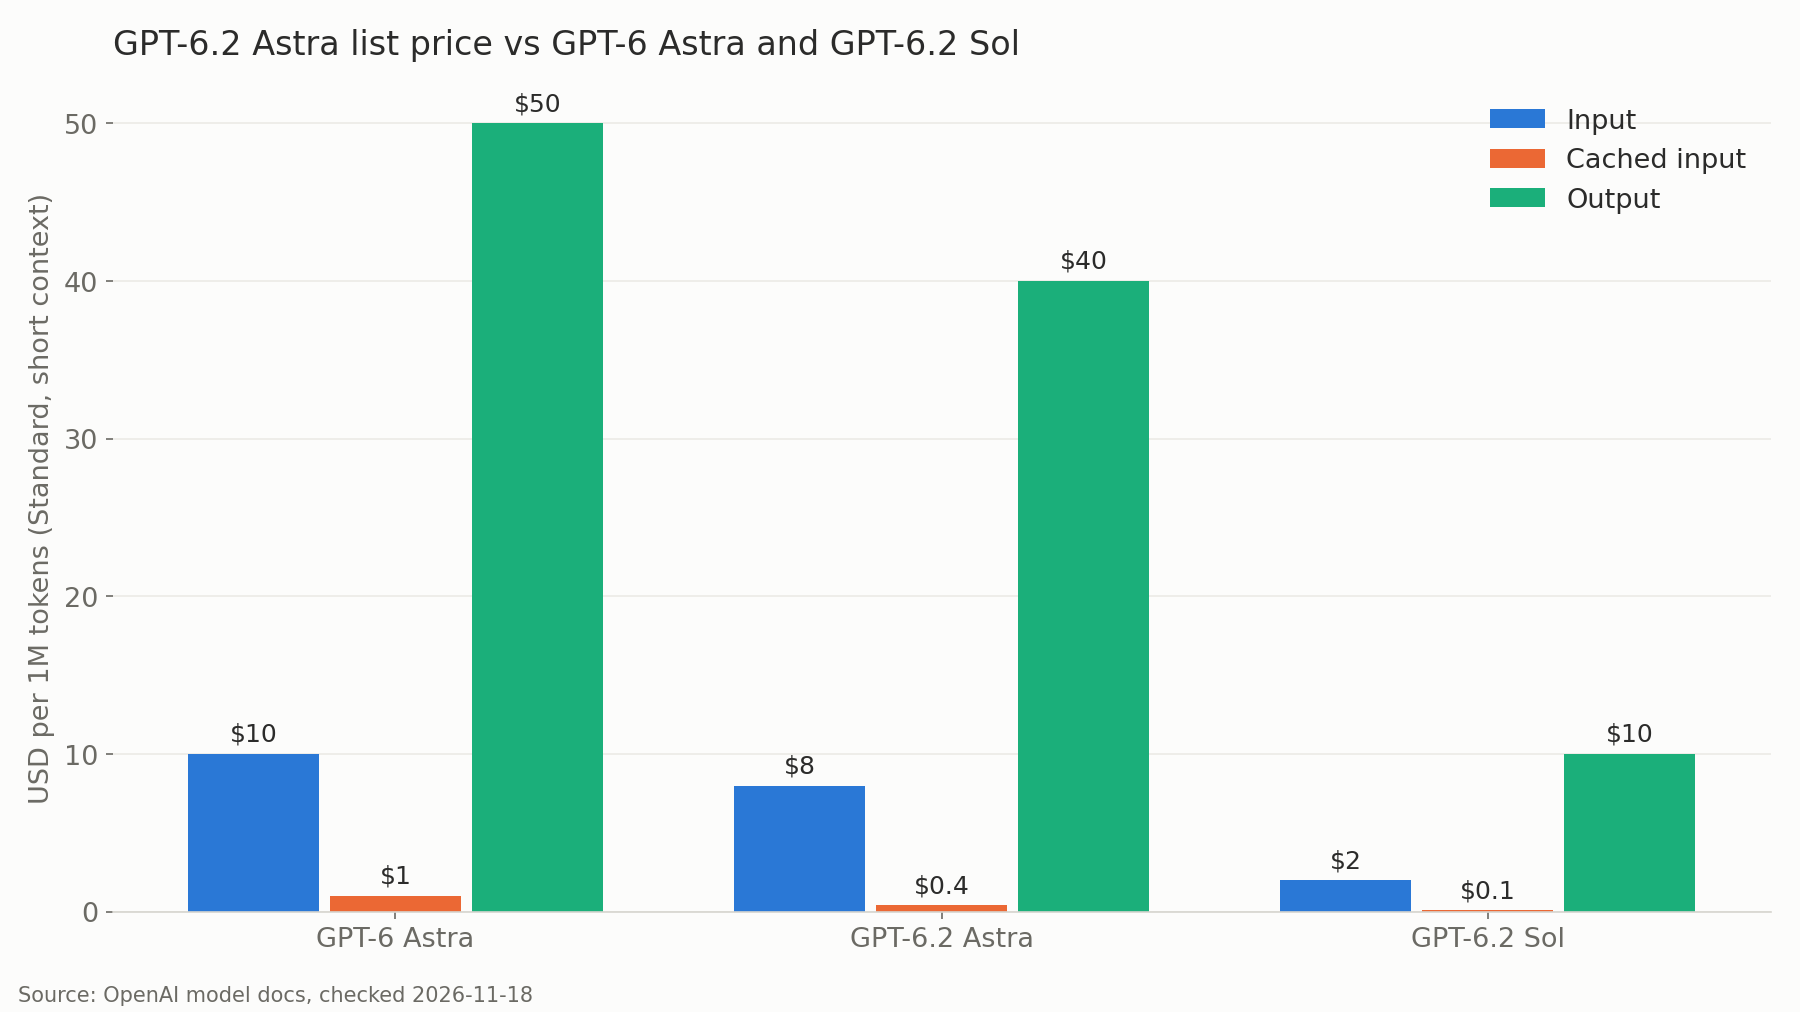
Harga GPT-6.2 Astra adalah $8 per 1M token input dan $40 per 1M token output di tingkat Standard OpenAI, dengan input ter-cache $0,40 per 1M. Itu 20% di bawah GPT-6 Astra ($10/$50), dan tarif pembacaan cache turun 60%. Saudaranya, GPT-6.2 Sol, berharga $2 untuk input dan $10 untuk output per 1M token.
OpenAI merilis kedua model ini pada 17 November 2026 sebagai gpt-6.2-astra dan gpt-6.2-sol.
Sekilas harga GPT-6.2 Astra
GPT-6.2 Astra adalah model frontier OpenAI untuk proyek panjang dan berat: coding, penggunaan komputer, dan pekerjaan dokumen, dengan jendela konteks 1.050.000 token dan hingga 128.000 token output. Pada tingkat Standard, tarifnya $8 per 1M token input, $0,40 per 1M token input ter-cache, dan $40 per 1M token output, untuk prompt hingga 272K token.
| Tarif (per 1M token, Standard) | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
| Input | $8,00 | $2,00 | $10,00 |
| Input ter-cache | $0,40 | $0,10 | $1,00 |
| Penulisan cache (30 menit) | $10,00 | $2,50 | $12,50 |
| Penulisan cache (12 jam) | $20,00 | $5,00 | $25,00 |
| Output | $40,00 | $10,00 | $50,00 |
Token reasoning ditagih sebagai token output. Ini penting pada Astra, karena model menolak permintaan yang menetapkan reasoning effort ke none, sehingga setiap panggilan selalu membawa biaya reasoning di atas jawaban yang terlihat.
Biaya API GPT-6.2 Astra per token
Satu token input berharga $0,000008 dan satu token output berharga $0,00004. Output 5x lebih mahal dari input, jadi apa pun yang ditulis model, termasuk reasoning tersembunyi, menjadi penyumbang terbesar tagihan Anda.
Permintaan chat tipikal dengan 3.000 token input dan 800 token output berbiaya:
- GPT-6.2 Astra: $0,024 input + $0,032 output = $0,056
- GPT-6.2 Sol: $0,006 + $0,008 = $0,014
- GPT-6 Astra: $0,030 + $0,040 = $0,070
Skala ke aplikasi yang melayani 20.000 permintaan seperti itu per hari. Selama 30 hari berarti 600.000 permintaan: sekitar $33.600 di GPT-6.2 Astra, $8.400 di GPT-6.2 Sol, dan $42.000 di GPT-6 Astra. Sol mempertahankan harga daftar $2/$10 yang sama dengan GPT-6 Sol dan GPT-6.1 Sol, jadi jika Anda sudah menganggarkan untuk Sol, tidak ada yang berubah.
Harga cache GPT-6.2 Astra: perubahan terbesar
Pemotongan utamanya adalah 20%, tetapi pemotongan cache lebih besar. Pembacaan cache pada GPT-6.2 Astra berharga $0,40 per 1M, yaitu 0,05x dari tarif input. GPT-6 Astra mengenakan $1,00, atau 0,1x. Panduan prompt caching OpenAI mengonfirmasi bahwa tarif baca 0,05x berlaku untuk GPT-6.2 Astra, GPT-6.2 Sol, GPT-6.1 Sol, dan GPT-6.1 Terra.
Tiga aturan menentukan apa yang Anda bayar:
- Penulisan menggantikan input, tidak menumpuk. Token yang ditulis ke cache ditagih dengan tarif tulis, bukan tarif input, tidak pernah keduanya. Penulisan 30 menit berbiaya 1,25x input ($10 di Astra); penulisan 12 jam berbiaya 2,5x ($20).
- Prefix minimum adalah 1.024 token. Prompt yang lebih pendek tidak pernah di-cache.
- Pembacaan berbiaya sama untuk kedua masa berlaku. Pilih penulisan 12 jam hanya untuk system prompt dan dokumen referensi yang stabil dan dipakai berulang dalam jangka panjang.
Dengan tarif ini, caching menguntungkan sejak penggunaan ulang pertama. Satu penulisan 30 menit plus satu pembacaan berbiaya 1,30x dari harga tanpa cache sebuah prefix, dibandingkan 2x untuk mengirimkannya dua kali. Sepuluh permintaan berarti 1,70x dibandingkan 10x.
Simon Willison menyebut harga cache tersebut sebagai “kabar baik untuk sesi agentic yang berjalan lama” dalam tulisannya saat peluncuran. Untuk taktiknya, lihat panduan kami tentang GPT-6 prompt caching.
Berapa biaya sesi agent 50 giliran
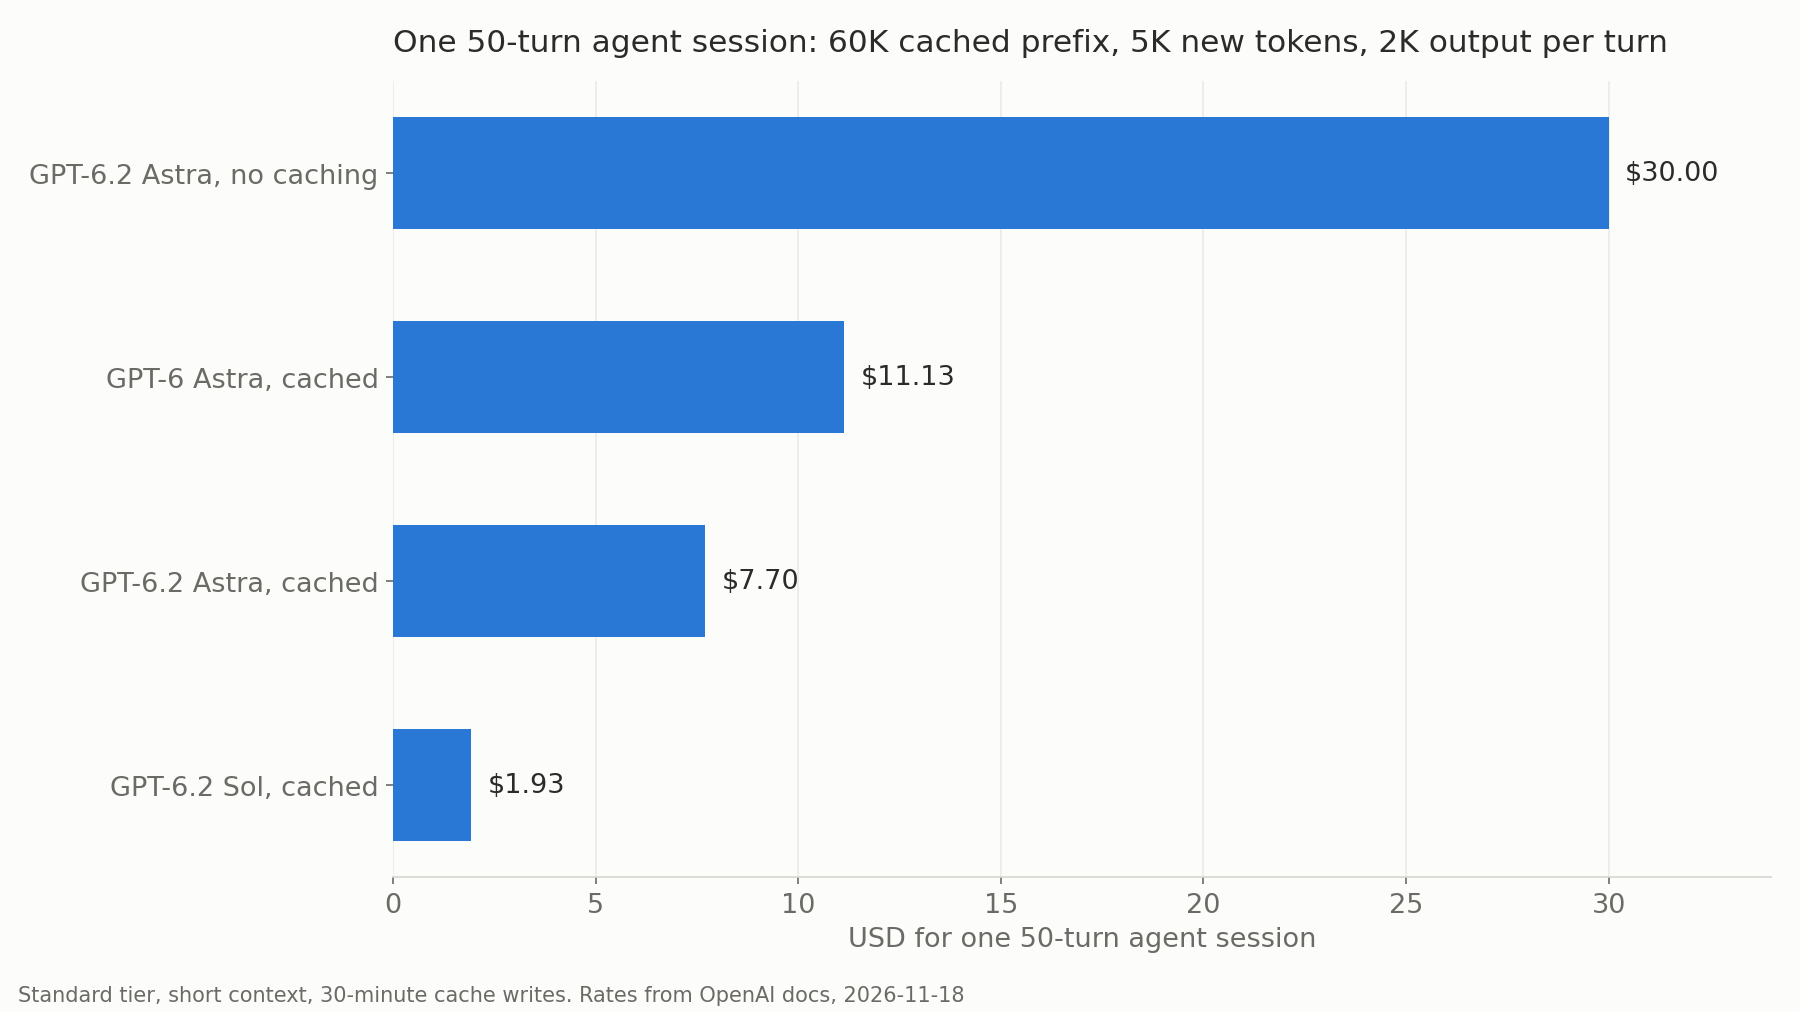
Ambil sebuah coding agent yang berjalan 50 giliran. Setiap giliran membaca ulang prefix 60K token dari cache, menulis 5K token baru ke cache 30 menit, dan menghasilkan 2K token output.
| Model dan pengaturan | Biaya per giliran | Biaya per sesi |
|---|---|---|
| GPT-6.2 Astra, tanpa caching | $0,600 | $30,00 |
| GPT-6 Astra, dengan cache | $0,223 | $11,13 |
| GPT-6.2 Astra, dengan cache | $0,154 | $7,70 |
| GPT-6.2 Sol, dengan cache | $0,039 | $1,93 |
Caching memangkas sesi GPT-6.2 Astra sebesar 74%. Dibandingkan GPT-6 Astra dengan caching yang sama, model baru ini 31% lebih murah per sesi, melebihi potongan daftar 20%, karena prefix yang di-cache adalah porsi terbesar dari input.
Harga konteks panjang di atas 272K token
GPT-6.2 Astra menerima hingga 922.000 token input, tetapi harganya berubah pada 272K. Setelah input sebuah permintaan melewati 272K token, tarif input dan cache menjadi dua kali lipat dan output naik ke 1,5x, untuk seluruh permintaan, bukan hanya bagian yang meluap.
| Tarif (per 1M token) | Hingga 272K input | Di atas 272K input |
|---|---|---|
| Input | $8,00 | $16,00 |
| Input ter-cache | $0,40 | $0,80 |
| Penulisan cache (30 menit) | $10,00 | $20,00 |
| Output | $40,00 | $60,00 |
Review codebase 400K token tunggal dengan 4K output berbiaya $6,40 + $0,24 = $6,64. Jika review yang sama dipangkas menjadi 250K token, biayanya turun menjadi $2,00 + $0,16 = $2,16. Jika Anda menjalankan review 400K berulang-ulang dengan 380K token dilayani dari cache dan 20K token baru ditulis, biayanya sekitar $0,94 per eksekusi.
Retrieval dan pemangkasan menguntungkan ketika sebuah prompt berada tepat di atas 272K.
Batch, jendela background, Fast, dan Ultrafast
Halaman harga OpenAI mencantumkan GPT-6.2 Astra di empat tingkat pemrosesan, ditambah jendela background dengan diskon. GPT-6.2 tidak muncul di tabel Flex, sehingga jendela background mengisi peran itu untuk pekerjaan yang bisa menunggu.
| Tingkat (konteks pendek) | Astra input / output | Sol input / output |
|---|---|---|
| Standard | $8 / $40 | $2 / $10 |
| Batch (diskon 50%) | $4 / $20 | $1 / $5 |
| Background, jendela 8 jam (diskon 40%) | $4,80 / $24 | $1,20 / $6 |
| Background, jendela 2 jam (diskon 30%) | $5,60 / $28 | $1,40 / $7 |
| Fast (2x) | $16 / $80 | $4 / $20 |
| Ultrafast, hingga 28 Feb 2027 (3x) | $24 / $120 | $6 / $30 |
| Ultrafast, mulai 1 Mar 2027 (6x) | $48 / $240 | $12 / $60 |
Jendela background adalah public beta di Responses API. Anda mengatur background ke true dan background_options.completion_window ke 2h atau 8h, dan membiarkan streaming dimatikan. Panduan mode background mencatat dua catatan penting: permintaan ini berbagi rate limit dengan Batch, dan permintaan Standard tidak dapat menggunakan ulang entri cache yang dibuat oleh permintaan 2h atau 8h.
Berikut pekerjaan malam hari yang meringkas 10.000 dokumen, masing-masing 4K token input dan 500 token output:
| Tingkat | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Standard | $520 | $130 |
| Background, 2 jam | $364 | $91 |
| Background, 8 jam | $312 | $78 |
| Batch | $260 | $65 |
Tarif 3x Ultrafast adalah promosi; pada 1 Maret 2027 tarif itu menjadi dua kali lipat menjadi 6x, jadi jangan mengandalkannya dalam anggaran Anda.
GPT-6.2 Astra vs GPT-6.2 Sol dan flagship rival
Astra berharga tepat 4x Sol di setiap baris. Halaman model Sol mencantumkan konteks 1.050.000 token yang sama, batas output 128.000 yang sama, alat yang sama, dan rate limit yang sama. Jadi pilihan itu bermuara pada kualitas per tugas, bukan fitur.
| Model (per 1M token) | Input | Baca cache | Output |
|---|---|---|---|
| GPT-6.2 Astra | $8,00 | $0,40 | $40,00 |
| Claude Fable 5.2 | $8,00 | $0,20 | $40,00 |
| Claude Opus 5.5 | $4,00 | $0,20 | $20,00 |
| GPT-6.2 Sol | $2,00 | $0,10 | $10,00 |
Harga Claude berasal dari halaman harga Anthropic, dicek pada 18 November 2026. GPT-6.2 Astra dan Claude Fable 5.2 berbagi harga daftar $8/$40 yang sama; cache hit Fable 5.2 berharga $0,20 dan tarif tulisnya mengikuti masa berlaku 5 menit dan 1 jam milik Anthropic, bukan 30 menit dan 12 jam milik OpenAI, jadi bandingkan biaya riil pada trafik Anda sendiri.
Ulasan awal mengenai kualitasnya beragam. Willison mencatat bahwa GPT-6.2 Astra “tidak mendapat skor setinggi Fable 5.2 di berbagai benchmark”, jadi jalankan evaluasi Anda sendiri sebelum berkomitmen. Jika Anda datang dari generasi sebelumnya, panduan API GPT-6 Astra kami membahas bentuk permintaannya, dan migrasi GPT-6 Astra ke Sol menjelaskan kapan model yang lebih murah sudah cukup.
Kedua model berbagi rate limit Standard yang sama: 5.000 permintaan dan 1M token per menit di tingkat Build, hingga 15.000 permintaan dan 40M token per menit di Grow.
Biar Codex memeriksa biaya GPT-6.2 Astra Anda dengan Apidog CLI
Tabel harga hanya berguna jika permintaan Anda benar-benar mengenai cache dan tetap di bawah 272K. Coding agent Anda bisa memeriksanya di setiap build dengan Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt kepada agent Anda:
Create an Apidog test case in project <id> for POST /v1/responses with model
gpt-6.2-astra. Send the same 2,000-token system prompt twice. Assert both calls
return 200, usage.input_tokens stays under 272000, and the second call reports
usage.input_tokens_details.cached_tokens above 0. Run it against the openai
environment and summarize any failures.
Agent membaca skema, memvalidasi payload-nya, membuat test case, dan menjalankannya:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Jika perubahan prompt merusak caching atau mendorong permintaan melewati 272K, eksekusi gagal sebelum tagihan datang. apidog run yang sama dengan -r junit bisa dipasang di CI; panduan pipeline CI/CD Apidog CLI kami menyediakan pengaturan tinggal salin-tempel, dan Apidog CLI di Codex membahas sisi agent. Paket Gratis Apidog mencakup hingga 4 pengguna.
FAQ
Berapa biaya GPT-6.2 Astra per 1M token? $8 per 1M token input, $0,40 per 1M token input ter-cache, dan $40 per 1M token output di tingkat Standard, untuk permintaan hingga 272K token input.
Apakah GPT-6.2 Astra lebih murah dari GPT-6 Astra? Ya. Input dan output 20% lebih rendah ($8/$40 vs $10/$50) dan pembacaan cache 60% lebih rendah ($0,40 vs $1,00). Sesi agent dengan cache kami jadi 31% lebih murah.
Berapa biaya GPT-6.2 Sol? $2 per 1M token input, $0,10 ter-cache, dan $10 output, harga daftar yang sama dengan GPT-6.1 Sol dan GPT-6 Sol. Ini seperempat harga Astra di setiap baris.
Apakah GPT-6.2 Astra mengenakan biaya lebih untuk prompt panjang? Ya. Di atas 272K token input, tarif input dan cache menjadi dua kali lipat dan output naik ke 1,5x untuk seluruh permintaan: $16 input, $0,80 ter-cache, dan $60 output per 1M token.
Bisakah saya mendapat diskon untuk GPT-6.2 Astra? Batch berbiaya 50% dari Standard. Permintaan background di Responses API mendapat diskon 30% dengan jendela 2 jam atau 40% dengan jendela 8 jam (public beta). Caching memangkas prefix yang berulang menjadi 0,05x tarif input.
Apakah token reasoning dihitung dalam tagihan GPT-6.2 Astra? Ya. Token reasoning ditagih dengan tarif output $40 per 1M, dan model menolak reasoning effort none, jadi siapkan anggaran untuk reasoning di setiap panggilan.