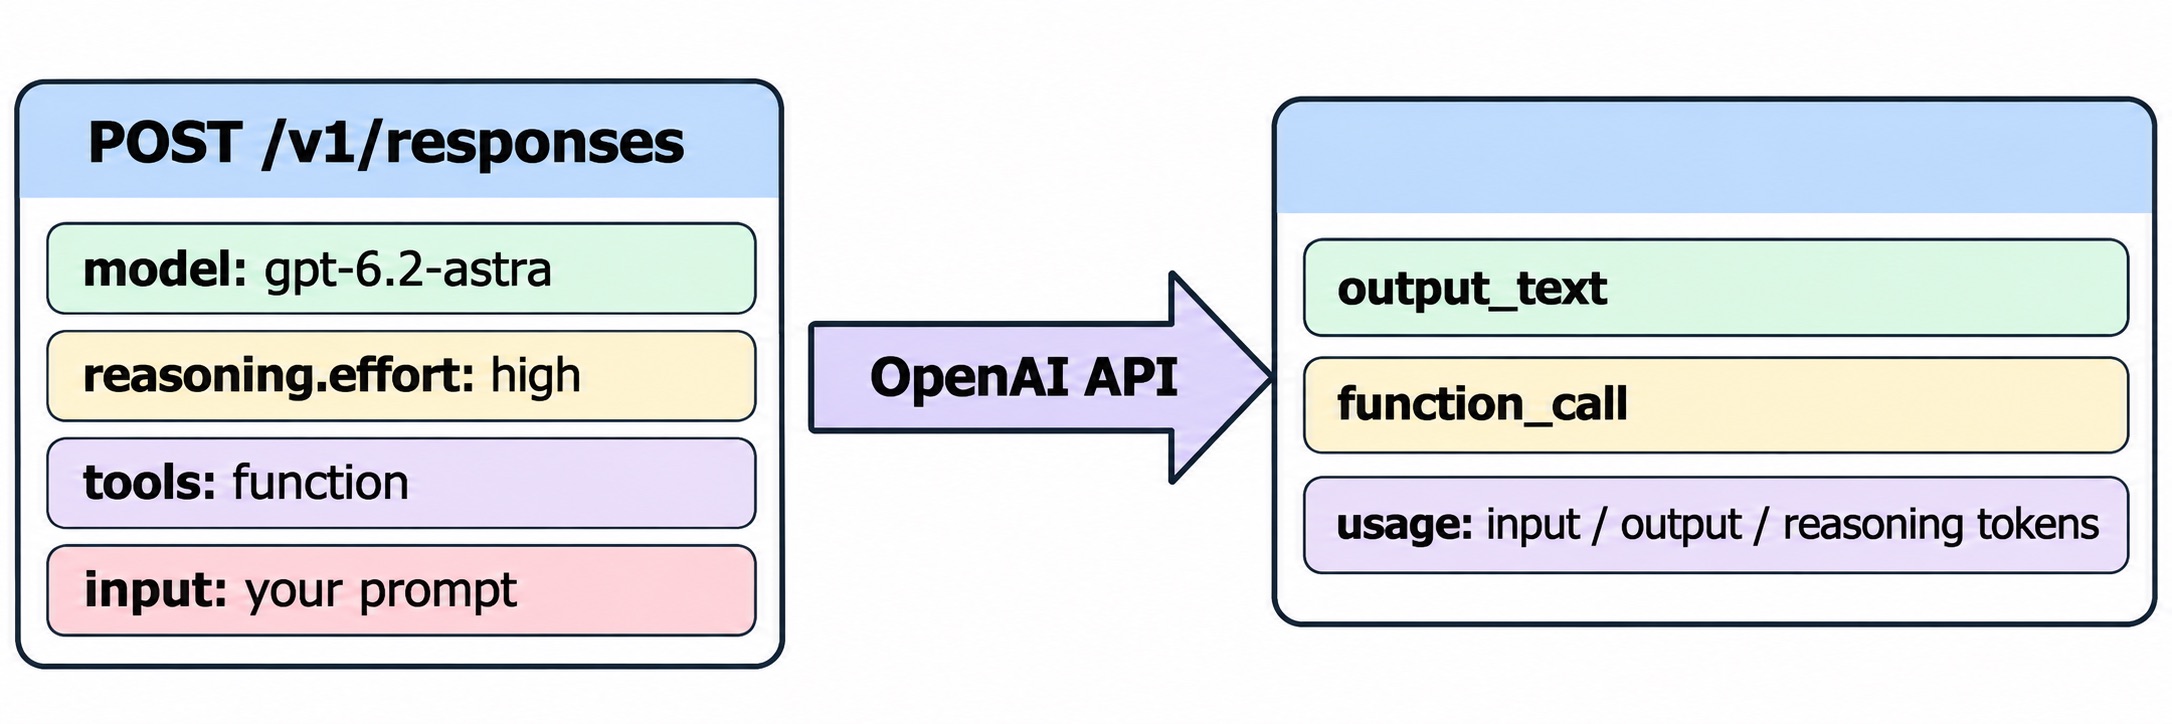
Jawaban singkat: Untuk menggunakan API GPT-6.2 Astra, kirimkan request ke endpoint Responses milik OpenAI (POST /v1/responses) dengan "model": "gpt-6.2-astra", tingkat reasoning seperti "high", dan input Anda. Harganya $8 per juta token input dan $40 per juta token output, menerima hingga 922K token input dan mengembalikan hingga 128K. Jangan atur effort ke none: API akan menolaknya.
OpenAI merilis GPT-6.2 Astra dan saudara lebih murahnya, GPT-6.2 Sol, pada 17 November 2026. Jika Anda pernah memanggil GPT-6 Astra sebelumnya, sebagian besar kode Anda tetap bisa digunakan. Panduan ini membahas API GPT-6.2 Astra mulai dari request pertama, pemanggilan tool, penyetelan effort, jebakan harga, hingga pengujian berulang yang bisa dijalankan oleh coding agent Anda.
Yang perlu Anda siapkan sebelum panggilan API GPT-6.2 Astra pertama
Anda membutuhkan empat hal, dan kemungkinan besar tiga di antaranya sudah Anda miliki:
- Kunci API OpenAI dari dashboard platform, diekspor sebagai
OPENAI_API_KEY. - Usage tier berbayar. Halaman model OpenAI mencantumkan rate limit Astra mulai dari tier Build (5.000 request dan 1M token per menit).
- Model ID
gpt-6.2-astra. Model yang lebih murah adalahgpt-6.2-sol. - Endpoint yang didukung: Responses, Chat Completions, atau Batch. Realtime, Assistants, dan fine-tuning tidak mendukung kedua model ini.
Spesifikasi ini berasal dari halaman model GPT-6.2 Astra milik OpenAI, dicek pada 18 November 2026.
| Spesifikasi | GPT-6.2 Astra |
|---|---|
| Model ID | gpt-6.2-astra |
| Jendela konteks | 1.050.000 token |
| Input maksimum | 922.000 token |
| Output maksimum | 128.000 token |
| Batas pengetahuan | 18 Mei 2026 |
| Endpoint | Responses, Chat Completions, Batch |
| Fitur | Streaming, function calling, structured outputs, input gambar, prompt caching |
Cara membuat request API GPT-6.2 Astra pertama Anda
API Responses adalah endpoint yang terus dikembangkan OpenAI dengan fitur-fitur baru, jadi mulailah dari sana. Berikut langkah-langkahnya:
- Ekspor kunci Anda:
export OPENAI_API_KEY=sk-... - Kirim request dengan model ID dan tingkat effort.
- Baca
output_textuntuk jawaban danusageuntuk jumlah token.
Dengan curl:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.2-astra",
    "reasoning": { "effort": "high" },
    "input": "Review this migration plan and list the three biggest risks."
  }'
Dengan SDK Python resmi (pip install --upgrade openai):
from openai import OpenAI

client = OpenAI()  # reads OPENAI_API_KEY

response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    input="Review this migration plan and list the three biggest risks.",
)

print(response.output_text)
print(response.usage)
Dengan Node.js (npm install openai):
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.2-astra",
  reasoning: { effort: "high" },
  input: "Review this migration plan and list the three biggest risks.",
});

console.log(response.output_text);
Periksa blok usage pada setiap panggilan awal. Astra memakai token reasoning sebelum menulis satu kata pun, dan token tersebut ditagih sebagai output. Jawaban yang singkat tetap bisa berbiaya lebih besar dari perkiraan Anda.
Memilih reasoning effort untuk GPT-6.2 Astra
Reasoning effort adalah faktor terbesar yang memengaruhi kualitas dan biaya. Panduan reasoning OpenAI mencantumkan nilai none, minimal, low, medium, high, xhigh, dan max, serta menyatakan bahwa setiap model hanya mendukung sebagian dari nilai tersebut. Untuk GPT-6.2 Astra dan Sol, satu aturan yang terkonfirmasi adalah none ditolak, sehingga setiap panggilan selalu melakukan reasoning.
| Effort | Gunakan untuk |
|---|---|
low / medium |
Edit sederhana, ekstraksi, jawaban singkat |
high |
Code review, perencanaan, sebagian besar prompt sulit. Default yang masuk akal untuk mulai pengujian |
xhigh |
Agent run panjang dan pekerjaan asinkron, hanya jika eval menunjukkan keuntungan yang jelas |
max |
Masalah tersulit Anda, di mana jawaban yang lebih baik sebanding dengan beberapa kali lipat biaya token |
OpenAI tidak menyatakan effort default Astra, jadi aturlah secara eksplisit di setiap request. Ini menjaga tagihan dan hasil pengujian Anda tetap dapat direproduksi.
Berapa besar pengaruh effort terhadap tagihan? Simon Willison menjalankan prompt gambar yang sama pada setiap model dengan tiga tingkat effort pada hari peluncuran dan mempublikasikan biayanya. Astra berbiaya 11,55 sen pada high, 17,70 sen pada xhigh, dan 88,71 sen pada max. Dari high ke max, biayanya melonjak hampir delapan kali lipat.
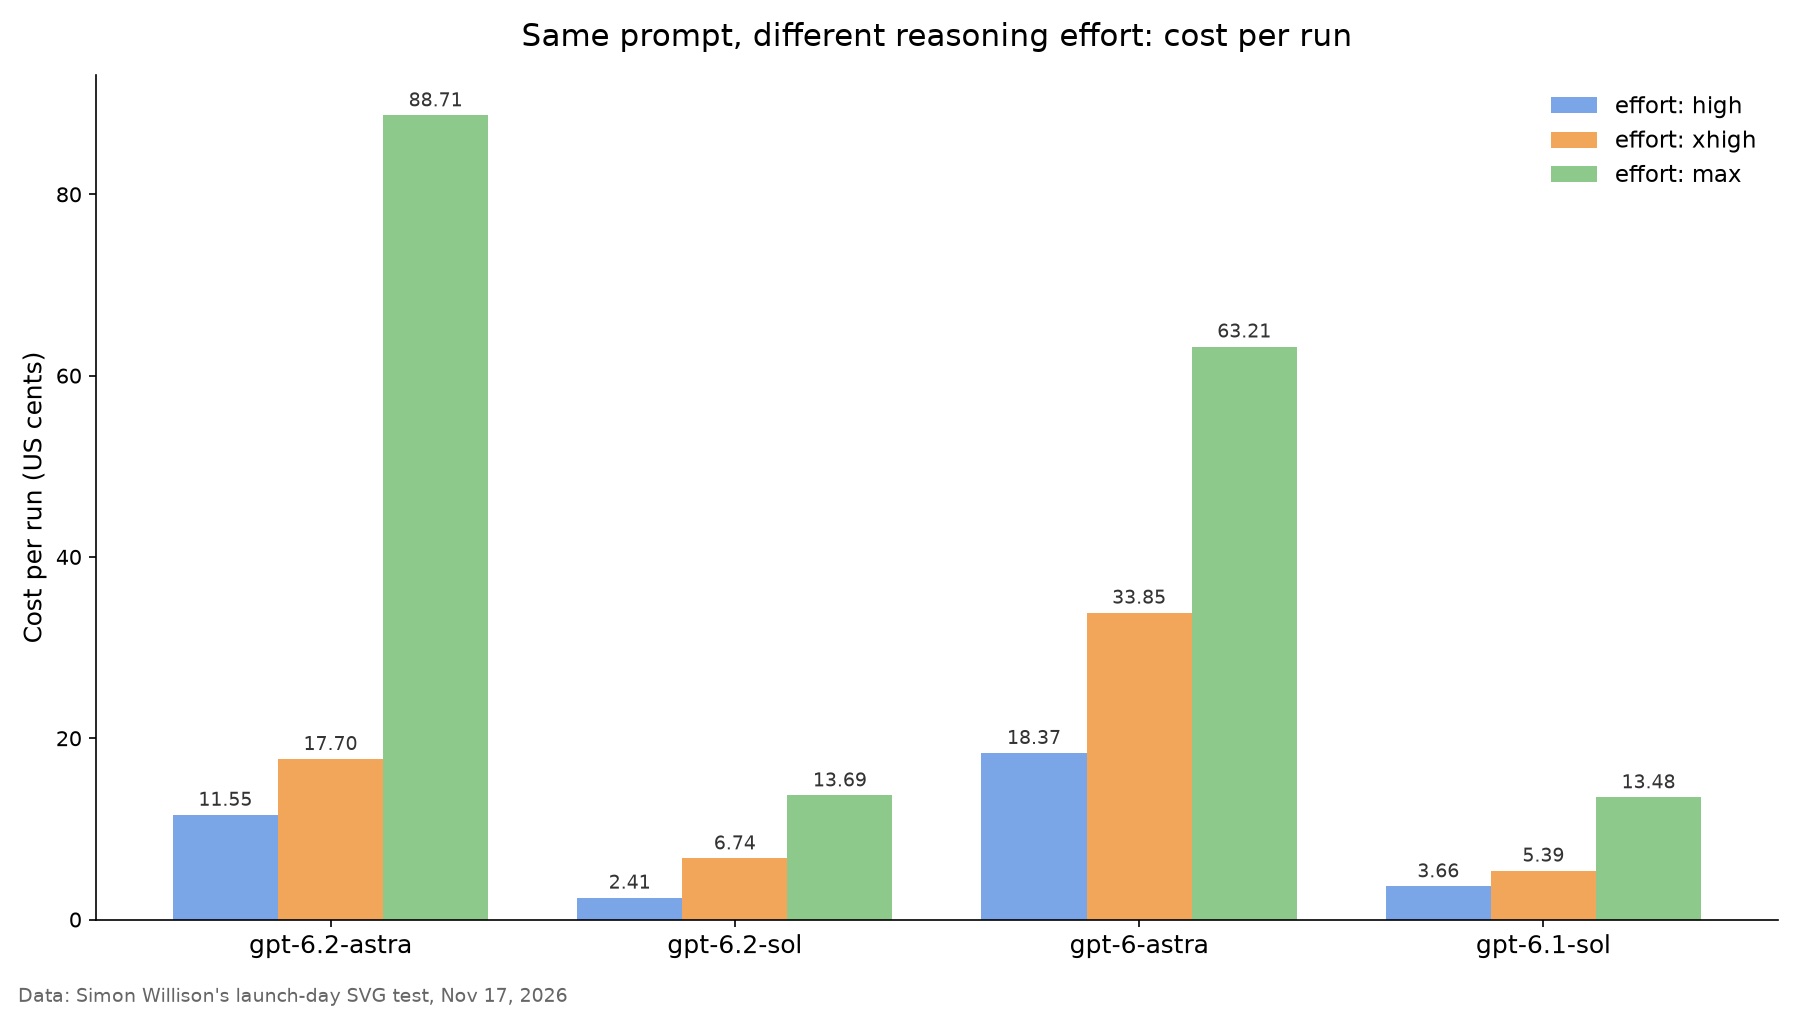
Perhatikan bahwa GPT-6.2 Astra lebih murah daripada GPT-6 Astra pada high dan xhigh, tetapi lebih mahal pada max. Harga per token turun 20%, namun effort max berpikir lebih lama. Ukur biaya per tugas yang selesai, bukan biaya per juta token.
Menggunakan tools dan structured outputs dengan API GPT-6.2 Astra
Astra mendukung function calling, structured outputs, dan daftar panjang hosted tools di API Responses: web search, file search, image generation, code interpreter, hosted shell, apply patch, skills, computer use, MCP, dan tool search.
Function tool tampak sama seperti pada GPT-6 Astra:
response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    tools=[{
        "type": "function",
        "name": "get_order_status",
        "description": "Look up an order by its ID.",
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"],
        },
    }],
    input="Where is order A-1042?",
)

for item in response.output:
    if item.type == "function_call":
        print(item.name, item.arguments)
Jalankan fungsi tersebut sendiri, lalu kirimkan hasilnya kembali sebagai item function_call_output dengan call_id yang cocok. Astra akan menulis jawaban akhir dari situ.
Untuk output yang dapat dibaca mesin, berikan skema JSON di text.format dengan "type": "json_schema" dan "strict": true. Model kemudian mengembalikan JSON yang sesuai dengan skema Anda, sehingga Anda bisa mem-parsingnya tanpa menebak-nebak.
Dua kebiasaan membantu dengan model sekapabel ini. Pertama, berikan setiap tool deskripsi yang ringkas dan skema yang ketat; para pengulas pada hari peluncuran melaporkan bahwa Astra bisa tersesat pada tugas panjang yang terbuka. Kedua, atur max_output_tokens pada agent loop agar satu langkah yang tidak terkendali tidak menghabiskan anggaran Anda. Untuk latar belakang tentang endpoint itu sendiri, lihat panduan OpenAI Responses API kami.
Harga dan rate limit API GPT-6.2 Astra
Harga Astra dihitung per juta token, dengan biaya tambahan untuk prompt yang sangat panjang. Tarif berikut berasal dari halaman model:
| Item | GPT-6.2 Astra | GPT-6 Astra (untuk perbandingan) |
|---|---|---|
| Input | $8.00 | $10.00 |
| Cached input | $0.40 | $1.00 |
| Penulisan cache (retensi 30 menit) | $10.00 | tidak tersedia |
| Output | $40.00 | $50.00 |
Jebakannya ada pada aturan konteks panjang. Begitu sebuah request melebihi 272K token input, tarif input dan cache berlipat dua serta output berbiaya 1,5x untuk seluruh request tersebut. Prompt 300K token ditagih $16 input dan $60 output, bukan hanya token yang melewati batas. Jika Anda memasukkan seluruh repositori ke Astra, pecah atau gunakan cache di bawah 272K bila memungkinkan.
Job Batch cocok untuk eval dan backfill yang bisa menunggu; VentureBeat melaporkan Batch berjalan dengan harga setengah.
Rate limit standar per tier:
| Tier | Request/menit | Token/menit |
|---|---|---|
| Build | 5.000 | 1.000.000 |
| Launch | 10.000 | 4.000.000 |
| Grow | 15.000 | 40.000.000 |
Tangani respons 429 dengan exponential backoff. Satu agent run panjang pada xhigh bisa menghabiskan kuota token tier Build dengan cepat.
Migrasi dari GPT-6 Astra ke GPT-6.2 Astra
Sebagian besar kode hanya memerlukan satu perubahan: string model. Sebelum Anda mengaktifkannya di production, periksa hal-hal berikut:
- Model ID:
gpt-6-astramenjadigpt-6.2-astra. - Effort
none: jika ada jalur kode yang mengirimkannya, sekarang akan gagal. Gunakan nilai terendah yang diterima oleh eval Anda. - Prompt caching: harga cached input turun dari $1,00 menjadi $0,40, jadi system prompt dan daftar tool yang stabil kini layak di-cache.
- Prompt panjang: periksa ulang request yang mendekati 272K token terhadap aturan konteks panjang di atas.
- Keamanan: OpenAI menyatakan kedua model GPT-6.2 mencapai ambang keamanan siber "Critical" dan dilengkapi pengaman yang lebih ketat. Prompt untuk tool keamanan mungkin mendapatkan penolakan yang sebelumnya tidak muncul.
Ulasan awal beragam, jadi lakukan pengujian sebelum beralih. Ethan Mollick menyebut Astra "sangat tidak konsisten & aneh," dan Dan Shipper mengatakan ia sering berhenti terlalu dini pada build end-to-end, menurut rangkuman VentureBeat. Yang lain memuji kemampuan code review dan computer use-nya. Prompt Anda sendirilah tolok ukur satu-satunya yang benar-benar penting. Panduan API GPT-6 Astra membahas apa saja yang tetap berlaku dari generasi sebelumnya, dan jika sebagian besar trafik Anda bersifat rutin, panduan API GPT-6.1 Sol menunjukkan bentuk request dari tier yang lebih murah.
Minta coding agent Anda menguji GPT-6.2 Astra dengan Apidog CLI
Menempelkan prompt ke terminal hanya memberi tahu Anda performa Astra hari ini. Itu tidak akan memberi tahu Anda ketika sebuah pembaruan merusak skema Anda bulan depan. Sebaiknya minta coding agent Anda membangun pemeriksaan tersebut dan menjalankannya dengan Apidog CLI; Anda cukup menulis satu prompt.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Kemudian berikan satu prompt kepada Claude Code, Codex, atau Cursor:
In Apidog project <projectId>, create a test case for POST https://api.openai.com/v1/responses
with model "gpt-6.2-astra", reasoning effort "high" and a get_order_status function tool.
Assert status 200, that the output contains a function_call named get_order_status,
that its arguments parse as JSON with an order_id, and that usage.output_tokens is under 4000.
Read the API key from the OPENAI_API_KEY variable in environment <envId>, then run it.
Agent akan membaca skema payload, memeriksa filenya, membuat test case, dan menjalankannya:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Simpan kunci di environment Apidog, bukan di dalam prompt, agar kunci itu tidak pernah berada di konteks agent Anda. Tambahkan --upload-report untuk meninjau hasil run di aplikasi Apidog, atau -n 5 untuk mengulanginya dan melihat seberapa stabil tool call Astra. Masukkan -r junit ke dalam pipeline dan pemeriksaan akan dijalankan ulang di setiap deploy; panduan Apidog CLI dalam CI/CD menunjukkan penyetelannya, dan Apidog CLI di Claude Code membahas sisi agent-nya. Paket Gratis Apidog mencakup tim hingga 4 pengguna.
FAQ
Berapa model ID API GPT-6.2 Astra? gpt-6.2-astra. Saudara lebih murahnya adalah gpt-6.2-sol. Keduanya berfungsi pada endpoint Responses, Chat Completions, dan Batch.
Berapa biaya API GPT-6.2 Astra? $8 per juta token input, $0,40 per juta token cached input, dan $40 per juta token output. Request dengan lebih dari 272K token input dikenakan biaya input dua kali lipat dan output 1,5x untuk seluruh request.
Mengapa request GPT-6.2 Astra saya gagal dengan reasoning effort none? Kedua model GPT-6.2 menolak "effort": "none". Gunakan high, atau tingkat terendah yang menurut pengujian Anda cocok untuk tugas Anda.
Berapa jendela konteks GPT-6.2 Astra? 1.050.000 token secara total, dengan hingga 922.000 token input dan 128.000 token output.
Bisakah saya menggunakan GPT-6.2 Astra dengan API Chat Completions? Ya. Ini didukung, tetapi hosted tools seperti web search, computer use, dan apply patch tercantum untuk API Responses, jadi gunakan Responses untuk pekerjaan agent.
Apakah GPT-6.2 Astra tersedia gratis? Tidak di API; setiap panggilan ditagih. Di ChatGPT Work dan Codex, ia termasuk dalam paket Plus, Pro, Enterprise, dan Edu, menurut pengumuman peluncuran OpenAI.