
Z.ai kini menjual dua model dengan nama yang hampir sama, jendela konteks 1M-token yang sama, dan perbedaan harga sembilan kali lipat di antara keduanya. Penamaan tersebut tidak membantu Anda memilih. “Flash” menyiratkan varian yang lebih kecil, lebih cepat, lebih lemah, dan hanya satu dari tiga kata itu yang akurat.
Berikut versi singkatnya: GLM-5.3-Flash lebih murah, menangani gambar secara native, dan memberikan kuota tiga kali lipat kepada pengguna paket coding. GLM-5.3 sedikit lebih pintar dan menghasilkan hampir dua kali lebih cepat. Untuk sebagian besar beban kerja, Flash adalah pilihan default yang tepat dan beban pembuktian ada pada pemilihan yang mahal.
Posting ini membahas di mana aturan tersebut rusak.
Tabel perbandingan
| GLM-5.3-Flash | GLM-5.3 | |
|---|---|---|
| Indeks Intelijen (Analisis Buatan) | 57 | 60 |
| Harga gabungan per 1 juta token | $0.10 | $0.90 |
| Daftar input / output per 1 juta | $0.15 / $0.50 | $1.40 / $4.40 |
| Kecepatan output | ~49 token/detik | ~86 token/detik |
| Waktu hingga token pertama | 1.52s | 1.57s |
| Jendela konteks | 1.048.576 | 1.048.576 |
| Input gambar native | Ya | Tidak, berbasis adaptor |
| Parameter | 320B total / 18B aktif | Lebih besar, tidak sepenuhnya diungkapkan |
| Lisensi | MIT, bobot terbuka | Bobot terbuka |
| Kuota Paket Coding | 3x | 1x |
Angka kecepatan dan intelijen adalah pengukuran Analisis Buatan. Harga adalah daftar Z.ai, sebelum diskon peluncuran yang dibahas di bawah ini.
Dari mana kesenjangan harga sembilan kali lipat berasal
GLM-5.3-Flash adalah model mixture-of-experts 320B yang mengaktifkan 18B parameter per token, dibangun di atas basis baru dengan perhatian hibrida linier dan sparse. Z.ai melaporkan komputasi perhatian kira-kira tiga kali lebih sedikit dibandingkan GLM-5.3 dan cache KV sekitar 4,4 kali lebih kecil.
Ukuran cache KV adalah hal yang membuat penyediaan konteks panjang menjadi mahal. Menguranginya hingga 4,4x adalah sebagian besar alasan Z.ai dapat menawarkan jendela 1 juta token dengan harga sepersepuluh. Anda tidak membayar lebih sedikit untuk konteks yang lebih pendek atau model yang lebih lemah. Anda membayar lebih sedikit karena jejak penyediaan per permintaan benar-benar lebih kecil.
Itu adalah hasil rekayasa nyata, bukan diskon promosi, yang penting untuk mengetahui apakah harga tersebut bertahan.
Apa arti kesenjangan intelijen tiga poin
57 banding 60 pada Indeks Intelijen Analisis Buatan adalah celah sempit dalam istilah absolut. Sebagai kalibrasi, model bobot terbuka rata-rata dengan ukuran sebanding mencetak 27, jadi keduanya berada jauh di atas lapangan.
Namun, tiga poin bukanlah apa-apa. Kesenjangan indeks sebesar itu biasanya muncul sebagai: kinerja yang sedikit lebih buruk pada rantai penalaran multi-langkah, sedikit lebih banyak penyimpangan pada tugas agen yang sangat panjang, dan lebih banyak sensitivitas terhadap instruksi yang ambigu. Mereka jarang muncul pada ekstraksi, klasifikasi, ringkasan, atau pengeditan kode satu file yang lugas.
Uji praktisnya adalah apakah tugas Anda memiliki jawaban yang dapat diverifikasi. Jika Anda dapat memeriksa output secara terprogram, kesalahan sesekali Flash murah untuk ditangkap dan murah untuk dicoba lagi, dan dengan sepersembilan harga, Anda dapat mencoba lagi berkali-kali. Jika tugas Anda menghasilkan prosa yang harus dibaca dan dinilai oleh manusia, perbedaan kualitas lebih sulit untuk dipulihkan dan kesenjangan harga kurang penting dibandingkan hasilnya.
Kecepatan adalah satu-satunya area di mana Flash benar-benar kalah
Ini adalah bagian di mana namanya salah. GLM-5.3 menghasilkan sekitar 86 token per detik. GLM-5.3-Flash menghasilkan sekitar 49. Model yang lebih besar, lebih mahal, hampir dua kali lebih cepat dalam menghasilkan output.
Waktu hingga token pertama secara efektif imbang, yaitu 1,52 berbanding 1,57 detik, sehingga keduanya terasa sama responsif pada awal respons.
Konsekuensinya sepenuhnya tergantung pada panjang output:
- Respons singkat. Tidak relevan. Keduanya mulai dalam sekitar 1,5 detik dan selesai sebelum ada yang menyadari perbedaan throughput.
- Generasi panjang. Respons 4.000 token membutuhkan sekitar 82 detik pada Flash dan sekitar 47 pada GLM-5.3. Dalam alat interaktif, itu adalah celah yang signifikan.
- Pekerjaan batch dengan konkurensi. Juga sebagian besar tidak relevan, karena Anda melakukan skala dengan permintaan paralel daripada kecepatan per-stream, dan perbedaan harga membeli banyak paralelisme.
Jika Anda melakukan streaming output bentuk panjang kepada seseorang yang sedang menunggu, GLM-5.3 adalah pengalaman yang lebih baik. Itu adalah alasan paling jelas untuk membayar sembilan kali lebih banyak.
Multimodalitas adalah garis pemisah yang sebenarnya
GLM-5.3-Flash menerima gambar, video, dan file sebagai blok konten dalam permintaan penyelesaian obrolan yang sama dengan teks Anda. GLM-5.3 tidak melakukan ini secara native; visi melalui adaptor terpisah.
Jika aplikasi Anda membutuhkan model untuk melihat sesuatu, ini bukan perbandingan, ini adalah persyaratan. Flash adalah satu-satunya dari keduanya yang melakukannya dalam satu panggilan, dalam satu jendela konteks, pada satu baris tagihan.
Kemampuan itu dikombinasikan dengan konteks 1 juta dengan cara yang benar-benar baru untuk keluarga model ini: dokumen spesifikasi panjang dan tangkapan layar hasil yang dibuat dapat menempati prompt yang sama. Posisi Z.ai sendiri berbicara tentang mengamati antarmuka dan merender hasil, yang merupakan kerangka agen coding daripada captioning gambar.
Panduan visi kami mencakup payload dan alur kerja. Model visi khusus yang lebih lama dibahas dalam panduan API GLM-5V-Turbo jika Anda memelihara sesuatu yang dibangun di jalur tersebut.
Sudut pandang paket coding
Bagi pelanggan GLM Coding Plan, perhitungannya berbeda dan lebih sederhana. Flash termasuk dalam paket dan dilaporkan membawa tiga kali lipat kuota yang dapat digunakan dari GLM-5.3. Z.ai juga mencatat bahwa panggilan di luar jam sibuk mengkonsumsi setengah dari poin standar.
Jika Anda menjalankan Claude Code atau Cline terhadap kuota paket Anda, tiga kali lipat permintaan untuk penurunan indeks tiga poin adalah pertukaran yang mudah untuk pekerjaan rutin. Simpan GLM-5.3 untuk masalah sulit dan biarkan Flash menyerap volumenya. Pengaturan untuk kedua harness ada di panduan Claude Code dan Cline kami.
Verifikasi pengganda kuota di z.ai sebelum membuat rencana berdasarkan itu, karena ketentuan paket berubah lebih sering daripada spesifikasi model.
Batas waktu harga
Diskon peluncuran 50% untuk GLM-5.3-Flash berlaku hingga 9 September 2026. Sampai saat itu, tarif efektif adalah $0,075 input dan $0,25 output per juta, yang memperlebar kesenjangan terhadap GLM-5.3 menjadi kira-kira delapan belas kali lipat.
Setelah kedaluwarsa, harga daftar $0,15 dan $0,50 berlaku dan kesenjangan kembali menjadi sekitar sembilan kali lipat. Bagaimanapun, Flash jauh lebih murah. Batas waktu penting untuk mengunci proyeksi biaya, bukan untuk pilihan antara kedua model. Analisis harga kami memiliki angka-angka yang dihitung.
Aturan keputusan
Gunakan GLM-5.3-Flash ketika:
- Input Anda mencakup gambar, video, atau file.
- Biaya per token adalah batasan yang Anda optimalkan.
- Anda menjalankan ekstraksi, klasifikasi, atau perutean volume tinggi.
- Anda menggunakan Paket Coding dan ingin kuota Anda lebih jauh.
- Anda menginginkan bobot terbuka berlisensi MIT yang dapat Anda host sendiri. Menjalankannya secara lokal mencakup perangkat kerasnya.
Gunakan GLM-5.3 ketika:
- Anda melakukan streaming respons panjang kepada manusia yang menunggu dan throughput adalah pengalaman yang dirasakan.
- Pekerjaan Anda adalah penalaran jangka panjang di mana tiga poin indeks menumpuk di setiap langkah.
- Kualitas output dinilai oleh seseorang daripada diperiksa oleh tes.
Gunakan keduanya ketika: Anda dapat melakukan perutean. Kirim sebagian besar lalu lintas ke Flash dan eskalasikan ke GLM-5.3 pada kegagalan, kepercayaan rendah, atau jenis tugas. Kesenjangan harga sembilan kali lipat membuat router layak dibangun, dan karena kedua model berada di belakang endpoint yang kompatibel dengan OpenAI yang sama, perutean adalah pertukaran ID model daripada integrasi.
Migrasi di antara keduanya
Jika Anda sudah menggunakan GLM-5.3 dan mengevaluasi untuk pindah, bagian mekanisnya sepele dan bagian validasi adalah tempat pekerjaan itu berada.
Apa yang tidak berubah. URL dasar, skema autentikasi, bentuk permintaan dan respons, semantik streaming, dan skema panggilan alat. Kedua model berada di belakang permukaan yang kompatibel dengan OpenAI yang sama. Pertukaran adalah string ID model.
Apa yang berubah. Biaya per panggilan turun kira-kira sembilan kali lipat. Generasi melambat kira-kira setengahnya. Kualitas penalaran bergeser sebanyak tiga poin indeks. Dan Anda mendapatkan input gambar yang sebelumnya tidak tersedia.
Apa yang harus diperiksa sebelum berkomitmen. Jalankan prompt Anda yang sebenarnya melalui keduanya dan bandingkan pada empat sumbu: kebenaran output pada kasus yang dapat Anda verifikasi, latensi end-to-end termasuk waktu generasi daripada hanya token pertama, jumlah token dari objek usage pada setiap respons, dan perilaku pada konteks realistis terpanjang Anda.
Yang keempat menangkap masalah paling banyak. Model yang terlihat setara pada prompt pendek dapat menyimpang secara signifikan ketika konteks penuh, dan tabel benchmark tidak akan pernah memberi tahu Anda hal itu tentang data Anda sendiri.
Jika Anda memulai dengan model dasar, apa itu GLM-5.3 mencakupnya dengan caranya sendiri, dan panduan API GLM-5.3 memiliki pengaturan yang Anda migrasikan.
Uji saja daripada percaya tabel
Setiap angka di atas adalah klaim vendor atau benchmark pihak ketiga yang dijalankan pada beban kerja orang lain. Tidak ada yang memberi tahu Anda bagaimana kedua model ini berperilaku pada prompt Anda.
Pertukaran adalah satu string. Arahkan klien yang kompatibel dengan OpenAI ke https://api.z.ai/api/paas/v4/, jalankan prompt Anda yang sebenarnya melalui glm-5.3-flash dan glm-5.3, dan bandingkan output, latensi, dan jumlah token pada lalu lintas yang Anda pedulikan. Panduan API memiliki pengaturannya.
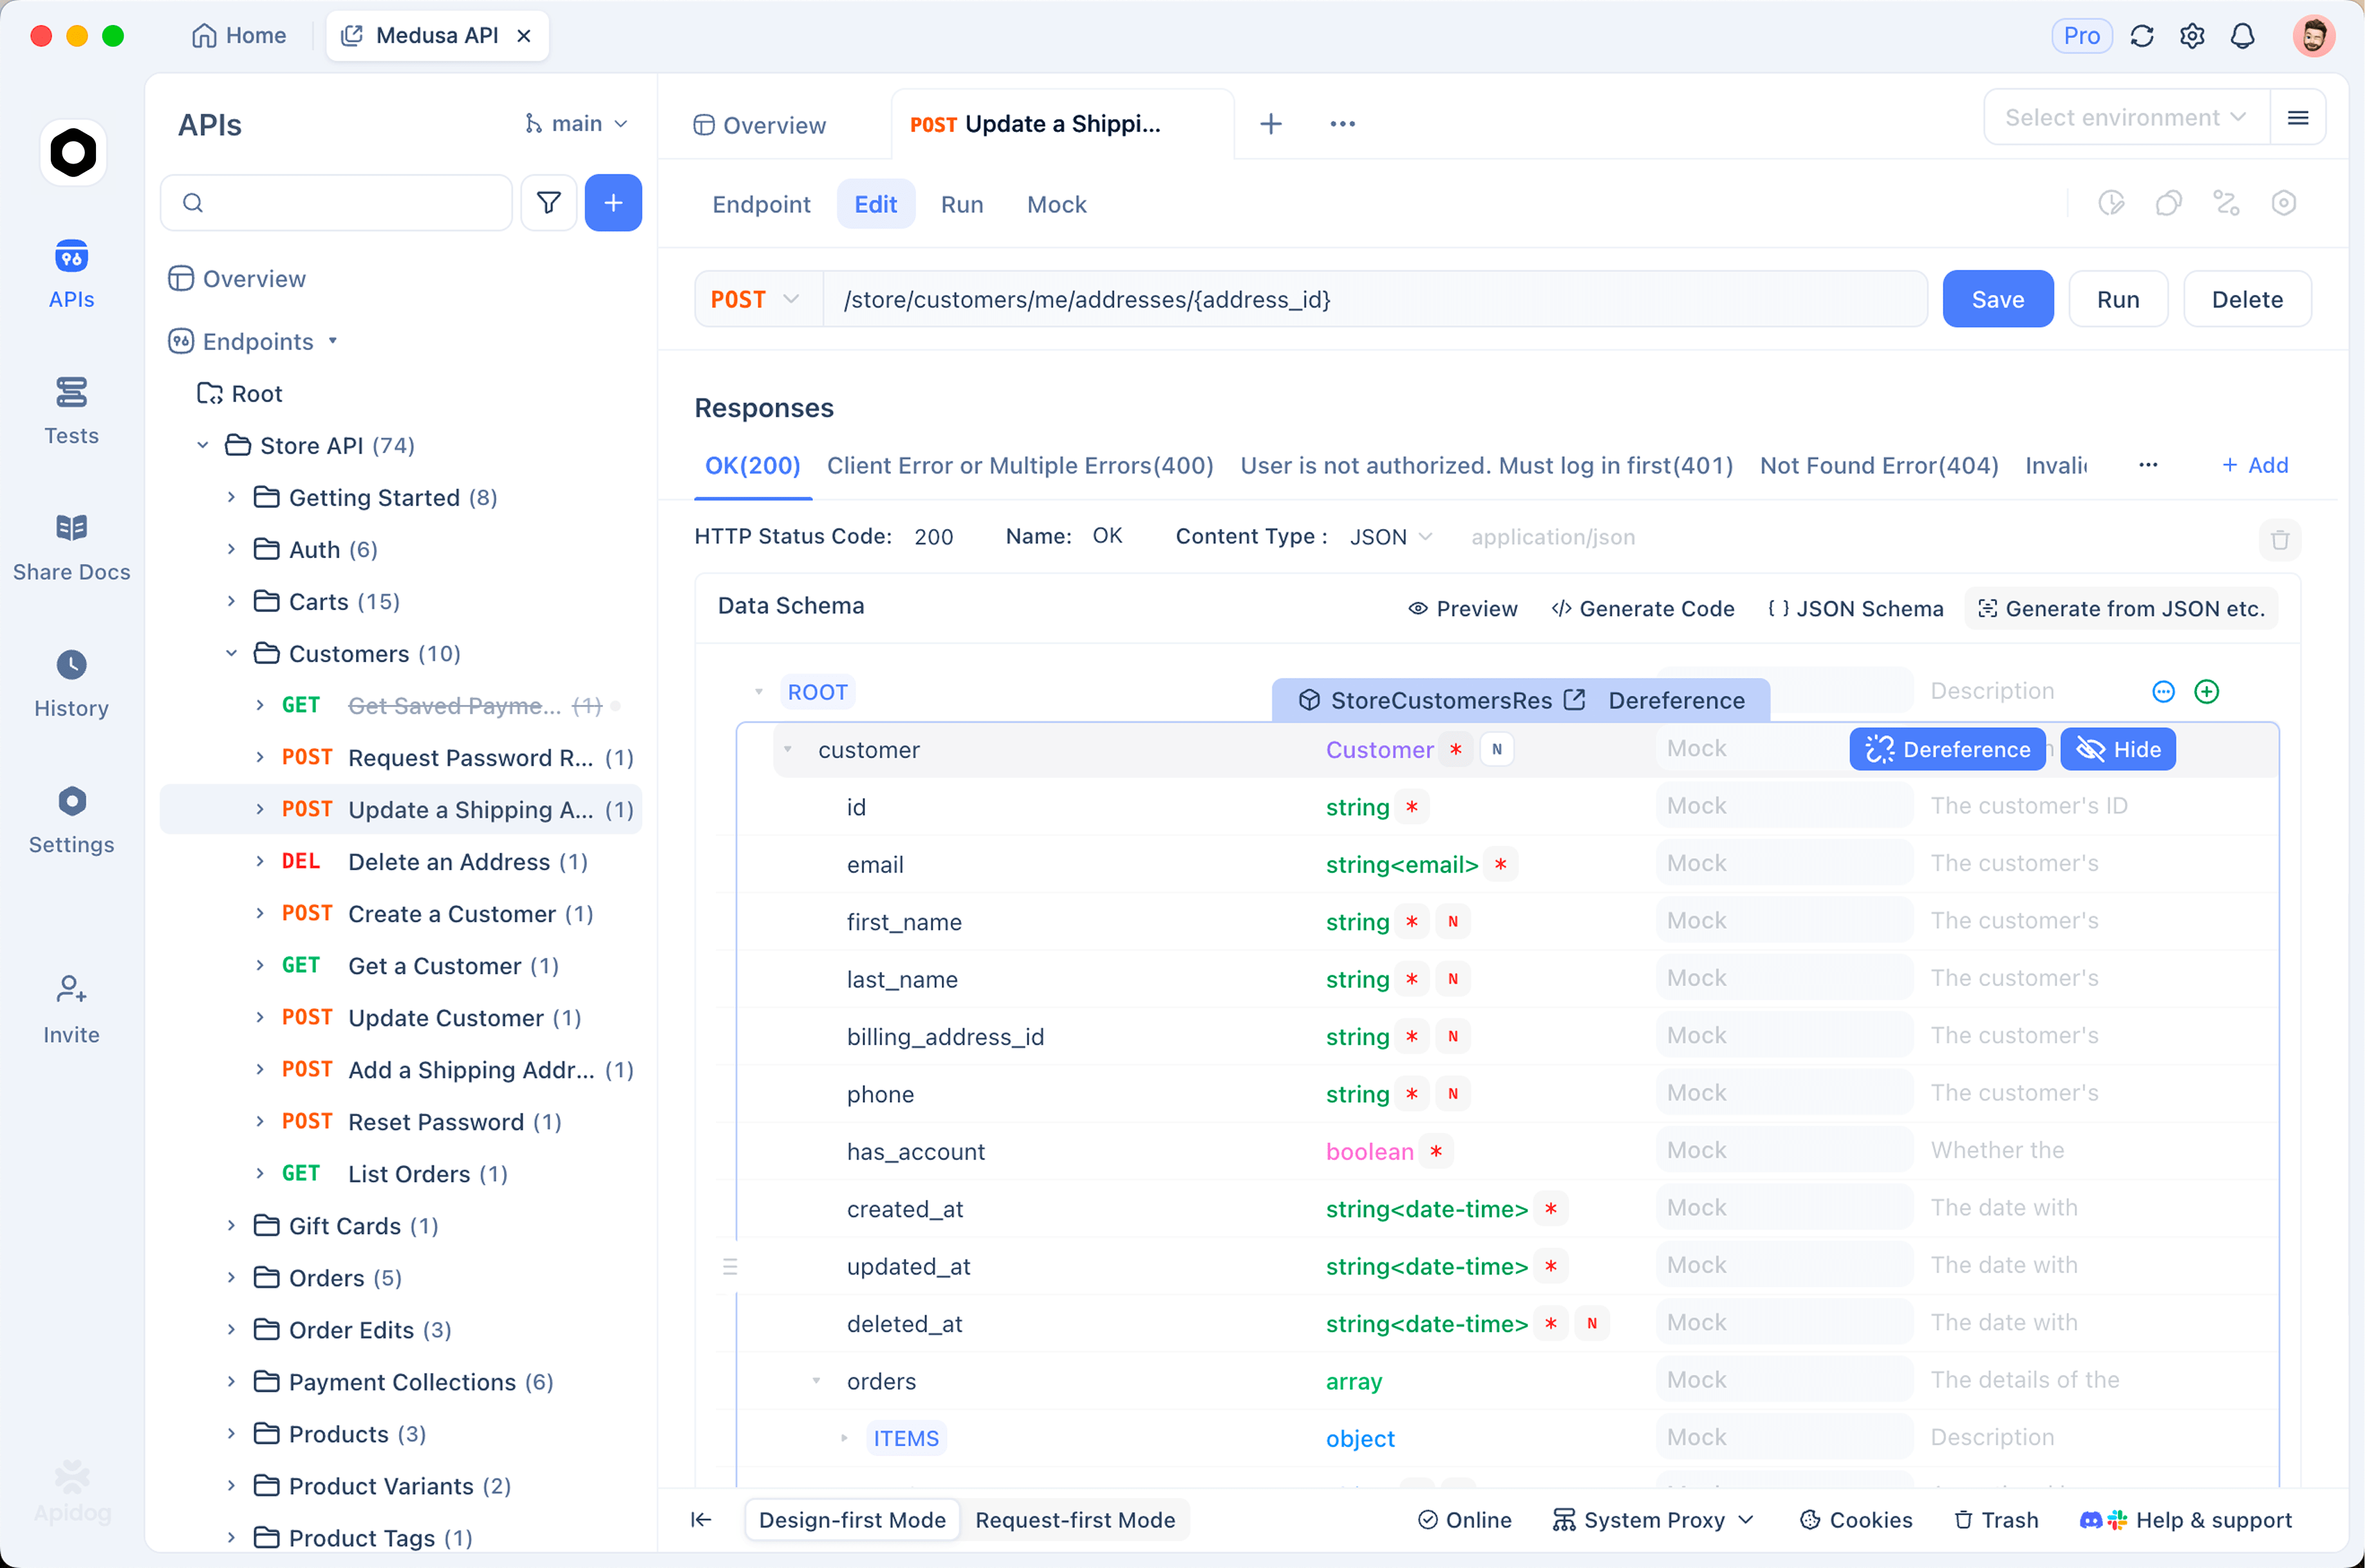
Di sinilah menyimpan perbandingan sebagai suite yang dapat diulang membuahkan hasil. Di Apidog, Anda dapat menyimpan kedua panggilan dalam satu koleksi dengan ID model sebagai variabel lingkungan, melampirkan pernyataan ke bidang yang dibaca aplikasi Anda, dan menjalankan kembali semuanya ketika diskon kedaluwarsa atau Z.ai merilis revisi berikutnya. Pilihan model yang dapat Anda uji ulang dalam tiga puluh detik adalah keputusan yang dapat Anda tinjau kembali; yang tersimpan dalam riwayat shell tidak.
FAQ
Apakah GLM-5.3-Flash hanya GLM-5.3 yang lebih kecil? Tidak. Ini adalah model dasar yang dilatih secara terpisah dengan arsitektur perhatian yang berbeda, bukan distilasi atau varian yang dipangkas.
Apakah keduanya memiliki jendela konteks yang sama? Ya, 1.048.576 token untuk keduanya.
Mana yang lebih baik untuk coding? Flash mencetak 84,3 pada Terminal-Bench 2.1 dan 63,4 pada DeepSWE menurut Z.ai, yang kuat. GLM-5.3 sedikit lebih kuat dalam penalaran umum. Bagi pengguna paket coding, kuota 3x biasanya menentukan.
Bisakah saya beralih di antara keduanya tanpa perubahan kode? Ya. Endpoint yang sama yang kompatibel dengan OpenAI, ID model yang berbeda. Hanya input gambar yang eksklusif untuk Flash.
Apakah yang lebih murah akan tetap murah? Harga mencerminkan cache KV yang lebih kecil dan komputasi perhatian yang lebih rendah daripada promosi, jadi keuntungan struktural seharusnya bertahan. Diskon peluncuran tambahan 50% akan berakhir pada 9 September 2026.