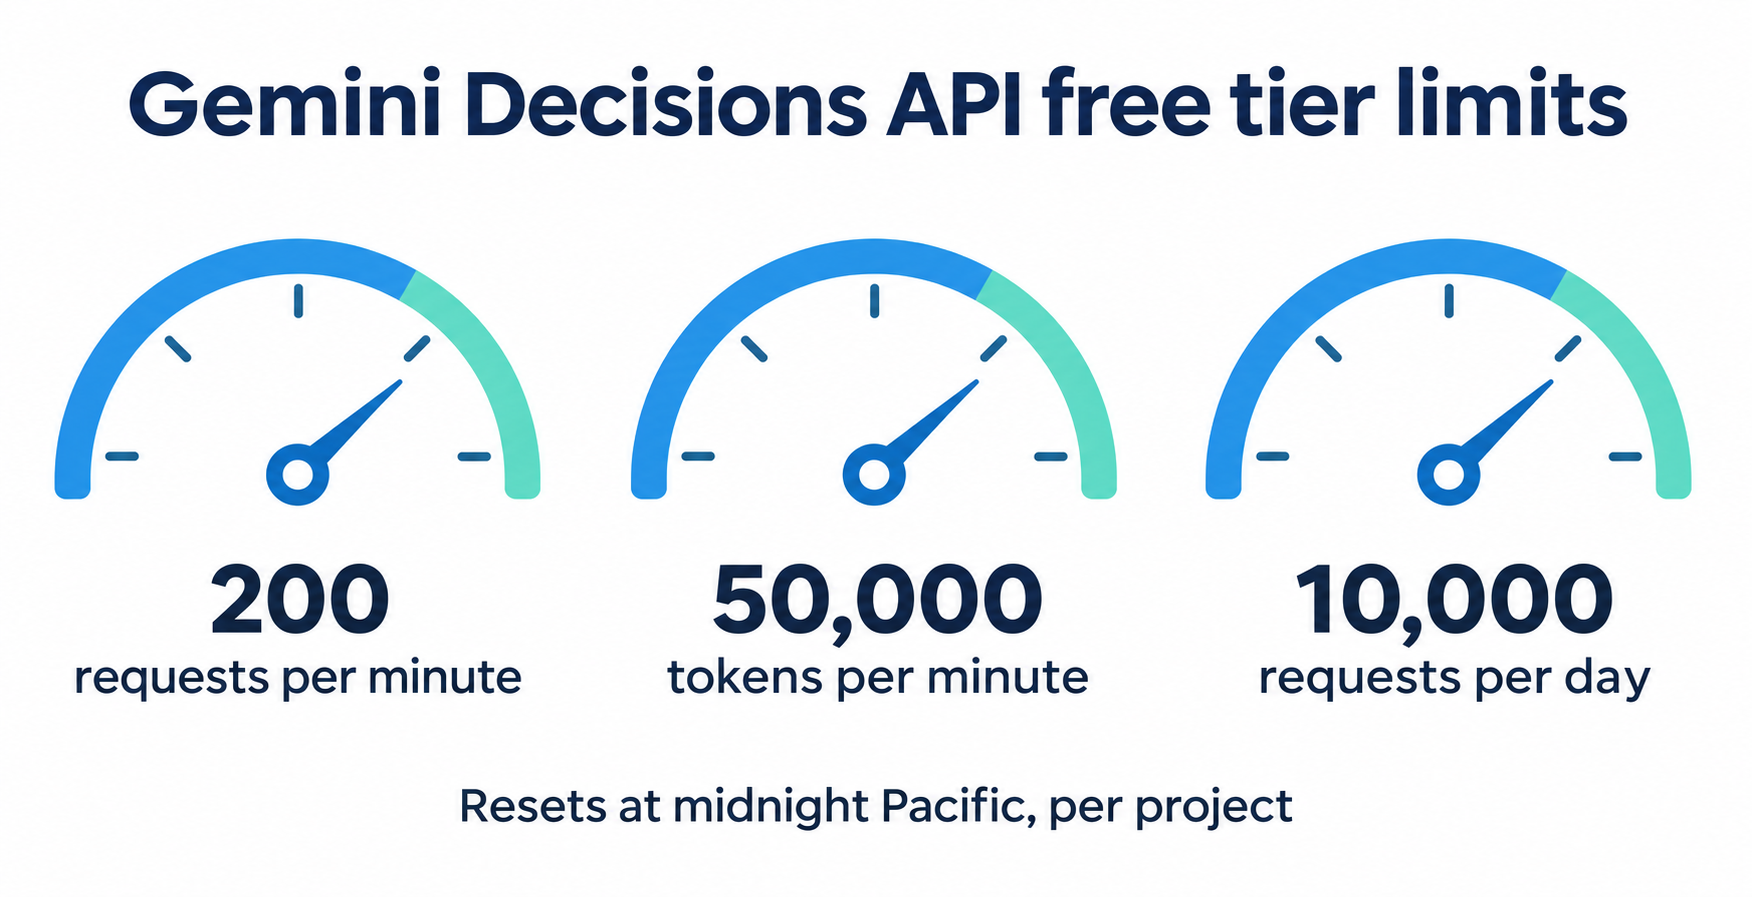
Anda dapat menggunakan Gemini Decisions API secara gratis mulai hari ini. Paket gratis (free tier) Google untuk gemini-decision-1 tidak mengenakan biaya untuk input, tidak menagih token output, dan mengizinkan 200 permintaan per menit, 50.000 token per menit, serta 10.000 permintaan per hari per project. Anda hanya perlu API key AI Studio tanpa akun penagihan (billing). Kelemahannya: pada paket gratis, Google dapat menggunakan konten Anda untuk menyempurnakan produknya.
Di bawah ini: apa arti batasan-batasan tersebut dalam beban kerja nyata, perhitungan token di balik harga berbayar $0,10 per 1M, rute gratis lainnya, dan cara menjaga pengujian serta CI agar tidak menghabiskan kuota harian Anda. Setiap kuota dan harga dibaca dari halaman resmi Google pada 12 November 2026. API ini dirilis sebagai v1beta, jadi periksa kembali sebelum menyusun anggaran. Untuk jenis pertanyaannya sendiri (noul, choice, score), lihat panduan Decisions API dari Google.
Apa saja yang termasuk dalam paket gratis Gemini Decisions API
Paket gratis Gemini Decisions API adalah tingkat penggunaan tanpa biaya dari Gemini Developer API milik Google yang diterapkan pada model gemini-decision-1. Paket ini memberi setiap Google Cloud project pemrosesan input gratis, tanpa biaya output, dan batas rate tetap sebesar 200 RPM, 50.000 TPM, dan 10.000 RPD, tanpa perlu pengaturan penagihan apa pun.
Berikut yang dikatakan oleh halaman harga dan halaman batas rate Google, secara berdampingan:
| Item | Paket gratis | Berbayar (Tier 1) |
|---|---|---|
| Harga input (teks, gambar, video, audio, PDF) | Gratis | $0,10 per 1M token |
| Harga output | Tidak berlaku (0 token output) | Tidak berlaku (0 token output) |
| Permintaan per menit | 200 | 1.500 |
| Token per menit | 50.000 | 1.000.000 |
| Permintaan per hari | 10.000 | 50.000 |
| Konten digunakan untuk menyempurnakan produk Google | Ya | Tidak |
| Context caching | Tidak tersedia | Tidak tersedia |
Tiga detail yang lebih penting daripada angka-angka utamanya:
- Batasan berlaku per project, bukan per API key. Membuat lima key dalam satu project tidak memberi Anda lima kuota.
- Batas harian direset pada tengah malam waktu Pasifik. Pekerjaan batch yang dimulai pukul 11 malam waktu Pasifik mendapat satu jam kuota hari itu dan kuota baru 10.000 setelah tengah malam.
- Data paket gratis dapat digunakan oleh Google. Tabel harga menandai "Digunakan untuk menyempurnakan produk kami" sebagai Ya pada paket gratis dan Tidak pada paket berbayar. Jangan kirim PII pelanggan, kontrak, atau gambar medis melalui key gratis.
Cara mendapatkan API key Gemini Decisions secara gratis
Anda bisa mulai melakukan panggilan gratis dalam waktu sekitar lima menit:
- Masuk ke Google AI Studio dan klik Create API key. Project baru akan dimulai pada paket gratis.
- Instal SDK 3.2 atau lebih baru:
pip install -U google-genaiataunpm install @google/genai@latest. - Ekspor key sebagai
GEMINI_API_KEYagar SDK dapat mendeteksinya. - Kirim satu permintaan dengan
http_options={"api_version": "v1beta"}dan baca blokusagedi respons.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input="Order 8821 arrived with a cracked screen.",
    questions={
        "is_damaged": {"type": "noul", "instructions": "Did the item arrive damaged?"},
    },
)

print(result.answers["is_damaged"].noul)
print(result.usage.total_input_tokens)
Angka usage.total_input_tokens itulah yang perlu Anda catat. Pada paket gratis, itulah yang menghabiskan kuota 50.000 TPM Anda; pada paket berbayar, itulah satu-satunya hal yang ditagihkan kepada Anda.
Untuk penawaran gratis Google lainnya, lihat panduan paket gratis Gemini API kami dan cara menggunakan Gemini secara gratis.
Cara kerja penentuan harga Gemini Decisions API
Anda hanya membayar token input, dan input bersama hanya dihitung sekali per permintaan berapa pun jumlah pertanyaan yang Anda ajukan. Setiap pertanyaan hanya menambahkan token instruksi dan kriteria miliknya sendiri. Output selalu 0 token, karena model mengembalikan probabilitas, bukan teks.
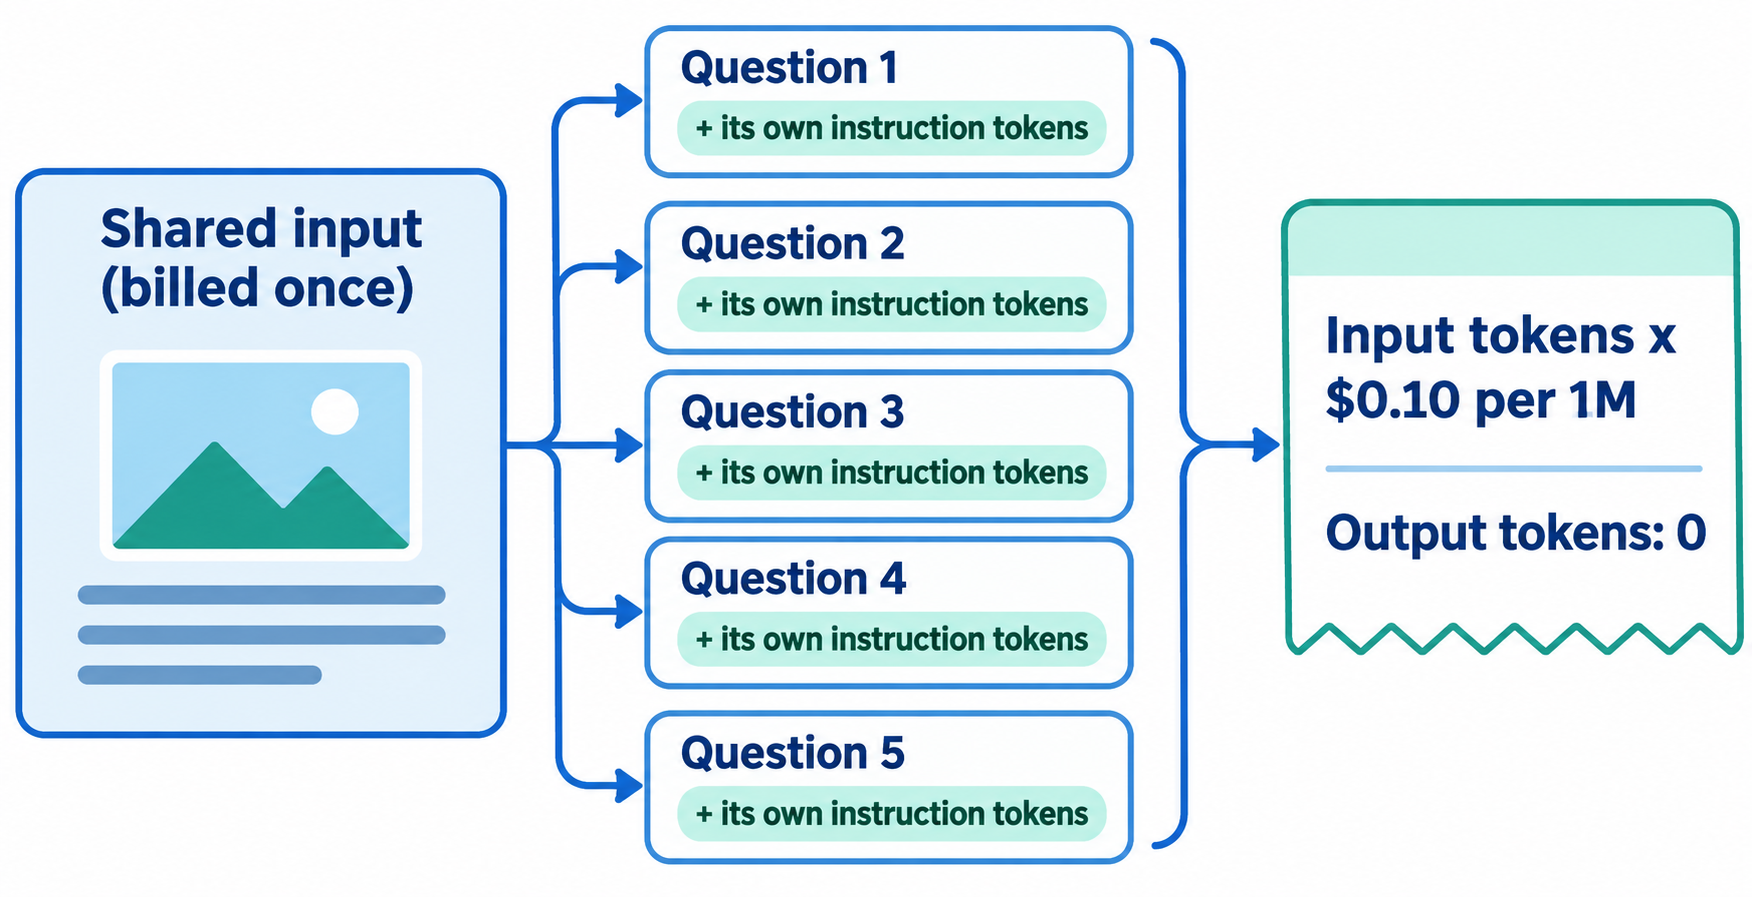
Jadi rumus untuk satu permintaan sangat sederhana:
input tokens = shared input + sum(each question's instructions + criteria)
paid cost    = input tokens / 1,000,000 x $0.10
Bagian yang menarik adalah efeknya pada paket gratis. Untuk teks, jumlah permintaan (200 RPM, 10.000 RPD) biasanya menjadi batasan pertama. Untuk gambar, audio, atau dokumen panjang, batas 50.000 TPM yang menjadi batasan pertama.
Contoh perhitungan biaya: paket gratis vs berbayar
Angka token pertanyaan di bawah ini adalah estimasi (sekitar 30 token per pertanyaan singkat). Jumlah token gambar dan audio berasal dari tabel resolusi media Google, yang mencantumkan 280 token per gambar pada low, 1.120 pada high, dan 25 token per detik audio untuk model Gemini saat ini. Jalankan satu permintaan sungguhan dan ganti angka saya dengan nilai usage Anda sendiri.
10.000 foto produk x 16 pertanyaan
Katakanlah Anda memeriksa foto pengiriman untuk kerusakan, penempatan, keterbacaan label, dan 13 hal lainnya.
- Per permintaan pada resolusi
low: 280 (gambar) + 20 (konteks teks) + 16 x 30 (pertanyaan) = 780 token - 10.000 foto: 10.000 x 780 = 7,8 juta token
- Biaya berbayar: 7,8 x $0,10 = $0,78
- Pada resolusi
high: 1.120 + 20 + 480 = 1.620 token per foto, 16,2 juta token, $1,62
Pada paket gratis, TPM menentukan kecepatan Anda: 50.000 / 780 = sekitar 64 foto per menit. Seluruh 10.000 foto selesai dalam sekitar 2 jam 36 menit dan menggunakan tepat satu hari kuota 10.000 permintaan. Pada high, sekitar 30 per menit dan 5,5 jam.
Sekarang, kesalahan yang harus dihindari. Jika Anda mengirim 16 pemeriksaan tersebut sebagai 16 permintaan terpisah, masing-masing akan mengirim ulang gambar: 16 x 300 = 4.800 token gambar-dan-konteks ditambah 480 token pertanyaan yang sama, sekitar 5.280 per foto. Itu berarti 52,8 juta token ($5,28 jika berbayar) dan 160.000 permintaan, setara dengan 16 hari kuota paket gratis. Kelompokkan pertanyaan-pertanyaan tersebut dalam satu permintaan.
10.000 tiket dukungan x 3 pertanyaan routing
- Per permintaan: 250 (teks tiket) + 3 x 40 (pertanyaan dengan kriteria) = 370 token
- 10.000 tiket: 3,7 juta token, $0,37 jika berbayar
- Paket gratis: 50.000 / 370 = 135 permintaan per menit, di bawah batas 200 RPM. Kuota 10.000 permintaan satu hari cukup untuk 10.000 tiket.
PDF panjang
Context window-nya 262.144 token, tetapi TPM gratis adalah 50.000, jadi satu kontrak berukuran 120.000 token sudah melebihi anggaran gratis satu menit penuh. Dokumentasi Google tidak menjelaskan bagaimana paket gratis menangani satu permintaan yang melebihi batas TPM, jadi uji satu permintaan terlebih dahulu. Dokumen panjang adalah kasus di mana Tier 1 (1M TPM) membalas biayanya.
Cara lain menggunakan Gemini Decision 1 dengan biaya $0
| Rute | Biaya | Perlu kartu atau penagihan? | Cocok untuk apa |
|---|---|---|---|
| Paket gratis Gemini API (AI Studio key) | $0, 200 RPM / 50.000 TPM / 10.000 RPD | Tidak | Prototipe, alat internal, batch malam hari di bawah 10.000 permintaan |
| Decisions Playground di AI Studio | $0 (paket tanpa biaya, sesuai postingan peluncuran Google) | Tidak | Menguji rumusan pertanyaan sebelum menulis kode |
OpenRouter (google/gemini-decision-1) |
$0,10 per 1M input, $0 output | Ya, kredit | Satu key untuk berbagai penyedia; tidak gratis |
Halaman model OpenRouter, diperiksa pada 12 November 2026, mencantumkan satu penyedia (Google AI Studio) dengan harga $0,10 per 1M input, output gratis, dan tanpa varian :free. Endpoint-nya adalah endpoint Decisions milik OpenRouter, sehingga SDK chat completions tidak dapat memanggilnya.
Cara tetap berada dalam batas paket gratis
Kebiasaan-kebiasaan berikut menjaga prototipe Anda tetap $0 selama mungkin:
- Ajukan semua pertanyaan dalam satu permintaan. Input bersama ditagih sekali, dan hingga 1.000 pertanyaan dapat dimasukkan dalam satu panggilan.
- Turunkan resolusi media.
lowberbiaya seperempat darihighper gambar. - Kirim hanya bidang yang dibutuhkan pertanyaan. Google menyatakan konten yang tidak relevan menurunkan akurasi, dan itu juga menghabiskan TPM.
- Atur kecepatan berdasarkan TPM, bukan RPM. Atur laju worker ke 50.000 dibagi jumlah token per permintaan yang Anda ukur.
- Cache jawaban sendiri. API ini tidak memiliki context caching dan menghitung input berulang sepenuhnya, jadi hash input ditambah pertanyaan dan lewati yang berulang.
- Mulai proses besar setelah tengah malam waktu Pasifik untuk mendapatkan kuota satu hari penuh.
- Jauhkan pengujian dan CI dari API asli. Rangkaian pengujian yang memanggil API pada setiap push bisa menghabiskan 10.000 permintaan sebelum makan siang. Gunakan mock saja.
Minta coding agent Anda mem-mock Decisions API dengan Apidog CLI
Unit test tidak membutuhkan model yang berjalan langsung. Yang dibutuhkan adalah bentuk respons yang tepat: peta answers, noul antara 0,01 dan 0,99, sebuah confidence, dan usage.total_output_tokens: 0. Coding agent Anda dapat membangun mock tersebut dengan Apidog CLI, sehingga hanya satu smoke test yang menyentuh Google.
Pengaturan sekali saja:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Lalu berikan satu prompt kepada Claude Code, Codex, atau Cursor:
In Apidog project <id>, add the Gemini Decisions endpoint POST /v1beta/decisions
with a request body of model, input and questions. Create mock expectations that
return a damaged answer (noul 0.97) and an undamaged one (noul 0.04), each with
usage.total_output_tokens = 0. Add a test case that asserts the answers map,
confidence between 0 and 1 and zero output tokens. Run it against the mock
environment, then once against the real API with my free-tier key.
Agent membaca skema setiap payload, memvalidasinya, dan baru kemudian menulis:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file decisions-endpoint.json
apidog endpoint create --project <id> --file decisions-endpoint.json

apidog cli-schema get mock-create
apidog cli-schema validate mock-create --file mock-damaged.json
apidog mock create --project <id> --file mock-damaged.json

apidog cli-schema get test-case-create
apidog test-case create --project <id> --file decisions-case.json
apidog run --test-case <caseId> --project <id> -e <mockEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <freeTierEnvId> -r cli
Di CI, jalankan hanya lingkungan mock dengan -r junit (file pipeline ada di panduan CI/CD Apidog CLI kami); pengaturan agent ada di Apidog CLI di Claude Code. Paket Free Apidog mencakup hingga 4 pengguna, jadi tim kecil dapat berbagi mock tanpa biaya. Sedang mempertimbangkan versi OpenAI juga? Lihat penjelasan OpenAI Decisions API kami.
FAQ
Apakah Gemini Decisions API gratis? Ya, dalam batas tertentu. Paket gratis tidak mengenakan biaya input dan output selalu 0 token. Anda mendapatkan 200 permintaan per menit, 50.000 token per menit, dan 10.000 permintaan per hari per project. Melampaui itu, aktifkan penagihan dan bayar $0,10 per 1M token input.
Apakah saya perlu kartu kredit untuk paket gratis Gemini Decisions API? Tidak. API key dari Google AI Studio langsung dimulai pada paket gratis. Halaman batas rate Google menyatakan Anda hanya berpindah ke paket berbayar setelah mengaktifkan penagihan di AI Studio.
Apakah Google melatih modelnya dengan data Decisions API saya pada paket gratis? Halaman harga Google menandai "Digunakan untuk menyempurnakan produk kami" sebagai Ya untuk paket gratis dan Tidak untuk yang berbayar. Perlakukan key paket gratis sebagai tidak cocok untuk data sensitif.
Mengapa saya mendapat error 429 meskipun jauh di bawah 200 permintaan per menit? Kemungkinan Anda melebihi 50.000 token per menit. Input gambar, audio, dan PDF berat dalam token, sehingga TPM biasanya menjadi batasan sebelum RPM. Catat usage.total_input_tokens dan atur laju permintaan ke 50.000 dibagi angka tersebut.
Apakah ada model Gemini Decision 1 gratis di OpenRouter? Tidak, per 12 November 2026. OpenRouter mencantumkan google/gemini-decision-1 dengan harga $0,10 per 1M token input dan $0 output, tanpa varian :free.
Apakah saya bisa menggunakan Batch API atau context caching untuk memperpanjang paket gratis? Tidak. Halaman model mencantumkan Batch API dan caching sebagai tidak didukung di semua tingkat. Kelompokkan pertanyaan dalam satu permintaan dan cache jawaban di kode Anda sendiri.