Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2, singkatnya: Fable 5.2 mencetak skor tertinggi, Neon paling murah per token, dan Astra menyelesaikan tugas benchmark independen dengan biaya paling rendah. Neon dipatok $3 / $15 per 1 juta token input/output, sedangkan Astra dan Fable sama-sama $8 / $40. Ketiganya menawarkan konteks sekitar 1 juta token.
Tiga model frontier dirilis dalam sepuluh hari: Claude Fable 5.2 pada 9 November 2026, GPT-6.2 Astra pada 17 November, dan Gemini 4 Neon pada 18 November. Di bawah ini: harga, spesifikasi, skor independen, biaya per tugas, dan cara menguji ketiganya dengan Apidog CLI.
Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2: kesimpulan singkat
Pilih berdasarkan beban kerja, bukan peringkat papan skor:
- Gemini 4 Neon untuk coding dan analisis kompleks yang Anda jalankan sepanjang hari. Harganya 62,5% lebih murah per token dibanding dua model lainnya dan menempati peringkat kedua di Vals Index.
- GPT-6.2 Astra jika stack Anda berbasis di OpenAI Responses API. Model ini menulis jauh lebih sedikit token per tugas, sehingga menjadi yang termurah di antara ketiganya per tugas Artificial Analysis meskipun harganya $8 / $40.
- Claude Fable 5.2 untuk pekerjaan jangka panjang tersulit, di mana satu proses yang gagal lebih mahal daripada tokennya. Model ini memimpin kedua indeks independen, dengan biaya per tugas tertinggi.
Jika Anda mengikuti preseden Oktober, perbandingan Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5 kami membahas generasi sebelumnya.
Bagaimana perbandingan ketiga model dari segi harga dan spesifikasi?
Neon adalah pengecualian dalam hal harga. Angka-angka bersumber dari posting peluncuran Gemini 4 Neon dan halaman harga Google, halaman model GPT-6.2 Astra, dan ikhtisar Claude Fable 5.2 dari Anthropic.
| Spesifikasi | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| ID model API | gemini-4-neon |
gpt-6.2-astra |
claude-fable-5-2 |
| Dirilis | 18 Nov 2026 | 17 Nov 2026 | 9 Nov 2026 |
| Input / output per 1 juta | $3 / $15 | $8 / $40 | $8 / $40 |
| Input ter-cache per 1 juta | $0,15 (hanya implisit) | $0,40 | $0,20 |
| Jendela konteks | 1.048.576 (dibagi dengan output) | 1.050.000 (maks input 922.000) | 1 juta |
| Output maks per permintaan | 65.536 | 128.000 | 128K |
| Prompt panjang | Tarif tetap hingga 1 juta | Di atas 272K input: input 2x, output 1,5x | Tarif tetap hingga 1 juta |
| Diskon batch | 50% (Batch dan Flex) | 50% | 50% |
| Kontrol reasoning | thinking_level: low hingga xhigh, default high |
reasoning.effort, none ditolak |
effort, default high |
| Tier API gratis | Tidak | Tidak | Tidak |
Dua detail mengubah tagihan nyata. Caching Neon bersifat implisit: Anda hanya mendapat tarif $0,15 ketika Google mencocokkan prefiks prompt yang berulang. Dan Neon mengembalikan maksimal 65.536 token per permintaan, jadi output yang sangat panjang memerlukan long decode dari Google atau loop kelanjutan.
Untuk rincian tarif lengkap, lihat ulasan kami tentang harga Gemini 4 Neon, harga GPT-6.2 Astra, dan harga Claude Fable 5.2.
Model mana yang menang di benchmark independen?
Tabel benchmark dari vendor jarang memakai pengujian yang sama. Dua papan skor independen memeringkat ketiganya pada satu suite yang sama, dan keduanya berbeda pendapat soal posisi kedua.
| Metrik | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 61 (xhigh) | 62 (max) | 65 (max) |
| Vals Index | 70,87%, #2 | 67,66%, #8 | 71,31%, #1 |
| Biaya AA per tugas indeks | $6,44 | $4,00 | $26,54 |
| Waktu AA per tugas indeks | 21,5 menit | 13,9 menit | 41,8 menit |
| Kecepatan output AA | 110 tok/s | 49 tok/s | 109 tok/s |
| Token output di seluruh indeks AA | 283 juta | 65,8 juta | 275 juta |
Sumber: halaman model Artificial Analysis untuk masing-masing model, dicek pada 19 November 2026, dan Vals Index per 18 November 2026.
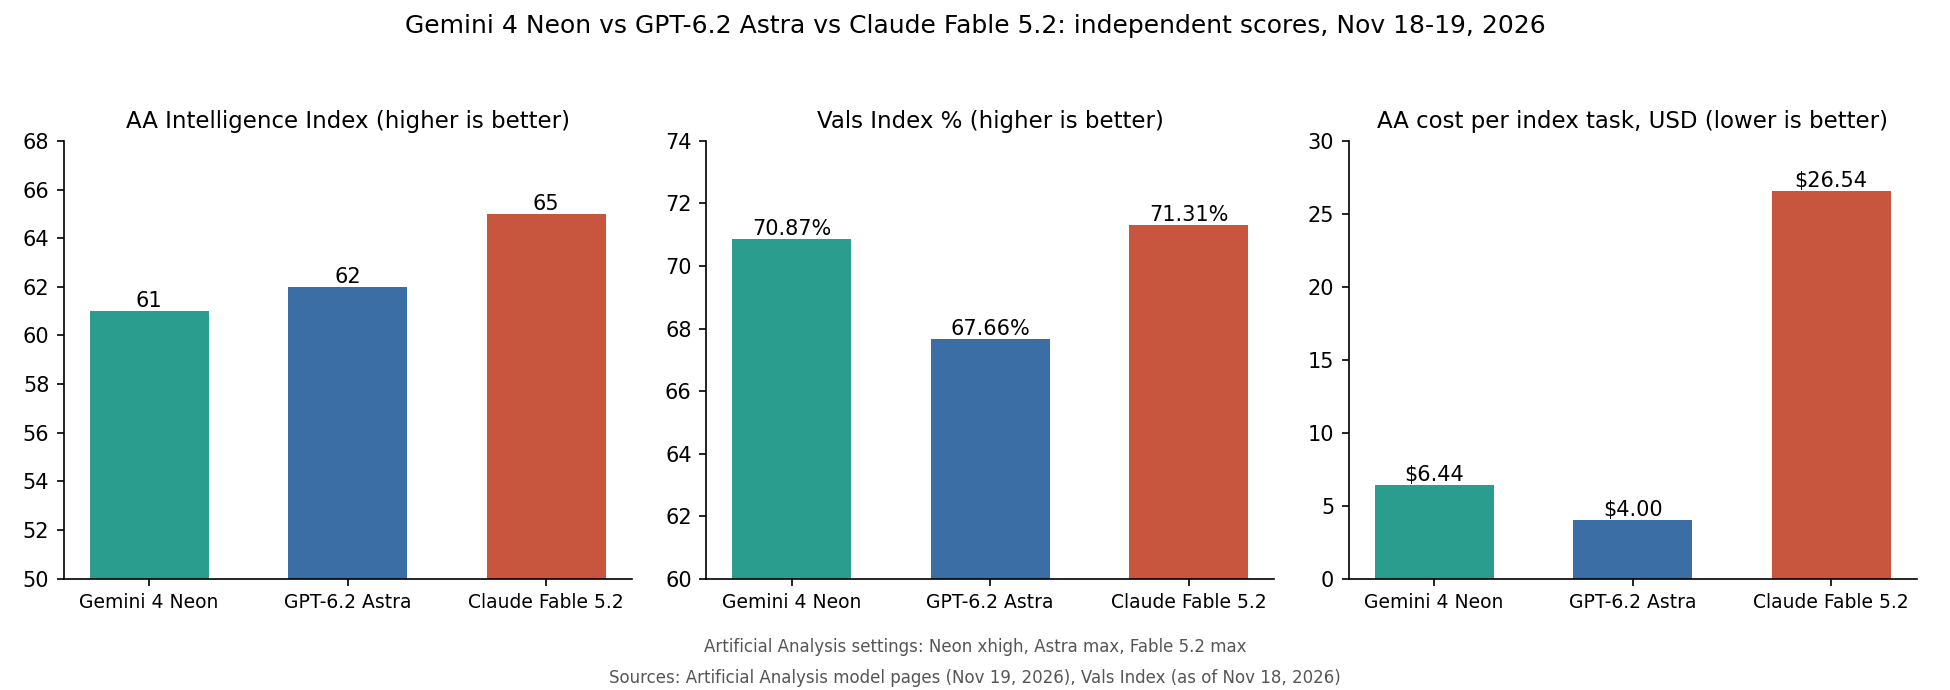
Fable 5.2 memimpin kedua papan skor, dan di Vals, Neon hanya tertinggal 0,44 poin. Artificial Analysis menempatkan Astra satu poin di depan Neon; Vals menempatkan Neon lebih dari 3 poin di depan Astra.
Posting peluncuran Google menempatkan Neon di peringkat #3 di Artificial Analysis; pada 19 November halaman yang sama mencantumkannya di peringkat #6 dari 96. Peringkat hari peluncuran bergerak cepat, dan selisih satu poin hanyalah noise. Baris biaya dan kecepatan lebih banyak memberi tahu Anda bagaimana tiap model akan terasa dalam agent Anda.
Mengapa yang termahal per token justru termurah per tugas?
Harga per token adalah separuh tagihan; separuhnya lagi adalah berapa banyak token yang ditulis model sebelum menjawab. Pada suite Artificial Analysis, Astra menghasilkan 65,8 juta token output. Neon menghasilkan 283 juta dan Fable 275 juta, lebih dari empat kali lipatnya. Tarif output Astra sebesar $40 diterapkan pada tumpukan yang jauh lebih kecil, sehingga biaya per tugasnya berada di $4,00, di bawah Neon $6,44, meskipun tarif output Neon 62,5% lebih rendah.
Pengaturan berpengaruh. Artificial Analysis menjalankan Neon pada xhigh; pada high model ini mencetak skor 60 dengan 123 juta token output alih-alih 283 juta, satu poin lebih rendah dengan kurang dari separuh token. Panduan level thinking Gemini 4 Neon kami menunjukkan kurva lengkapnya.
Angka $26,54 Fable menggabungkan tarif output yang tinggi dengan verbositas yang tinggi: harga dari skor teratas.
Berapa biaya beban kerja agent nyata pada masing-masing model?
Dua beban kerja pada tarif daftar, dengan asumsi jumlah token identik pada tiap model (kenyataannya tidak akan sama, jadi bacalah ini sebagai perbandingan harga, bukan ramalan).
| Beban kerja | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Sesi agent: 150K input baru, 1,35 juta pembacaan cache, 150K output | $0,45 + $0,20 + $2,25 = $2,90 | $1,50 + $0,54 + $6,00 = $8,04 | $1,50 + $0,27 + $6,00 = $7,77 |
| Satu permintaan panjang: 400K input, 8K output, tanpa cache | $1,20 + $0,12 = $1,32 | $6,40 + $0,48 = $6,88 | $3,20 + $0,32 = $3,52 |
Astra dan Fable menagih 150K pertama sebagai cache write $10 per 1 juta; Neon tidak mengenakan biaya tulis. Permintaan panjang menunjukkan aturan 272K milik Astra: melewati batas itu, OpenAI menagih $16 input dan $60 output per 1 juta untuk seluruh permintaan.
Jika Neon menulis token 3x lebih banyak daripada Astra pada prompt Anda, sesi $2,90-nya bisa lebih mahal daripada Astra. Ukur token output sebelum memilih berdasarkan harga.
Perbedaan API mana yang akan merusak harness agent Anda?
Tiap API menolak pengaturan yang diterima API lainnya:
- Gemini 4 Neon: parameter lama
thinking_budgetmengembalikan HTTP 400, begitu jugafrequency_penaltydanpresence_penalty. Nilai kustomtemperature,top_k, dantop_pdiabaikan, menurut panduan developer Google Cloud. - GPT-6.2 Astra:
reasoning.effortyang diatur kenonemengembalikan 400, dan halaman model mencantumkan Realtime, Assistants, dan fine-tuning sebagai tidak didukung. - Claude Fable 5.2: pemaksaan penggunaan tool (
tool_choicebernilaianyatautool) dan parameter sampling sepertitemperaturemengembalikan 400, dan thinking tidak bisa dimatikan.
Panduan GPT-6.2 Astra vs Claude Fable 5.2 kami membahas keanehan Astra dan Fable secara rinci, dan panduan API Gemini 4 Neon membahas format permintaan Neon.
Di mana tiap model paling cocok?
Gemini 4 Neon dirancang untuk pekerjaan kompleks yang sering dilakukan. Google menyebutnya dapat memangkas pembacaan file yang redundan dan dapat merencanakan sementara subagent Gemini 4 Hydrogen yang lebih murah menjalankan langkah-langkahnya; di Google Antigravity, /swarm menjalankan agent secara paralel.
GPT-6.2 Astra menghadirkan kotak peralatan OpenAI: apply_patch, hosted shell, computer use, MCP, dan beta multi-agent di Responses API. Ini yang tercepat di antara ketiganya di Artificial Analysis, dengan 13,9 menit per tugas. Simon Willison mencatat pada hari peluncuran bahwa skornya sedikit di bawah Fable 5.2 pada beberapa benchmark.
Claude Fable 5.2 adalah pilihan ketika kualitas lebih penting daripada biaya: sesi agent panjang, refactor sulit, tugas riset. Pembacaan cache $0,20 dan harga 1 juta yang tetap meredam tarif output $40.
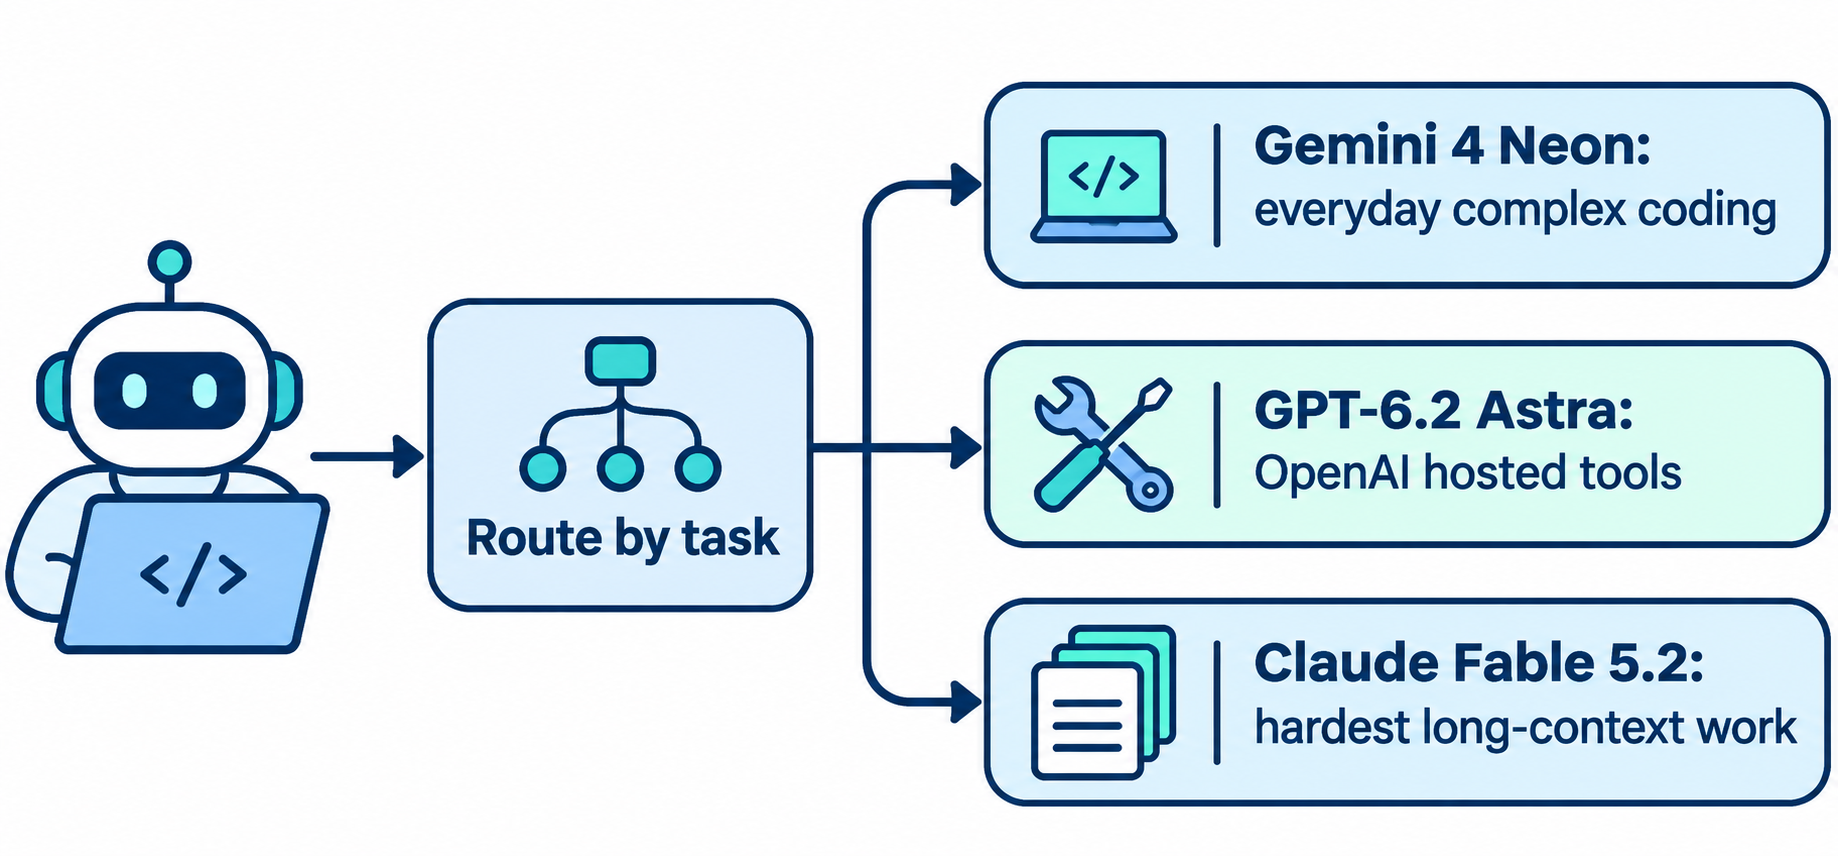
Anda tidak harus memilih satu. Kirim sebagian besar langkah agent ke Neon dan beberapa tugas yang gagal di sana ke Fable atau Astra; biaya rata-rata Anda tetap mendekati Neon.
Bagaimana cara menguji ketiga model pada beban kerja Anda sendiri?
Papan skor mengukur tugas orang lain. Kirim 5 hingga 10 prompt nyata dari riwayat agent Anda ke ketiga API, lalu bandingkan tingkat kelulusan, token, dan latensi. Menjalankan permintaan itu secara manual lama-lama melelahkan, jadi biarkan Claude Code, Codex, atau Cursor menggerakkan Apidog CLI. Penyiapan membutuhkan tiga perintah:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu beri agent Anda satu prompt:
In Apidog project <PROJECT_ID>, create three test cases that send the
same code-review prompt to gemini-4-neon (Gemini Interactions API,
thinking_level high), gpt-6.2-astra (OpenAI Responses API, effort high)
and claude-fable-5-2 (Claude Messages API, no temperature field).
Keep each API key in a private environment variable. Assert a 200
status and a non-empty answer, record token usage and response time,
run each case 5 times and summarize cost per run at list prices.
Validate every payload against its schema before you write it.
Agent memeriksa skema tiap payload, menulis test case, dan menjalankannya. Flag berikut berasal dari apidog run --help pada CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <NEON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir abc-results
Ulangi perintah terakhir dengan ID case Astra dan Fable. -n 5 menjalankan tiap case lima kali, dan --upload-report menampilkan proses run di aplikasi Apidog. Ini adalah templat alur kerja; kami belum menjalankannya terhadap ketiga API dari mesin ini.
Tambahkan case negatif untuk error 400 di atas, supaya perubahan aturan dari penyedia langsung terdeteksi di suite Anda. Panduan Apidog CLI di Claude Code membahas penyiapan agent, dan paket Free Apidog mencakup hingga 4 pengguna.
FAQ
Apakah Gemini 4 Neon lebih baik daripada GPT-6.2 Astra? Tergantung papan skornya: Neon memimpin di Vals Index (70,87% vs 67,66%), Astra unggul satu poin di Artificial Analysis Intelligence Index (62 vs 61). Neon berharga $3 / $15 per 1 juta token, sedangkan Astra $8 / $40.
Mana yang termurah dari ketiganya? Per token, Gemini 4 Neon dengan input $3 dan output $15 per 1 juta. Per tugas Artificial Analysis, GPT-6.2 Astra dengan $4,00, karena menulis jauh lebih sedikit token daripada Neon ($6,44) atau Fable 5.2 ($26,54).
Model mana yang mencetak skor tertinggi? Claude Fable 5.2 memimpin baik di Artificial Analysis Intelligence Index (65) maupun Vals Index (71,31%) per 18-19 November 2026.
Apakah ada yang memiliki tier API gratis? Tidak. Google tidak mencantumkan tier gratis untuk Neon, dan Astra serta Fable 5.2 adalah model API berbayar. Pelanggan Google AI Pro dan Ultra dapat menggunakan Neon di aplikasi Gemini dan Antigravity. Lihat panduan gratis Gemini 4 Neon kami untuk opsi $0.
Bisakah saya menggunakan lebih dari satu dalam agent yang sama? Bisa. Rutekan langkah rutin ke Neon dan tugas yang gagal di sana ke Fable 5.2 atau Astra. Uji tiap rute terlebih dahulu: jumlah token per tugas berbeda lebih dari 4x antar model.