
Gemini 4 Neon vs Carbon kini menjadi pilihan nyata bagi setiap tim di Gemini API. Google menambahkan Neon pada November 2026 sebagai model tingkat menengah yang berada di antara Hydrogen dan Carbon, dan ketiganya berbagi satu skema request, satu jendela konteks 1 juta token, serta tool bawaan yang sama. Yang membedakannya adalah seberapa dalam mereka berpikir, seberapa cepat mereka selesai, dan berapa biaya setiap token.
Jawaban singkat: Gunakan Gemini 4 Hydrogen ($1,50 input / $7,50 output per 1 juta token, tersedia paket gratis) sebagai pilihan default untuk coding sehari-hari dan worker agent. Pindahkan tugas ke Gemini 4 Neon ($3 / $15, hanya paket berbayar) saat tugasnya kompleks dan sering dijalankan, misalnya refaktorisasi multi-file atau analisis dokumen yang padat. Simpan Gemini 4 Carbon ($2 / $10 hingga 30 November 2026, lalu $4 / $20) untuk masalah arsitektur, debugging, dan keamanan yang paling sulit.
Gemini 4 Neon vs Carbon vs Hydrogen sekilas
Gemini 4 Neon adalah model Gemini 4 tingkat menengah dari Google, dibuat untuk rekayasa perangkat lunak yang kompleks, pekerjaan berbasis pengetahuan, dan tugas sains yang Anda jalankan dengan frekuensi tinggi. Ia menalar lebih dalam dibanding Hydrogen, menyelesaikan lebih cepat dengan token output yang lebih sedikit dibanding Carbon, dan berharga $3 per 1 juta token input serta $15 per 1 juta token output, hanya di paket berbayar.
Berikut perbandingan berdampingan, diambil dari panduan Choosing a model dan halaman harga Gemini API milik Google, keduanya dicek pada 19 November 2026:
| Gemini 4 Hydrogen | Gemini 4 Neon | Gemini 4 Carbon | |
|---|---|---|---|
| Model ID | gemini-4-hydrogen |
gemini-4-neon |
gemini-4-carbon |
| Posisi | Default yang cepat | Pekerjaan kompleks, frekuensi tinggi | Penalaran terkuat |
| Kecepatan (label Google) | Cepat | Sedang | Cermat |
| Input / output per 1 juta | $1,50 / $7,50 | $3,00 / $15,00 | $2,00 / $10,00 hingga 30 Nov, lalu $4,00 / $20,00 |
| Input cache per 1 juta | $0,075 | $0,15 | $0,10, lalu $0,20 |
| Tingkat berpikir | low, medium, high (default), xhigh | low, medium, high (default), xhigh | low, medium (default), high |
| Paket API gratis | Ya | Tidak | Tidak |
| Jendela konteks | 1.048.576 token, terpadu | 1.048.576 token, terpadu | 1.048.576 token, terpadu |
Ketiganya menerima input teks, gambar, video, audio, dan PDF serta mendukung function calling, structured output, eksekusi kode, computer use, dan grounding Google Search. Masing-masing memiliki batas output sinkron 65.536 token dan bisa melewatinya hingga 1 juta token dengan long decode.
Model Gemini 4 mana yang sebaiknya Anda pakai?
Panduan Google sendiri singkat dan layak dijadikan titik awal:
- Mulai dengan Hydrogen untuk sebagian besar proyek baru: coding sehari-hari, aplikasi interaktif, agent yang menggunakan tool, dan pipeline dokumen multimodal. Google menyebutnya mengurangi klaim yang dikarang lebih dari 5x dibanding Gemini 3.8 Flash.
- Naik ke Neon saat Hydrogen tidak cukup dan Anda tidak butuh verifikasi ekstra dari Carbon: debugging level repositori, refaktorisasi multi-file, analisis hukum, keuangan, dan sains yang berjalan berkali-kali sehari.
- Cadangkan Carbon untuk arsitektur sistem, debugging multi-file, pembuktian formal, audit keamanan, atau tugas apa pun yang membuat model yang lebih cepat tersendat.
- Turun ke Gemini 3.5 Flash-Lite ($0,30 / $2,50) untuk pekerjaan teks bervolume tinggi seperti terjemahan, ekstraksi, dan peringkasan.
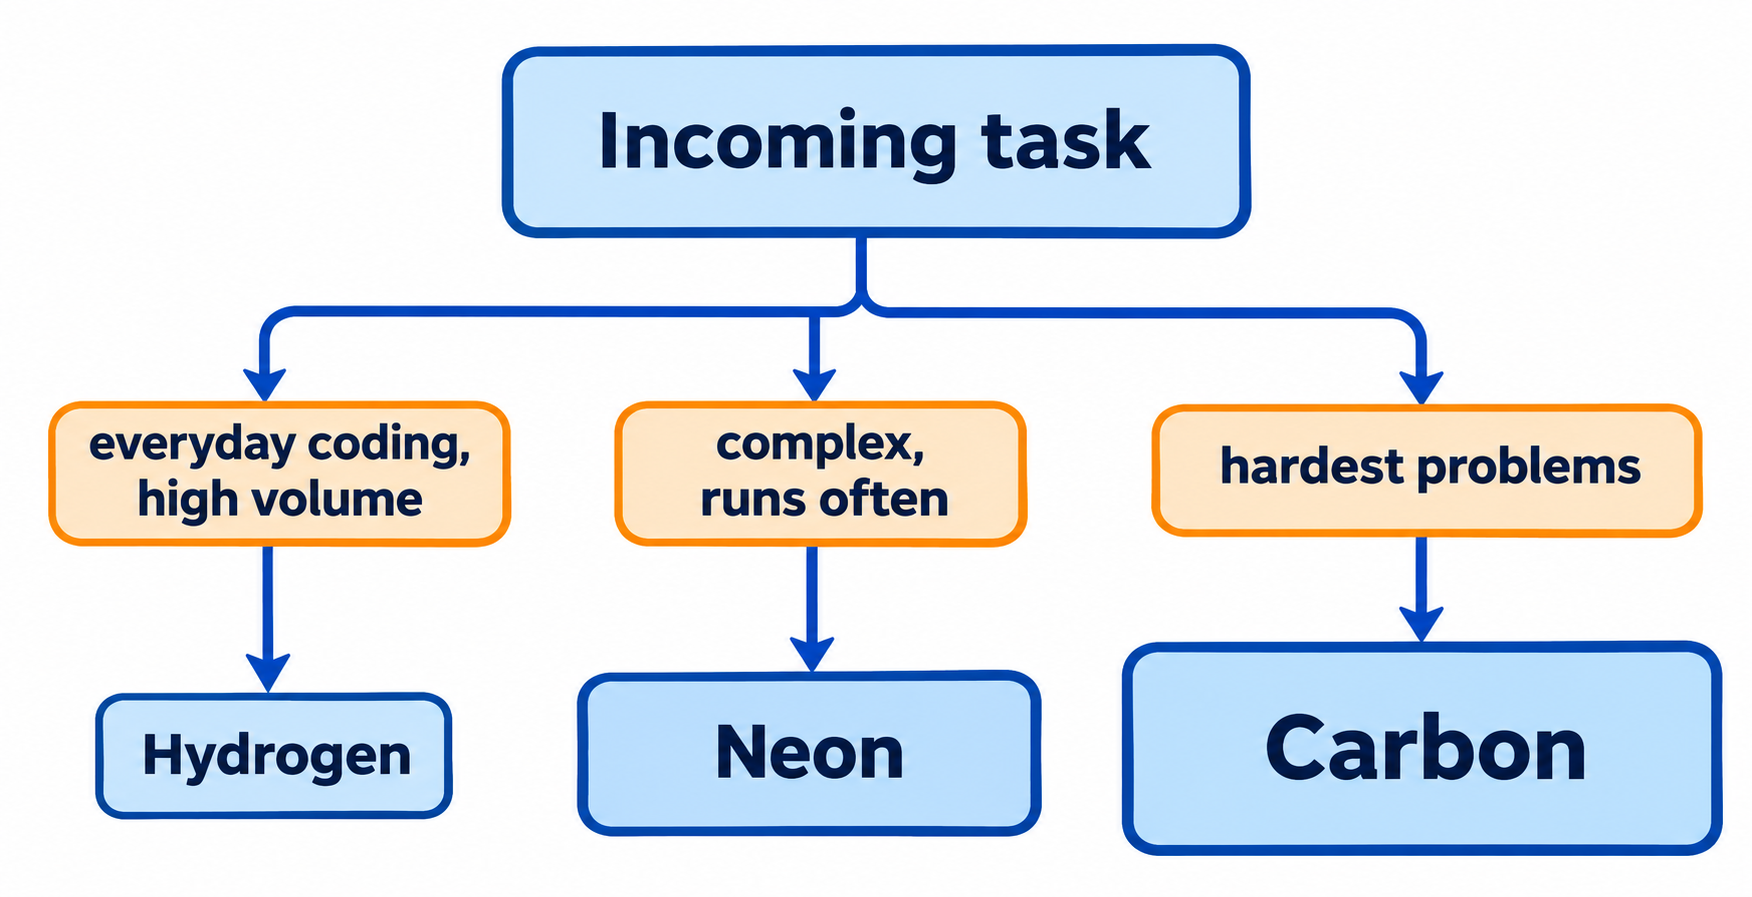
Kata kunci untuk Neon adalah "sering". Audit keamanan triwulanan bisa mengambil risiko penalaran Carbon yang lebih lambat. Agent refaktorisasi yang menyentuh 200 pull request per minggu butuh sesuatu yang selesai cepat dan tetap benar di bagian-bagian sulit.
Gemini 4 Neon vs Carbon: harga dan kedalaman penalaran
Inilah perbandingan yang paling diperhatikan sebagian besar tim, karena Neon dan Carbon sama-sama menyasar pekerjaan berat.
Gaya penalaran. Carbon menghabiskan lebih banyak token berpikir per giliran untuk menguji hipotesis, mengisolasi akar masalah lintas repositori, dan memeriksa perbaikan terhadap test. Neon menargetkan kualitas level frontier dengan penggunaan token yang lebih hemat. Menurut halaman What's new in Gemini 4 Neon milik Google, ia menyelesaikan debugging level repositori dalam lebih sedikit langkah, mengurangi pembacaan file redundan pada sesi pemanggilan tool yang panjang, dan menangani compacting konteks secara andal.
Defaultnya berbeda. Carbon secara default memakai berpikir medium dan maksimal di high. Neon default-nya high dan menambahkan xhigh untuk masalah multi-langkah paling sulit. Jika Anda mengganti Carbon dengan Neon tanpa mengatur thinking_level, Anda juga mengubah seberapa keras model berpikir.
Harga berbalik pada 1 Desember. Hingga 30 November 2026, harga perkenalan Carbon ($2 / $10) sebenarnya lebih murah per token dibanding Neon ($3 / $15). Mulai 1 Desember, Carbon menjadi dua kali lipat menjadi $4 / $20, dan Neon berubah 25% lebih murah per token. Neon tidak punya harga perkenalan, jadi tarifnya tidak berubah.
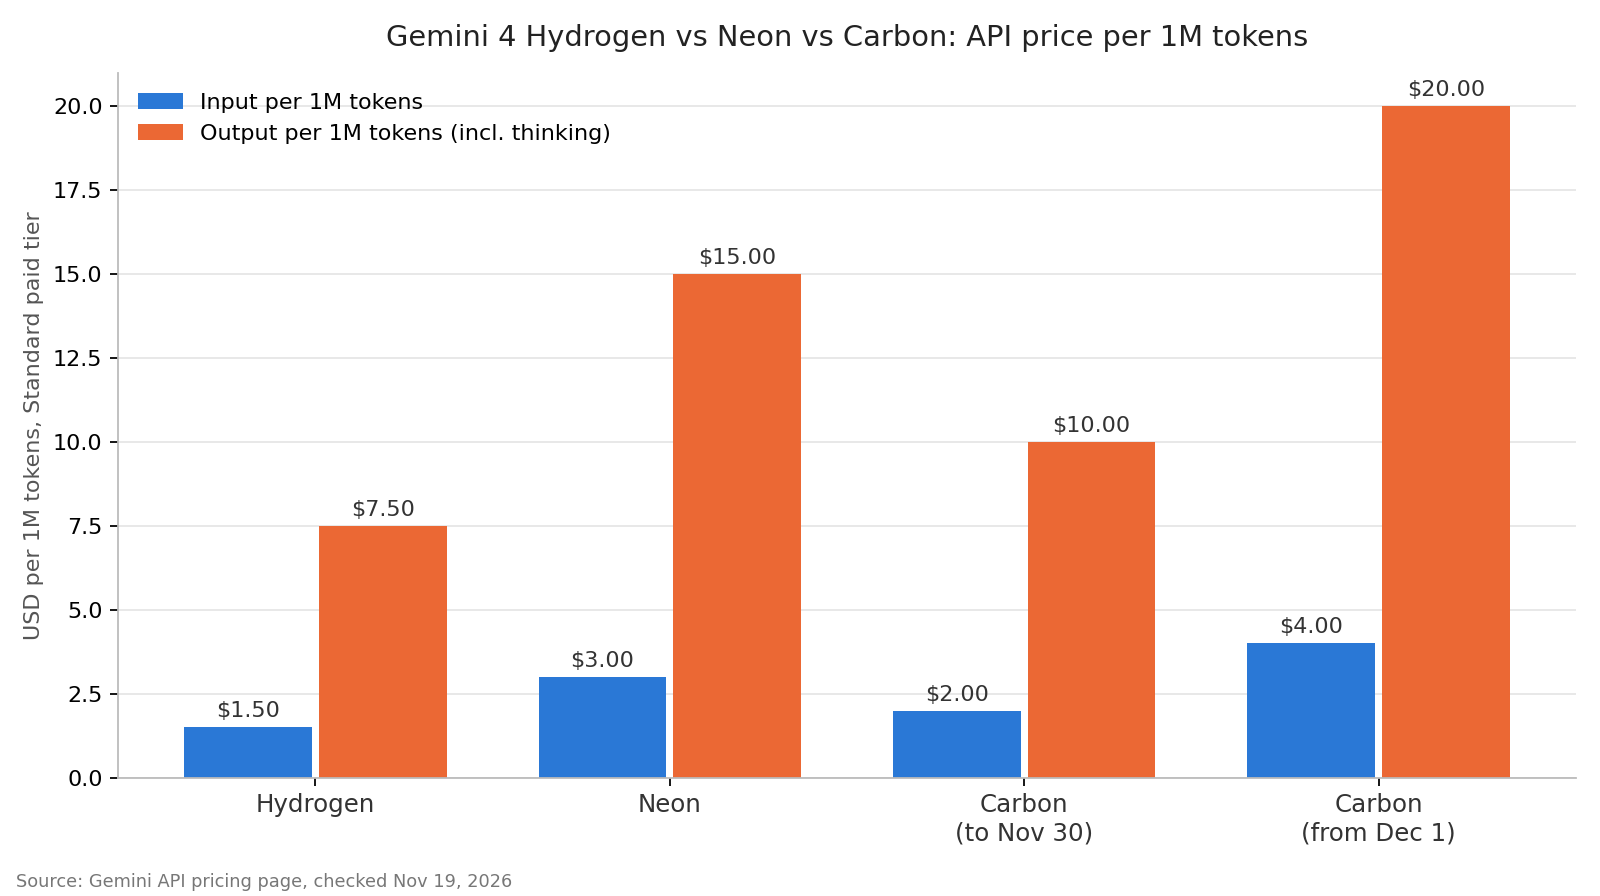
Namun harga per token hanyalah setengah dari tagihan: harga output mencakup token berpikir, dan Carbon memang dirancang untuk berpikir lebih banyak.
Gemini 4 Neon vs Hydrogen: kapan upgrade menguntungkan
Hydrogen dan Neon tampak mirip di atas kertas: tingkat berpikir sama, default sama, jendela konteks sama, tool sama. Neon berharga tepat dua kali lipat per token.
Upgrade menguntungkan saat jawaban Hydrogen memaksa Anda mencoba ulang. Kalau Hydrogen butuh tiga percobaan untuk menyelesaikan refaktorisasi multi-file yang Neon selesaikan sekali jalan, model yang lebih murah justru menjadi yang lebih mahal.
Dua perbedaan praktis:
- Paket gratis. Hydrogen punya paket API gratis untuk prototyping. Neon tidak, jadi Anda butuh proyek paket berbayar sebelum panggilan pertama. Di paket gratis itu, Google dapat menggunakan data Anda untuk meningkatkan produknya.
- Harga batch. Keduanya memangkas harga menjadi setengah di mode Batch: Hydrogen turun ke $0,75 / $3,75 dan Neon ke $1,50 / $7,50. Batch job Neon setiap malam berharga sama per token dengan panggilan Hydrogen real-time.
Jika Anda sudah menjalankan Hydrogen sebagai worker cepat di bawah Carbon sebagai planner, lihat uraian kami tentang pola orchestrator Gemini 4 Hydrogen. Neon memberi setup tersebut jalur ketiga untuk langkah-langkah dengan tingkat kesulitan menengah.
Biaya per tugas: contoh perhitungan
Berikut satu tugas agent dengan 40.000 token input dan 8.000 token output (termasuk berpikir), dihitung dengan tarif Standard paket berbayar:
| Model | Biaya input | Biaya output | Per tugas | Per 1.000 tugas |
|---|---|---|---|---|
| Hydrogen | $0,060 | $0,060 | $0,12 | $120 |
| Neon | $0,120 | $0,120 | $0,24 | $240 |
| Carbon (hingga 30 Nov) | $0,080 | $0,080 | $0,16 | $160 |
| Carbon (mulai 1 Des) | $0,160 | $0,160 | $0,32 | $320 |
Tabel ini mengasumsikan setiap model memakai jumlah token yang sama, padahal tidak. Google menyatakan Carbon menghabiskan lebih banyak token berpikir per giliran dan Neon menyelesaikan dengan token output lebih sedikit dibanding Carbon. Jika Carbon butuh 12.000 token output untuk tugas yang sama, biayanya pada Desember naik menjadi $0,40 per tugas, dan selisihnya dengan Neon melebar dari $0,08 menjadi $0,16. Jumlah token ini bersifat ilustratif; ukur sendiri sebelum menyusun anggaran.
Tiga cara memangkas tagihan:
- Implicit caching. Berjalan secara default pada prompt minimal 4.096 token dan memberi diskon 95% untuk input yang di-cache. Letakkan system prompt dan definisi tool yang stabil di awal agar masuk ke cache.
- Tingkat berpikir. Google menyarankan menjalankan eval Anda di keempat tingkat dan memilih yang terendah yang masih memenuhi standar kualitas Anda.
xhighmenghabiskan token dan latensi paling besar. - Mode batch. Pekerjaan yang tidak mendesak sebaiknya dijalankan di mode Batch dengan harga setengah dari Standard.
Untuk linimasa lengkap harga Carbon, baca panduan harga Gemini 4 Carbon kami.
Berpindah di antara ketiganya: apa yang berubah di kode Anda
Berpindah antar model Gemini 4 tidak memerlukan perubahan skema request. Anda cukup mengubah string model dan, biasanya, thinking_level:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Find the race condition in this retry queue and propose a fix.",
    "generation_config": { "thinking_level": "high" }
  }'
Saat memindahkan beban kerja:
- Tetapkan
thinking_levelsecara eksplisit. Default Carbon adalahmedium; Neon dan Hydrogenhigh. Pergantian tanpa pengaturan eksplisit mengubah biaya dan latensi. - Gunakan proyek paket berbayar untuk Neon dan Carbon. Kunci paket gratis hanya bisa mengakses Hydrogen dan Flash-Lite.
- Buang parameter sampling. Panduan migrasi Neon menyebut
temperature,top_p, dantop_kdiabaikan saat dalam rentang yang valid dan mengembalikan400jika di luar rentang. - Rangkai model dengan
previous_interaction_id. Karena ketiganya berbagi satu skema, Anda bisa merencanakan dengan Carbon, mengimplementasikan dengan Hydrogen, dan mengirim langkah tengah yang rumit ke Neon dalam satu percakapan.
Bandingkan keduanya lewat coding agent Anda dengan Apidog CLI
Cara tercepat menyelesaikan pertanyaan Neon vs Carbon vs Hydrogen adalah mengirim prompt yang sama ke ketiganya dan membandingkan status, latensi, dan penggunaan token. Coding agent Anda bisa membuat dan menjalankan tes tersebut dengan Apidog CLI sementara Anda tetap bekerja.
Instal CLI dan berikan skill Apidog ke agent Anda:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt ke Claude Code, Codex, atau Cursor:
In Apidog project <id>, create a test scenario named "Gemini 4 model compare"
that POSTs to https://generativelanguage.googleapis.com/v1beta/interactions
with model {{model}}, thinking_level "high" and the prompt in {{prompt}}.
Assert status 200 and a non-empty output, and save the usage block to a variable.
Run it once each for gemini-4-hydrogen, gemini-4-neon and gemini-4-carbon,
then give me a table of latency and token usage per model.
Agent membaca skema payload, memvalidasi file-nya, membuat skenario, dan menjalankannya tiga kali, hanya mengganti modelnya:
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-hydrogen" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-neon" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-carbon" -r cli,json
Simpan GEMINI_API_KEY di environment Apidog. Tambahkan --upload-report untuk melihat setiap eksekusi di aplikasi, dan masukkan perintah yang sama ke CI dengan -r junit untuk menangkap regresi saat Google memperbarui model. Panduan kami tentang Apidog CLI di Claude Code membahas seluruh setup ini dari awal hingga akhir. Paket Gratis Apidog mencakup tim hingga 4 pengguna.
FAQ
Apakah Gemini 4 Neon lebih baik dari Gemini 4 Carbon? Tidak di semua aspek. Carbon adalah model penalaran terkuat Google. Neon menukar sebagian kedalaman dengan penyelesaian lebih cepat dan token output lebih sedikit, cocok untuk pekerjaan kompleks yang sering berjalan.
Apakah Gemini 4 Neon gratis? Tidak. Neon hanya tersedia di paket berbayar Gemini API, serta di Google AI Studio dengan paket Google AI Pro dan Ultra. Hydrogen adalah model Gemini 4 dengan paket API gratis.
Apakah Neon lebih murah dari Carbon? Per token, hanya mulai 1 Desember 2026. Hingga 30 November, tarif perkenalan Carbon $2 / $10 masih mengalahkan $3 / $15 milik Neon. Setelahnya, Carbon berharga $4 / $20 dan Neon 25% lebih murah per token, belum menghitung token berpikir Carbon yang jauh lebih besar.
Apakah Gemini 4 Neon, Carbon, dan Hydrogen punya jendela konteks yang sama? Ya. Ketiganya berbagi jendela terpadu 1.048.576 token untuk input, berpikir, dan output, dengan batas output sinkron 65.536 token dan long decode hingga 1 juta token.
Bisakah saya memakai Neon, Carbon, dan Hydrogen dalam satu workflow? Ya. Ketiganya berbagi skema request, jadi Anda bisa meneruskan previous_interaction_id dari giliran satu model ke model lain. Rencanakan dengan Carbon, implementasikan dengan Hydrogen, dan serahkan langkah di antaranya kepada Neon.
Model Gemini 4 mana yang paling cepat? Hydrogen. Google melabeli Hydrogen cepat, Neon sedang, dan Carbon cermat.