
Level thinking Gemini 4 Neon memberi Anda empat pengaturan seberapa keras model bernalar sebelum menjawab: low, medium, high, dan xhigh. Neon menggunakan high sebagai default. Google menyarankan Anda tetap menggunakan high untuk sebagian besar pekerjaan kompleks dan beralih ke xhigh hanya ketika high gagal pada masalah sulit yang membutuhkan banyak langkah, karena xhigh membakar lebih banyak token dan membutuhkan waktu lebih lama.
Apa itu level thinking Gemini 4 Neon?
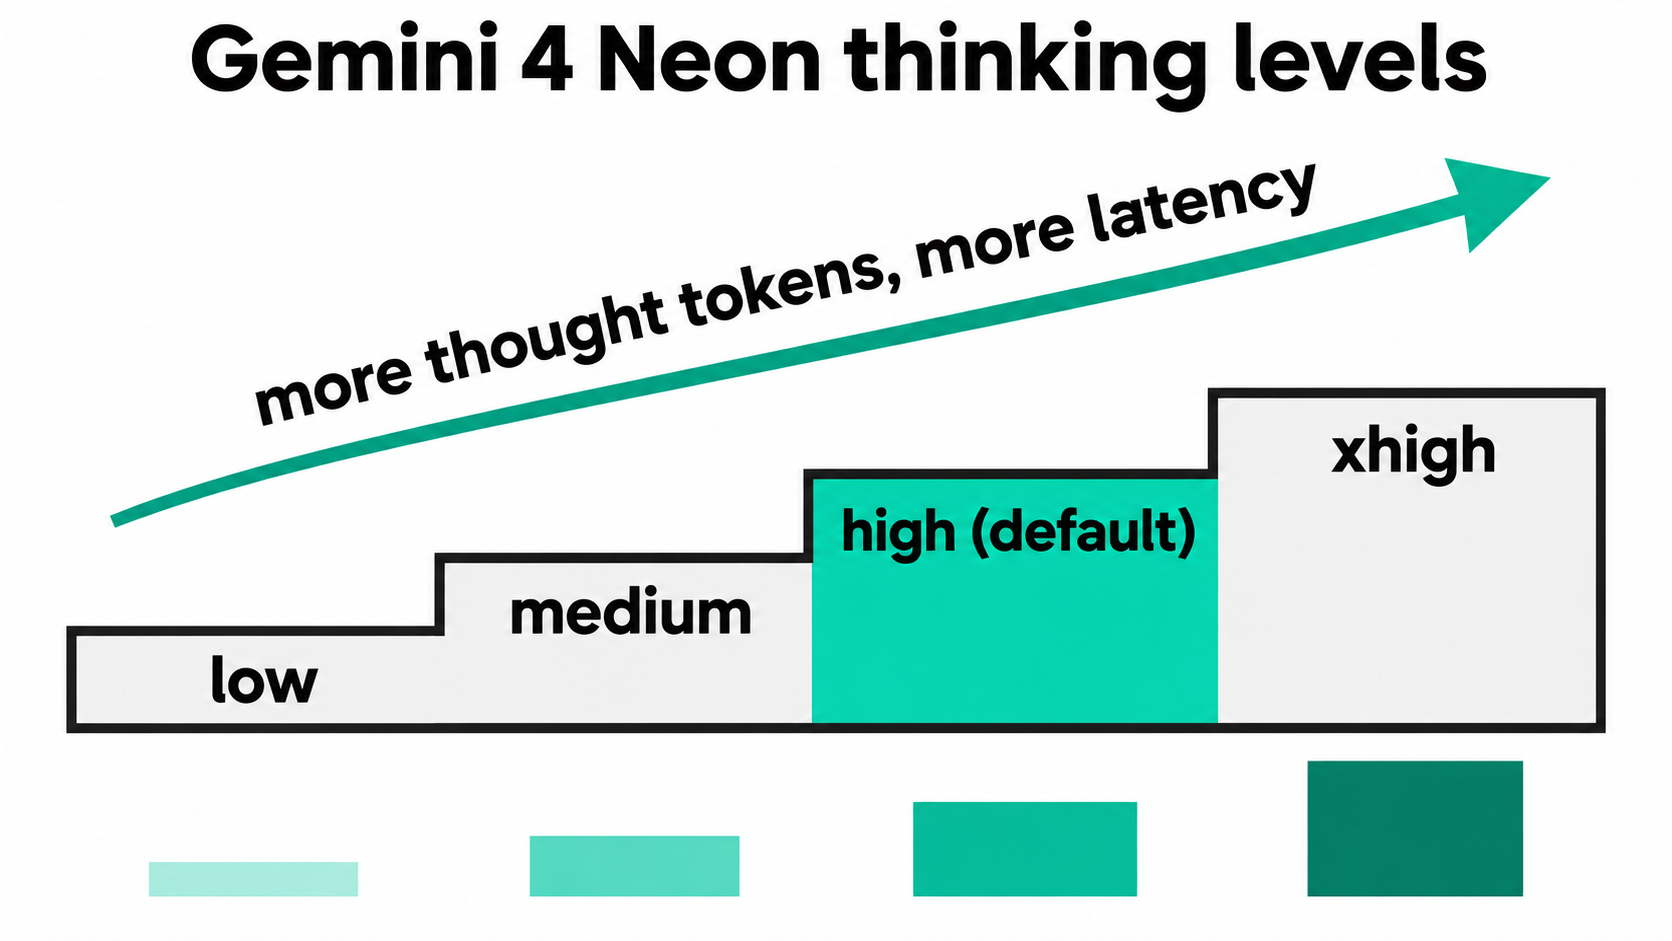
Level thinking adalah nilai parameter thinking_level yang menentukan seberapa banyak penalaran internal yang dilakukan gemini-4-neon sebelum menulis balasan. Neon mendukung empat level: low, medium, high (default), dan xhigh. Level yang lebih tinggi menggunakan lebih banyak token pemikiran dan menambah latensi; level yang lebih rendah menjawab lebih cepat dan lebih murah.
Berikut cara panduan thinking dari Google mendeskripsikan setiap level untuk Neon:
thinking_level |
Penggunaan token | Saran penggunaan dari Google |
|---|---|---|
low |
Token paling sedikit, latensi terendah | Chat cepat, pemrosesan throughput tinggi; tetap mumpuni untuk tugas agentic |
medium |
Penggunaan token lebih rendah, respons lebih cepat | Coding interaktif, prototipe UI langsung, panggilan tool yang sensitif terhadap latensi |
high (default) |
Kecerdasan dan kecepatan yang seimbang | Coding kompleks, eksekusi agentic, pemanggilan tool, pekerjaan pengetahuan multimodal |
xhigh |
Token paling banyak, penalaran paling dalam | Rekayasa multi-langkah yang sulit, masalah analitis dan ilmiah ketika high tidak memadai |
Dua nilai yang mungkin Anda harapkan tidak ada. Neon menolak minimal dengan error, sehingga kode yang disalin dari aplikasi Gemini 3 Flash akan rusak jika mengirim nilai tersebut. Dan thinkingBudget berbasis jumlah token yang lama sudah tidak digunakan lagi di Gemini 4: jika dikirim sendiri, akan dipetakan ke level terdekat dengan peringatan; jika dikirim bersama thinkingLevel, akan mengembalikan 400.
Bagaimana default Neon dibandingkan dengan model Gemini 4 lainnya?
Neon memulai satu langkah lebih tinggi dari model saudara yang lebih besar. Menurut catatan rilis Gemini 4 Neon, Neon dan Hydrogen default ke high dan mendukung xhigh, sedangkan Carbon dan Argon default ke medium dan maksimal di high.
| Model | Level default | Level yang didukung |
|---|---|---|
gemini-4-neon |
high |
low, medium, high, xhigh |
gemini-4-hydrogen |
high |
low, medium, high, xhigh |
gemini-4-carbon |
medium |
low, medium, high |
gemini-4-argon |
medium |
low, medium, high |
Hal ini penting saat Anda mengganti model. Pindahkan beban kerja Carbon ke Neon tanpa mengatur thinking_level dan setiap permintaan akan naik dari penalaran medium ke high, yang mengubah jumlah token Anda. Jika Anda mempertimbangkan model yang lebih besar, perbandingan Gemini 4 Carbon vs Argon kami membahas perbedaan itu.
Bagaimana cara mengatur thinking_level di Gemini API?
Neon berjalan pada tier berbayar baik untuk Interactions API maupun generateContent. Nama field-nya berbeda di antara keduanya.
Interactions API: taruh thinking_level di dalam generation_config.
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent: gunakan thinkingLevel di dalam generationConfig.thinkingConfig.
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
Di Python SDK, panggilan Interactions menerima generation_config={"thinking_level": "high"}, dan panggilan generateContent menerima thinking_config=types.ThinkingConfig(thinking_level="low"). Jangan sertakan temperature, top_p, dan top_k: Google menyatakan Neon mengabaikan nilai dalam rentang dan menolak nilai di luar rentang dengan 400. Untuk panduan lengkap permintaan pertama pada desain API yang sama, lihat panduan Gemini 4 Hydrogen API kami.
Kapan sebaiknya menggunakan high vs xhigh?
Gunakan high sebagai default dan naikkan tugas ke xhigh hanya setelah high gagal memenuhi standar kualitas Anda pada tugas tersebut. Posting peluncuran Google menggambarkan xhigh sebagai "penalaran multi-langkah yang lebih dalam untuk beban kerja rekayasa, analitis, dan ilmiah tersulit."
Pilih xhigh ketika:
- Tugas memiliki banyak langkah yang saling bergantung dan kesalahan awal merusak hasil, seperti refactor multi-file atau audit konkurensi.
highmemberikan jawaban yang percaya diri namun salah pada set evaluasi Anda, bukan sekadar lebih lambat.- Latensi tidak terlalu penting, seperti pada job latar belakang, review malam hari, atau analisis batch.
- Jawaban yang salah lebih mahal daripada token, seperti pada patch keamanan atau perhitungan finansial.
Tetap di high (atau turun lebih rendah) ketika:
- Prompt bersifat ekstraksi atau pemformatan. Google memperingatkan bahwa
xhigh"dapat menyebabkan overthinking atau menghabiskanmax_output_tokenspada prompt yang lebih sederhana seperti ekstraksi teks atau JSON." - Ada pengguna yang menunggu. Chat, autocomplete, dan panggilan tool langsung cocok dengan
mediumataulow. - Anda menjalankan volume tinggi. Setiap token pemikiran tambahan akan ditagih, dan selisihnya berlipat ganda di seluruh permintaan.
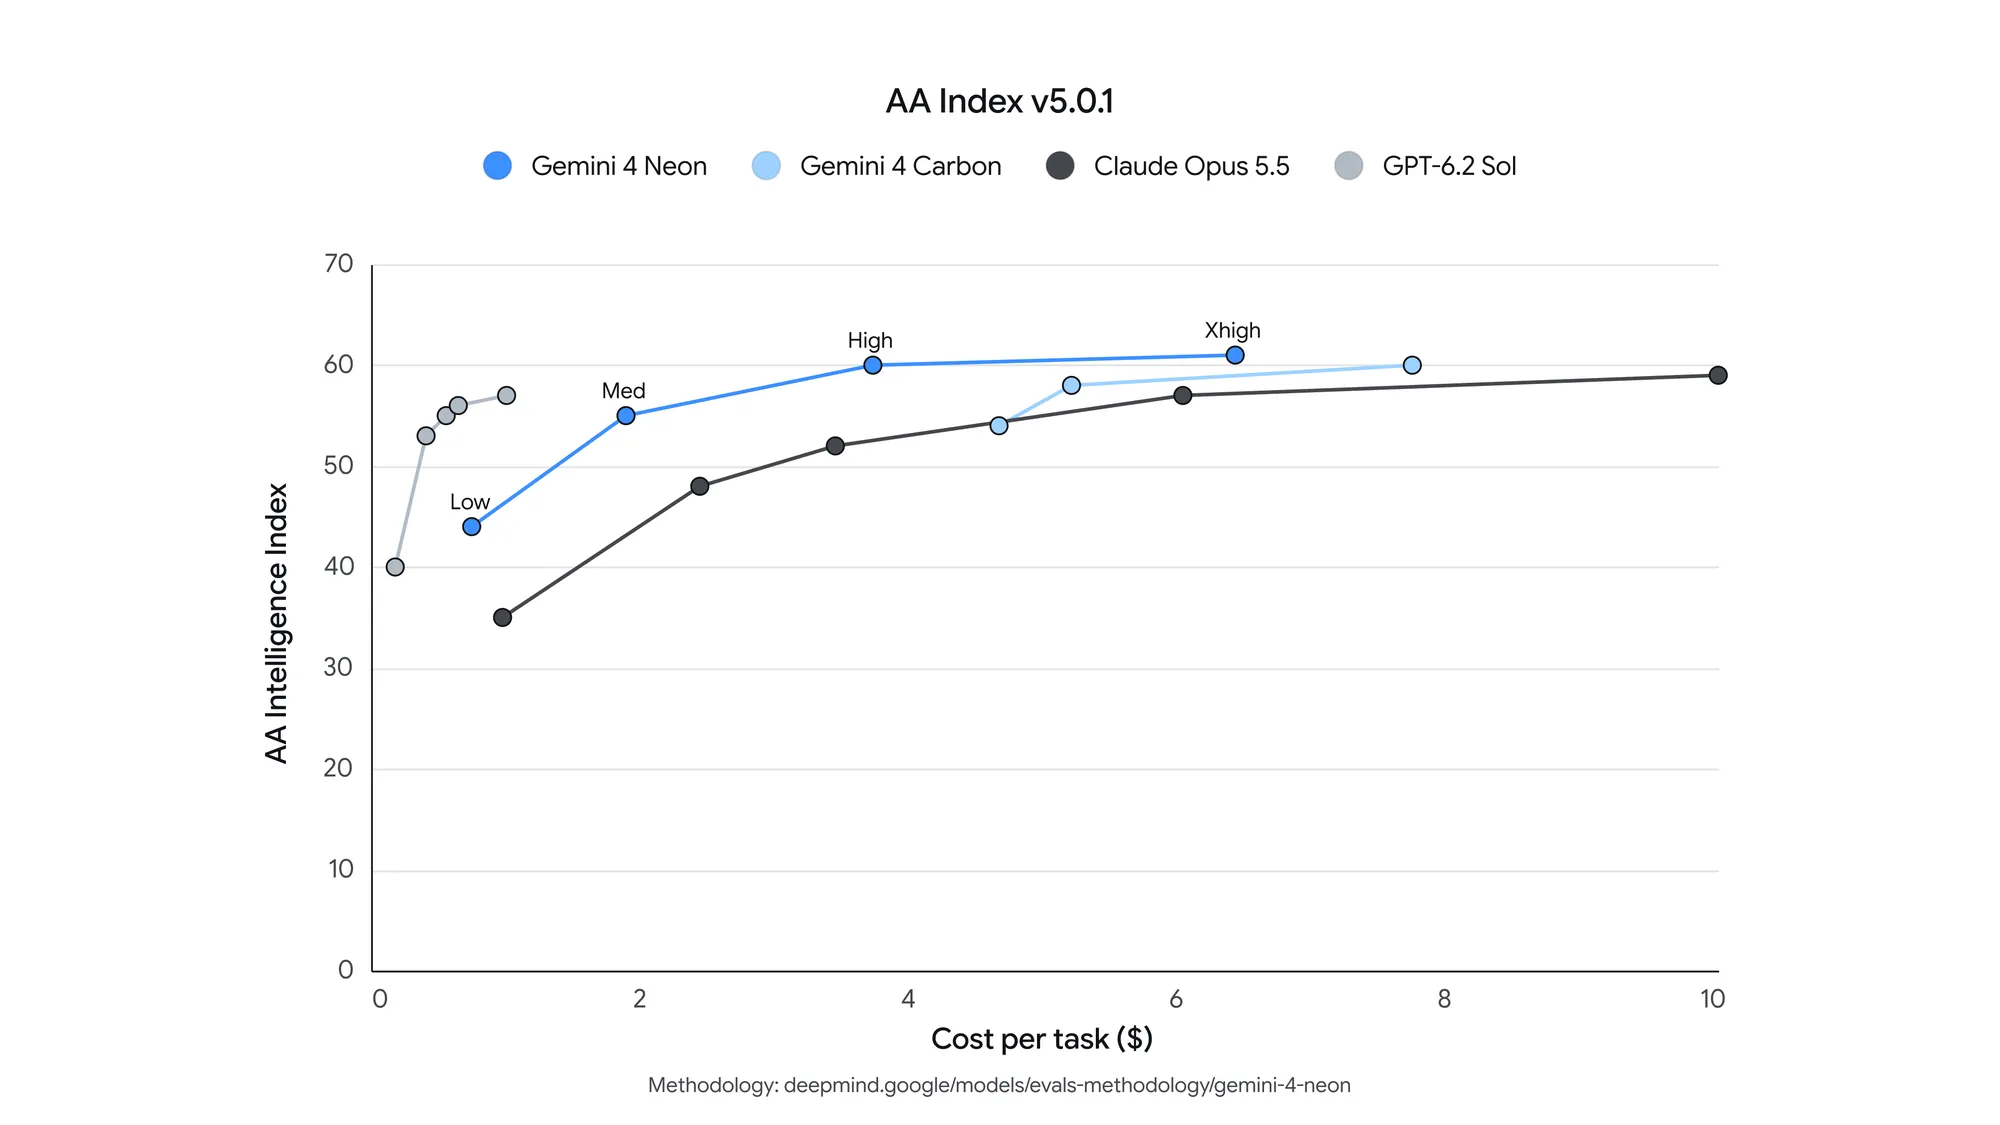
Angka benchmark Google mendukung pembagian ini. Dalam pengumuman peluncuran mereka, Neon pada xhigh mendapatkan skor 61 di Artificial Analysis Intelligence Index, berada di peringkat ketiga. Pada default high, Google melaporkan biaya per tugas 32% lebih rendah daripada Carbon. Itu angka Google, bukan pengujian kami, tetapi menunjukkan trade-off: xhigh membeli skor tertinggi Neon, high membeli efisiensi.
Berapa biaya setiap level thinking?
Setiap level memiliki harga per token yang sama; yang berubah adalah berapa banyak token yang Anda bayar. Neon berbiaya $3,00 per 1 juta token input dan $15,00 per 1 juta token output, dan halaman harga Google menyatakan tarif output mencakup token pemikiran. Input yang di-cache turun menjadi $0,15 per 1 juta melalui caching implisit (caching eksplisit tidak didukung di Neon). Tidak ada tier gratis untuk model ini.
Jadi biaya sebuah level adalah token pemikiran yang ditambahkan, dikalikan $15 per juta. Berikut perhitungan untuk satu permintaan dengan 2.000 token input dan jawaban terlihat 800 token. Jumlah token pemikiran bersifat hipotetis, dipilih untuk menunjukkan perhitungan, bukan hasil pengukuran:
| Token pemikiran (hipotetis) | Biaya input | Biaya output + pemikiran | Total per permintaan | Per 10.000 permintaan |
|---|---|---|---|---|
| 500 | $0,006 | $0,0195 | $0,0255 | $255 |
| 2.000 | $0,006 | $0,042 | $0,048 | $480 |
| 8.000 | $0,006 | $0,132 | $0,138 | $1.380 |
Pemikiran dengan cepat mendominasi tagihan. Pada 8.000 token pemikiran, penalaran mencapai 87% dari biaya permintaan. Itulah sebabnya saran Google sendiri adalah menjalankan evaluasi Anda pada keempat level dan "pilih thinking_level terendah yang memenuhi standar kualitas Anda." Panduan level thinking Gemini 3.8 Flash kami membahas trade-off yang sama pada model yang lebih murah jika Anda ingin membandingkan.
Bagaimana cara mengukur token dan latensi per level?
Jalankan prompt yang sama pada setiap level dan baca blok usage. Di Interactions API, objek usage pada respons melaporkan total_input_tokens, total_output_tokens, dan total_thought_tokens secara terpisah. Di generateContent, token pemikiran muncul sebagai usageMetadata.thoughtsTokenCount.
Loop ini mengirim satu prompt pada keempat level dan mencetak token pemikiran plus waktu wall-clock:
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
Jalankan pada 10 hingga 20 prompt dari beban kerja nyata Anda. Satu prompt tidak memberi banyak informasi; satu set menunjukkan di mana high dan xhigh mulai berbeda pendapat soal kualitas.
Atur timeout klien HTTP Anda tinggi selama pengujian. Catatan migrasi Google menyatakan prompt yang sulit dapat memakan waktu beberapa menit dan menyarankan timeout setidaknya 15 menit, atau eksekusi latar belakang.
Mengapa xhigh kadang mengembalikan jawaban kosong?
max_output_tokens membatasi pemikiran dan output terlihat secara bersama. Jika Neon menghabiskan seluruh anggaran untuk bernalar, interaksi berhenti dengan status incomplete dan mengembalikan jawaban yang terpotong atau kosong, dan Anda tetap membayar token pemikiran yang dihasilkan.
Tiga aturan dari dokumentasi Google menghindari hal ini:
- Hapus batas rendah yang lama. Jika aplikasi Anda meng-hardcode nilai seperti 8.192, naikkan ke 65.536, batas sinkron default.
- Turunkan level, bukan batasnya. Untuk memangkas biaya atau latensi, turun ke
mediumataulowalih-alih memperkecilmax_output_tokens. - Gunakan mode latar belakang untuk pekerjaan panjang. Untuk jawaban melebihi 65.536 token, atur
backgroundketruedanmax_output_tokenshingga 1.048.576 dikurangi input Anda. Input, pemikiran, dan output berbagi satu jendela 1 juta token. Panduan output panjang Gemini 4 Argon kami membahas pola polling.
Biarkan coding agent Anda melakukan benchmark keempat level dengan Apidog CLI
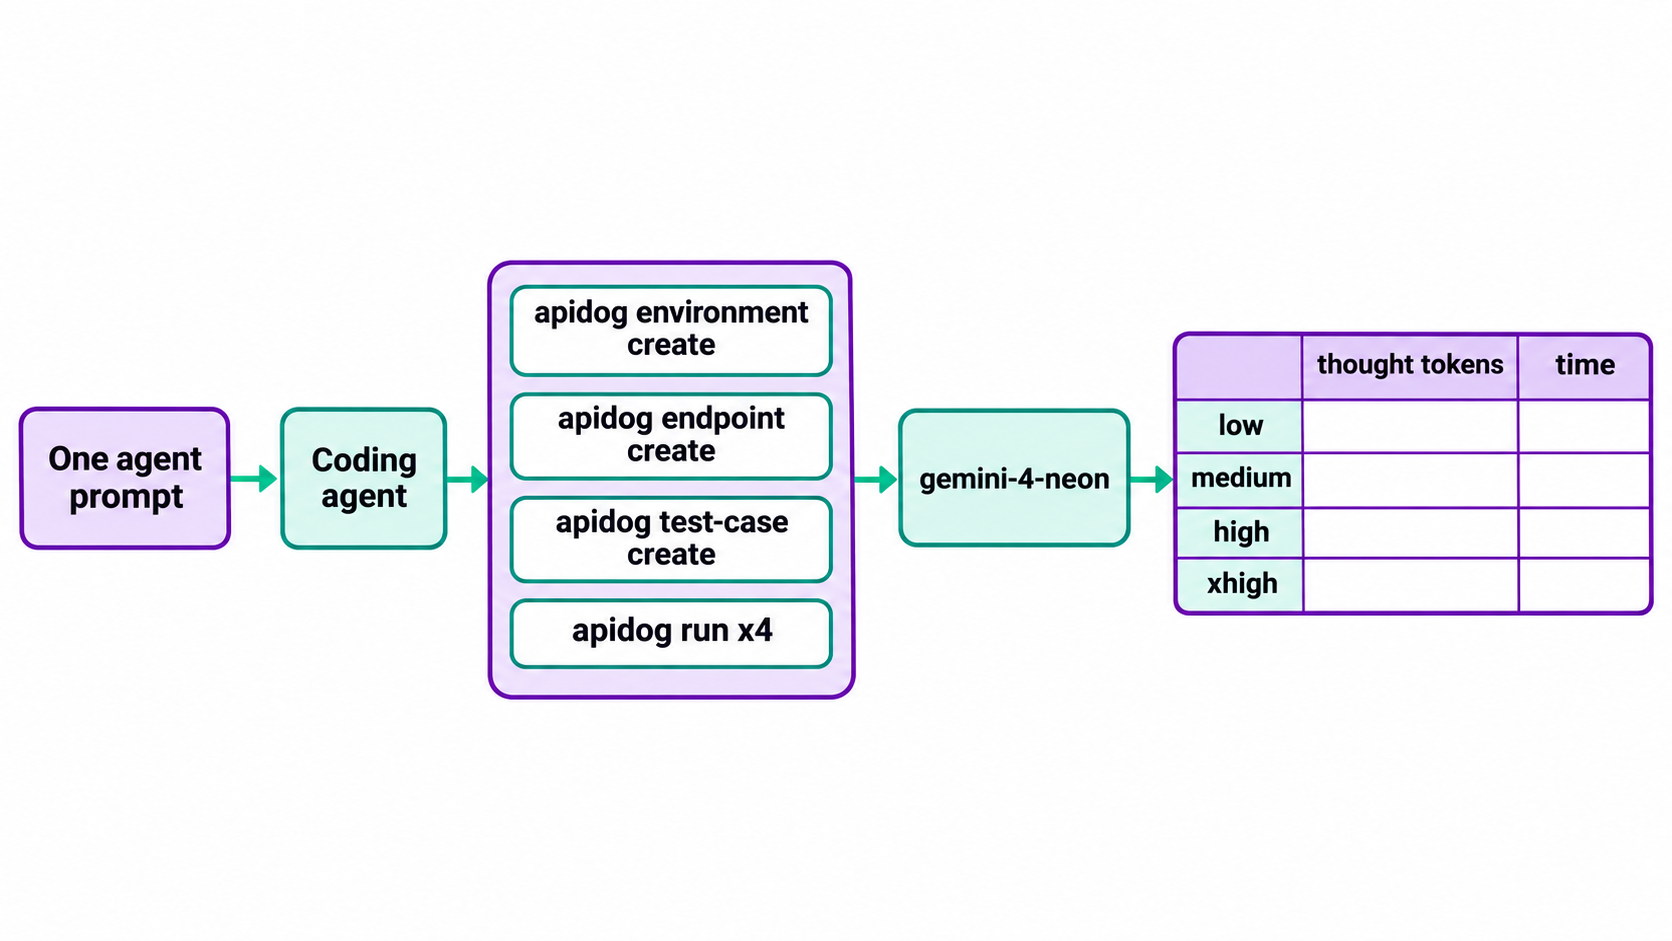
Menjalankan ulang loop itu secara manual lama-lama melelahkan. Sebagai gantinya, biarkan coding agent Anda (Claude Code, Codex, Cursor) membuat satu tes yang dapat digunakan kembali dengan Apidog CLI dan menjalankannya ulang di setiap level setiap kali Anda ingin angka baru.
Siapkan sekali:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt ke agent Anda:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
Agent akan membaca setiap skema payload, memvalidasi JSON-nya, menulis resource, dan mengulang eksekusi:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
Assertion status is "completed" menangkap jebakan incomplete dari bagian sebelumnya, sehingga level yang kehabisan anggaran gagal secara nyata alih-alih mengembalikan string kosong. Ganti -r cli,json dengan -r junit dan eksekusi yang sama masuk ke CI; panduan CI/CD Apidog CLI menunjukkan pipeline-nya, dan Apidog CLI di Claude Code membahas setup agent. Paket Free Apidog mencakup hingga 4 pengguna.
FAQ
Apa level thinking default untuk Gemini 4 Neon? high. Anda tidak perlu mengirim thinking_level untuk mendapatkannya. Carbon dan Argon default ke medium, jadi atur level secara eksplisit saat Anda migrasi dari mereka.
Apakah Gemini 4 Neon mendukung minimal thinking? Tidak. Neon mendukung low, medium, high, dan xhigh, dan menolak minimal dengan error. Gunakan low untuk respons tercepat dan termurah.
Apakah token pemikiran ditagih di Gemini 4 Neon? Ya. Token pemikiran ditagih pada tarif output $15,00 per 1 juta. Google menghitung setiap token yang diproses model, termasuk token pemikiran.
Apakah saya masih bisa menggunakan thinkingBudget dengan Gemini 4 Neon? Itu sudah tidak digunakan lagi pada model Gemini 4. Jika dikirim sendiri, akan dipetakan ke thinkingLevel terdekat dan mengembalikan peringatan. Jika dikirim bersama thinkingLevel, permintaan gagal dengan 400.
Apakah xhigh selalu lebih akurat daripada high? Tidak selalu. Google menyatakan xhigh dapat overthinking pada prompt sederhana seperti ekstraksi teks atau JSON dan dapat menghabiskan max_output_tokens. Uji keduanya pada prompt Anda sendiri dan gunakan level terendah yang lolos.
Apakah saya bisa menggunakan level thinking Gemini 4 Neon secara gratis? Tidak. Gemini 4 Neon tidak tersedia di tier gratis Gemini API. Di Google AI Studio dan Google Antigravity, model ini terikat pada paket berbayar Google AI Pro dan Ultra.