
Benchmark Gemini 4 Neon menempatkannya di peringkat #1 pada Artificial Analysis Coding Agent Index (58,6), dengan 65,2% pada Terminal-Bench 4.1 dan #2 pada Vals Index (70,9%). Google juga menyatakan biayanya 32% lebih rendah per tugas dibandingkan Gemini 4 Carbon pada level thinking default high. Namun, sebagian besar baris dijalankan pada xhigh, dan beberapa menggunakan harness milik Google sendiri.
Detail terakhir itulah inti tulisan ini. Ikhtisar Gemini 4 Neon kami membahas spesifikasi dan harga. Di sini Anda mendapatkan setiap skor yang dipublikasikan, siapa yang mengukurnya, pada level thinking apa, dan bagaimana mengubah “biaya per tugas” menjadi angka yang dapat Anda bandingkan dengan tagihan Anda sendiri.
Ringkasan benchmark Gemini 4 Neon
Gemini 4 Neon adalah model Gemini 4 kelas menengah Google, dirilis pada 18 November 2026, dengan harga $3 per juta token input dan $15 per juta token output. Hasil publikasinya yang paling kuat ada di coding agentic dan pekerjaan berbasis pengetahuan, di mana model ini menempati peringkat #1 atau #2 di empat papan peringkat independen.
Berikut adalah baris-baris utama dari tulisan peluncuran Google:
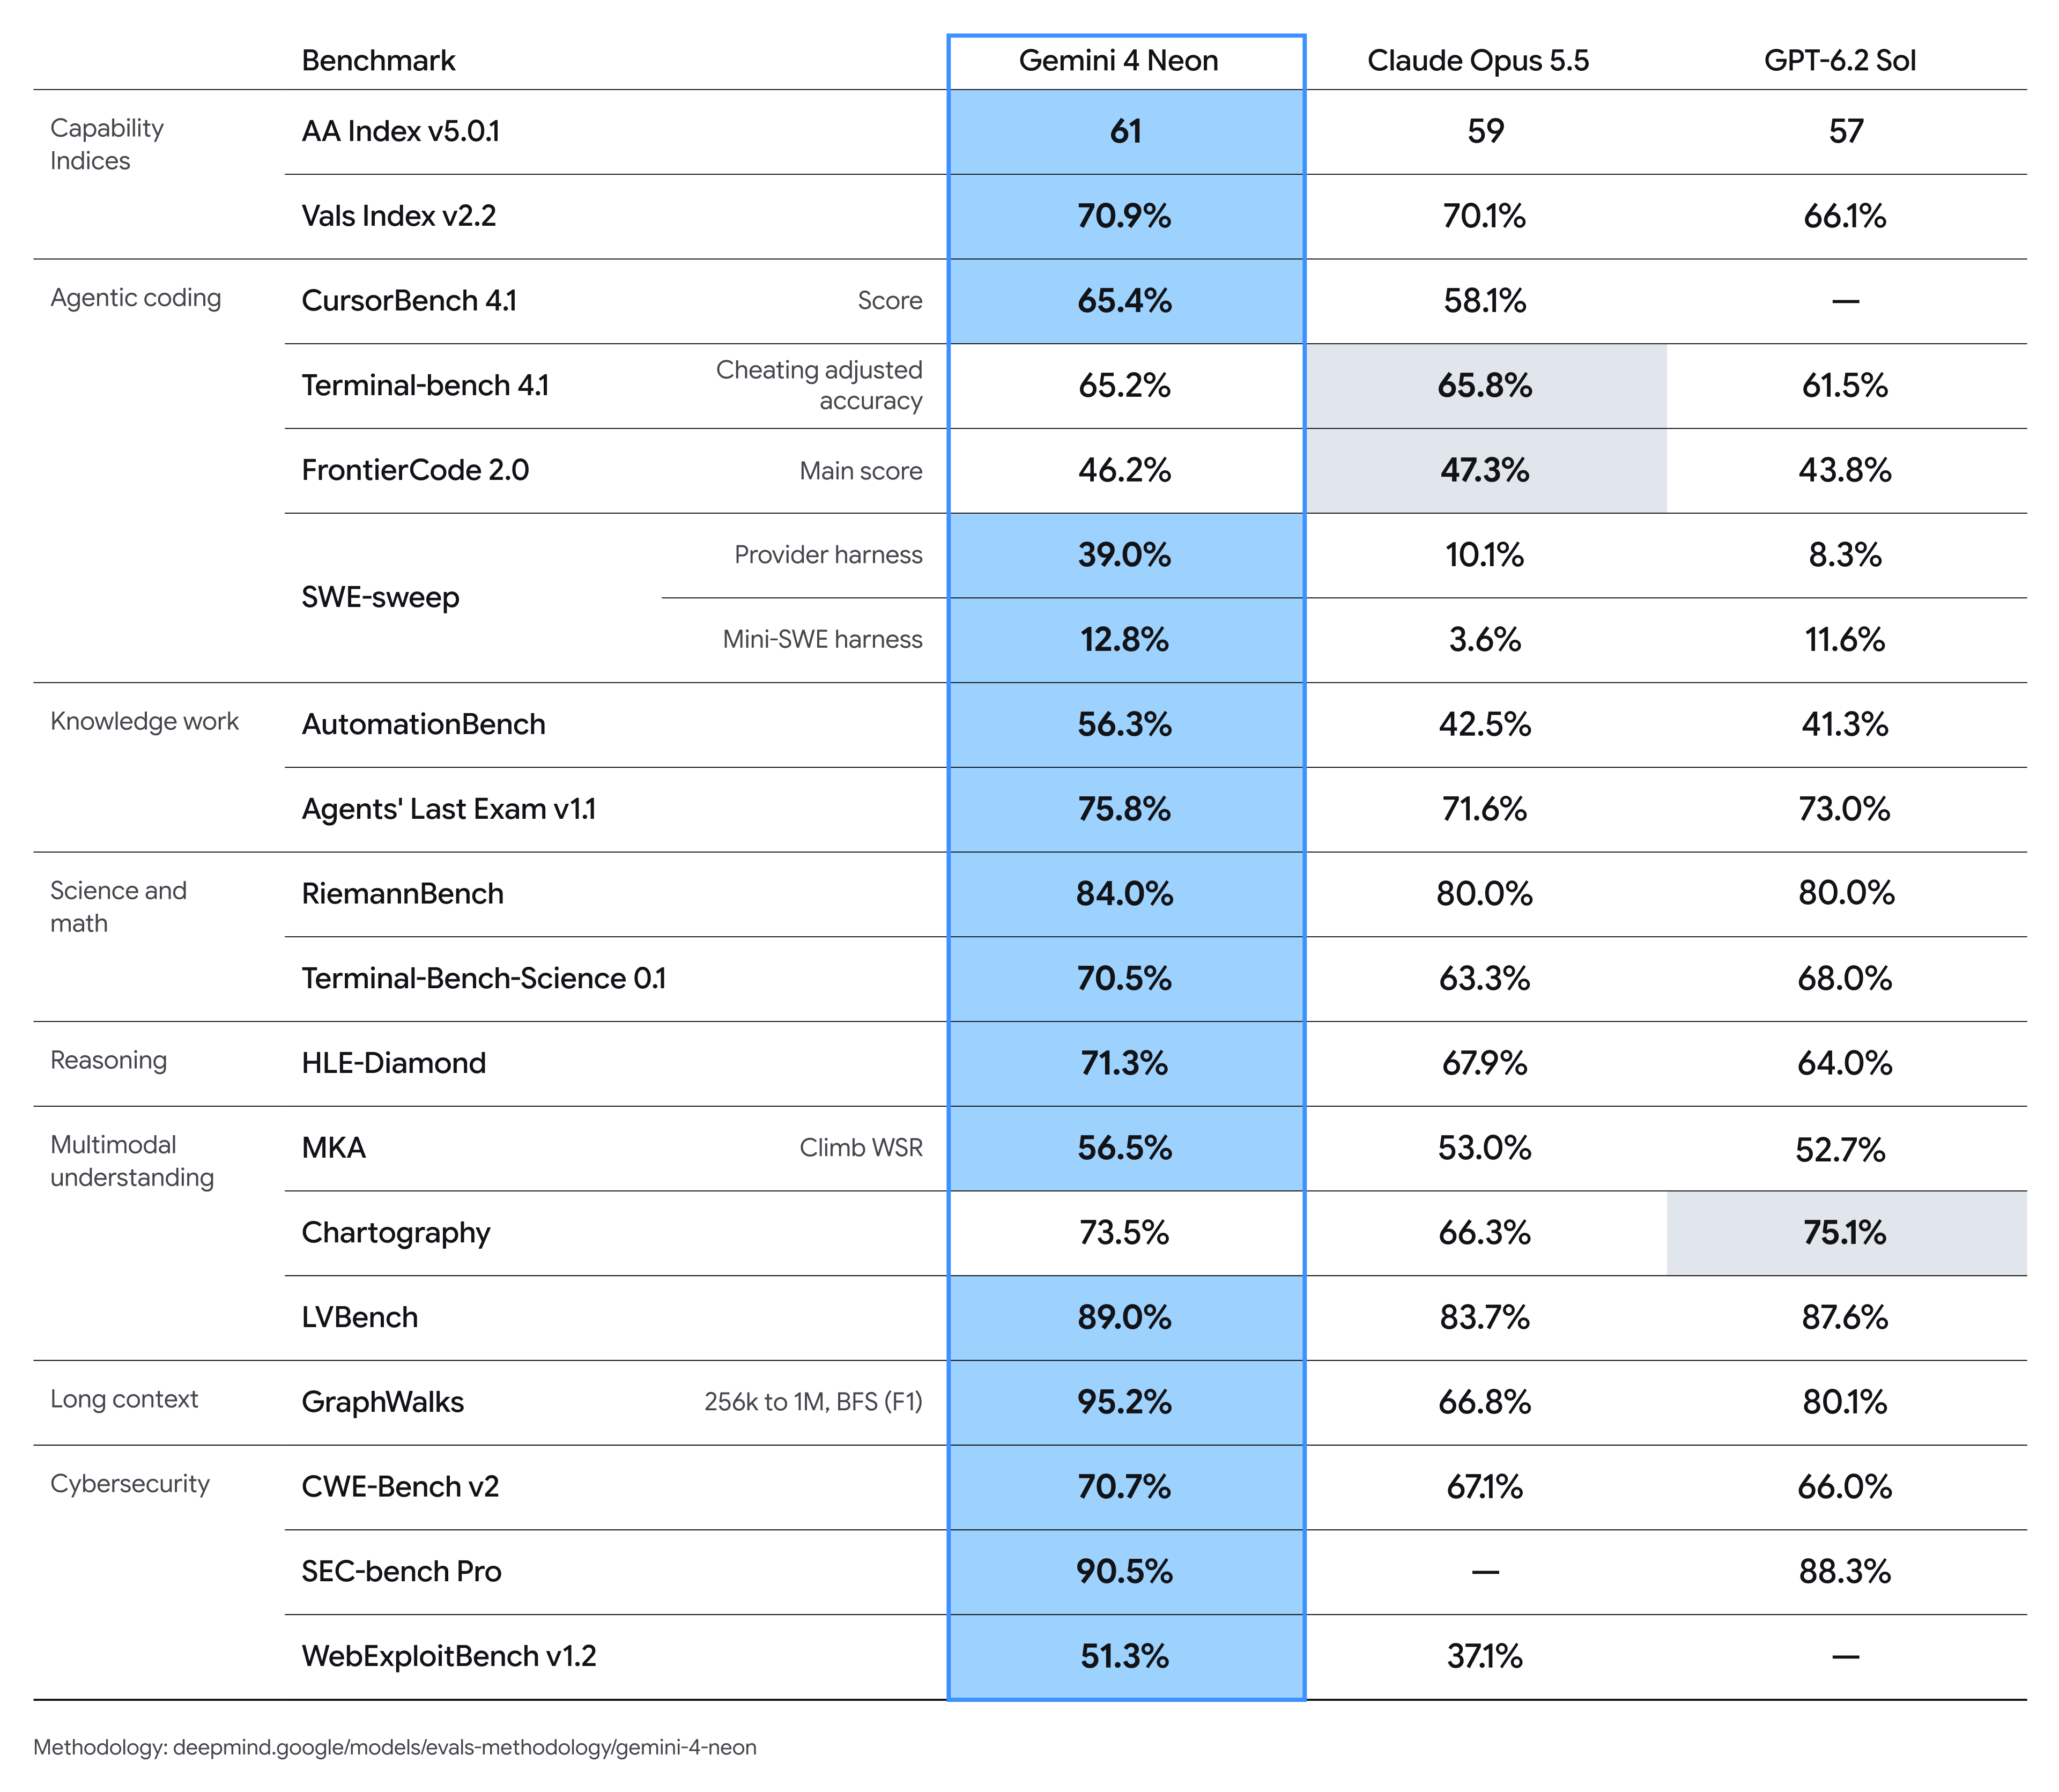
Google juga melaporkan peringkat #1 pada Legal Research Bench dan Tax Agent Bench milik Vals AI.
Benchmark coding Gemini 4 Neon
Coding adalah area dengan argumen terkuat untuk Neon, sekaligus area yang paling bergantung pada harness. PDF metodologi evaluasi Google menjelaskan bagaimana setiap baris coding dihasilkan.
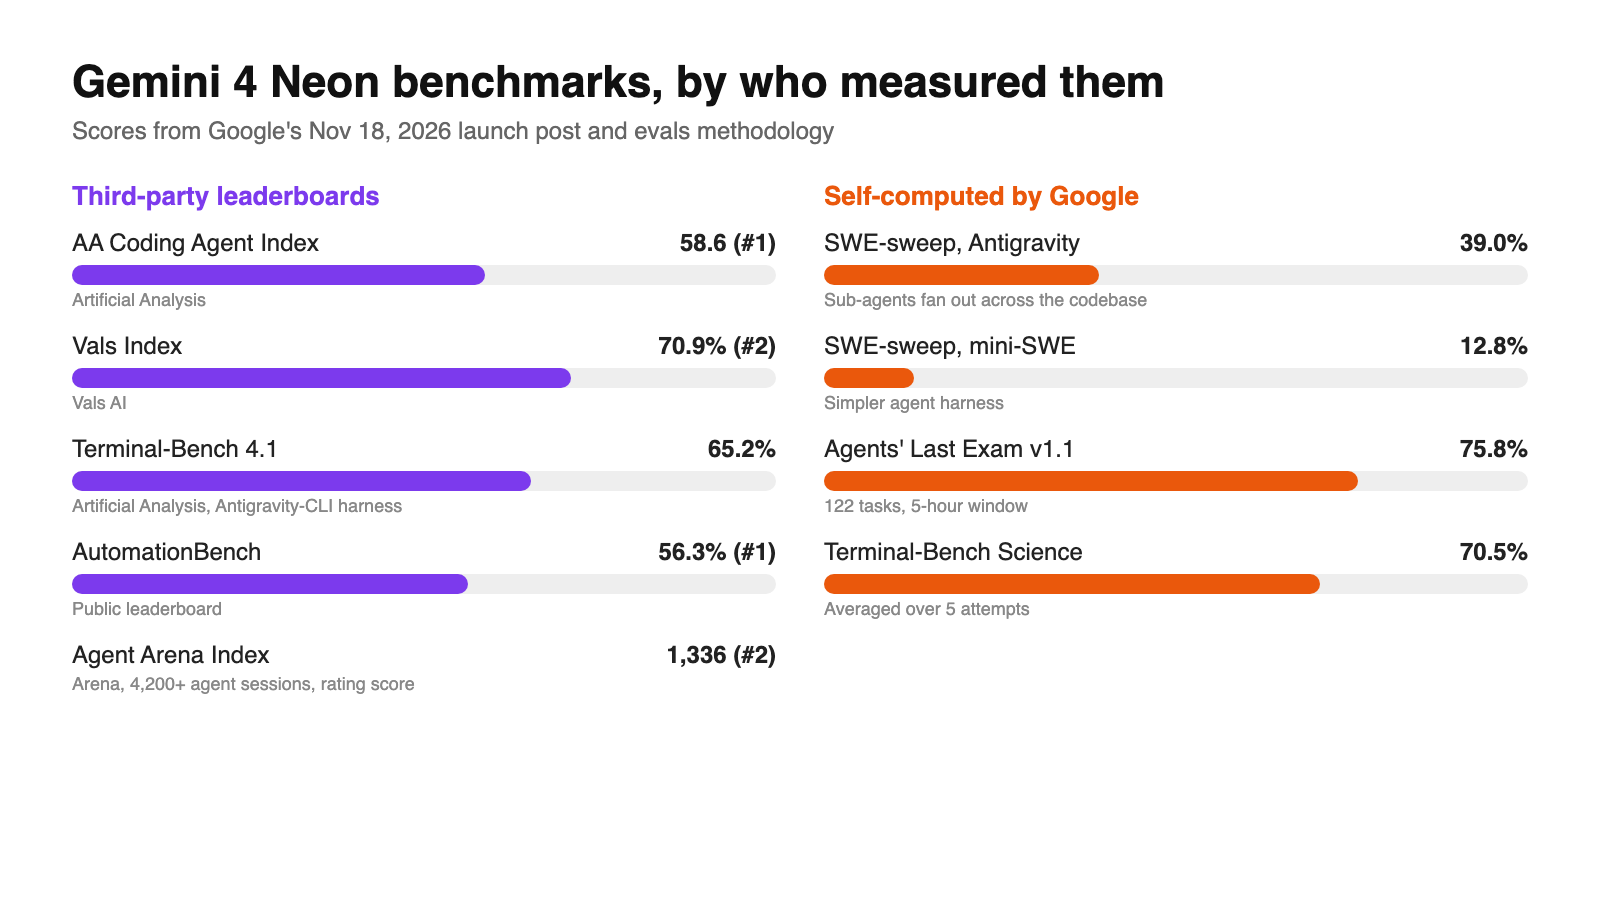
Artificial Analysis Coding Agent Index: 58,6, #1. Ini adalah komposit independen, sehingga menjadi baris yang paling sedikit dipengaruhi oleh setup Google. Anda dapat memeriksa klasemen terkini di Artificial Analysis.
Terminal-Bench 4.1: 65,2%. Artificial Analysis menjalankan Neon menggunakan harness publik Antigravity-CLI versi 1.5.9. Skor model lain berasal dari papan peringkat resmi, dan setiap hasil menggunakan akurasi yang disesuaikan terhadap kecurangan. Ini adil, tetapi Neon berjalan di dalam tooling agent milik Google sendiri.
FrontierCode 2.0: 46,2%. Angka ini berasal dari papan peringkat publik dan dijalankan pada high, default yang Anda dapatkan di produksi. Jika Anda hanya percaya satu angka coding untuk lalu lintas sehari-hari, percayai angka ini.
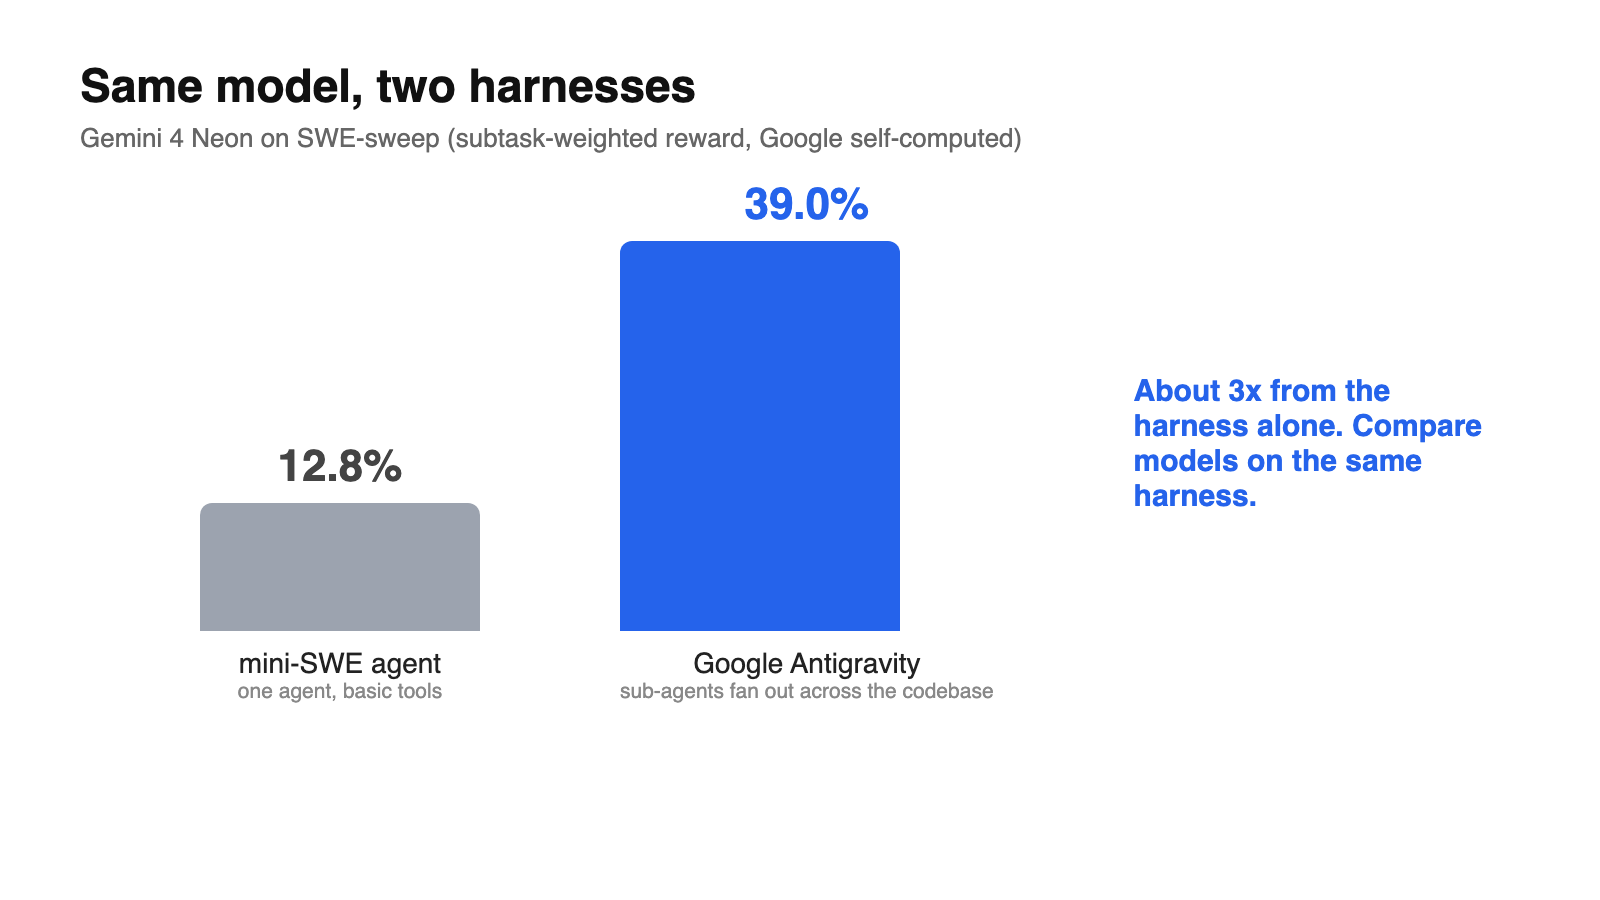
SWE-sweep: 39,0% di Antigravity, 12,8% pada mini-SWE. Keduanya dihitung sendiri oleh Google. Lompatan 3x berasal dari harness: Google mencatat bahwa Antigravity-CLI menyertakan tool default yang menyebarkan sub-agent ke seluruh codebase, yang cocok untuk tugas pencarian bug. Opus 5.5 dijalankan di Claude Code dan GPT-6.2 Sol di Codex untuk perbandingan yang sama. Bacalah 12,8% sebagai model dan 39,0% sebagai model plus tooling terbaiknya.
Benchmark agent dan pekerjaan berbasis pengetahuan
Baris-baris ini penting jika Anda berencana menjalankan Neon tanpa pengawasan selama banyak langkah.
- Agent Arena Index: 1.336, #2. Dibangun dari 4.200+ sesi agent dunia nyata. Google juga menyatakan Neon menempati peringkat #2 di sana untuk steerability, artinya model beradaptasi dengan baik saat pengguna mengoreksinya di tengah tugas.
- AutomationBench: 56,3%, #1. Benchmark Zapier untuk otomasi bisnis, dari papan peringkat publik.
- Vending-Bench 2: $16.843, #1. Simulasi jangka panjang Andon Labs tentang menjalankan bisnis. Skornya adalah uang yang dihasilkan, bukan persentase.
- Agents’ Last Exam v1.1: 75,8%. Dihitung sendiri pada set 122 tugas di dalam Antigravity-CLI 1.4.8 dengan jendela 5 jam per eksekusi. Skor Opus 5.5 berasal dari papan peringkat publik dan skor GPT-6.2 Sol dari system card-nya, jadi setup-nya berbeda.
- Chartography: 73,5%. Membaca bagan profesional yang padat, dihitung sendiri tanpa tool.
Untuk sains dan matematika, Neon mencatat 70,5% pada Terminal-Bench Science (dihitung sendiri, dirata-ratakan dari 5 percobaan), 84,0% pada RiemannBench, dan 71,3% pada HLE-Diamond (dari papan peringkat Artificial Analysis).
Bagaimana Google menghasilkan angka-angka ini
Empat aturan dari metodologi mengubah cara Anda membaca tabel:
- Level thinking tertinggi secara default. “Semua hasil dijalankan dengan Gemini API pada setelan thinking tertinggi kecuali dinyatakan lain.” Itu berarti
xhigh. Hanya FrontierCode 2.0 yang secara eksplisit ditandaihigh. Panggilan produksi default kehigh, jadi perkirakan token thinking lebih sedikit dan kemungkinan skor lebih rendah daripada yang ditunjukkan tabel. - Pass@1, satu percobaan. Tidak ada majority voting atau komputasi test-time paralel, kecuali dinyatakan lain (Terminal-Bench Science merata-ratakan 5 percobaan).
- Angka pesaing dilaporkan sendiri. Skor non-Gemini berasal dari masing-masing penyedia kecuali dinyatakan lain. Opus 5.5 dan GPT-6.2 Sol menggunakan setelan penalaran maksimumnya jika tersedia.
- Filter keamanan aktif, kecuali cyber. Baris keamanan siber dijalankan dengan filter nonaktif.
Panduan level thinking kami membahas kapan xhigh sepadan dengan token tambahannya.
Biaya per tugas: apa arti klaim 32%
Biaya per tugas adalah total pengeluaran untuk menyelesaikan satu tugas benchmark, bukan harga per token. Model dengan harga token lebih tinggi tetap bisa lebih murah per tugas jika mencapai jawaban dalam lebih sedikit langkah dan lebih sedikit token thinking.
Google membuat tiga klaim biaya:
| Klaim | Level thinking | Dibandingkan dengan |
|---|---|---|
| Biaya per tugas 32% lebih rendah, dengan skor AA Intelligence Index yang tinggi | high |
Gemini 4 Carbon |
| Biaya per tugas sekitar 50% hingga 80% lebih rendah pada Vals Index dan Agent Arena | high |
Model frontier pesaing teratas |
| Biaya per tugas 36%+ lebih rendah | xhigh |
Model pesaing pada setelan tertingginya |
Perhatikan ketidaksesuaiannya: baris akurasi sebagian besar menggunakan xhigh, sedangkan penghematan utama 32% berada pada high. Keduanya benar, tetapi tidak pada saat yang sama. Anda mendapatkan penghematan biaya atau skor teratas, dan selisih di antara keduanya perlu Anda ukur sendiri.
Berikut cara memperkirakan biaya per tugas Anda sendiri. Token thinking ditagih sebagai output.
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
Tugas coding dengan 20.000 token input dan 4.000 token output berbiaya $0,06 + $0,06 = $0,12. Jika 15.000 dari token input tersebut mengenai cache, biayanya turun menjadi $0,015 + $0,00225 + $0,06 = sekitar $0,077. Jalankan tugas yang sama pada xhigh dan jumlah output-lah yang berubah, jadi catat token per level, bukan hanya lulus atau gagal. Rincian harga Gemini 4 Neon kami membahas tarif Batch, Flex, dan Priority.
Baris cyber dan keamanan
Skor cyber berasal dari “Gemini 4 Neon for cyber,” yang diberikan kepada defender tepercaya melalui Fairwind Program, bukan melalui API publik.
| Benchmark | Skor | Catatan |
|---|---|---|
| SEC-bench Pro | 90,5% | Tercanggih saat ini, sekitar setengah biaya per tantangan |
| WebExploitBench v1.2 | 51,26% | Tercanggih saat ini, setengah biaya model besar |
| AutoBaxBench (hard tier) | 76% | Tercanggih saat ini, kode yang lebih aman daripada Carbon di setiap tier |
| CWE-bench v2 | 70,7% | Peningkatan 3,4% dibanding Carbon |
| ExploitGym | Tidak disebutkan | Tingkat frontier dengan setengah token Carbon |
Angka keamanan dari tulisan yang sama: Neon menolak 1,98% tugas Terminal-Bench 4.0, mencetak 0,0% kecurangan pada Terminal-Bench 4.0, mengambil jalan pintas pada 2,45% evaluasi kecurangan coding Google, dan lulus 99,2% evaluasi kejujuran agent-nya. Dengan pengaman real-time pada level thinking tertingginya, model ini menahan setiap serangan dalam benchmark injeksi prompt tidak langsung Gray Swan.
Di mana Neon belum unggul
Neon tidak selalu pertama, dan Google mengatakannya:
- Artificial Analysis Intelligence Index: #3 secara keseluruhan, “tepat di belakang model yang lebih besar dan lebih lambat.”
- Vals Index: #2, bukan #1.
- Agent Arena Index: #2.
Google juga masih mengarahkan Anda ke Carbon untuk proyek jangka panjangnya yang paling sulit. Jika Anda memilih di antara tiga model Gemini 4, perbandingan Neon vs Carbon vs Hydrogen kami memetakan trade-off-nya, dan tulisan benchmark Gemini 4 Argon menunjukkan cara membaca tabel model sebelumnya.
Benchmark Gemini 4 Neon sendiri dengan Apidog CLI
Papan peringkat menggambarkan harness Google, bukan produk Anda. Cara tercepat untuk mengetahui apakah Neon sepadan dengan harganya adalah membiarkan coding agent Anda menjalankan prompt yang sama pada high dan xhigh serta mencatat token dan latensi untuk masing-masing.
Tidak ada tier API gratis untuk Neon, jadi Anda memerlukan kunci Gemini API berbayar. Permintaan ini mengikuti format Interactions API yang didokumentasikan Google; kami belum menjalankannya secara langsung untuk tulisan ini:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
Apidog CLI memungkinkan Claude Code, Codex, Cursor, atau OpenCode membuat dan menjalankan pengujian API dari terminal. Siapkan sekali:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt kepada agent Anda:
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
Agent tersebut membuat environment, memeriksa payload test case terhadap skemanya, lalu menjalankannya sekali per level thinking:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
Tambahkan --timeout-request 900000 jika prompt Anda panjang, karena eksekusi xhigh yang sulit bisa memakan waktu beberapa menit. Untuk menjalankan ulang perbandingan setiap kali prompt berubah, masukkan apidog run ... -r junit yang sama ke CI dengan panduan CI/CD Apidog CLI, atau mulai dari Apidog CLI di Claude Code. Paket Free Apidog mencakup hingga 4 pengguna.
FAQ
Apa hasil benchmark terbaik Gemini 4 Neon? #1 pada Artificial Analysis Coding Agent Index dengan 58,6, plus #1 pada AutomationBench (56,3%) dan Vending-Bench 2 ($16.843).
Pada level thinking apa benchmark dijalankan? Sebagian besar pada xhigh, setelan tertinggi. Metodologi Google menyatakan hasil menggunakan setelan thinking tertinggi kecuali dinyatakan lain; FrontierCode 2.0 (46,2%) ditandai sebagai high default.
Apakah Gemini 4 Neon lebih murah daripada Carbon per tugas? Google menyatakan biaya per tugas 32% lebih rendah pada high. Itu angka per tugas dari eksekusi benchmark, jadi konfirmasikan pada prompt Anda sendiri sebelum memindahkan lalu lintas.
Mengapa Neon mencetak 39,0% dan 12,8% pada SWE-sweep? Karena harness-nya berbeda. 39,0% di dalam Google Antigravity, yang menyebarkan sub-agent ke seluruh codebase; 12,8% adalah agent mini-SWE yang lebih sederhana.
Apakah benchmark Gemini 4 Neon independen? Sebagian. Baris Artificial Analysis, Vals, Arena, AutomationBench, dan FrontierCode berasal dari pihak ketiga. SWE-sweep, Agents’ Last Exam, dan Terminal-Bench Science dihitung sendiri oleh Google.