API Gemini 4 Neon menggunakan ID model gemini-4-neon. Anda memanggilnya dengan permintaan POST ke https://generativelanguage.googleapis.com/v1beta/interactions, dengan key Anda di header x-goog-api-key, serta model dan input di body JSON. Model ini hanya tersedia di tier berbayar, dengan harga $3 per juta token input dan $15 per juta token output, dan secara default menggunakan tingkat berpikir high.
Panduan ini membahas hal-hal yang membedakan Neon: pengaturan tier berbayar, cara beralih dari model Gemini 4 lain, output lebih dari 64K token, menggabungkan Neon dengan Hydrogen, dan cara menjaga tagihan tetap terkendali. Semua nama field diambil langsung dari dokumentasi Google.
Apa saja yang Anda butuhkan sebelum panggilan API Gemini 4 Neon pertama?
Anda membutuhkan API key Gemini pada project dengan penagihan aktif, ID model gemini-4-neon, dan endpoint Interactions. Google merilis Neon pada 18 November 2026 sebagai model tingkat menengah dari keluarga Gemini 4, berada di antara Hydrogen dan Carbon.
| Item | Nilai |
|---|---|
| ID Model | gemini-4-neon |
| Endpoint | POST /v1beta/interactions di generativelanguage.googleapis.com |
| Header autentikasi | x-goog-api-key: $GEMINI_API_KEY |
| API | Interactions API dan generateContent |
| Tingkat berpikir | low, medium, high (default), xhigh |
| Jendela konteks | 1.048.576 token, dibagi untuk input, berpikir, dan output |
| Output per hop sinkron | 65.536 token |
| Long decode | Hingga 1.048.576 token dikurangi input Anda |
| Free tier | Tidak |
| Harga tier berbayar | $3,00 / 1M input, $15,00 / 1M output (termasuk token berpikir) |
| Input yang di-cache | $0,15 / 1M melalui implicit caching |
Untuk PDF, function calling, dan streaming, bentuk permintaannya sama seperti yang dijelaskan dalam panduan API Gemini 4 Hydrogen kami; cukup ganti ID modelnya.
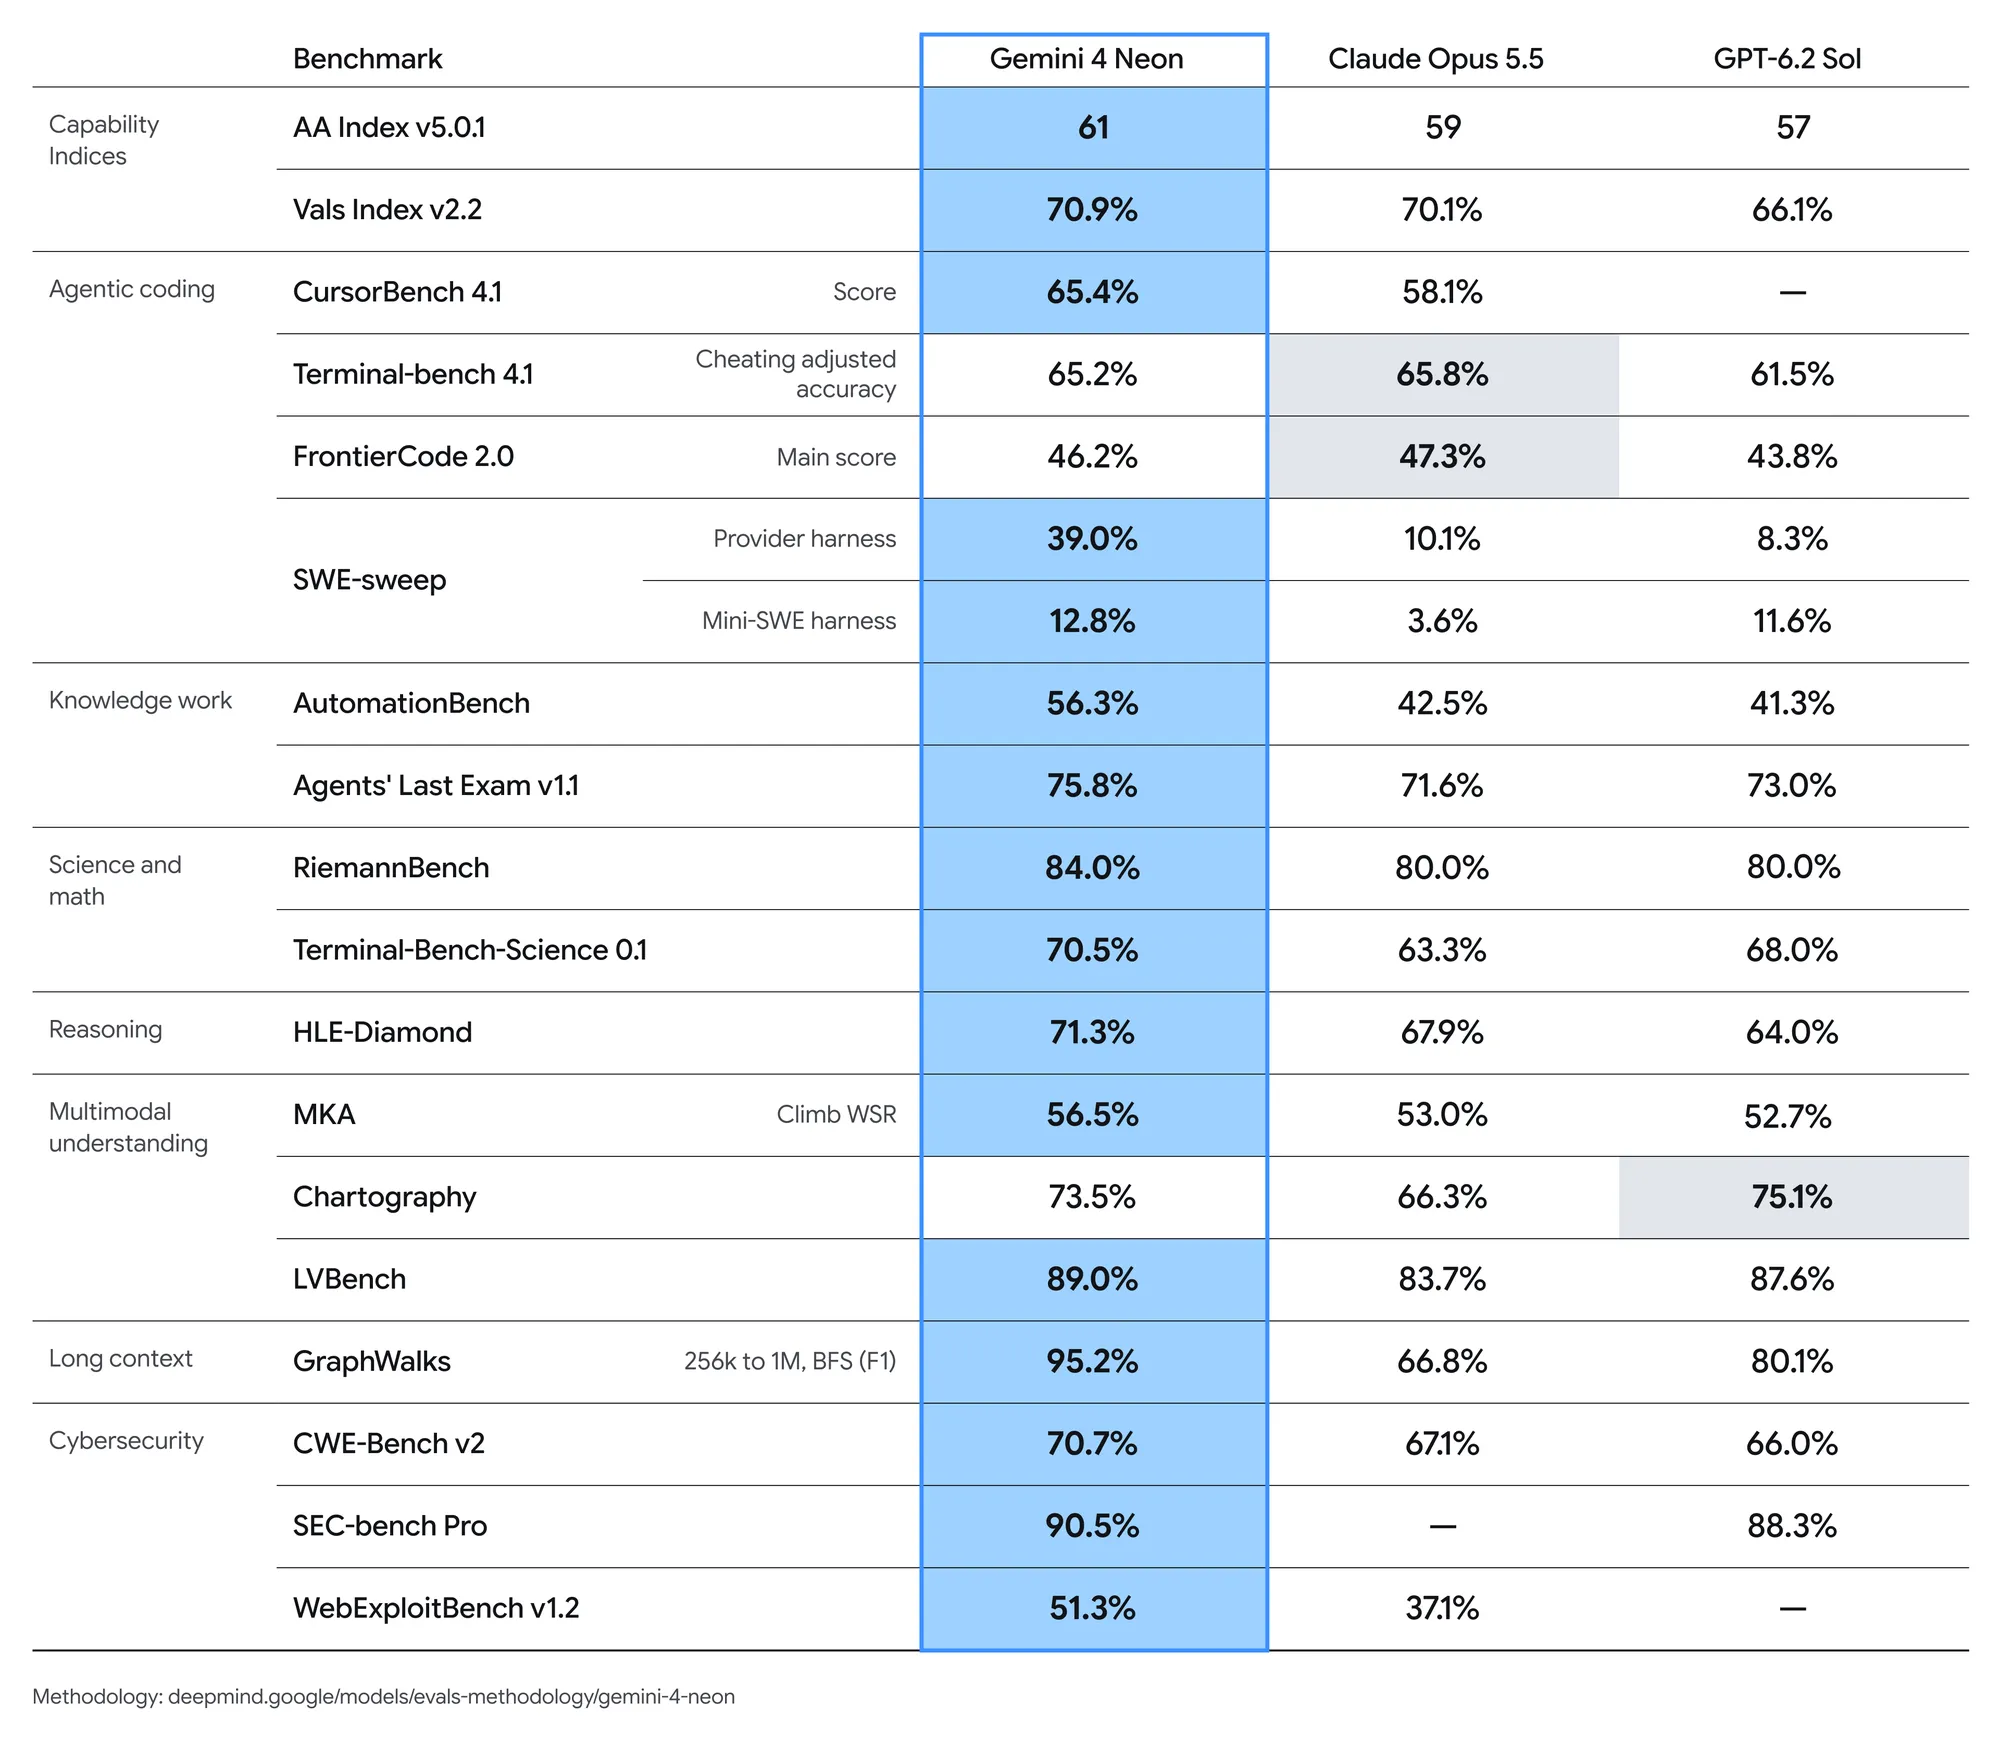
Bagaimana cara mendapatkan API key Gemini yang berfungsi dengan Neon?
Neon tidak tersedia di free tier, jadi hanya punya key saja tidak cukup. Project di belakang key tersebut harus mengaktifkan penagihan.
- Buka halaman API keys di Google AI Studio dan buat key baru, atau gunakan key yang sudah Anda miliki.
- Pastikan project dari key tersebut berada di tier berbayar. Panduan Google menyatakan dengan jelas: “Neon hanya tersedia di tier berbayar (tidak di free tier).”
- Ekspor key-nya:
export GEMINI_API_KEY="YOUR_API_KEY". Google GenAI SDK akan membacanya secara otomatis. - Periksa batas rate limit tier berbayar Anda di halaman rate limits sebelum merencanakan batch besar. [VERIFY: Angka RPM dan TPM Neon per tier]
Bagaimana cara mengirim permintaan API Gemini 4 Neon pertama Anda?
Kirimkan model dan input ke endpoint Interactions. Berikut bentuk quickstart dari Google:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Review this Go handler for missing error checks and suggest fixes."
  }'
Panggilan yang sama dengan Python SDK (pip install -U google-genai):
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Review this Go handler for missing error checks and suggest fixes.",
)

print(interaction.output_text)
print(interaction.usage)
Saat pengujian, baca field usage di setiap respons: token berpikir ditagih dengan tarif output $15, jadi jumlah token berpikir-lah yang menentukan biaya Anda.
Snippet ini mengikuti panduan Google. Kami tidak menjalankannya saat menulis artikel ini, jadi cocokkan bentuk responsnya dengan panggilan pertama Anda sendiri.
Apa yang berubah saat Anda beralih dari Hydrogen atau Carbon?
Jika Anda sudah menjalankan model Gemini 4 lain, beralih ke Neon tidak memerlukan perubahan skema permintaan. Cukup ubah string model dan periksa tiga hal berikut:
| Pemeriksaan | Neon | Hydrogen | Carbon dan Argon |
|---|---|---|---|
| Tingkat berpikir default | high |
high |
medium |
| Tingkat tertinggi | xhigh |
xhigh |
high |
| Input / output per 1M | $3 / $15 | $1,50 / $7,50 | Lihat harga Carbon |
Jika berasal dari Carbon atau Argon, perubahan default dari medium ke high berarti lebih banyak token berpikir untuk prompt yang sama. Atur thinking_level secara eksplisit jika Anda ingin perilaku seperti sebelumnya:
interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions.",
    generation_config={"thinking_level": "medium"},
)
Jika berasal dari Gemini 3.8 Flash atau lebih lama, daftar yang perlu disesuaikan lebih panjang. Berdasarkan checklist migrasi Google:
- Naikkan batas output yang rendah.
max_output_tokensmencakup token berpikir dan jawaban sekaligus. Hapus batas yang di-hardcode seperti 8.192, atau naikkan menjadi 65.536, dan turunkan tingkat berpikir jika Anda ingin menghemat. - Hapus
minimal. Neon menolaknya dengan error. - Buang parameter sampling. Server mengabaikan
temperature,top_p, dantop_kyang berada dalam rentang; nilai di luar rentang mengembalikan400. - Beralih dari explicit caching. Neon tidak mendukung
cachedContentsmaupuncaches.create, jadi hapus fieldcached_content. - Deklarasikan tools secara native. Meminta pemanggilan tool JSON mentah tanpa tools yang dideklarasikan bisa mengembalikan
MALFORMED_FUNCTION_CALL. Gunakan function calling atau structured outputs.
Bagaimana cara mendapatkan output lebih dari 64K token dari Neon?
Permintaan sinkron berhenti di 65.536 token, baik streaming maupun tidak. Untuk output yang lebih panjang, misalnya spesifikasi migrasi lengkap beserta rangkaian tesnya, atur background ke true dan naikkan max_output_tokens di atas 65.536. Server Google kemudian akan terus menghasilkan output dalam hop berukuran 64K token hingga mencapai batas yang Anda tetapkan.
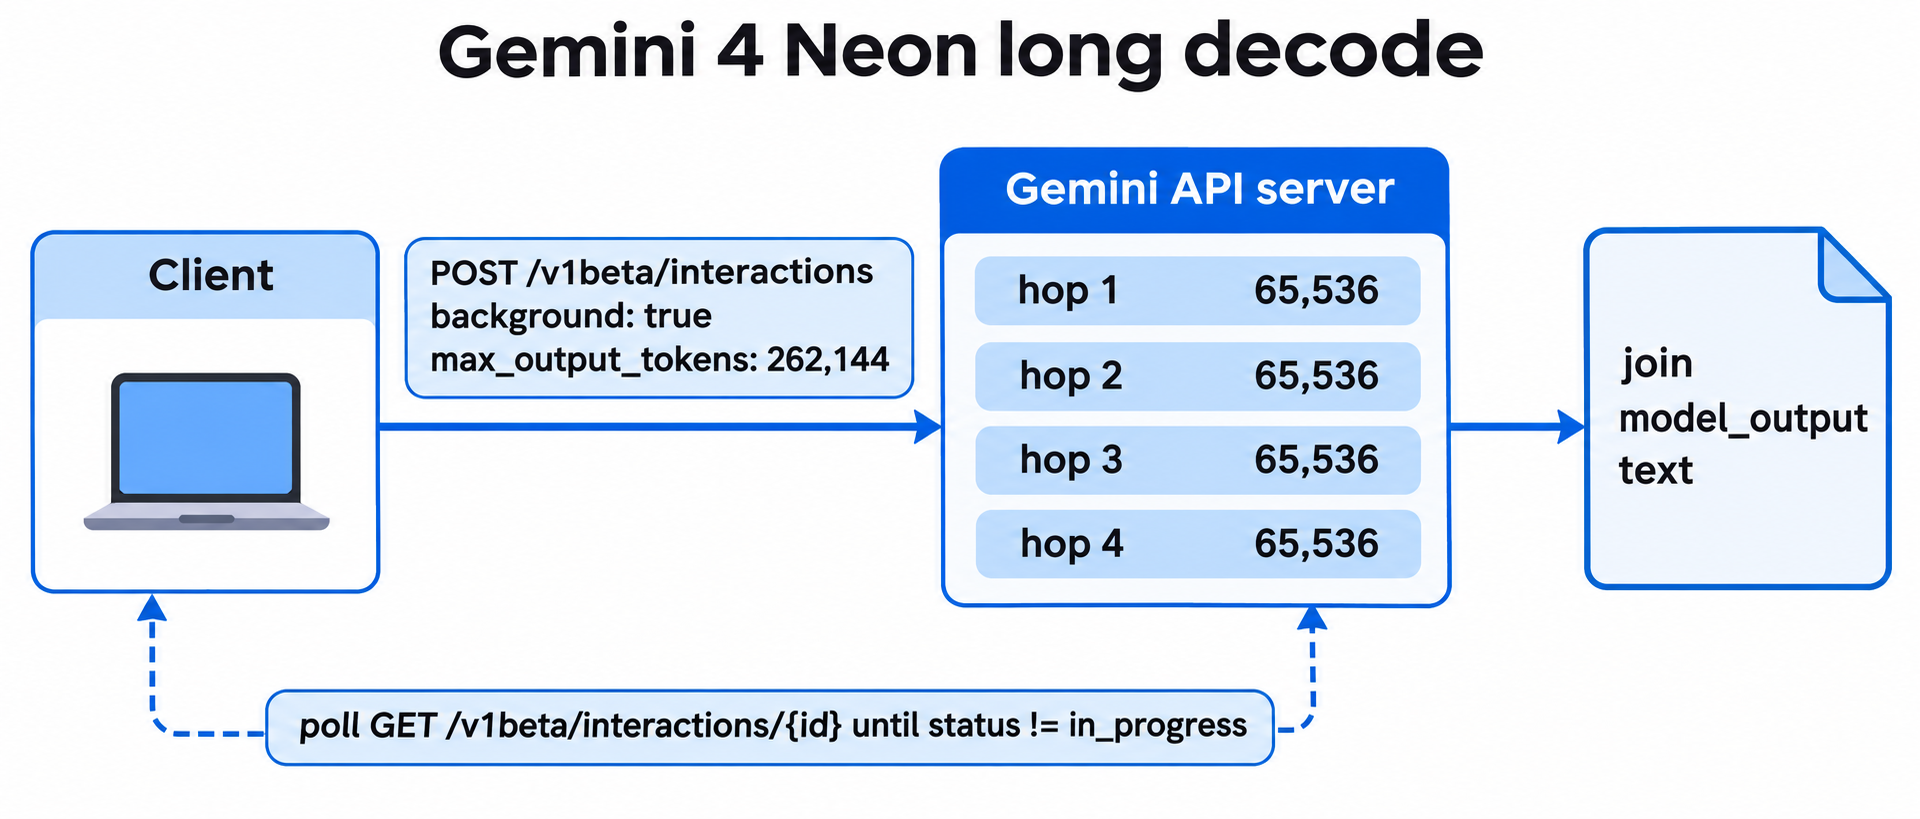
Mulai pekerjaannya dan simpan id-nya:
export ID=$(curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-neon",
    "input": "Generate a complete multi-module migration specification and test suite for this service.",
    "background": true,
    "generation_config": {
      "max_output_tokens": 262144,
      "thinking_level": "high"
    }
  }' | jq -r '.id')
Lalu lakukan polling hingga selesai dan gabungkan teks dari setiap hop (Python, dengan ID yang sudah Anda ekspor):
import os, time

interaction = client.interactions.get(id=os.environ["ID"])
while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

text = "".join(
    c.text
    for step in interaction.steps if step.type == "model_output"
    for c in step.content if c.type == "text"
)
Tiga aturan dari panduan Google mencegah hal ini berjalan salah:
- Jika Anda mengatur
backgroundtanpamax_output_tokens, server akan berhenti di 65.536 token. - Batasnya bisa naik hingga 1.048.576 dikurangi token input Anda. Google menyarankan 131.072 atau 262.144 untuk pekerjaan panjang dengan banyak langkah.
- Prompt yang berat bisa berjalan selama beberapa menit. Gunakan mode background, atau atur timeout HTTP client minimal 15 menit.
Jika Anda tidak ingin menyimpan interactions di sisi Google, panduan long decode juga mendokumentasikan kelanjutan di sisi klien pada SDK terbaru.
Bagaimana cara menggabungkan Neon dengan Hydrogen?
Gunakan Neon untuk pengambilan keputusan dan Hydrogen untuk volume kerja. Neon menyusun atau meninjau alur kerja, lalu Anda meneruskan id interaction-nya sebagai previous_interaction_id ke panggilan gemini-4-hydrogen yang mengeksekusi satu langkah. Panduan developer Cloud dari Google menunjukkan pola berikut:
plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
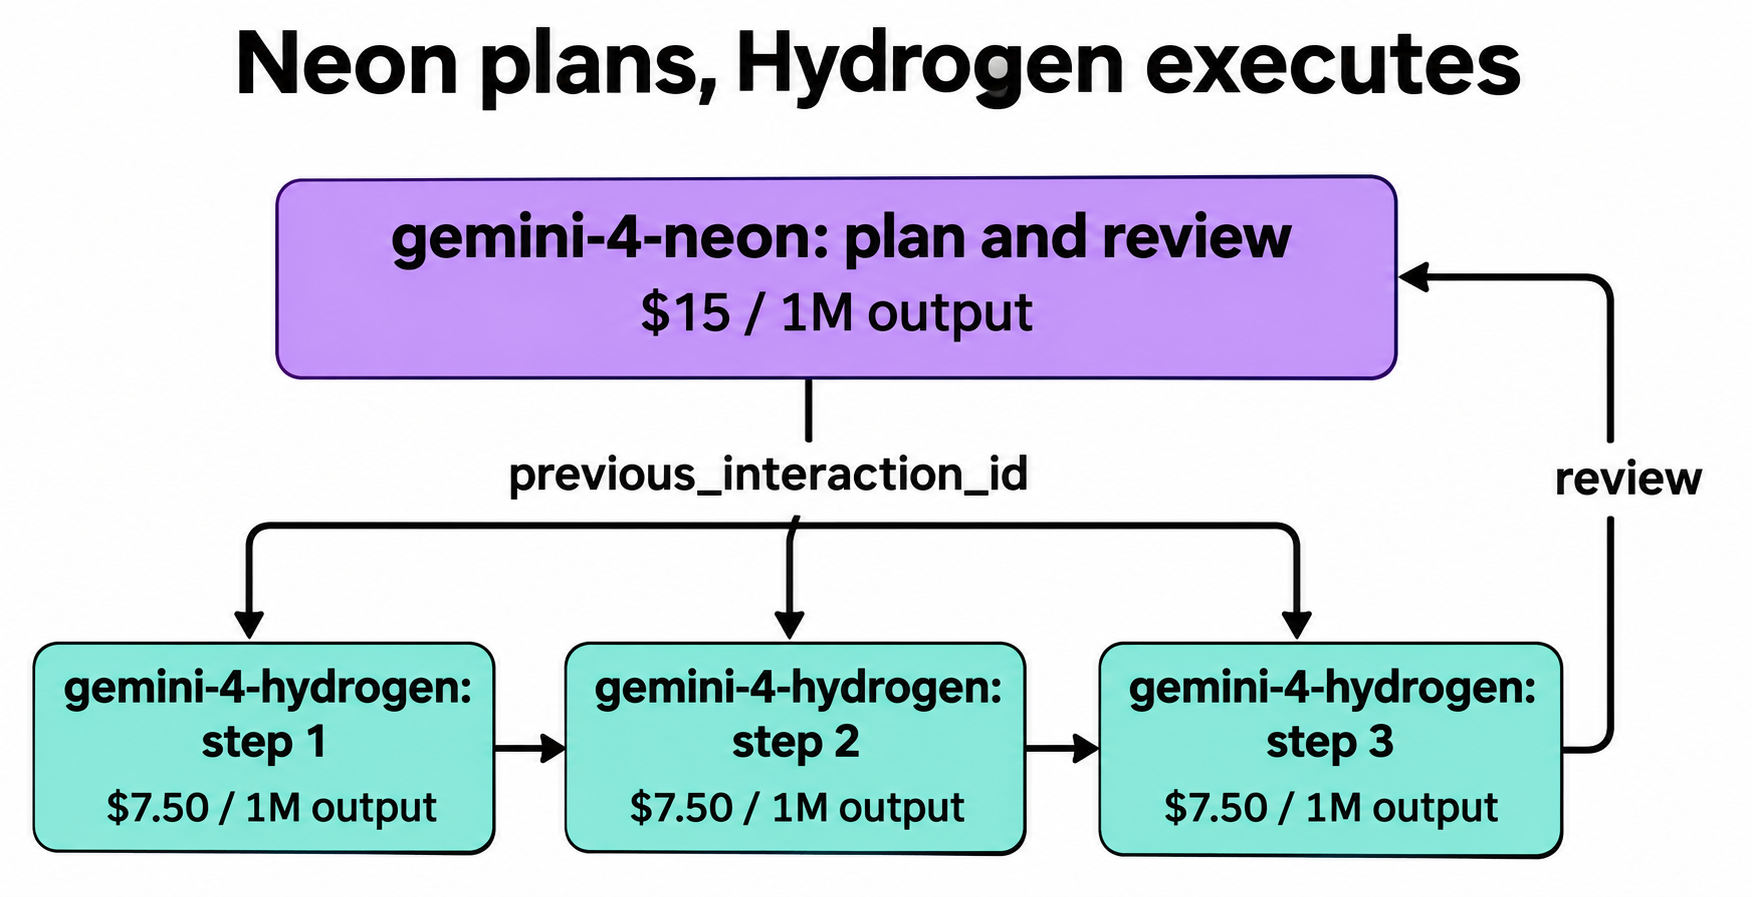
Setiap token output yang ditulis Hydrogen alih-alih Neon hanya berbiaya separuh. Panduan orkestrator Gemini 4 Hydrogen kami membahas pola serupa dengan Carbon sebagai perencana.
Bagaimana cara menjaga biaya API Gemini 4 Neon tetap rendah?
Empat cara, diurutkan dari yang biasanya paling menguntungkan:
- Pilih tingkat berpikir terendah yang tetap memenuhi standar. Saran Google adalah menjalankan evaluasi Anda di keempat tingkat dengan
max_output_tokensyang tinggi, lalu pilihthinking_levelterendah yang memenuhi standar kualitas Anda. - Gunakan ulang prompt panjang. Implicit caching berjalan otomatis untuk prompt berukuran minimal 4.096 token dan memangkas biaya input yang di-cache hingga 95%, dari $3,00 menjadi $0,15 per juta. Letakkan bagian prompt yang panjang dan stabil (teks sistem, dokumentasi, skema) di bagian awal.
- Serahkan eksekusi ke Hydrogen. Lihat pola penggabungan di atas.
- Hitung semuanya. Google menagih setiap token yang diproses model, termasuk token berpikir dan instruksi internal yang ditambahkan saat Anda menggunakan grounding. Grounding dengan Google Search juga ditagih per query.
Sanity check cepat: sebuah panggilan dengan 20.000 token input dan 8.000 token output (termasuk token berpikir) berbiaya $0,06 untuk input dan $0,12 untuk output, jadi total $0,18 sesuai harga daftar.
Minta coding agent Anda membandingkan Neon dan Hydrogen dengan Apidog CLI
Apakah Neon layak dengan harga dua kali lipat Hydrogen untuk prompt Anda? Minta coding agent Anda (Claude Code, Codex, Cursor) membuat satu test case dan menjalankannya terhadap kedua model dengan Apidog CLI.
Lakukan pengaturan sekali:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu berikan satu prompt ke agent Anda:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY,
MODEL (default "gemini-4-hydrogen") and THINKING (default "high"). Add an
endpoint for POST /v1beta/interactions with the x-goog-api-key header from
GEMINI_API_KEY. Create a test case that sends model {{MODEL}}, our code-review
prompt and generation_config.thinking_level {{THINKING}}, and asserts: HTTP 200,
status is "completed", a non-empty model_output step, and usage.total_tokens
exists. Run it for gemini-4-hydrogen and gemini-4-neon, then compare
usage.total_thought_tokens and usage.total_output_tokens.
Agent membaca skema setiap payload dan memvalidasi JSON-nya sebelum menulis apa pun:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
Kalikan token setiap eksekusi dengan harga modelnya, dan Anda mendapatkan biaya riil per tugas untuk prompt Anda sendiri, bukan sekadar rata-rata dari posting peluncuran. Tambahkan --upload-report untuk melihat hasil eksekusi di aplikasi Apidog, atau ganti -r cli,json dengan -r junit untuk memasukkan pemeriksaan yang sama ke CI. Panduan CI/CD Apidog CLI menunjukkan pipeline-nya, dan Apidog CLI di Claude Code membahas pengaturan agent. Plan Gratis Apidog mencakup hingga 4 pengguna.
FAQ
Apa ID model Gemini 4 Neon? gemini-4-neon. Model ini berfungsi dengan Interactions API maupun generateContent.
Apakah API Gemini 4 Neon gratis? Tidak. Neon hanya tersedia di tier berbayar Gemini API, dengan harga $3 per juta token input dan $15 per juta token output. Pelanggan Google AI Pro dan Ultra dapat mencobanya di chat AI Studio.
Apakah kode Hydrogen saya berfungsi dengan Neon? Ya. Google menyatakan bahwa peralihan antar model Gemini 4 tidak memerlukan perubahan skema permintaan. Perbarui string model, lalu putuskan apakah Anda ingin tingkat berpikir default high.
Berapa output maksimum API Gemini 4 Neon? 65.536 token per permintaan sinkron. Dengan background diatur ke true dan max_output_tokens yang lebih tinggi, Neon dapat menghasilkan output hingga jendela 1.048.576 token dikurangi input Anda.
Apakah Gemini 4 Neon mendukung temperature? Tidak. Server mengabaikan nilai temperature, top_p, dan top_k yang berada dalam rentang, dan mengembalikan 400 untuk nilai di luar rentang. Gunakan thinking_level untuk menukar kualitas dengan kecepatan dan biaya.
Apakah Neon mendukung context caching eksplisit? Tidak. Hapus cached_content dari permintaan Anda. Implicit caching tetap berlaku secara otomatis untuk prompt berukuran 4.096 token atau lebih, dengan diskon 95% untuk input yang di-cache.