
Harga Gemini 4 Hydrogen adalah $1,50 per 1 juta token input dan $7,50 per 1 juta token output di tier berbayar Standard Gemini API, dengan harga flat di seluruh jendela konteks 1 juta token. Thinking token ditagih dengan tarif output, input yang di-cache seharga $0,075 per 1 juta, dan Batch atau Flex memotong semua tarif menjadi setengahnya.
Hydrogen, yang dirilis 12 November 2026, adalah anggota tercepat dari keluarga Gemini 4. Berbeda dengan Carbon dan Argon, ia tidak memiliki harga perkenalan yang berlipat ganda di kemudian hari, dan tersedia di tier Free. Di bawah ini: tabel harga, contoh perhitungan biaya, bagaimana tingkat thinking memengaruhi tagihan Anda, dan cara mengukur biaya Anda sendiri. Baru mengenal model ini? Mulailah dengan apa itu Gemini 4 Hydrogen.
Berapa biaya Gemini 4 Hydrogen per 1 juta token?
Gemini 4 Hydrogen (model ID gemini-4-hydrogen) memiliki empat tier berbayar di halaman harga Google. Semua harga per 1 juta token:
| Tier | Input | Output termasuk thinking | Input ter-cache | Tier gratis |
|---|---|---|---|---|
| Standard | $1,50 | $7,50 | $0,075 | Gratis |
| Batch | $0,75 | $3,75 | $0,0375 | Tidak tersedia |
| Flex | $0,75 | $3,75 | $0,0375 | Tidak tersedia |
| Priority | $2,70 | $13,50 | $0,135 | Lihat halaman harga |
Tiga detail di halaman yang sama memengaruhi anggaran Anda:
- Thinking ditagih. “Setiap token yang diproses model dihitung dan ditagih, termasuk thinking token.”
- Hanya implicit caching. Explicit caching tidak didukung; Anda mendapatkan tarif cache ketika implicit cache Google cocok dengan awalan prompt yang berulang.
- Grounding berbiaya tambahan. Google Search grounding mencakup 5.000 permintaan gratis per bulan, lalu $14 per 1.000.
Penggunaan tier gratis ditandai “Digunakan untuk meningkatkan produk kami: Ya” di halaman tersebut. Panduan gratis Gemini 4 Hydrogen kami membahas semua jalur dengan biaya $0.
Apa arti “harga flat hingga 1 juta token”?
Artinya satu harga untuk setiap ukuran prompt. Google menyatakan dalam postingan peluncurannya bahwa Hydrogen “dihargai flat di seluruh jendela konteks 1 juta tokennya sebesar $1,50 per juta token input dan $7,50 per juta token output.” Prompt berukuran 5 ribu token dan prompt 900 ribu token ditagih dengan tarif per token yang sama.
Tidak semua model Gemini bekerja seperti ini: Gemini 3.1 Pro Preview mengenakan biaya $2,00/$12,00 per 1 juta hingga 200K token, dan $4,00/$18,00 di atasnya.
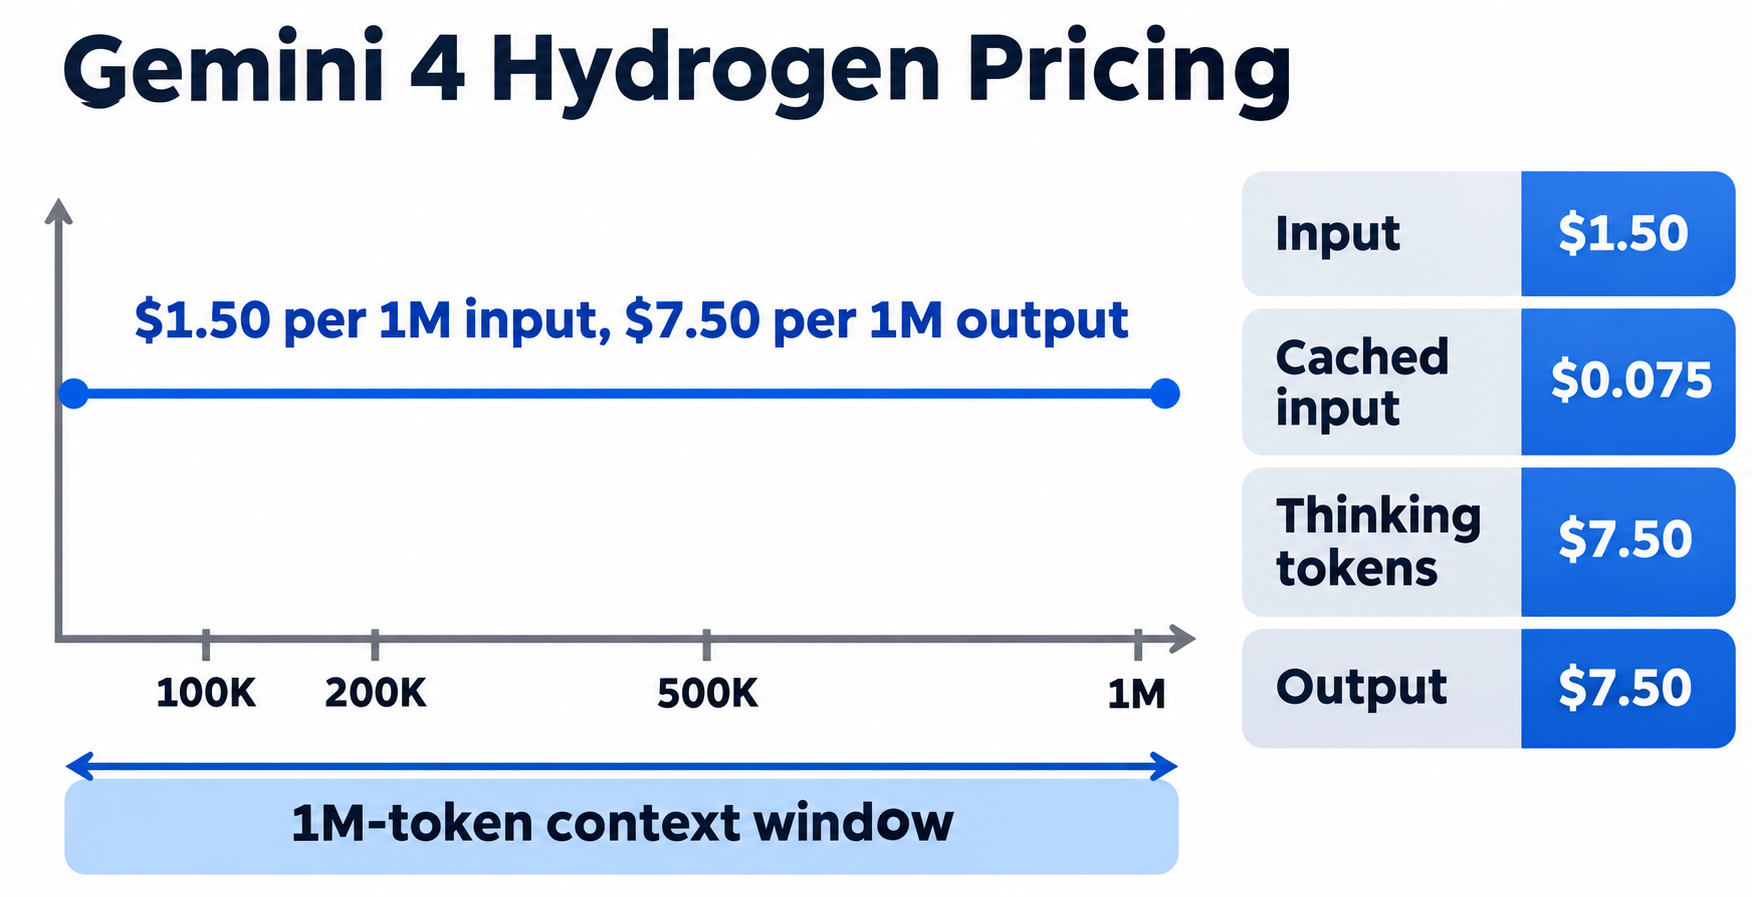
Dua angka membuatnya lebih konkret:
- Prompt 900 ribu token (kode program besar atau tumpukan PDF) berbiaya $1,35 untuk input di tier Standard, atau $0,0675 saat implicit cache mengenai.
- Jendela konteks bersifat terpadu: input, thinking, dan output berbagi 1.048.576 token. Prompt 900 ribu menyisakan sekitar 148 ribu token untuk thinking dan jawaban digabung.
Respons sinkron dibatasi 65.536 token. Output yang lebih panjang dijalankan melalui long decode, tetap dengan harga $7,50 per 1 juta.
Bagaimana tingkat thinking mengubah tagihan Gemini 4 Hydrogen Anda?
Hydrogen mendukung empat tingkat thinking: low, medium, high (bawaan) dan xhigh yang baru. Anda mengaturnya dengan generation_config.thinking_level. Harga per token tidak pernah berubah; yang berubah adalah jumlah thinking token, dan token tersebut ditagih dengan tarif output.
Artificial Analysis menjalankan Intelligence Index-nya di setiap tingkat. Berikut hasil yang dilaporkan:
| Tingkat thinking | Skor indeks | Token yang dihasilkan pada indeks | Biaya per tugas indeks |
|---|---|---|---|
| low | 27 | 20,3 juta | $0,29 |
| medium | 41 | 54,4 juta | $0,80 |
| high (bawaan) | 51 | 110 juta | $1,87 |
| xhigh | 54 | 304 juta | $3,16 |
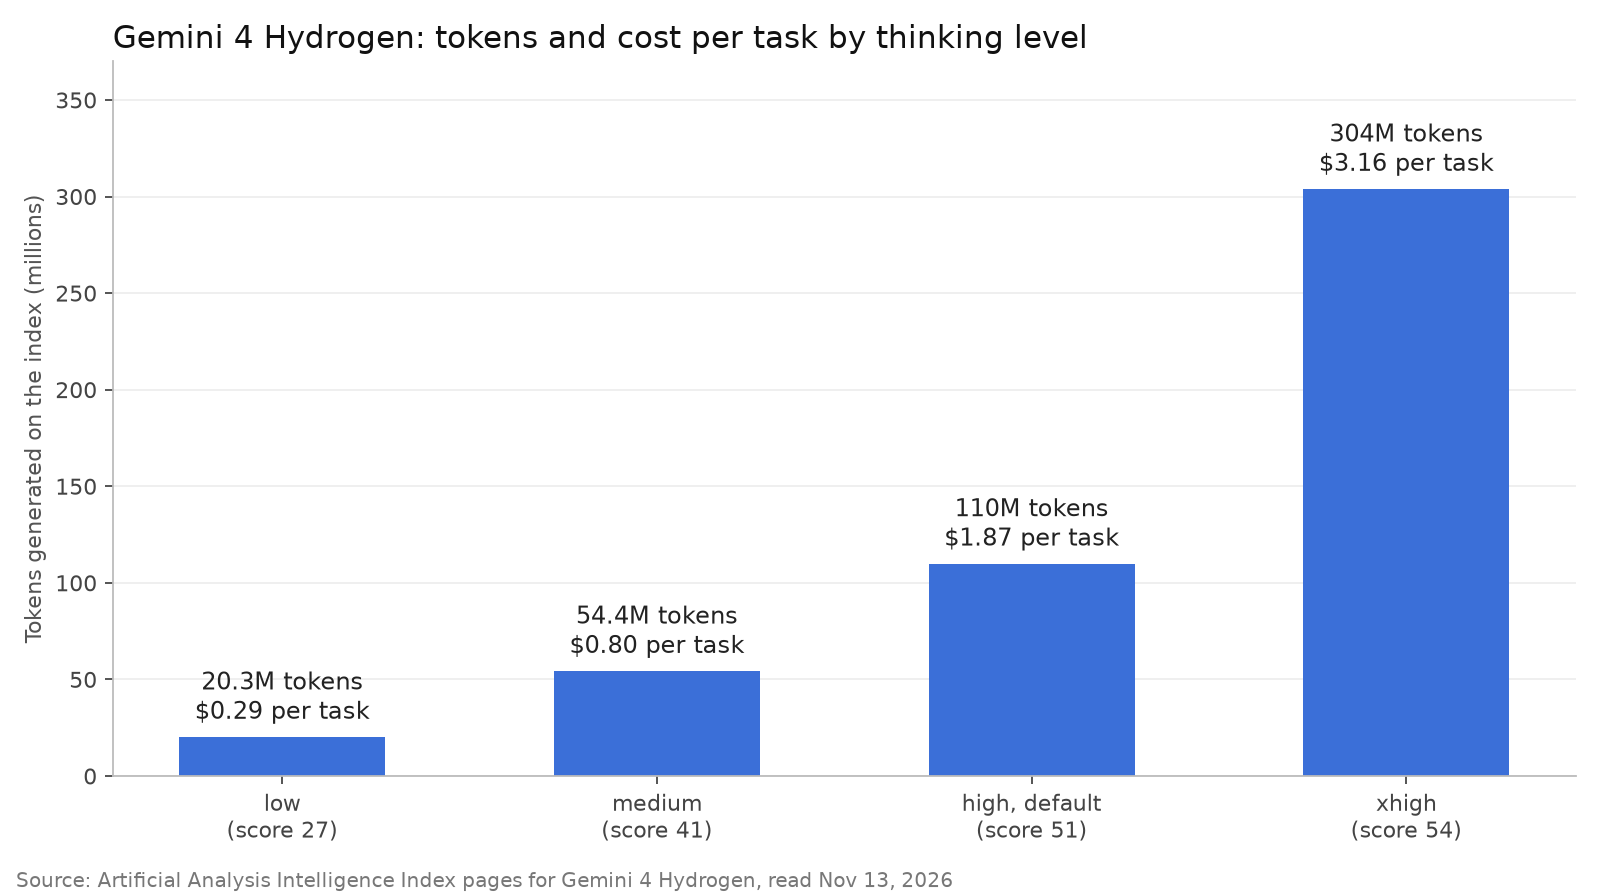
Baca tabel tersebut sebagai rasio. Dari high ke xhigh, token yang dihasilkan naik sekitar 2,8 kali lipat dan biaya per tugas naik sekitar 1,7 kali lipat, hanya untuk tambahan 3 poin indeks. Turun dari high ke low memangkas token menjadi kurang dari seperlima.
Halaman What’s new in Gemini 4 Hydrogen milik Google memperingatkan bahwa xhigh “dapat menyebabkan overthinking pada prompt yang lebih sederhana” dan merekomendasikan memilih “thinking_level terendah yang memenuhi standar kualitas Anda.” Perhatikan bahwa max_output_tokens membatasi thinking dan output digabung.
Berapa biaya satu panggilan Gemini 4 Hydrogen?
Setiap permintaan mengikuti satu rumus. Ambil jumlah token dari objek usage di respons (total_input_tokens, total_cached_tokens, total_thought_tokens, total_output_tokens):
cost = (uncached_input x $1.50 / 1M)
     + (cached_input   x $0.075 / 1M)
     + ((thought + output) x $7.50 / 1M)
Dua contoh di bawah menggunakan jumlah token ilustratif, bukan hasil pengukuran. Ganti dengan angka Anda sendiri.
Contoh 1: panggilan chat di tingkat high. 2.000 token input, 1.500 token thinking, 600 token output.
| Baris | Standard | Batch atau Flex |
|---|---|---|
| Input (2.000) | $0,0030 | $0,0015 |
| Thinking + output (2.100) | $0,0158 | $0,0079 |
| Total per panggilan | $0,0188 | $0,0094 |
| 10.000 panggilan per bulan | $187,50 | $93,75 |
Contoh 2: loop agen. Sebuah agen coding berjalan 40 giliran. Ia mengirim ulang percakapan setiap giliran, sehingga membaca total 1,2 juta token input, dan 900 ribu di antaranya mengenai implicit cache. Ia melakukan thinking sebanyak 200 ribu token dan menulis 60 ribu token kode serta panggilan tool.
| Baris | Standard | Batch atau Flex | Priority |
|---|---|---|---|
| Input tidak ter-cache (300K) | $0,45 | $0,23 | $0,81 |
| Input ter-cache (900K) | $0,07 | $0,03 | $0,12 |
| Thinking + output (260K) | $1,95 | $0,98 | $3,51 |
| Total per run | $2,47 | $1,23 | $4,44 |
Sekitar 79% tagihan Standard berasal dari thinking dan output, jadi tingkat thinking lebih penting daripada memangkas prompt Anda. Kode permintaan untuk kedua contoh ada di panduan API Gemini 4 Hydrogen kami.
Bagaimana perbandingan harga Hydrogen dengan Carbon, Argon, dan Gemini 3.8 Flash?
Berikut tarif tier berbayar Standard per 1 juta token dari halaman harga Google, dibaca pada 13 November 2026:
| Model | Input | Output | Input ter-cache | Tier gratis |
|---|---|---|---|---|
| Gemini 4 Hydrogen | $1,50 | $7,50 | $0,075 | Ya |
| Gemini 4 Carbon (hingga 30 Nov) | $2,00 | $10,00 | $0,10 | Tidak |
| Gemini 4 Carbon (mulai 1 Des) | $4,00 | $20,00 | $0,20 | Tidak |
| Gemini 4 Argon (hingga 30 Nov) | $2,00 | $10,00 | $0,10 | Tidak |
| Gemini 4 Argon (mulai 1 Des) | $4,00 | $20,00 | $0,20 | Tidak |
| Gemini 3.8 Flash (hingga 31 Des) | $0,75 | $3,75 | $0,075 | Ya |
| Gemini 3.8 Flash (mulai 1 Jan 2027) | $1,50 | $7,50 | $0,15 | Ya |
Jalankan jumlah token pada loop agen Contoh 2 melalui setiap harga, dan Anda mendapatkan $2,47 di Hydrogen, $3,29 di Carbon atau Argon bulan ini dan $6,58 mulai 1 Desember, serta $1,27 di Gemini 3.8 Flash hingga 31 Desember. Setelah harga Flash naik pada 1 Januari 2027, token yang sama berbiaya $2,54 di Flash, sedikit lebih mahal daripada Hydrogen karena tarif cache Flash berlipat ganda menjadi $0,15. Untuk detail perubahan harga model frontier, lihat panduan harga Gemini 4 Carbon dan harga Gemini 4 Argon kami.
Namun, “token yang sama” bukan perbandingan yang sebenarnya, karena setiap model menghabiskan jumlah token yang berbeda per tugas. Halaman Intelligence Index Artificial Analysis memberikan satu gambaran:
| Model (tingkat thinking) | Skor indeks | Token yang dihasilkan | Biaya per tugas indeks |
|---|---|---|---|
| Gemini 4 Hydrogen (high) | 51 | 110 juta | $1,87 |
| Gemini 4 Hydrogen (xhigh) | 54 | 304 juta | $3,16 |
| Gemini 4 Argon (high) | 50 | 113 juta | $4,97 |
| Gemini 4 Carbon (high) | 60 | 205 juta | $5,48 |
| Gemini 3.8 Flash (high) | 31 | 126 juta | tidak dibandingkan di sini |
Pada benchmark ini, Hydrogen pada pengaturan bawaannya menyamai skor Argon dengan biaya per tugas sekitar 38% dari Argon, sementara Carbon mencatat skor tertinggi. Anggap ini sebagai pandangan dari satu benchmark saja. Google juga menyatakan Hydrogen menyelesaikan tugas 2,5 kali lebih cepat daripada Gemini 3.8 Flash pada pengaturan high.
Pembagian praktisnya: Hydrogen untuk coding dan agen sehari-hari, Carbon untuk arsitektur yang sulit, debugging, dan tinjauan keamanan. Di Antigravity, opsi Orchestrator beralih antara Carbon dan Hydrogen dalam satu run. Perbandingan Gemini 4 Carbon vs Argon kami membahas sisi model frontier.
Bagaimana cara memangkas tagihan Gemini 4 Hydrogen Anda?
- Gunakan Batch atau Flex untuk pekerjaan yang bisa menunggu. Keduanya setengah harga.
- Pilih tingkat thinking terendah yang lolos eval Anda.
mediummenggunakan sekitar setengah token darihigh. - Simpan
xhighuntuk giliran-giliran yang sulit. - Pertahankan awalan prompt yang stabil agar implicit caching menagih input berulang seharga $0,075 per 1 juta, diskon 95%.
- Prototype di tier Free.
Ukur biaya riil Gemini 4 Hydrogen Anda dengan Apidog CLI
Tagihan Anda berasal dari prompt Anda sendiri. Cara tercepat mendapatkan angka riil adalah membiarkan agen coding Anda (Claude Code, Codex, Cursor) menjalankan prompt Anda di setiap tingkat thinking melalui Apidog CLI dan mencatat objek usage untuk setiap run.
Siapkan sekali:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Masukkan 5 sampai 10 prompt riil Anda ke dalam levels.csv, satu baris per prompt dan tingkat thinking, dengan kolom prompt dan thinking_level (low, medium, high, xhigh). Lalu beri satu prompt kepada agen Anda:
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model "gemini-4-hydrogen", input {{prompt}} and
generation_config.thinking_level {{thinking_level}}. Assert status 200,
status "completed", non-empty output, and a usage object that includes
total_input_tokens and total_output_tokens. In a post-processor, read
total_input_tokens, total_cached_tokens, total_thought_tokens and
total_output_tokens, compute cost at $1.50 input, $0.075 cached and
$7.50 output per 1M, and log it. Run every row of levels.csv and give me
a table of tokens and cost per prompt and thinking level.
Agen memeriksa bentuk payload sebelum menulis apa pun, lalu menjalankan setiap baris:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d levels.csv -r cli,json --out-file hydrogen-cost-{GENERATE_TIME}
Laporan JSON menunjukkan berapa biaya setiap tingkat thinking pada beban kerja Anda. Tambahkan -r junit dan perintah yang sama berjalan di CI, di mana assertion anggaran token dapat menggagalkan build. Panduan CI/CD Apidog CLI menunjukkan pipeline-nya, dan Apidog CLI di Claude Code membahas pengaturan agen. Paket Free Apidog mencakup hingga 4 pengguna.
Jalan pintas: katakan kepada agen Anda “Read https://apidog.com/apidog-cli-installation-guide.md and set up Apidog CLI.”
FAQ
Apakah Gemini 4 Hydrogen gratis? Di API, ya, dalam batas laju tier Free: Google mencantumkan input dan output Standard sebagai “Gratis” di tier Free. Batch, Flex, dan Search grounding membutuhkan kunci berbayar. Lihat panduan gratis Gemini 4 Hydrogen kami.
Apakah harga Gemini 4 Hydrogen akan naik seperti Carbon? Halaman harga Google mencantumkan tarif tunggal $1,50/$7,50 untuk Hydrogen, tanpa masa perkenalan atau tanggal berakhir. Carbon dan Argon membawa harga intro bertanggal; Hydrogen tidak.
Apakah thinking token ditagih untuk Gemini 4 Hydrogen? Ya, dengan tarif output $7,50 per 1 juta di tier Standard. Objek usage di respons melaporkannya secara terpisah sebagai total_thought_tokens.
Apakah Gemini 4 Hydrogen lebih murah daripada Gemini 3.8 Flash? Belum tahun ini: Flash berbiaya $0,75/$3,75 hingga 31 Desember 2026. Mulai 1 Januari 2027, Flash naik menjadi $1,50/$7,50, tarif per token yang sama dengan Hydrogen, dan Hydrogen mencatat skor 51 dibanding 31 milik Flash pada indeks Artificial Analysis.