
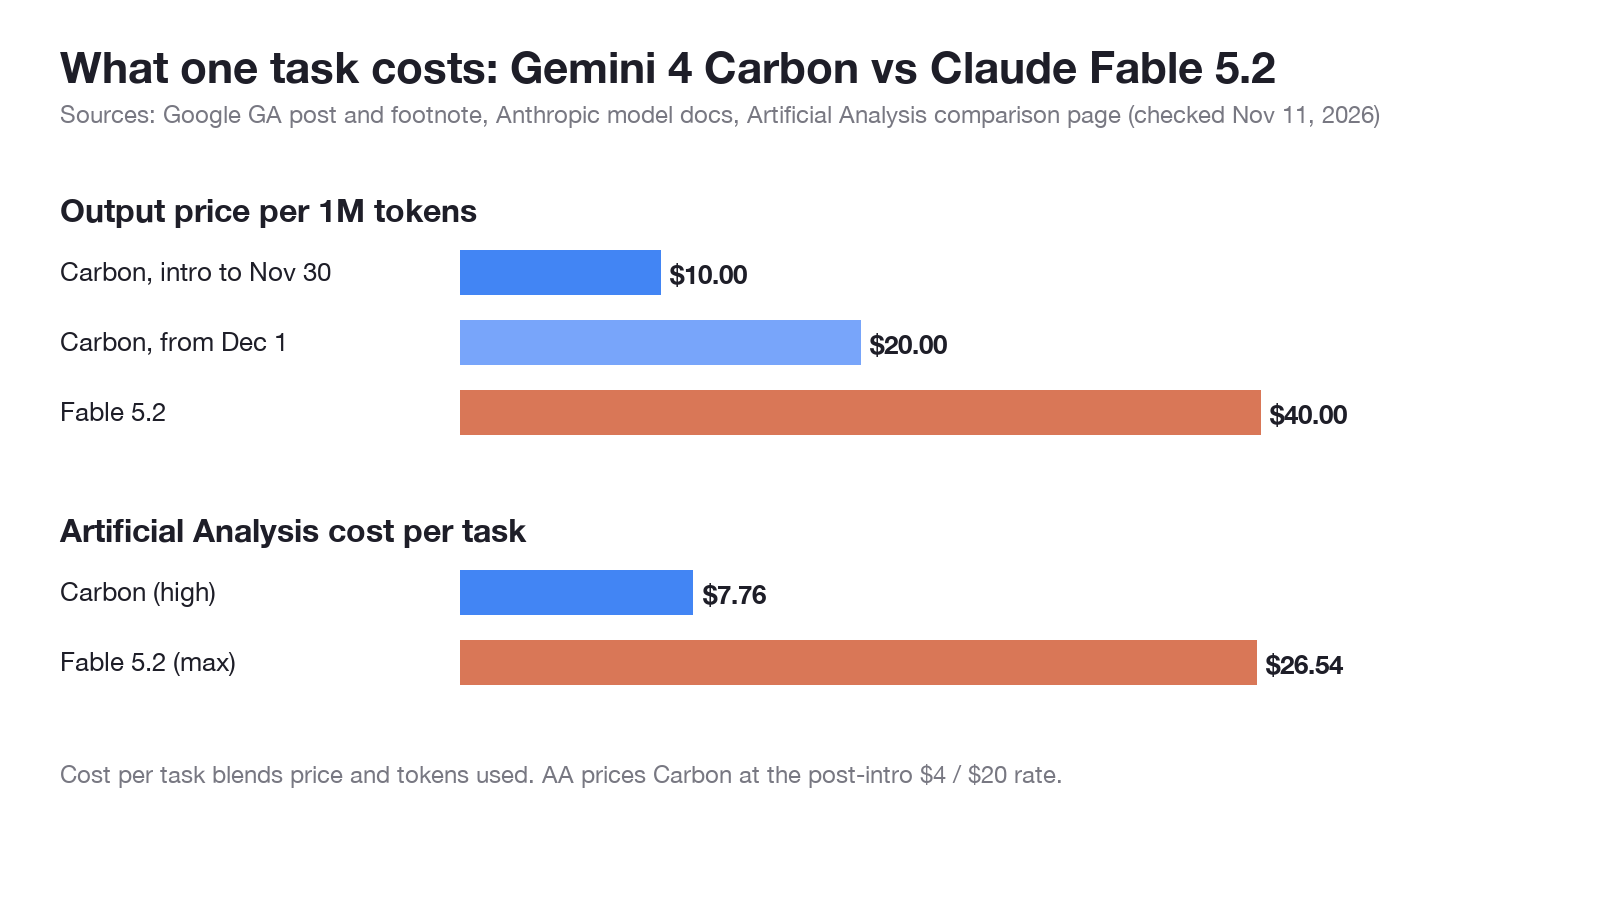
Per 11 November 2026, Gemini 4 Carbon dari Google adalah model yang lebih murah, sedangkan Claude Fable 5.2 adalah yang lebih kuat di sebagian besar benchmark coding dan agent yang dipublikasikan. Carbon dihargai $2 / $10 per 1 juta token input/output hingga 30 November (lalu $4 / $20), Fable 5.2 di $8 / $40, dan Artificial Analysis menghitung biaya satu tugas di $7,76 versus $26,54.
Keduanya diluncurkan selisih satu hari (Fable 5.2 pada 9 November, Carbon GA pada 10 November), dan tabel dari masing-masing vendor selalu menguntungkan modelnya sendiri. Panduan ini memisahkan setiap angka berdasarkan siapa yang mengukurnya, lalu menunjukkan cara melakukan A/B keduanya dengan permintaan Anda sendiri.
Gemini 4 Carbon vs Claude Fable 5.2: kesimpulan singkat
Pilih Gemini 4 Carbon ketika biaya per tugas adalah prioritas utama, untuk alur otomatisasi bisnis, atau untuk pekerjaan keamanan. Pilih Claude Fable 5.2 ketika Anda membutuhkan skor tertinggi pada tugas coding yang sulit, terminal, dan computer-use, serta sanggup membayar sekitar 3,4x lebih mahal per tugas. Untuk pekerjaan rekayasa sehari-hari, kedua vendor menyarankan model default yang lebih murah terlebih dahulu.
Postingan GA Google menyatakan "Argon tetap menjadi pilihan ideal untuk sebagian besar pekerjaan rekayasa perangkat lunak dan pengetahuan," dan memposisikan Carbon untuk tugas yang lebih sulit di mana model ini menghabiskan lebih banyak token untuk eksplorasi dan verifikasi. Dokumentasi model Anthropic mengatakan hal yang sama dengan kata-kata mereka sendiri: mulailah dengan Claude Opus 5.5 untuk sebagian besar beban kerja, lalu pindah ke Fable 5.2 untuk penalaran yang menuntut dan pekerjaan agentic jangka panjang.
Jadi, Anda menggunakan salah satunya setelah model default Anda gagal. Masih bingung memilih default? Baca dulu Gemini 4 Carbon vs Argon.
Bagaimana perbandingan harga dan spesifikasi Gemini 4 Carbon dan Claude Fable 5.2?
Berikut fakta-fakta yang dipublikasikan masing-masing vendor, beserta sumber untuk setiap barisnya.
| Spesifikasi | Gemini 4 Carbon | Claude Fable 5.2 | Sumber |
|---|---|---|---|
| Model ID | gemini-4-carbon |
claude-fable-5-2 |
Google, Anthropic |
| Rilis | GA 10 November 2026 | 9 November 2026 | Google, Anthropic |
| Harga input per 1 juta token | $2 hingga 30 November, lalu $4 | $8 ($16 dalam mode fast) | Catatan kaki Google, Anthropic |
| Harga output per 1 juta token | $10 hingga 30 November, lalu $20 | $40 ($80 dalam mode fast) | Catatan kaki Google, Anthropic |
| Jendela konteks | 1 juta token | 1 juta token | Kartu model AI Studio, dokumentasi Anthropic |
| Output maksimum | 65K / 1M tercantum [VERIFY] | 128K token | Kartu model AI Studio, dokumentasi Anthropic |
| Thinking | Tingkat thinking yang dapat dikonfigurasi | Adaptif, selalu aktif, effort default high |
Quickstart Google, dokumentasi Anthropic |
| Cara mendapatkannya | Tier berbayar Gemini API, AI Studio, Android Studio, Gemini for business, Antigravity, CodeMender, Google AI Ultra | Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure | Google, Anthropic |
| Tier API gratis | Tidak disebutkan | Tidak disebutkan | Google, Anthropic |
Postingan GA Google tidak menyebut Vertex AI, Gemini CLI, atau GitHub Copilot, jadi jangan berencana mengandalkannya dulu. Harga perkenalan Carbon sama dengan Argon, sehingga November menjadi bulan termurah untuk menjalankan evaluasi Anda.
Untuk daftar harga lengkap, lihat harga Claude Fable 5.2 dan pengumuman Gemini 4 Carbon dari Google.
Model mana yang menang pada benchmark?
Tergantung tabel siapa yang Anda baca, jadi berikut tiga tabel yang dipisahkan secara jelas.
Tabel Anthropic (dipublikasikan bersama Fable 5.2)
Postingan peluncuran Fable 5.2 dari Anthropic menyertakan kolom Gemini 4 Carbon. Halaman tersebut tidak menyebutkan siapa yang menjalankan angka Carbon, jadi perlakukan angka tersebut sebagai laporan vendor.
| Benchmark (tabel Anthropic) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69,9% | 61,2% |
| FrontierCode 2.0 | 49,1% (effort xhigh) | 41,1% (effort medium) |
| Terminal-Bench-Science 0.1 | 74,6% | 64,8% |
| OSWorld 2.1 (set offline, partial) | 89,3% | 81,5% |
| AA-Briefcase v1.1 (rubrik) | 66,1% | 61,8% |
| Chartography (tanpa tools) | 73,4% | 72,5% |
| AutomationBench | 51,4% | 53,9% |
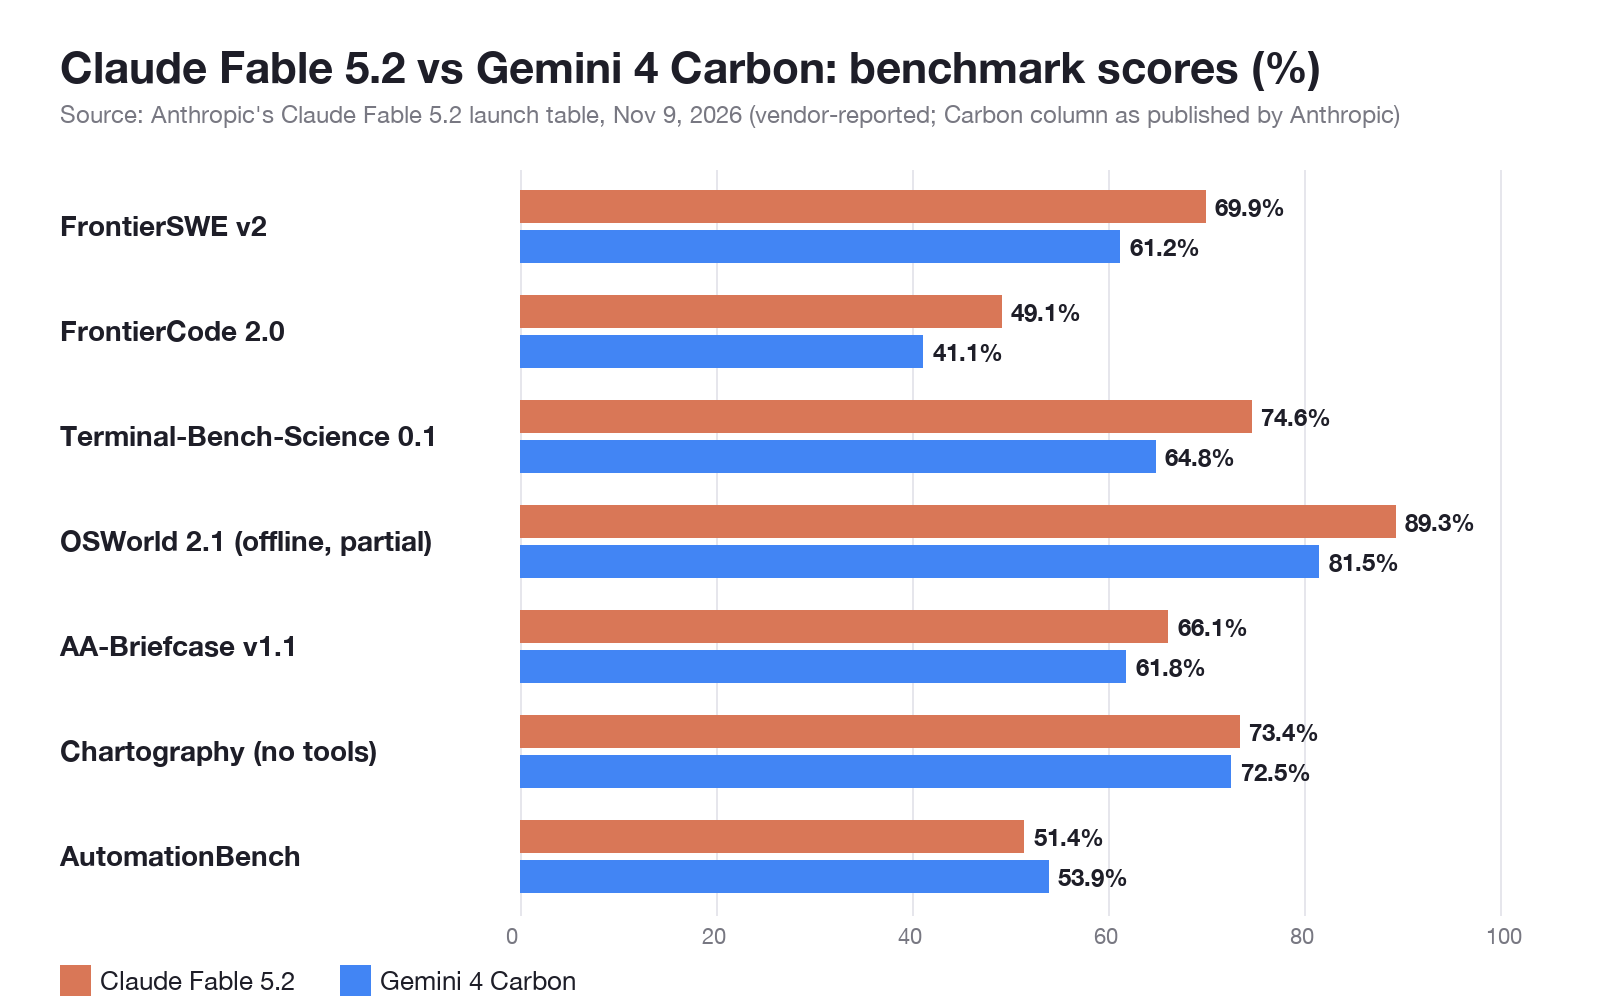
Perhatikan baris FrontierCode: Fable dijalankan dengan effort xhigh dan Carbon dengan medium. Perbedaan pengaturan ini sama pentingnya dengan perbedaan skornya.
Tabel Google (dipublikasikan bersama Carbon GA)
Google tidak mencetak perbandingan langsung dengan Fable 5.2. Sebagai gantinya, Google melaporkan leaderboard mitra: Carbon menduduki peringkat pertama pada CursorBench 4.0, WANDR milik Perplexity, dan AutomationBench milik Zapier "dengan biaya per tugas lebih dari 2X lebih rendah dibandingkan model eksternal terbaik berikutnya." Carbon menduduki peringkat kedua pada benchmark Multimodal Knowledge Agent dengan biaya rata-rata per tugas lebih dari 6x lebih rendah dibandingkan model teratas. Google tidak menyebutkan nama model pesaing dalam klaim tersebut.
Artificial Analysis (independen)
Halaman perbandingan Artificial Analysis menjalankan kedua model melalui Intelligence Index v5.0.1 yang sama:
| Metrik (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| Intelligence Index | 65 | 60 |
| Biaya per tugas | $26,54 | $7,76 |
| Biaya menjalankan seluruh indeks | $22.191 | $8.240 |
| Kecepatan output | 103 token/detik | 82 token/detik |
Fable 5.2 (max) saat ini memegang posisi teratas pada indeks tersebut. Carbon mencatat skor 5 poin lebih rendah dengan biaya per tugas sekitar 29% dari Fable. Artificial Analysis menghargai Carbon di $4 / $20, yaitu tarif setelah November, sehingga angka biayanya sudah mencerminkan harga Desember.
Di mana Claude Fable 5.2 unggul?
Fable 5.2 unggul pada tugas coding dan computer-use yang paling sulit, berdasarkan angka Anthropic:
- Coding skala repositori: 69,9% vs 61,2% pada FrontierSWE v2.
- Pekerjaan terminal dan riset: 74,6% vs 64,8% pada Terminal-Bench-Science 0.1.
- Computer use: 89,3% vs 81,5% pada OSWorld 2.1.
- Indeks independen: 65 vs 60 pada Artificial Analysis, satu-satunya skor yang tidak dijalankan oleh kedua vendor.
- Panjang output: output maksimum terdokumentasi sebesar 128K token per permintaan.
Jika kegagalan satu tugas menghabiskan waktu sore seorang engineer, peningkatan 8 poin pada FrontierSWE bisa lebih berharga daripada tagihan token. Untuk penyiapan, lihat panduan API Claude Fable 5.2.
Di mana Gemini 4 Carbon unggul?
Carbon unggul dalam biaya per tugas dan pada beban kerja yang dibangun Google untuknya:
- Biaya per tugas: $7,76 vs $26,54 pada Artificial Analysis, sekitar 3,4x lebih murah.
- Otomatisasi bisnis: 53,9% vs 51,4% pada AutomationBench, sesuai tabel milik Anthropic sendiri.
- Keamanan: memimpin pada SEC-bench Pro, ExploitGym, dan CWE-bench v1 menurut Google, serta model Carbon for cyber yang terbatas untuk para defender melalui Fairwind Program.
- Harga di bulan November: $2 / $10 hingga 30 November, seperempat tarif Fable baik pada input maupun output.
- Tim agent: pratinjau /swarm di Google Antigravity mengubah satu prompt menjadi tim yang terkoordinasi, dengan Carbon yang merencanakan dan mengaudit sementara model yang lebih ringan bekerja secara paralel.
Baru mengenal model ini? Mulailah dari apa itu Gemini 4 Carbon.
Berapa biaya riil satu tugas?
Harga daftar hanya menunjukkan tarif, bukan tagihan akhir. Biaya satu tugas adalah harga dikalikan jumlah token yang dipilih model untuk dihabiskan, dan Google menyatakan Carbon menghabiskan lebih banyak token untuk eksplorasi dan verifikasi.
Ambil satu permintaan dengan 50.000 token input dan 10.000 token output:
- Carbon, tarif intro: (0,05 x $2) + (0,01 x $10) = $0,20
- Carbon, mulai 1 Desember: (0,05 x $4) + (0,01 x $20) = $0,40
- Fable 5.2: (0,05 x $8) + (0,01 x $40) = $0,80
Itu pun dengan asumsi keduanya menghasilkan 10.000 token. Kenyataannya tidak. Jika Carbon menulis 30.000 token penalaran di mana Fable menulis 10.000, biaya Carbon di bulan Desember naik menjadi $0,80 dan selisihnya menutup. Artificial Analysis mengukur kondisi riil di seluruh rangkaian pengujinya dan tetap menemukan Carbon sekitar 3,4x lebih murah per tugas — sinyal terkuat yang Anda miliki sampai Anda mengukurnya sendiri.
Bagaimana cara A/B Gemini 4 Carbon dan Claude Fable 5.2 dengan permintaan Anda sendiri?
Benchmark adalah tugas orang lain. Uji yang adil mengirimkan prompt yang sama ke kedua API dan mencatat token serta latensi secara berdampingan.
Kedua panggilan adalah HTTP biasa. Berikut permintaan Carbon, dibangun dari quickstart Google untuk Interactions API, dengan nama model dalam sebuah variabel:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2 melewati Messages API Anthropic dengan claude-fable-5-2 sebagai nama modelnya.
Jalankan A/B dengan coding agent Anda menggunakan Apidog CLI
Menjalankan pasangan permintaan secara manual cepat membosankan. Serahkan saja kepada Claude Code, Codex, atau Cursor untuk mengendalikan Apidog CLI. Penyiapannya hanya tiga perintah:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Lalu beri agent Anda satu prompt:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
Agent akan memeriksa skema, menulis test casenya, dan menjalankannya. Flag di bawah ini berasal dari apidog run --help pada CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 mengulang setiap test case lima kali, sehingga satu respons lambat tidak menentukan hasilnya. Tambahkan --upload-report untuk melihat hasil run di aplikasi Apidog. Ini adalah templat alur kerja; kami belum menjalankannya terhadap Carbon dari mesin ini. Panduan Apidog CLI di Claude Code membahas penyiapan agent, dan panduan API Gemini 4 Argon membahas sisi permintaan Gemini.
Free plan Apidog mencakup hingga 4 pengguna, cukup untuk menjalankan perbandingan ini.
FAQ
Apakah Gemini 4 Carbon lebih baik daripada Claude Fable 5.2?
Tidak di semua aspek. Fable 5.2 mencatat skor lebih tinggi pada sebagian besar benchmark Anthropic dan pada indeks Artificial Analysis (65 vs 60). Carbon unggul dalam biaya per tugas ($7,76 vs $26,54) dan pada AutomationBench.
Seberapa murah Gemini 4 Carbon dibandingkan Claude Fable 5.2?
Pada harga daftar, Carbon 4x lebih murah hingga 30 November 2026 ($2 / $10 vs $8 / $40 per 1 juta token) dan 2x lebih murah mulai 1 Desember ($4 / $20). Diukur per tugas oleh Artificial Analysis, Carbon sekitar 3,4x lebih murah.
Apakah kedua model memiliki jendela konteks 1 juta token?
Ya. Kartu model AI Studio Google mencantumkan 1 juta token untuk Carbon, dan dokumentasi Anthropic mencantumkan 1 juta token untuk Fable 5.2. Output maksimum Fable adalah 128K token; periksa panduan developer Google untuk batas output pasti Carbon.
Apakah ada tier gratis untuk Gemini 4 Carbon atau Claude Fable 5.2 pada API?
Kedua vendor tidak menyebutkan adanya. Carbon berada di tier berbayar Gemini API dan di aplikasi Google AI Ultra; Fable 5.2 ditagih per token.
Apakah saya sebaiknya mengganti model default saya ke salah satunya?
Kemungkinan tidak. Google menyatakan Argon tetap menjadi pilihan tepat untuk sebagian besar pekerjaan rekayasa perangkat lunak dan pengetahuan, dan Anthropic merekomendasikan Opus 5.5 untuk sebagian besar beban kerja. Hanya arahkan tugas yang gagal ditangani default Anda ke Carbon atau Fable, lalu bandingkan hasilnya dengan permintaan Anda sendiri.