
Per 11 November 2026, Google’s Gemini 4 Carbon dihargai $2 per 1M token input dan $10 per 1M token output di Gemini API — harga perkenalan yang berakhir pada 30 November 2026. Mulai 1 Desember, harga Gemini 4 Carbon dari Google menjadi dua kali lipat: $4 untuk input dan $20 untuk output per 1M token, dan token berpikir ditagih dengan tarif output.
Tagihan riil Anda bergantung pada seberapa banyak token yang Carbon habiskan untuk berpikir — dan Carbon menghabiskan sangat banyak. Di bawah ini: tabel harga lengkap, contoh perhitungan pada kedua harga, selisih biaya dibanding Argon dan pesaing, serta cara mencatat biaya riil Anda per permintaan. Baru mengenal model ini? Mulailah dengan apa itu Gemini 4 Carbon.
Berapa harga Gemini 4 Carbon per 1M token?
Gemini 4 Carbon (ID model gemini-4-carbon) adalah model berbayar. Halaman harga Google mencantumkan empat tingkat, masing-masing dengan harga perkenalan hingga 30 November 2026 dan harga baru mulai 1 Desember 2026:
| Tingkat | Input (s.d. 30 Nov) | Input (mulai 1 Des) | Output termasuk thinking (s.d. 30 Nov) | Output termasuk thinking (mulai 1 Des) | Input cache (s.d. 30 Nov / mulai 1 Des) | Sumber |
|---|---|---|---|---|---|---|
| Standard | $2.00 | $4.00 | $10.00 | $20.00 | $0.10 / $0.20 | |
| Batch | $1.00 | $2.00 | $5.00 | $10.00 | $0.05 / $0.10 | |
| Flex | $1.00 | $2.00 | $5.00 | $10.00 | $0.05 / $0.10 | |
| Priority | $3.60 | $7.20 | $18.00 | $36.00 | $0.18 / $0.36 |
Semua harga per 1M token. Beberapa detail di halaman yang sama penting untuk anggaran Anda:
- Tidak ada tingkat gratis. Halaman Google menyatakan, “Gemini 4 Carbon tidak tersedia pada tingkat Gratis.”
- Token berpikir ditagih. “Setiap token yang diproses model dihitung dan ditagih, termasuk token berpikir.”
- Hanya caching implisit. Caching eksplisit tidak didukung, jadi Anda mendapatkan tarif cache ketika cache implisit Google cocok dengan prefiks prompt yang berulang.
Postingan peluncuran Google menyatakan perubahan ini dalam catatan kaki: “Setelah masa perkenalan berakhir pada 30 November 2026, harga $4 per 1M token input dan $20 per 1M token output akan berlaku. Berlaku hanya untuk model Carbon yang ditujukan untuk akses publik.”
Apa yang berubah pada 1 Desember 2026?
Semua tarif menjadi dua kali lipat. Input Standard naik dari $2 menjadi $4, output dari $10 menjadi $20, dan tarif cache dari $0,10 menjadi $0,20. Batch dan Flex juga berlipat dua, sehingga diskon batch 50% tetap berlaku.
Catatan kakinya tidak memuat pengecualian bagi pengguna awal, dan tidak ada di halaman harga yang menunjukkan proyek yang sudah ada tetap mendapat tarif perkenalan. Anggarkan setiap token yang dikirim pada atau setelah 1 Desember dengan tarif $4/$20.
Gemini 4 Argon mengikuti jadwal yang sama; lihat panduan harga Gemini 4 Argon kami.
Bagaimana token berpikir Gemini 4 Carbon ditagih?
Token berpikir ditagih dengan tarif output: $10 per 1M hingga 30 November, lalu $20. Interactions API melaporkannya di kolom terpisah, sehingga objek usage dari sebuah respons terlihat seperti contoh ini dari dokumentasi Google:
"usage": {
  "total_tokens": 530,
  "total_input_tokens": 62,
  "total_output_tokens": 171,
  "total_thought_tokens": 297
}
Model berpikir selama 297 token untuk menulis 171, dan Anda membayar tarif output untuk teks yang tak pernah Anda lihat. Carbon secara default memakai thinking_level “medium” dan juga menerima “low” dan “high”, sesuai panduan thinking Google.
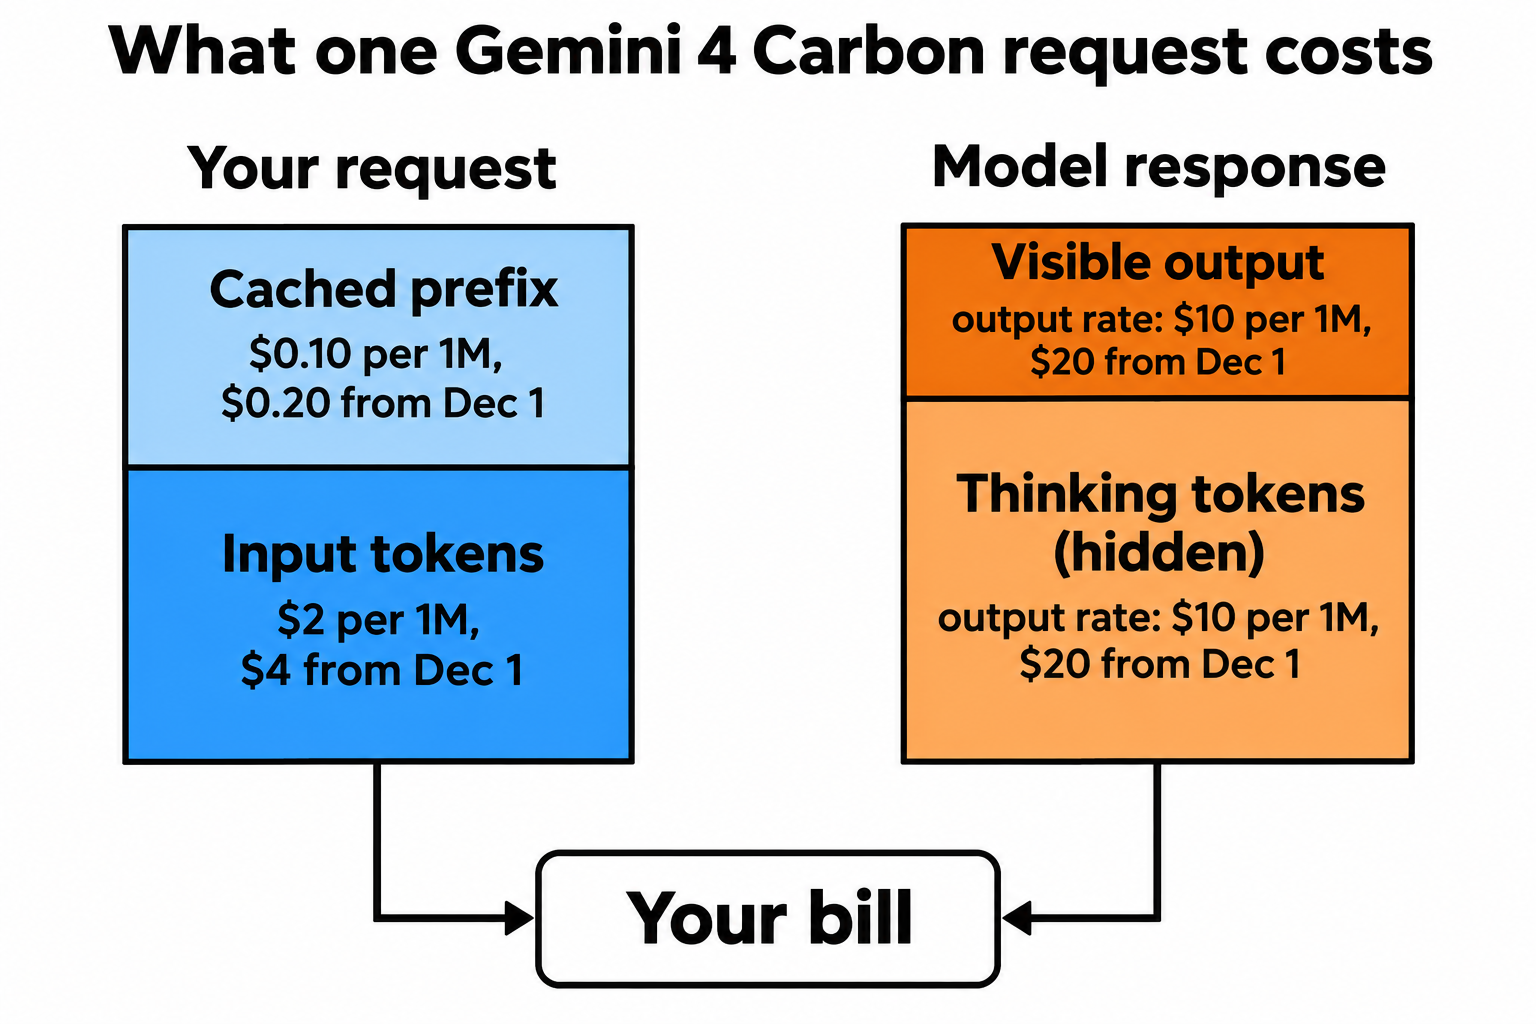
Rumus untuk satu permintaan:
cost = (uncached_input x input_rate)
     + (cached_input x cached_rate)
     + ((thought + output) x output_rate)
Berapa biaya satu panggilan Gemini 4 Carbon?
Dua contoh di bawah ini adalah jumlah token ilustratif, bukan hasil pengukuran. Ganti dengan angka dari objek usage milik Anda sendiri.
Contoh 1: satu panggilan chat. 1.500 token input, 2.500 token berpikir, 800 token output.
| Pos | S.d. 30 Nov | Mulai 1 Des |
|---|---|---|
| Input (1.500) | $0.0030 | $0.0060 |
| Berpikir + output (3.300) | $0.0330 | $0.0660 |
| Total per panggilan | $0.036 | $0.072 |
| 10.000 panggilan per bulan | $360 | $720 |
Contoh 2: sesi agent panjang dengan thinking berat. Sebuah loop agent berjalan 40 giliran. Karena mengirim ulang percakapan setiap giliran, ia membaca total 1,2M token input, dan 900K di antaranya mengenai cache implisit. Ia berpikir selama 300K token dan menulis 60K token kode serta pemanggilan tool.
| Pos | S.d. 30 Nov | Mulai 1 Des |
|---|---|---|
| Input tanpa cache (300K) | $0.60 | $1.20 |
| Input cache (900K) | $0.09 | $0.18 |
| Berpikir + output (360K) | $3.60 | $7.20 |
| Total per sesi | $4.29 | $8.58 |
| Token yang sama dengan tarif Batch atau Flex | $2.15 | $4.29 |
Dalam sesi agent itu, 84% tagihan berasal dari thinking dan output, jadi menurunkan tingkat thinking menghemat lebih banyak daripada memangkas prompt. Kode permintaannya ada di panduan API Gemini 4 Carbon kami.
Apakah Gemini 4 Carbon lebih mahal dari Gemini 4 Argon?
Per token, tidak: keduanya dihargai $2/$10 sekarang dan $4/$20 mulai 1 Desember. Per tugas, ya, biasanya. Google menyatakan Carbon menangani tugas yang lebih sulit “dengan menggunakan lebih banyak token dibanding Argon untuk mengeksplorasi secara menyeluruh, bernalar mendalam, dan menjalankan loop verifikasi yang panjang,” serta bahwa “Argon tetap menjadi pilihan ideal untuk mayoritas pekerjaan rekayasa perangkat lunak dan pengetahuan.”
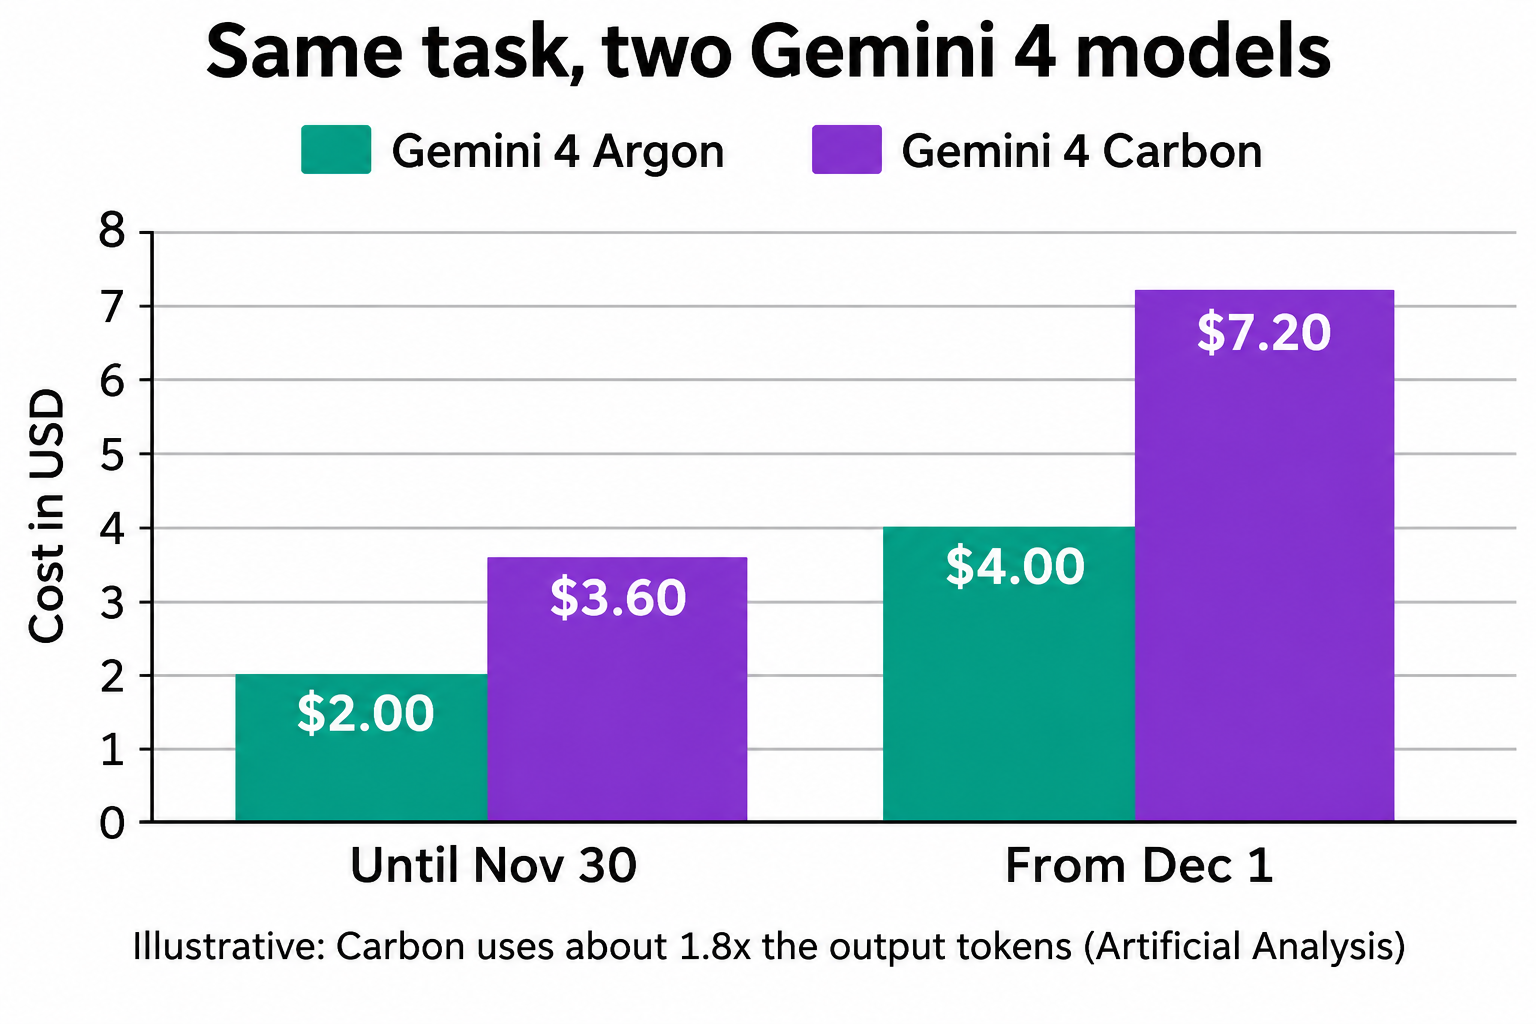
Artificial Analysis memberikan angka konkretnya. Saat menjalankan Intelligence Index-nya, Gemini 4 Carbon (high) menghasilkan 205M token output, dibandingkan 113M untuk Gemini 4 Argon. Itu sekitar 1,8x token output untuk rangkaian tugas yang sama, dan itu membeli skor lebih tinggi: 60 untuk Carbon dibanding 50 untuk Argon.
Terapkan rasio itu pada tugas di mana Argon menghabiskan 200K token output:
| Model | Token output | Biaya s.d. 30 Nov | Biaya mulai 1 Des |
|---|---|---|---|
| Gemini 4 Argon | 200.000 | $2.00 | $4.00 |
| Gemini 4 Carbon (sekitar 1,8x) | 360.000 | $3.60 | $7.20 |
Jadi, arahkan berdasarkan tingkat kesulitan: debugging sulit, arsitektur, dan audit keamanan untuk Carbon; coding sehari-hari untuk Argon. Perbandingan Gemini 4 Carbon vs Argon kami membahas tugas mana yang membenarkan token tambahan tersebut.
Bagaimana harga Gemini 4 Carbon dibandingkan dengan Claude Fable 5.2, Opus 5.5, dan GPT-6.1 Sol?
Berikut tarif API standar per 1M token, masing-masing diambil dari halaman harga vendor pada 11 November 2026:
| Model | Input | Output | Input cache | Sumber |
|---|---|---|---|---|
| Gemini 4 Carbon (s.d. 30 Nov) | $2.00 | $10.00 | $0.10 | |
| Gemini 4 Carbon (mulai 1 Des) | $4.00 | $20.00 | $0.20 | |
| Gemini 4 Argon (s.d. 30 Nov) | $2.00 | $10.00 | $0.10 | |
| Claude Fable 5.2 | $8.00 | $40.00 | $0.20 (cache hit) | Anthropic |
| Claude Opus 5.5 | $4.00 | $20.00 | $0.20 (cache hit) | Anthropic |
| GPT-6.1 Sol | $2.00 | $10.00 | $0.10 | OpenAI |
| GPT-6 Astra | $10.00 | $50.00 | $1.00 | OpenAI |
Mulai 1 Desember, harga per token Carbon sama dengan Claude Opus 5.5 dan tetap separuh dari Claude Fable 5.2. Anthropic mengenakan biaya tambahan untuk penulisan cache; Google tidak mencantumkan biaya penulisan untuk caching implisit. Harga Sol dari OpenAI mencakup prompt hingga 272K token input.
Harga nominal saja tidak menyelesaikan perbandingan, karena setiap model berpikir dalam jumlah berbeda. Artificial Analysis menerbitkan angka biaya untuk setiap model pada Intelligence Index-nya: $7,76 untuk Gemini 4 Carbon (high) dengan skor 60, dan $26,54 untuk Claude Fable 5.2 (max) dengan skor 65. Fable 5.2 juga menghasilkan lebih banyak token output pada indeks tersebut (275M dibanding 205M milik Carbon). Perlakukan angka-angka ini sebagai pandangan dari satu benchmark saja; beban kerja Anda akan berbeda. Untuk perbandingan langsung selengkapnya, lihat Gemini 4 Carbon vs Claude Fable 5.2, dan panduan API Claude Fable 5.2 untuk sisi Anthropic.
Bagaimana cara memangkas tagihan Gemini 4 Carbon Anda?
- Gunakan Batch atau Flex untuk pekerjaan yang bisa menunggu. Keduanya setengah harga standar.
- Turunkan tingkat thinking. “low” untuk giliran rutin, “high” hanya di tempat akurasi memberi keuntungan.
- Arahkan giliran-giliran mudah ke Argon. Harga per token sama, token output jauh lebih sedikit.
- Jaga prefiks prompt tetap stabil agar caching implisit menagih input berulang dengan $0,10 per 1M (lalu $0,20).
- Selesaikan pekerjaan besar sebelum 1 Desember, saat sesi yang sama berbiaya dua kali lipat.
Catat biaya riil Gemini 4 Carbon Anda per permintaan dengan Apidog CLI
Tagihan Anda berasal dari jumlah token, dan jumlah itu berubah setiap kali Anda mengedit prompt atau tingkat thinking. Cara tercepat untuk melihat angka riil adalah membiarkan coding agent Anda (Claude Code, Codex, Cursor) menjalankan prompt asli Anda melalui Apidog CLI dan mencatat objek usage untuk masing-masing.
Atur sekali:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Masukkan 10 hingga 20 prompt asli Anda ke prompts.csv dengan kolom prompt dan thinking_level. Lalu berikan satu prompt ke agent Anda:
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model {{model}} (default "gemini-4-carbon"), input {{prompt}}
and generation_config.thinking_level {{thinking_level}}. In a post-processor,
read usage.total_input_tokens, total_thought_tokens and total_output_tokens,
compute cost at $2/$10 and at $4/$20 per 1M, and log both. Assert status is
"completed". Run it once per row of prompts.csv and give me a table of
tokens and cost per prompt, plus the totals.
Agent memeriksa bentuk payload sebelum menulis apa pun, lalu menjalankan setiap baris:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case category --project <projectId>
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d prompts.csv -r cli,json --out-file carbon-cost-{GENERATE_TIME}
Laporan JSON menyimpan catatan bertanggal jumlah token per prompt. Jalankan ulang dengan --env-var "model=gemini-4-argon" dan Anda mendapatkan angka Argon untuk prompt yang sama — cara paling bersih untuk memutuskan model mana yang layak untuk setiap tugas. Tambahkan -r junit dan perintah yang sama berjalan di CI, tempat asersi biaya bisa menggagalkan build; panduan CI/CD Apidog CLI menunjukkan pipeline-nya, dan Apidog CLI di Claude Code membahas pengaturan agent. Paket Gratis Apidog mencakup hingga 4 pengguna.
Jalan pintas: katakan ke agent Anda, “Baca https://apidog.com/apidog-cli-installation-guide.md dan siapkan Apidog CLI.”
FAQ
Apakah Gemini 4 Carbon gratis? Tidak di API: Carbon tidak ada di tingkat Gratis, jadi Anda memerlukan kunci berbayar. Para ilmuwan bisa mengajukan ke Google untuk akses gratis enam bulan di Antigravity. panduan gratis Gemini 4 Carbon kami membahas semua jalurnya.
Apakah Google AI Ultra menyertakan Gemini 4 Carbon? Google menyatakan Carbon sedang diluncurkan ke pelanggan AI Ultra di aplikasi Gemini, AI Mode di Search, dan Antigravity. Panggilan API ditagih terpisah, per token, pada tingkat berbayar.
Apakah harganya naik bagi pengguna lama pada 1 Desember? Catatan kaki Google tidak menyebutkan pengecualian bagi pengguna lama. Anggarkan $4 input dan $20 output per 1M token untuk semua penggunaan Carbon mulai 1 Desember 2026.
Apakah Gemini 4 Carbon lebih murah dari Claude Fable 5.2? Per token, ya: $4/$20 mulai 1 Desember dibandingkan $8/$40 milik Fable 5.2. Pada Intelligence Index milik Artificial Analysis, angka biaya Carbon adalah $7,76 dibandingkan $26,54 untuk Fable 5.2 (max), meskipun Fable mencetak skor lebih tinggi, 65 berbanding 60.