
Gemini 4 Argon berharga $2 per 1M token input dan $10 per 1M token output selama periode perkenalan, kemudian $4 dan $20. Input yang di-cache mendapat diskon 95% dari harga input, yaitu $0.10 per 1M token pada tarif perkenalan dan $0.20 setelahnya. Google belum menyatakan berapa lama periode perkenalan berlangsung, dan Anda belum bisa membeli Argon: model ini telah diumumkan tetapi belum tersedia secara umum, dan hari ini baru diluncurkan kepada para pembela siber Program Fairwind.
Postingan ini mengubah lembar harga tersebut menjadi angka anggaran: perbandingan dengan tujuh model saat ini, empat skenario kerja, biaya per tugas pihak ketiga, dan kontrol biaya yang perlu disiapkan sekarang. Untuk model itu sendiri, mulailah dengan apa itu Gemini 4 Argon; untuk akses, lihat apakah Gemini 4 Argon gratis. Anda dapat membangun asumsi biaya di Apidog terhadap model yang dapat Anda panggil hari ini dan menukar nama modelnya nanti.
Lembar harga
Google menerbitkan harga di postingan peluncuran Gemini 4 Argon, dengan tarif pasca-perkenalan di catatan kaki 1: "Setelah periode perkenalan berakhir, harga $4 per 1M token input dan $20 per 1M token output akan berlaku."
| Gemini 4 Argon, per 1M token | Perkenalan | Standar (setelah perkenalan) |
|---|---|---|
| Input | $2.00 | $4.00 |
| Input yang di-cache (diskon 95% dari input) | $0.10 | $0.20 |
| Output | $10.00 | $20.00 |
| Output maksimum per respons (Google) | 1M token | 1M token |
| Biaya satu output penuh 1M-token | $10.00 | $20.00 |
Tarif yang di-cache adalah perhitungan dari aturan 95% Google ($2 x 0.05 dan $4 x 0.05). Google belum menerbitkan jendela konteks input atau ID model. Dikatakan batas output adalah 1M token, "naik dari 64K token sebelumnya"; setidaknya satu evaluator pihak ketiga, Vals AI, mencantumkan output maksimum 262K untuk konfigurasi yang diujinya.
Argon vs model-model frontier dan Gemini saat ini
Semua harga adalah per 1M token.
| Model | Input | Input yang di-cache | Output | Output maks |
|---|---|---|---|---|
| Gemini 4 Argon (perkenalan) | $2 | $0.10 | $10 | 1M |
| Gemini 4 Argon (standar) | $4 | $0.20 | $20 | 1M |
| GPT-6 Astra | $10 | $1 | $50 | 128,000 |
| Claude Opus 5.5 | $4 | $0.20 | $20 | 128K (300K di Batch, beta) |
| Claude Sonnet 5.5 | $2 | $0.20 | $10 | 128K (300K di Batch, beta) |
| GPT-6.1 Sol | $2 | $0.10 | $10 | 128,000 |
| Claude Fable 5.1 | $10 | $0.25 | $50 | 128K |
| gemini-3.1-pro-preview (prompt <=200K / >200K) | $2 / $4 | $0.20 / $0.40 | $12 / $18 | 65,536 |
| gemini-3.8-flash (perkenalan / mulai 2027-01-01) | $0.75 / $1.50 | $0.075 / $0.15 | $3.75 / $7.50 | 65,536 |
Harga kompetitor berasal dari halaman vendor masing-masing: halaman GPT-6 Astra OpenAI, halaman harga Anthropic, dan halaman harga Gemini API Google.
- Argon standar = Claude Opus 5.5. Sama-sama $4/$20, sama-sama $0.20 input yang di-cache.
- Argon perkenalan = Claude Sonnet 5.5 dan GPT-6.1 Sol. Sama-sama $2/$10; tarif cache perkenalan $0.10 cocok dengan GPT-6.1 Sol.
- GPT-6 Astra dan Claude Fable 5.1 berharga 5x Argon perkenalan dan 2.5x Argon standar. Lihat harga Claude Fable 5.1.
- Output perkenalan Argon ($10) di bawah gemini-3.1-pro-preview ($12), model Pro top Google sebelumnya.
- Prompt panjang mengubah perhitungan. OpenAI menagih prompt di atas 272K token input dengan 2x input dan cache serta 1.5x output untuk permintaan penuh. Gemini 3.1 Pro menagih lebih mahal di atas 200K; Anthropic tidak. Google belum menyatakan apakah Argon memiliki tingkat prompt panjang.
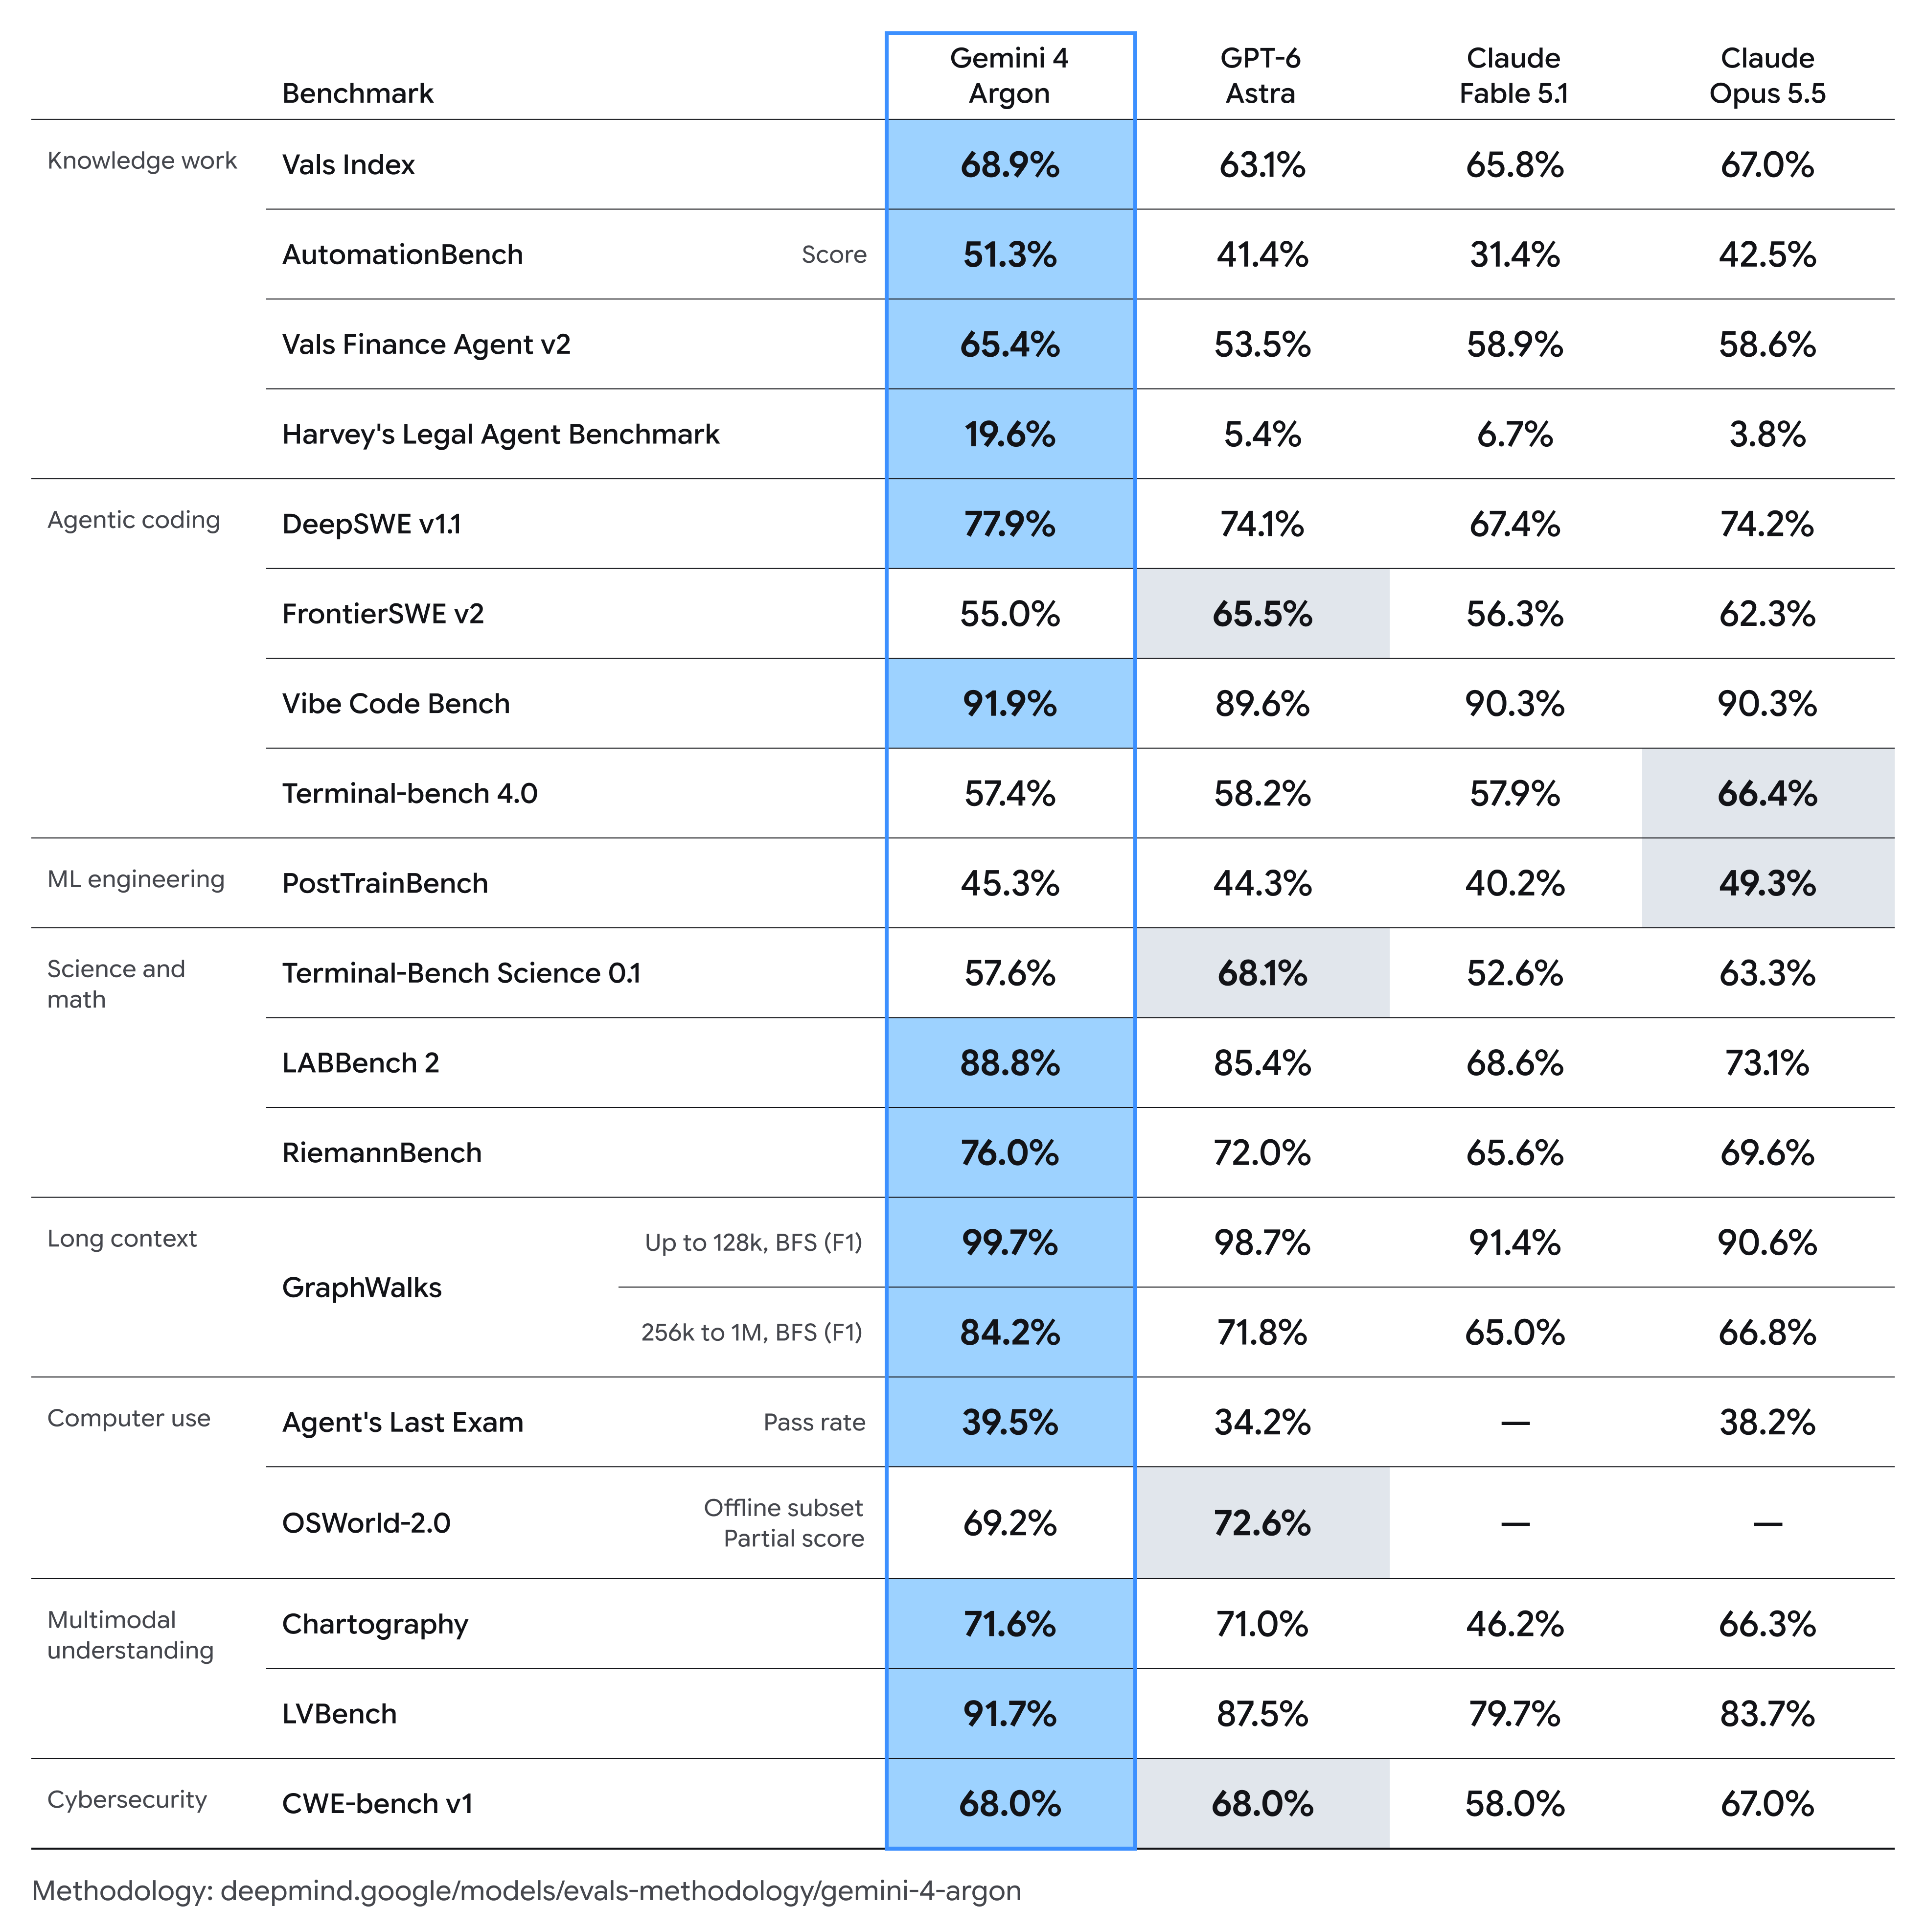
Untuk kemampuan di samping harga, lihat Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5.
Token pemikiran ditagih sebagai output
Pada model Gemini saat ini, token pemikiran ditagih sebagai output: dokumen pemikiran Google mengatakan "harga respons adalah jumlah token output dan token pemikiran." Google belum mendokumentasikan Argon secara spesifik, tetapi rencanakan dengan aturan yang sama. Google menjalankan evaluasi Argon "dengan pengaturan pemikiran tertinggi," jadi artikan "$10 per 1M token output" sebagai jawaban plus penalaran.
Empat skenario kerja
Setiap angka di bawah ini adalah token dibagi 1M, dikalikan tarif per 1M. Skenario 1 hingga 3 mengasumsikan tidak ada caching.
1. Panggilan API tipikal: 20K input, 5K output
- Perkenalan: 20.000 / 1M x $2 = $0.04 input, ditambah 5.000 / 1M x $10 = $0.05 output. Total $0.09.
- Standar: $0.08 + $0.10 = $0.18.
Dengan 1.000 panggilan sehari, itu berarti $90 perkenalan atau $180 standar. Panggilan yang sama berharga $0.18 pada Claude Opus 5.5, $0.45 pada GPT-6 Astra ($0.20 + $0.25), $0.10 pada gemini-3.1-pro-preview ($0.04 + $0.06), dan sekitar $0.034 pada gemini-3.8-flash pada tarif perkenalannya ($0.015 + $0.019).
2. Giliran agen yang panjang: 200K input, 50K output
- Perkenalan: 200.000 / 1M x $2 = $0.40, ditambah 50.000 / 1M x $10 = $0.50. Total $0.90.
- Standar: $0.80 + $1.00 = $1.80.
GPT-6 Astra akan menagih $4.50 ($2.00 + $2.50). gemini-3.1-pro-preview menagih $1.00 ($0.40 + $0.60), tetapi 200K adalah batas tingkatnya: prompt yang lebih panjang ditagih $4/$18. Jika Argon mendapatkan tingkat serupa, giliran yang lebih panjang akan lebih mahal.
3. Satu respons maksimal: 1M token output
Output saja adalah 1.000.000 / 1M x $10 = $10.00 pada tarif perkenalan dan $20.00 pada tarif standar. Tambahkan prompt 100K-token ($0.20 perkenalan, $0.40 standar) dan panggilan akan berharga $10.20 atau $20.40.
Tidak ada model lain dalam tabel yang menghasilkan ini dalam satu respons sinkron: kompetitor dibatasi pada 128K, Gemini Pro sebelumnya pada 65.536. Pada output maksimum 262K yang tercantum Vals, respons penuh berharga sekitar $2.62 perkenalan atau $5.24 standar. Sisi rekayasa (timeout, streaming, gateway) ada di 1M token output Gemini 4 Argon.
4. Prompt 500K-token yang di-cache, digunakan kembali 10 kali
Misalkan Anda mengirim kode sumber atau set kontrak 500K-token yang sama sepuluh kali, dengan 5K token output masing-masing. Asumsikan panggilan pertama membayar harga input penuh untuk membangun cache dan sembilan panggilan berikutnya membacanya.
| 10 panggilan, prompt 500K, 5K output masing-masing | Perkenalan | Standar |
|---|---|---|
| Input, tanpa caching (10 x 500K) | $10.00 | $20.00 |
| Input, di-cache (1 penuh + 9 di-cache) | $1.00 + 9 x $0.05 = $1.45 | $2.00 + 9 x $0.10 = $2.90 |
| Output (10 x 5K) | $0.50 | $1.00 |
| Total dengan caching | $1.95 | $3.90 |
| Total tanpa caching | $10.50 | $21.00 |
Caching memotong tagihan input sebesar 85.5%. Dua peringatan: Google belum menyatakan apakah Argon mengenakan biaya penyimpanan cache (gemini-3.1-pro-preview menagih $4.50 per 1M token per jam, yang akan menambah $2.25 untuk menyimpan 500K token selama satu jam), dan prompt 500K melewati batas 200K 3.1 Pro. Tarif cache standar Argon cocok dengan $0.20 Opus 5.5, jadi logika titik impas di perhitungan biaya caching prompt Claude Opus 5.5 berlaku.
Harga per token bukan biaya per tugas
Artificial Analysis mencantumkan $1.99 per tugas untuk menjalankan Intelligence Index-nya pada Gemini 4 Argon (Tinggi) dengan harga perkenalan; The Decoder menempatkan menjalankan yang sama pada $3.98 dengan harga standar. AA memberi skor Argon 53, sama dengan GPT-6 Astra (maks), yang dicantumkan $3.26 per tugas.
Masalahnya adalah volume token. AA menghitung sekitar 62K token output per tugas untuk Argon (tinggi) berbanding sekitar 27K untuk Astra pada pengaturan maksimalnya, sekitar 2.3x. Output per tugas pada perkenalan: 62.000 / 1M x $10 = $0.62, vs 27.000 / 1M x $50 = $1.35 untuk Astra. Pada standar, angka tugas penuh The Decoder untuk Argon ($3.98) berada di atas $3.26 AA untuk Astra (maks), meskipun tarif standar Argon 60% di bawah Astra.
Vals AI menunjukkan pola yang sama. Ini mencantumkan $15.68 per tes untuk Argon pada Vals Index, berbanding $32.14 untuk Claude Opus 5.5, $21.34 untuk Claude Sonnet 5.5, dan $3.24 untuk GPT-6.1 Sol, dan ini mencantumkan Argon pada tarif standar $4/$20. Sonnet 5.5 dan GPT-6.1 Sol berbagi harga perkenalan Argon di atas kertas, namun biaya per tes mereka terpaut lebih dari 6x.
Anggarkan dari jumlah token Anda sendiri, bukan kartu tarif.
Kontrol biaya yang perlu disiapkan sebelum Argon diluncurkan
- Batasi output. Pada generateContent,
generationConfig.maxOutputTokensmenetapkan batasan. Google mengatakan model baru diluncurkan pada Interactions API, jadi tetapkan batas yang setara di sana setelah dokumentasi mencantumkannya untuk Argon. Batas 1M adalah batas output $20 per panggilan pada tarif standar. - Cache konten yang stabil. Instruksi sistem, skema, dan dokumen referensi yang berulang di seluruh panggilan adalah tempat diskon 95% membuahkan hasil.
- Pilih tingkat pemikiran dengan sengaja. Google belum menerbitkan tingkat Argon. Hari ini gemini-3.1-pro-preview secara default ke
highdan gemini-3.8-flash kemedium. Ketika tingkat Argon didokumentasikan, uji apakah tingkat yang lebih rendah mempertahankan kualitas pada tugas Anda. - Tegaskan pada penggunaan. Setiap respons generateContent diakhiri dengan
usageMetadata. Di Apidog, simpan permintaan dengan model dalam variabel lingkunganGEMINI_MODEL, tambahkan asersi pasca-respons yang menghitung biaya dari jumlah token diusageMetadata, dan gagal jika panggilan melampaui batas Anda. Jalankan terhadap gemini-3.8-flash hari ini; ketika ID Argon diluncurkan, ubah satu variabel dan jalankan kembali suite.
Perhitungan untuk asersi itu:
biaya = input_tanpa_cache / 1.000.000 x tarif_input
     + input_cache   / 1.000.000 x tarif_cache
     + (output + pemikiran) / 1.000.000 x tarif_output
Apa yang belum ditetapkan harganya oleh Google
Panjang periode perkenalan dan tanggal mulai $4/$20; apakah prompt di atas 200K lebih mahal; harga Batch atau Flex (3.1 Pro memiliki keduanya, dengan input $1/$2 dan output $6/$9); biaya penyimpanan cache; batas laju; dan apakah ada tingkatan gratis sama sekali.
FAQ
Berapa biaya Gemini 4 Argon per juta token? $2 input dan $10 output selama periode perkenalan, kemudian $4 dan $20. Input yang di-cache mendapat diskon 95%: $0.10, kemudian $0.20.
Berapa lama harga perkenalan berlaku? Google belum menyatakan. Postingan peluncuran tidak memberikan tanggal akhir atau durasi.
Apakah token pemikiran ditagih sebagai output? Pada model Gemini saat ini, ya. Google belum mendokumentasikan aturan Argon secara spesifik.
Berapa biaya respons output 1M-token? $10 dengan harga perkenalan dan $20 dengan harga standar, sebelum input.
Apakah Argon lebih murah dari Claude Opus 5.5 atau GPT-6 Astra? Per token, Argon standar sama dengan Opus 5.5 dan 60% di bawah Astra. Per tugas, itu tergantung pada volume token: Artificial Analysis mengukur Argon menggunakan sekitar 2.3x token output Astra. Untuk Gemini yang lebih murah hari ini, lihat harga Gemini 3.8 Flash.
Bisakah saya membayar Argon hari ini? Tidak. Ini hanya diluncurkan untuk mitra Program Fairwind. Pelanggan API berbayar dan pelanggan Google AI Ultra akan menyusul, tanpa tanggal.
Anggarkan sekarang, ukur nanti
Kalikan jumlah token lalu lintas Anda saat ini dengan $2/$10 dan $4/$20, dan Anda akan mendapatkan rentang perkenalan dan standar Argon. Kemudian bangun pengukurannya: unduh Apidog, simpan permintaan Anda terhadap gemini-3.8-flash dengan GEMINI_MODEL sebagai variabel, dan tambahkan asersi biaya pada usageMetadata. Ketika Google menerbitkan ID model, Anda mengganti satu nilai dan melihat biaya per panggilan riil Anda pada hari pertama.