
Belum ada API Gemini 4 Argon publik, dan Google belum menerbitkan ID model. Google mengumumkan Argon pada 30 September 2026, dan saat ini hanya tersedia untuk para pembela Program Fairwind: serangkaian mitra Fairwind menggunakannya sebagai model terkelola di Gemini Enterprise. Artificial Analysis mencantumkan Google AI Studio sebagai satu-satunya penyedia API Argon, tetapi tanpa data kecepatan atau latensi, yang sesuai untuk akses pra-rilis yang diizinkan daripada *endpoint* yang dapat Anda daftar. Ketika peluncuran yang lebih luas dimulai, Google mengatakan akan dimulai "dengan pelanggan API berbayar dan pelanggan Google AI Ultra," jadi kunci API Gemini berbayar menempatkan Anda di barisan terdepan.
Jeda antara pengumuman dan akses adalah waktu yang dapat Anda manfaatkan. Panduan ini memisahkan apa yang telah dikonfirmasi Google tentang API Argon dari apa yang belum, lalu membahas kode yang dapat Anda jalankan hari ini di Gemini 3.8 Flash sehingga beralih ke Argon menjadi perubahan satu variabel. Anda akan membuat permintaan, menyiapkan peringatan *go-live*, mensimulasikan respons di Apidog, dan menambahkan batas biaya pada harga Argon. Untuk model itu sendiri, mulailah dengan apa itu Gemini 4 Argon; untuk tahapan peluncuran, lihat panduan tanggal rilis Gemini 4 Argon.
Apa yang telah dikonfirmasi tentang API Gemini 4 Argon, dan apa yang belum
Postingan peluncuran Google memberikan harga dan batas *output*. Hampir semua hal lain yang dibutuhkan untuk integrasi masih belum dipublikasikan.
| Item | Status | Detail |
|---|---|---|
| Harga input | Dikonfirmasi | $2 per 1 juta token (perkenalan), $4 setelah periode perkenalan |
| Harga output | Dikonfirmasi | $10 per 1 juta token (perkenalan), $20 setelahnya |
| Input yang di-cache | Dikonfirmasi | Diskon 95% untuk input: $0.10 perkenalan, $0.20 standar |
| Batas output | Dikonfirmasi | 1 juta token, naik dari 64K |
| Antarmuka API | Sinyal | Dokumen Google menyatakan semua model baru diluncurkan di Interactions API |
| ID Model | Belum diterbitkan | Tidak ada di halaman model, halaman harga, dan changelog |
| Jendela konteks input | Belum diterbitkan | Evaluasi konteks panjang Google menggunakan *prompt* hingga 1 juta token, tetapi itu bukan spesifikasi |
| Tingkat pemikiran | Belum diterbitkan | Evaluasi berjalan pada "pengaturan pemikiran tertinggi"; nama dan *default* tidak diketahui |
| Batas kecepatan | Belum diterbitkan | Tidak ada tingkatan yang diumumkan |
| Dukungan batch | Belum diterbitkan | Tidak ada harga batch atau Flex |
| Tingkat *prompt* panjang | Belum diterbitkan | 3.1 Pro mengenakan biaya lebih tinggi di atas 200K; aturan Argon tidak disebutkan |
| Durasi periode perkenalan | Belum diterbitkan | Tidak ada tanggal berakhir untuk $2/$10 |
Dua baris patut dicermati lebih dekat. Baris "Antarmuka API" berasal dari dokumen API Interaksi, yang menyatakan bahwa model baru "akan diluncurkan di API Interaksi." Argon adalah model baru, jadi perkirakan akan ada di sana terlebih dahulu; Google belum menyatakan apakah `generateContent` akan melayaninya. Baris *output* adalah batas yang disebutkan Google untuk model tersebut, tetapi Vals AI mencantumkan *output* maksimum 262K untuk konfigurasi yang diujinya, jadi jangan berasumsi setiap *endpoint* melayani satu juta penuh pada hari pertama. Panduan token *output* 1 juta kami membahas apa yang dilakukan batas tersebut terhadap *streaming*, *timeout*, dan penyimpanan.
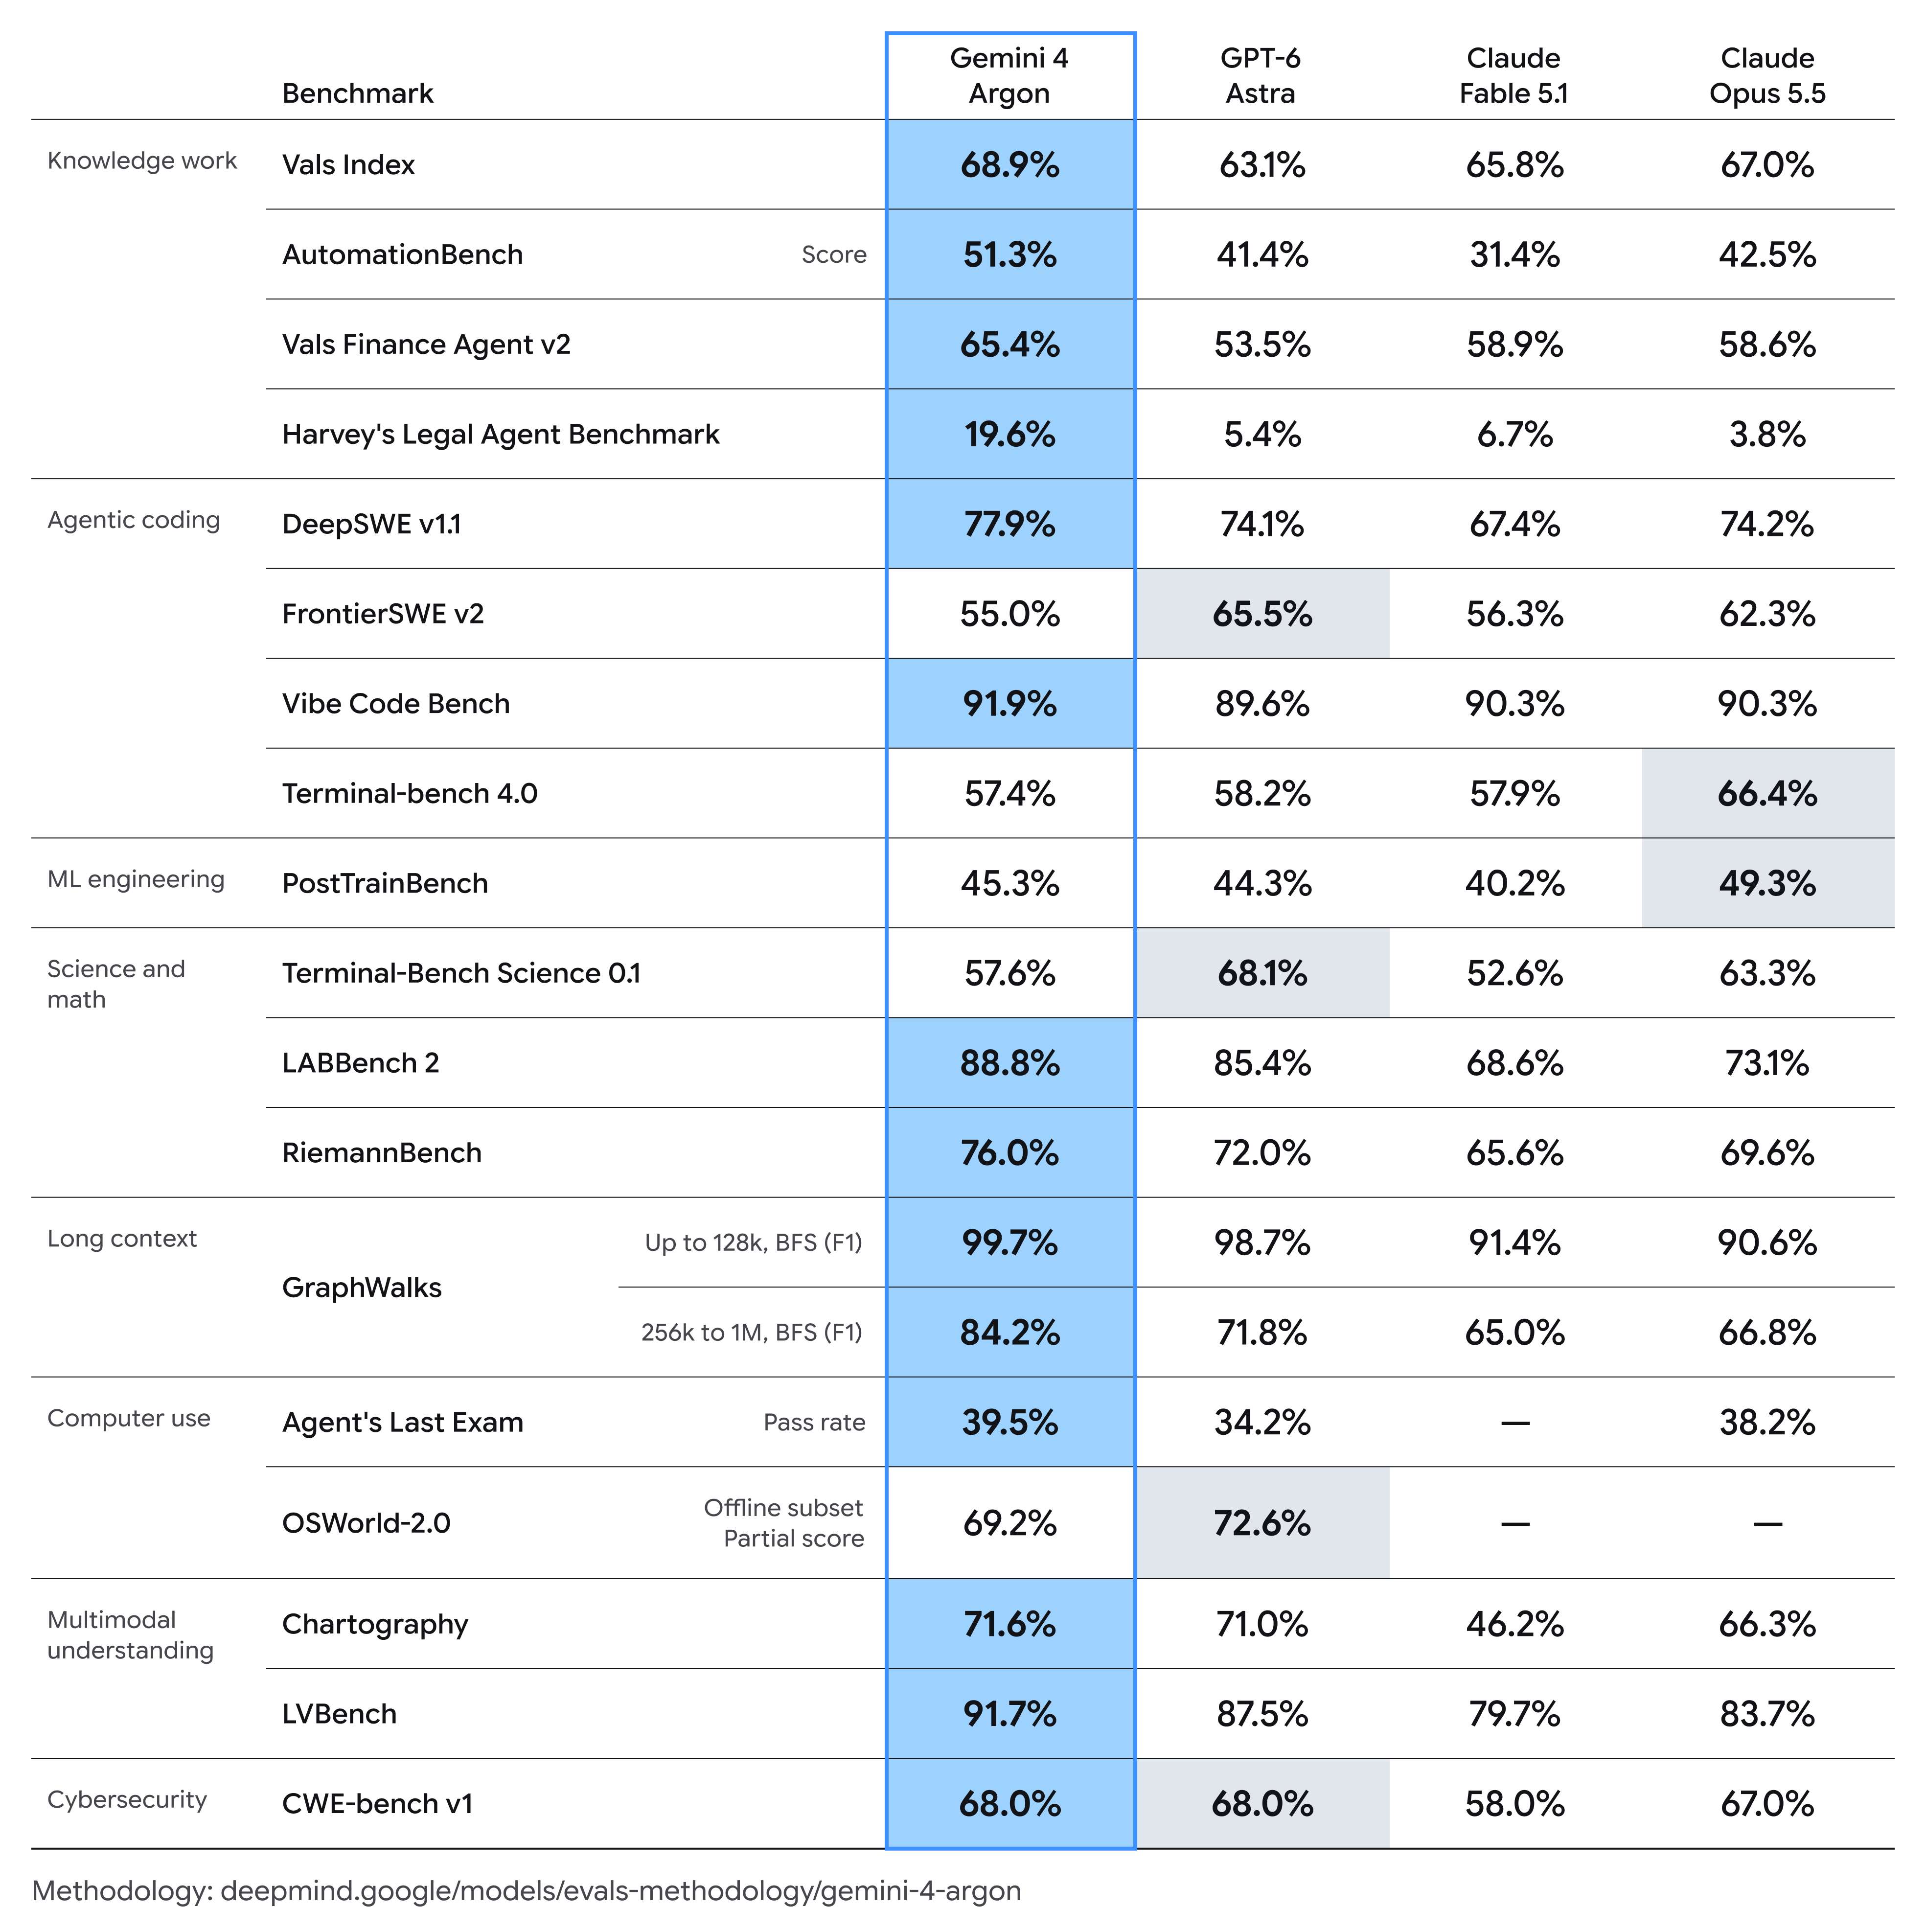
Mengenai harga, satu paragraf cukup di sini. Sebuah permintaan dengan *prompt* 20.000 token dan 5.000 token *output* berharga 20.000 x $2/1 juta + 5.000 x $10/1 juta = $0.04 + $0.05 = $0.09 dengan tarif perkenalan, dan $0.18 dengan standar $4/$20. Harga *output* perkenalan Argon ($10) berada di bawah $12 Gemini 3.1 Pro Preview, dan harga standarnya sama persis dengan Claude Opus 5.5. Rincian harga Gemini 4 Argon menjalankan skenario lengkap, termasuk input yang di-cache dan respons 1 juta token yang dimaksimalkan.
Jangan menuliskan ID model yang Anda temukan secara permanen dalam kode
Cari ID model Argon dan Anda akan menemukan string di situs *benchmark*, agregator, dan *pull request open-source*. Itu adalah *placeholder*. Vals AI menggunakan *slug* sendiri untuk halaman modelnya, satu *pull request* GitHub menambahkan ID "sementara," dan jalur gaya OpenRouter mengarah ke halaman yang tidak ditemukan. Google belum mengkonfirmasi salah satu pun, dan beberapa media secara eksplisit memperingatkan agar tidak menuliskan dugaan ID secara permanen dalam kode.
ID yang ditebak akan gagal dengan cara yang paling tidak membantu: 404 dalam produksi pada hari *deploy*, atau *fallback* senyap jika *wrapper* Anda menangkap *error* terlalu luas. Sebaliknya, simpan nama model dalam konfigurasi. Di setiap contoh di bawah, model berasal dari variabel lingkungan `GEMINI_MODEL` yang secara *default* adalah `gemini-3.8-flash`, model stabil yang dapat Anda panggil hari ini. Ketika Google menerbitkan ID Argon, Anda cukup mengubah satu nilai.
Siapkan kode Anda di Gemini 3.8 Flash
Gemini 3.8 Flash (`gemini-3.8-flash`) berjalan pada *endpoint*, *header*, dan bentuk respons yang sama yang diharapkan akan digunakan Argon, dengan harga $0.75/$3.75 per 1 juta token hingga 31 Desember 2026. Kunci Anda tersimpan di `GEMINI_API_KEY`; jangan pernah menempelkannya ke dalam kode. Pengaturan lengkap ada di panduan API Gemini 3.8 Flash kami.
Langkah 1: Kirim permintaan API Interaksi
API Interaksi adalah API utama Google, Tersedia Secara Umum sejak Juni 2026. Simpan model dan tingkat pemikiran dalam variabel, karena nama tingkat Argon belum dipublikasikan.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
Python SDK membutuhkan `google-genai` 2.3.0 atau yang lebih baru untuk Interactions API:
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # reads GEMINI_API_KEY from the environment
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
Pada 3.8 Flash, tingkat yang valid adalah `low`, `medium` (standar), dan `high`; `minimal` mengembalikan HTTP 400. Panduan tingkat pemikiran kami menjelaskan *trade-off*-nya. Untuk pekerjaan multi-giliran, teruskan ID respons sebelumnya sebagai `previous_interaction_id`, dan kirim `store: false` untuk menolak penyimpanan sisi server.
Langkah 2: Pastikan jalur generateContent tetap berfungsi
Sebagian besar kode yang ada memanggil *endpoint* `generateContent` yang lama, yang menurut Google tetap didukung sepenuhnya. Berikut adalah permintaan yang sama:
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
Perhatikan di mana tingkat pemikiran berada: `generation_config.thinking_level` pada Interaksi, `generationConfig.thinkingConfig.thinkingLevel` di sini. Jika klien Anda membungkus keduanya, rutekan model baru melalui Interaksi secara *default*. Definisi alat membutuhkan perhatian yang sama; lihat pemanggilan fungsi Gemini 3.8 Flash.
Langkah 3: Jadwalkan pemeriksaan *go-live* dengan models.list
Jangan menyegarkan *changelog*. Tanyakan pada API. *Endpoint* model mengembalikan model yang tersedia dengan batas token dan metode yang didukung:
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # a failed run is the alert
Jalankan setiap jam dari cron atau jadwal CI, menggunakan kunci yang digunakan aplikasi produksi Anda. Ketika kami menjalankan panggilan ini pada 1 Oktober 2026, dengan kunci proyek berbayar, ia mengembalikan 61 model, tanpa `nextPageToken`, dan tanpa nama yang mengandung "argon". Pada hari cocok, entri tersebut memberi tahu Anda tiga hal sekaligus: nama model yang sebenarnya, apakah `outputTokenLimit` adalah 1 juta penuh, dan metode mana yang tercantum.
Langkah 4: Simulasikan respons agar klien dapat dibangun sebelum akses
Anda tidak memerlukan Argon untuk membangun kode yang menggunakan Argon. Simpan permintaan Langkah 2 di Apidog dengan `GEMINI_API_KEY` dan `GEMINI_MODEL` sebagai variabel lingkungan, kirim sekali terhadap 3.8 Flash, dan ekstrak respons sebenarnya ke *endpoint* sebagai contoh respons. Smart Mock *default* Apidog menghasilkan data dari skema, jadi atur metode *mock* *default* proyek ke "Response example first" (Pengaturan Proyek, Pengaturan Fitur, Pengaturan Mock). URL *mock* kemudian mengembalikan respons yang Anda simpan, sehingga *front end* Anda, *queue workers*, dan *parser* dapat berjalan melawannya tanpa menghabiskan token.
Jelaslah tentang apa *mock* ini: skema respons Gemini saat ini, bukan yang spesifik Argon, karena Google belum menerbitkannya. Ini masih merupakan pilihan yang tepat, karena Argon diharapkan berada di API yang sama. Untuk melatih balasan Argon yang berat, edit `usageMetadata` contoh ke jumlah besar dan konfirmasikan bahwa kode penagihan dan peringatan Anda bereaksi.
Langkah 5: Verifikasi usageMetadata dan batas biaya
Setiap respons `generateContent` menyertakan `usageMetadata`. Tambahkan skrip *post-processor* di Apidog yang memberi harga setiap respons dengan tarif standar Argon, sehingga pengujian gagal sebelum tagihan muncul:
// Apidog post-processor: price this response at Gemini 4 Argon's standard rates
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // USD per input token after the intro period
const OUT = 20 / 1e6; // USD per output token; thinking bills as output on current Gemini models
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata is present", () => pm.expect(u).to.be.an("object"));
pm.test("cost under $0.10 at Argon rates", () => pm.expect(cost).to.be.below(0.10));
Pilih batas per permintaan; $0.10 cocok untuk *prompt* pendek seperti ini. Google belum menyatakan bagaimana Argon menagih token pemikiran, jadi skrip mengasumsikan aturan Gemini saat ini. Gunakan permintaan yang sama yang tersimpan dan jalankan terhadap 3.8 Flash sekarang dan Argon nanti: perbedaan jumlah token dan biaya adalah perbandingan regresi Anda.
FAQ
Apakah API Gemini 4 Argon tersedia? Belum secara publik. Argon sedang diluncurkan hanya untuk serangkaian mitra Program Fairwind, yang menggunakannya melalui Gemini Enterprise. Pelanggan API berbayar dan pelanggan Google AI Ultra akan menyusul, tanpa tanggal.
Apa ID model Gemini 4 Argon? Google belum menerbitkannya. String di situs pihak ketiga adalah *placeholder*, jadi simpan model dalam variabel lingkungan dan pantau `models.list`.
Berapa biaya API Gemini 4 Argon? $2 untuk input dan $10 untuk output per 1 juta token selama periode perkenalan yang tidak disebutkan durasinya, lalu $4 dan $20. Input yang di-cache mendapat diskon 95%. Lihat harga Gemini 4 Argon.
Apakah Argon akan berfungsi dengan generateContent? Google belum mengatakannya. Dokumennya menyatakan semua model baru diluncurkan di API Interaksi, jadi bangunlah di atas Interaksi dan perlakukan `generateContent` sebagai *fallback*.
Apakah Google AI Ultra memberi saya akses API? Tidak. AI Ultra adalah langganan konsumen, bukan kunci API. Google mengatakan akses API dimulai dengan pelanggan API berbayar.
Langkah Anda Selanjutnya
Atur `GEMINI_MODEL` di setiap lingkungan, jadwalkan pemeriksaan `models.list`, dan simpan permintaan Interaksi dan `generateContent` dengan verifikasi biaya terlampir. Unduh Apidog untuk menyimpan permintaan, *mock*, dan pengujian tersebut dalam satu *workspace*, lalu ubah satu variabel ketika Google menerbitkan ID.