
Angka utama Gemini 4 Argon, 1 Juta token, adalah batas outputnya, bukan jendela konteksnya. Google mengatakan satu respons Argon dapat mencapai 1 juta token, sekitar 16 kali lipat dari batas sebelumnya 64K, dan Google belum menerbitkan jendela input Argon sama sekali. Juga belum ada yang bisa disebut: Argon saat ini hanya tersedia untuk pembela Program Fairwind, dengan pelanggan API berbayar berikutnya setelah Google membuka akses (lihat panduan tanggal rilis dan akses).
Respons sepanjang itu mematahkan tiga asumsi yang diandalkan sebagian besar tumpukan API: sebuah panggilan selesai dalam hitungan detik, bodi muat di memori, dan satu permintaan memiliki biaya kecil yang dapat diprediksi. Panduan ini mencakup biaya respons maksimal, streaming, batas waktu, batas output, penyimpanan, dan cara menguji semua itu di Apidog sebelum akses dibuka. Untuk gambaran umum model, lihat apa itu Gemini 4 Argon; untuk bentuk permintaan, lihat panduan API Gemini 4 Argon.
1 Juta token output bukanlah jendela konteks 1 Juta
Beberapa halaman yang merujuk pada Argon menjelaskan angka 1 Juta sebagai jendela konteks, dan satu berita utama menyebutnya sebagai "jendela konteks 16 kali lebih besar". Itu keliru. Postingan peluncuran Google menyatakan bahwa mereka memperluas "batas token output model menjadi 1 Juta token yang memimpin industri." Batas 64K tersebut cocok dengan batas output 65.536 token pada Gemini 3.1 Pro Preview, model Pro teratas Google sebelumnya.
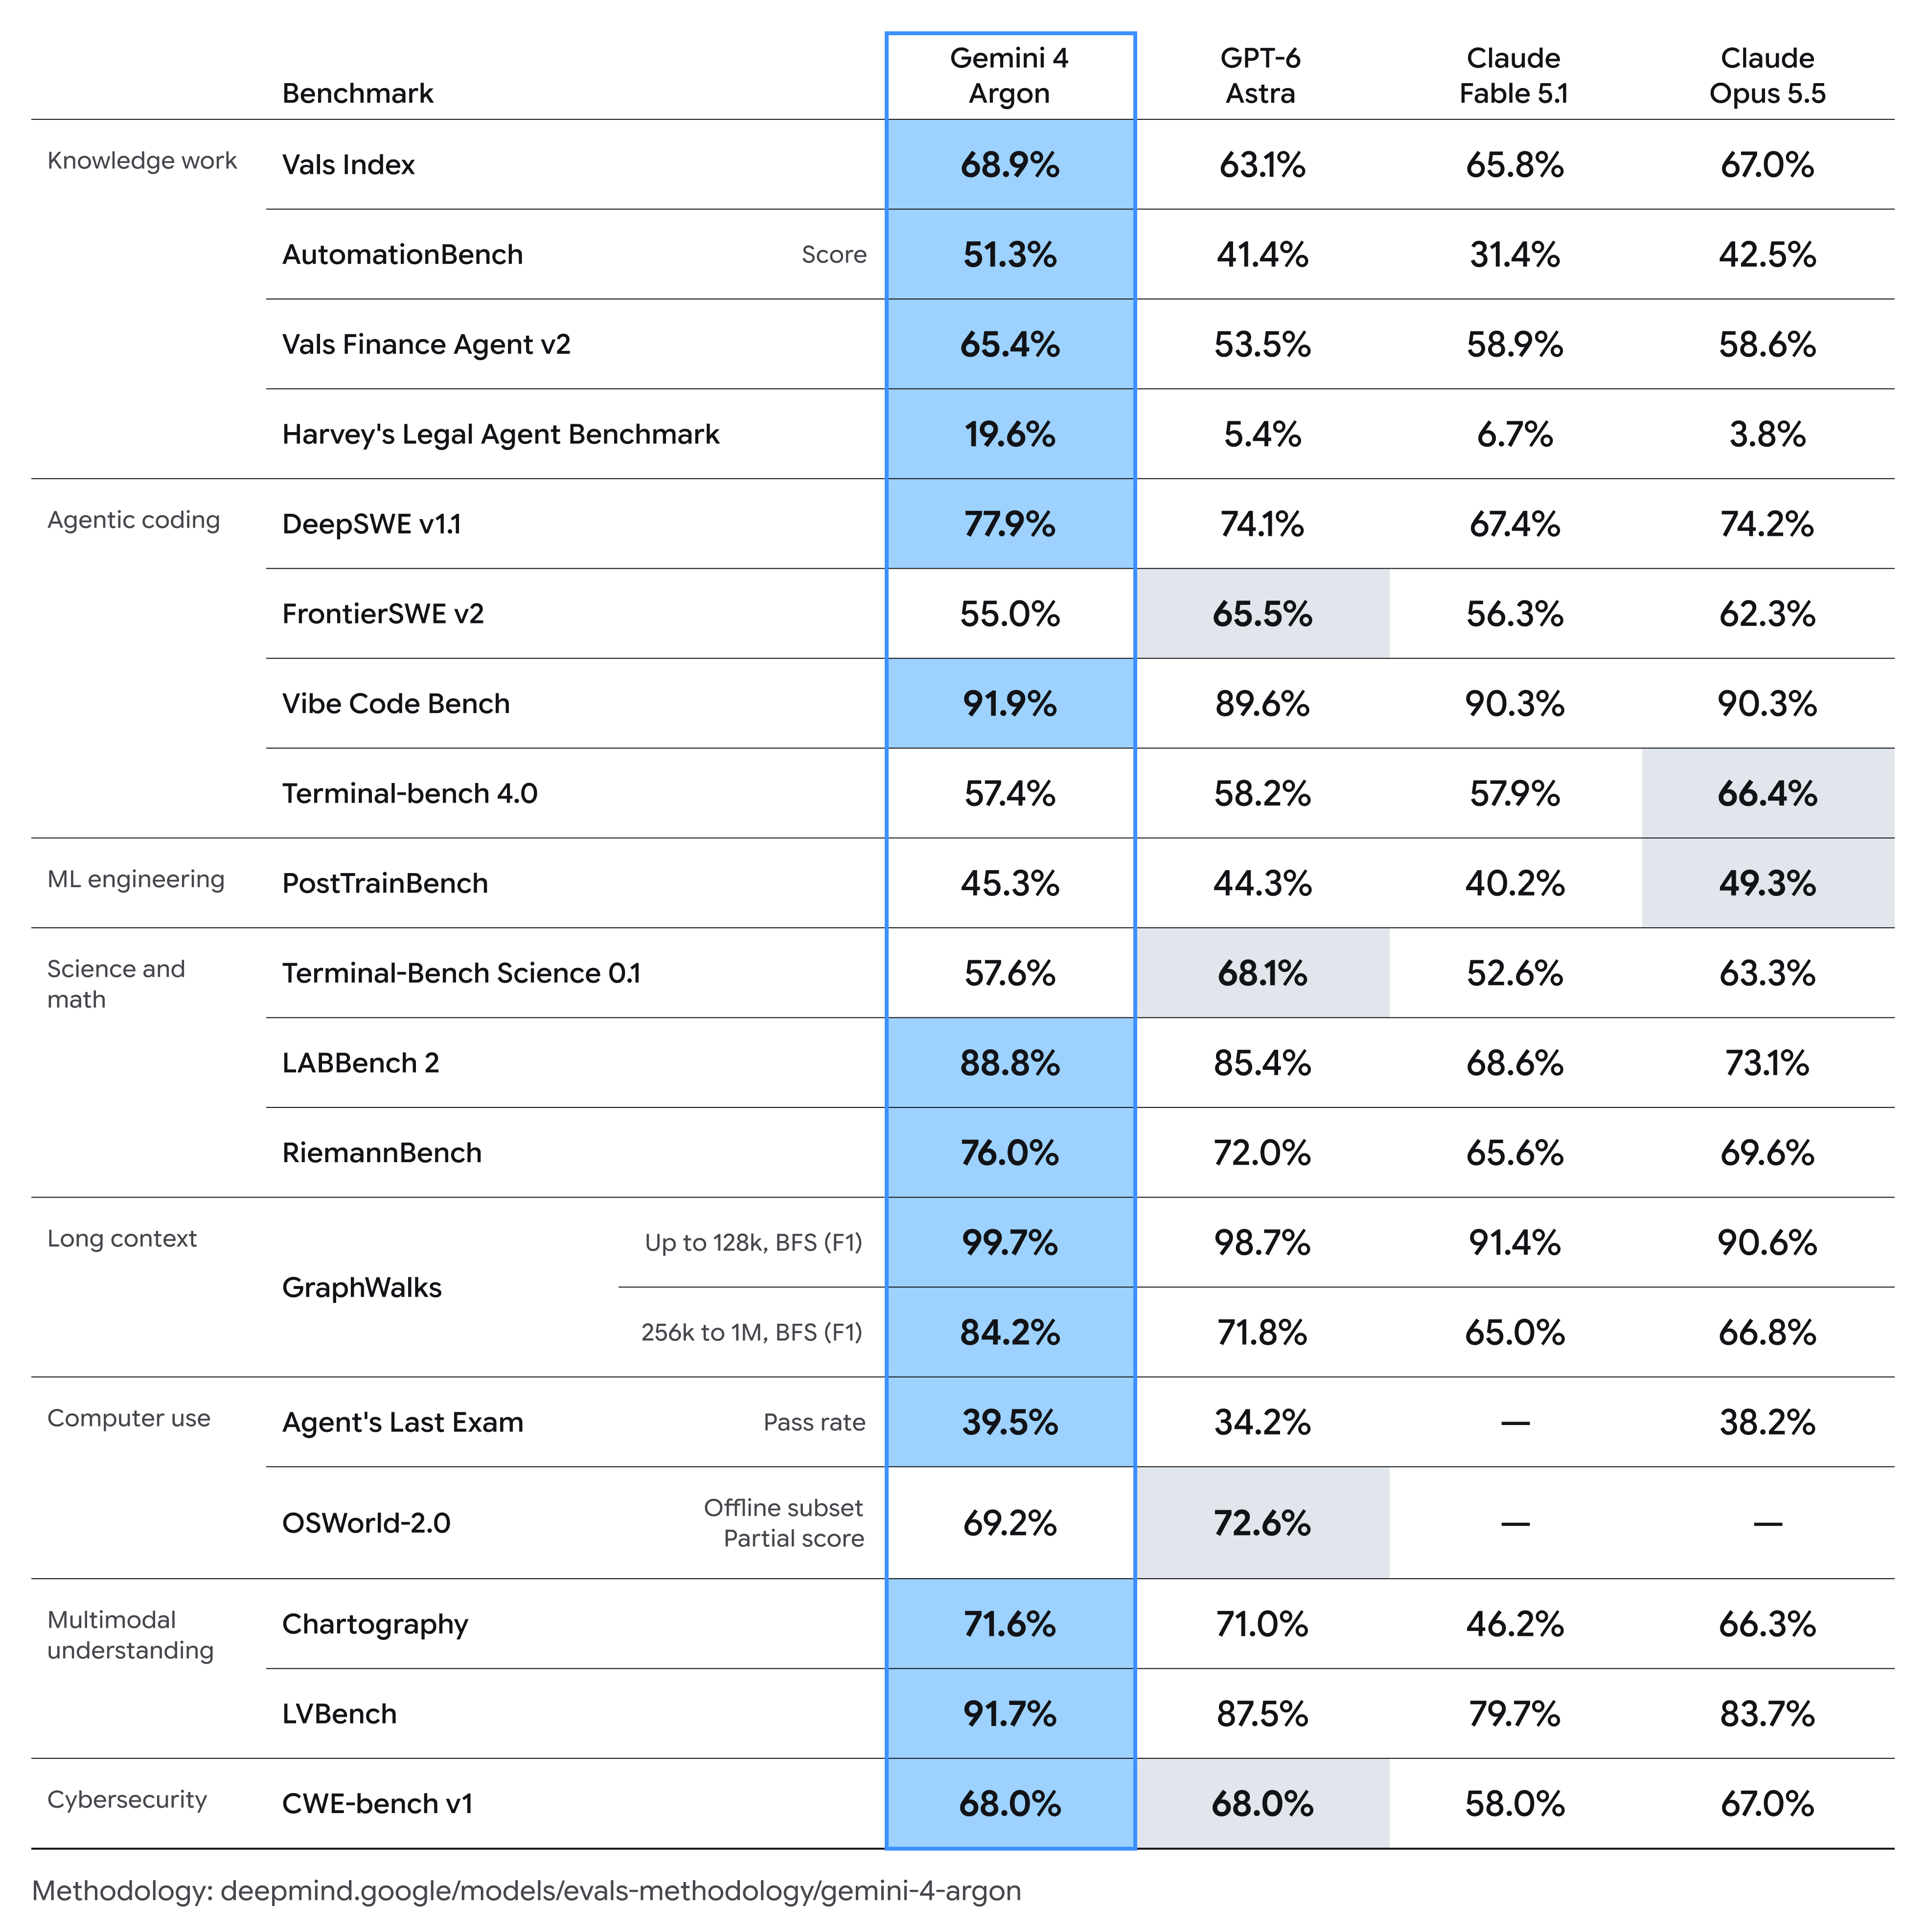
Input adalah angka terpisah yang belum diberikan Google. Evaluasi konteks panjangnya, yang dijelaskan dalam metodologi evaluasi, menggunakan prompt antara 256K dan 1 Juta token. Itu adalah subset benchmark, bukan spesifikasi. Ada peringatan di sisi output juga: Vals AI mencantumkan output maksimum 262K untuk konfigurasi Argon yang diujinya. Google mengatakan batas model adalah 1 Juta; setidaknya satu evaluator pihak ketiga melihat batas yang lebih rendah pada endpoint yang digunakannya.
| Model | Output maks per respons | Jendela input atau konteks |
|---|---|---|
| Gemini 4 Argon | 1 Juta (batas yang ditetapkan Google) | Belum diterbitkan |
| Gemini 3.1 Pro Preview | 65.536 | 1.048.576 |
| Gemini 3.8 Flash | 65.536 | 1.048.576 |
| GPT-6 Astra | 128.000 | 1.050.000 (input maks 922K) |
| Claude Opus 5.5 | 128K (300K pada Batch dengan header beta) | 1 Juta |
Setiap pesaing membatasi output sinkron pada 128K, jadi batas yang ditetapkan Argon sekitar 8x lebih besar. Alasan Google adalah kedalaman penalaran: dengan ruang kepala, model dapat "menghasilkan ratusan ribu token dalam satu lintasan" dan menyelesaikan masalah sulit dalam satu kali jalan. Untuk cara vendor lain menangani proses panjang, lihat tugas 18 jam Claude Opus 5.5 dan panduan API GPT-6 Astra.
Berapa biaya satu respons maksimal
Harga batas maksimal terlebih dahulu. Output dikenakan biaya $10 per 1 Juta token selama periode intro Argon dan $20 setelahnya, jadi satu respons panjang penuh berharga:
- Intro: 1.000.000 x $10/1 Juta = $10,00 untuk output
- Standar: 1.000.000 x $20/1 Juta = $20,00 untuk output
Input ditambahkan. Prompt 200.000 token menambahkan 200.000 x $2/1 Juta = $0,40 dengan tarif intro atau $0,80 dengan tarif standar, jadi satu panggilan maksimal berharga $10,40 atau $20,80. Sebuah pekerjaan malam yang memicu 100 panggilan tersebut berharga $1.040 dengan tarif intro.
Proses berpikir membuatnya lebih sulit dilihat. Pada model Gemini saat ini, token berpikir dikenakan biaya sebagai output; Google belum mengatakan apakah Argon mengikuti aturan itu atau apakah token berpikir dihitung terhadap batas 1 Juta. Bagaimanapun, jawaban singkat yang terlihat masih dapat menimbulkan biaya output yang besar. Panduan harga Gemini 4 Argon menyajikan lebih banyak skenario, termasuk input yang di-cache dengan diskon 95%.
Mengapa streaming wajib
Panggilan non-streaming tidak mengembalikan apa pun sampai seluruh respons selesai. Pada ratusan ribu token, itu adalah koneksi senyap yang panjang, dan batas waktu idle di seluruh tumpukan Anda dapat menutupnya sebelum byte pertama tiba.
Gunakan streaming. Pada generateContent, ganti metode dengan :streamGenerateContent?alt=sse dan Google mengirimkan peristiwa yang dikirim server (server-sent events), satu bagian kandidat parsial per peristiwa. Baca setiap peristiwa saat tiba dan tulis; jangan mengumpulkan seluruh bodi terlebih dahulu. Ini berjalan pada Gemini 3.8 Flash hari ini, dengan model dalam variabel karena Google belum menerbitkan ID model Argon (pengaturannya ada di panduan API Gemini 3.8 Flash kami):
import json, os, requests

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
URL = ("https://generativelanguage.googleapis.com/v1beta/models/"
       f"{MODEL}:streamGenerateContent?alt=sse")
body = {
    "contents": [{"parts": [{"text": "Write a test plan for every endpoint in a payments API."}]}],
    "generationConfig": {"maxOutputTokens": 60000},
}
usage = None
with requests.post(URL, json=body, stream=True, timeout=(10, 120),
                   headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]}) as r, \
        open("response.txt", "a", encoding="utf-8") as out:
    r.raise_for_status()
    for line in r.iter_lines(decode_unicode=True):
        if not line or not line.startswith("data:"):
            continue
        event = json.loads(line[5:])
        for cand in event.get("candidates", []):
            for part in cand.get("content", {}).get("parts", []):
                out.write(part.get("text", ""))
        out.flush()
        usage = event.get("usageMetadata", usage)
print(usage)
timeout=(10, 120) mengatur batas waktu koneksi 10 detik dan batas waktu baca 120 detik. Dalam requests, batas waktu baca adalah celah terpanjang antara byte, bukan durasi total, jadi aliran yang terus mengirim dapat berjalan selama diperlukan. Setiap bagian masuk ke disk saat tiba. Pada 3.8 Flash setiap peristiwa membawa usageMetadata yang sedang berjalan, jadi yang terakhir memberi Anda jumlah token akhir untuk dicatat dan ditagih.
Batas waktu di setiap lompatan
Klien Anda adalah satu lompatan. Aliran data yang panjang juga melewati reverse proxy, gateway API, penyeimbang beban, dan mungkin runtime tanpa server, dan salah satu dari itu dapat mengakhiri respons lebih awal:
| Lompatan | Apa yang harus diperiksa | Gejala jika salah |
|---|---|---|
| Klien HTTP | Batas waktu baca atau idle, ditambah batas waktu total permintaan apa pun | Pengecualian di tengah streaming hanya pada jawaban panjang |
| Reverse proxy | Batas waktu baca dan buffering respons untuk text/event-stream |
Peristiwa tiba secara beruntun, atau aliran terputus |
| Gateway API | Durasi permintaan maksimum | Permintaan gagal pada waktu yang sama setiap kali dijalankan |
| Load balancer | Batas waktu idle | Terputus selama jeda panjang sebelum peristiwa pertama |
| Fungsi tanpa server | Waktu eksekusi maksimum | Fungsi berakhir saat model masih menulis |
Perhatikan batas tetap. Jika respons panjang selalu gagal pada waktu yang sama, beberapa lompatan memiliki batas durasi keras yang tidak dapat diperbaiki oleh streaming, dan pekerjaan itu perlu dipindahkan dari jalur permintaan.
Jalankan pekerjaan panjang di latar belakang
Untuk pekerjaan terpanjang, lepaskan pekerjaan dari koneksi langsung. Interactions API mendukung eksekusi latar belakang untuk tugas yang berjalan lama menggunakan background=true. Eksekusi latar belakang bergantung pada interaksi yang tersimpan: dokumen mengatakan store=false tidak kompatibel dengan eksekusi latar belakang, jadi biarkan penyimpanan aktif untuk permintaan ini. Untuk mengambil interaksi latar belakang yang selesai, ikuti dokumen Google; jangan menebak-nebak polling endpoint. Karena Google mengatakan model baru diluncurkan di Interactions API, rencanakan pekerjaan panjang Argon untuk dijalankan di sana.
Batasi output dengan sengaja
Batas 1 Juta adalah langit-langit, bukan target. Pada generateContent, generationConfig.maxOutputTokens membatasi setiap respons; contoh streaming menetapkan 60.000. Pada 3.8 Flash, token berpikir dihitung terhadap batas tersebut: pengujian kami yang dibatasi 2.000 mengembalikan 1.340 token berpikir dan 656 token yang terlihat. Untuk Interactions API, konfirmasikan bidang batas output di dokumen Google sebelum Anda mengandalkannya. Kemudian pilih batas dari biaya yang akan Anda terima per panggilan:
| Batas output | Biaya output kasus terburuk, standar ($20/1 Juta) | Intro ($10/1 Juta) |
|---|---|---|
| 64.000 | 64.000 x $20/1 Juta = $1,28 | $0,64 |
| 128.000 | $2,56 | $1,28 |
| 500.000 | $10,00 | $5,00 |
| 1.000.000 | $20,00 | $10,00 |
Respons yang mencapai batas akan berhenti lebih awal, jadi perlakukan sebagai tidak lengkap. Periksa finishReason pada peristiwa terakhir: MAX_TOKENS berarti batas tersebut memotongnya. Kemudian lanjutkan di giliran berikutnya atau tingkatkan batas untuk pekerjaan itu.
Simpan dan urai output besar tanpa buffering
Satu juta token berarti megabita teks per respons. Beberapa aturan mencegah hal itu membebani pekerja:
- Tulis potongan data saat tiba, ke file atau unggahan objek multipart, daripada membuat satu string di memori.
- Pertahankan file parsial jika koneksi terputus. Coba lagi dari awal secara membabi buta akan menghasilkan, dan menagih, output lagi.
- Minta JSON Lines saat Anda membutuhkan struktur, sehingga setiap baris diurai sendiri daripada menunggu satu dokumen raksasa ditutup.
- Catat
usageMetadatadan jumlah byte, bukan seluruh isi. - Periksa batas ukuran kolom dan pesan di database dan antrean Anda sebelum jawaban 800K token mengenainya.
Uji di Apidog sebelum akses dibuka
Anda dapat melatih semua ini terhadap pengganti. Unduh Apidog dan lakukan tiga pemeriksaan.
Amati aliran data. Kirim permintaan streaming terhadap 3.8 Flash dengan GEMINI_API_KEY dan GEMINI_MODEL sebagai variabel lingkungan. Apidog mengurai respons text/event-stream dan menampilkan setiap peristiwa dalam tampilan Garis Waktu saat tiba, sehingga Anda dapat melihat ukuran potongan, celah, dan usageMetadata akhir.
Streaming respons palsu yang jauh lebih panjang. Output 3.8 Flash yang sebenarnya mencapai maksimal 65.536 token, jadi jalankan mock lokal yang mengalirkan lebih banyak dalam bentuk peristiwa yang sama:
# long_stream_mock.py: Gemini-shaped SSE for parser and timeout tests (fake data)
import json, time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

EVENTS, DELAY, CHUNK = 20000, 0.005, "lorem ipsum " * 40

class Handler(BaseHTTPRequestHandler):
    def do_POST(self):
        self.rfile.read(int(self.headers.get("Content-Length", 0)))
        self.send_response(200)
        self.send_header("Content-Type", "text/event-stream")
        self.end_headers()
        for i in range(EVENTS):
            event = {"candidates": [{"content": {"parts": [{"text": CHUNK}]}}]}
            if i == EVENTS - 1:  # fake counts sized like a near-max reply
                event["usageMetadata"] = {"promptTokenCount": 1200,
                    "candidatesTokenCount": 950000, "thoughtsTokenCount": 40000,
                    "totalTokenCount": 991200}
            self.wfile.write(f"data: {json.dumps(event)}\n\n".encode())
            self.wfile.flush()
            time.sleep(DELAY)

ThreadingHTTPServer(("127.0.0.1", 8787), Handler).serve_forever()
Arahkan URL dasar lingkungan "mock" ke http://127.0.0.1:8787 dan kirim permintaan streaming yang sama melaluinya. Aliran akan berjalan sekitar dua menit (128 detik dalam pengujian kami) dan membawa 9,6 juta karakter teks, cukup untuk mengungkap parser buffering, proxy yang menahan peristiwa, atau batas waktu yang terlalu singkat.
Tegaskan jumlah token. Pada permintaan generateContent non-streaming, tegaskan bahwa candidatesTokenCount ditambah thoughtsTokenCount dalam usageMetadata tetap pada atau di bawah batas Anda dan bahwa biaya yang dihitung tetap di bawah batas maksimal Anda pada harga Argon. Panduan API Argon memiliki skrip biaya siap pakai.
FAQ
Apakah 1 Juta adalah jendela konteks Gemini 4 Argon? Tidak. 1 Juta adalah batas output per respons, naik dari 64K. Google belum menerbitkan jendela input Argon.
Berapa biaya respons Argon 1 Juta token? $10 untuk output pada tarif intro dan $20 pada tarif standar, ditambah input. Lihat harga Gemini 4 Argon untuk skenario lebih lanjut.
Bisakah saya menghasilkan respons 1 Juta token hari ini? Tidak, kecuali organisasi Anda berada dalam kelompok Fairwind dengan akses Argon. Gemini 3.8 Flash dan 3.1 Pro Preview membatasi output pada 65.536 token, dan Vals AI mencantumkan output maks 262K untuk konfigurasi Argon yang diujinya.
Apakah saya harus streaming respons Argon yang panjang? Google belum menerbitkan panduan streaming untuk Argon, tetapi panggilan non-streaming yang berjalan selama beberapa menit akan terpapar pada setiap batas waktu idle di tumpukan Anda. Streaming, atau gunakan eksekusi latar belakang pada Interactions API.
Bagaimana batas output Argon dibandingkan dengan GPT-6 Astra dan Claude Opus 5.5? Keduanya membatasi output sinkron pada 128K; Anthropic mengizinkan 300K pada Batch dengan header beta. Batas 1 Juta yang ditetapkan Argon sekitar 8 kali lipat dari itu.
Langkah Anda berikutnya
Tambahkan streaming dan batas output ke klien Gemini Anda sekarang, pada 3.8 Flash, dan jalankan terhadap aliran mock panjang sampai tidak ada dalam tumpukan Anda yang memotongnya. Ketika ID Argon dikirim, ubah GEMINI_MODEL dan jalankan kembali pengujian yang sama di Apidog.