DeepSeek menerbitkan kartu model untuk DeepSeek-V4.1-Flash pada 10 September 2026, dan angka-angkanya kurang mengenakkan bagi pelanggan V4-Pro. Model yang lebih kecil dan lebih murah ini memiliki skor lebih tinggi daripada model unggulan pada setiap tolok ukur pengkodean dan agen yang DeepSeek daftar, biayanya 70 hingga 77% lebih murah per token pada puncaknya, dan pada 14 September, model ini akan sepenuhnya menggantikan V4-Pro: setiap permintaan deepseek-v4-pro akan dialihkan ke V4.1-Flash dan ditagih dengan tarif Flash.
Ini bukan pertukaran biasa antara yang kecil dan besar. Ini adalah perbandingan dengan tenggat waktu. Jika Anda menjalankan V4-Pro dalam produksi, Anda memiliki empat hari untuk mempelajari perubahan apa yang terjadi saat pengalihan dilakukan. Jika Anda menjalankan V4-Flash, perubahan sudah terjadi: nama deepseek-v4-flash dilayani oleh V4.1-Flash hari ini.
Di bawah ini: ketiga model berdasarkan arsitektur, tolok ukur yang dilaporkan DeepSeek, harga USD, dan throughput, kemudian alur kerja untuk menjalankan satu set prompt melalui deepseek-v4-pro dan deepseek-flash di Apidog sebelum transisi untuk membandingkan output, latensi, dan jumlah penggunaan. Untuk pembahasan mendalam tentang arsitektur, baca terlebih dahulu apa itu DeepSeek-V4.1-Flash; untuk daftar periksa migrasi, lihat panduan penghentian V4-Pro.
TL;DR
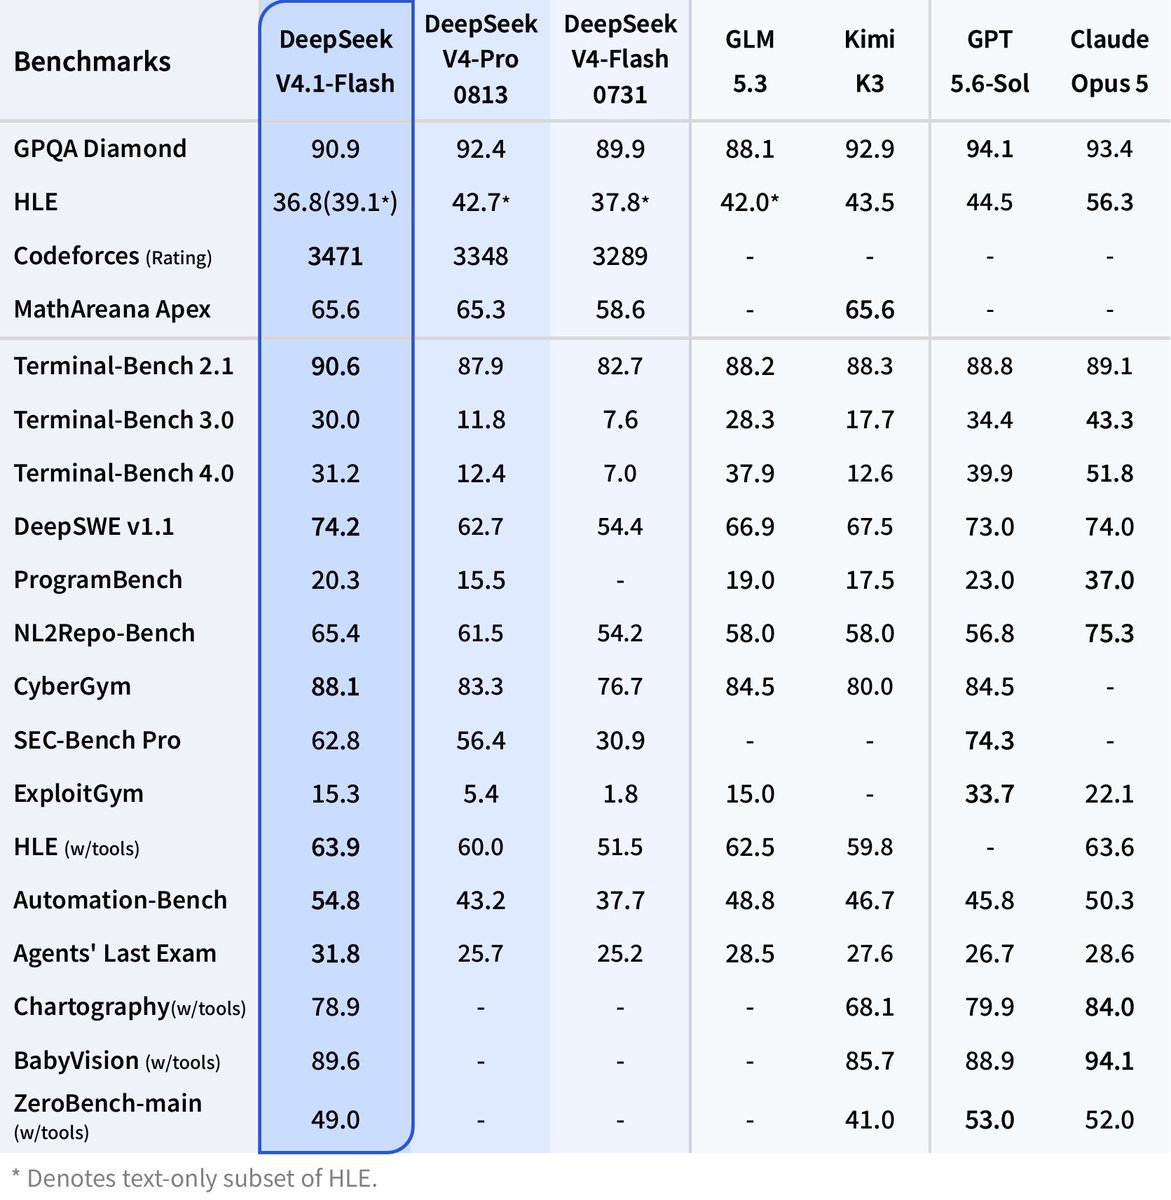
- V4.1-Flash unggul pada tolok ukur DeepSeek sendiri. DeepSWE v1.1 adalah sorotan utama: 74.2 dibandingkan 62.7 untuk V4-Pro dan 54.4 untuk V4-Flash.
- Ini yang termurah dari ketiganya. Input cache-miss puncak adalah $0.30 per 1 juta token dibandingkan $1.32 untuk V4-Pro dan $0.44 untuk V4-Flash lama.
- Ini dibangun untuk throughput tinggi. 8 miliar parameter aktif pada prefill, cache KV sebesar 890 byte per token, dan batas konkurensi 2.500.
- Setelah 14 September hanya ada satu pilihan. Lalu lintas V4-Pro dialihkan ke V4.1-Flash. Pertanyaannya adalah apa yang Anda peroleh dan hilangkan, bukan mana yang harus dipilih.
Spesifikasi Berdampingan
Generasi V4.1 adalah arsitektur baru, bukan pelatihan ulang. DeepSeek menyebutnya Causal Encoder-Decoder (CED): 40 lapisan yang terbagi menjadi 20 encoder dan 20 decoder, dengan 384 ahli yang dialihkan ditambah satu ahli bersama per lapisan. Kartu model menyebutkan tulang punggungnya memiliki 552B parameter (763B dengan encoder visi).
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| Generasi Arsitektur | V4 MoE | V4 MoE | V4.1 Causal Encoder-Decoder, 40 lapisan |
| Total parameter | 284B (daftar OpenRouter dari build visi) | Tidak diungkapkan di sini | 552B tulang punggung, 763B dengan encoder visi |
| Parameter aktif | 13B | Tidak diungkapkan di sini | 8B prefill, 16B decode |
| Jendela konteks | 1M token | 1M token | 1M token |
| Output maksimal | 384K token | 384K token | 384K token |
| Visi | Build Vision-Exp terpisah | Tidak diungkapkan di sini | Native, encoder DeepSeek-ViT |
| Lisensi | Tidak dibahas di sini | Tidak dibahas di sini | MIT, bobot di Hugging Face |
| Batas konkurensi | 2.500 | 500 | 2.500 |
| Status API | Dihentikan, alias dilayani oleh V4.1-Flash | Dialihkan ke V4.1-Flash pada 14 Sep | GA sejak 10 Sep, id model deepseek-flash |
Jumlah parameter aktif yang terpisah adalah detail yang perlu diperhatikan: V4-Flash menggunakan 13B untuk setiap token, sementara V4.1-Flash menghabiskan 8B untuk input dan 16B untuk output, di mana kualitasnya berada.
Tolok Ukur: dari mana datangnya 11.5 poin
Setiap angka di bawah ini dilaporkan oleh DeepSeek dari kartu model. Tidak ada pengujian independen yang dipublikasikan, dan frasa "pengujian oleh berbagai pihak" dalam pemberitahuan penghentian tidak menyebutkan namanya. Perlakukan ini sebagai klaim vendor dan verifikasi dengan prompt Anda sendiri.
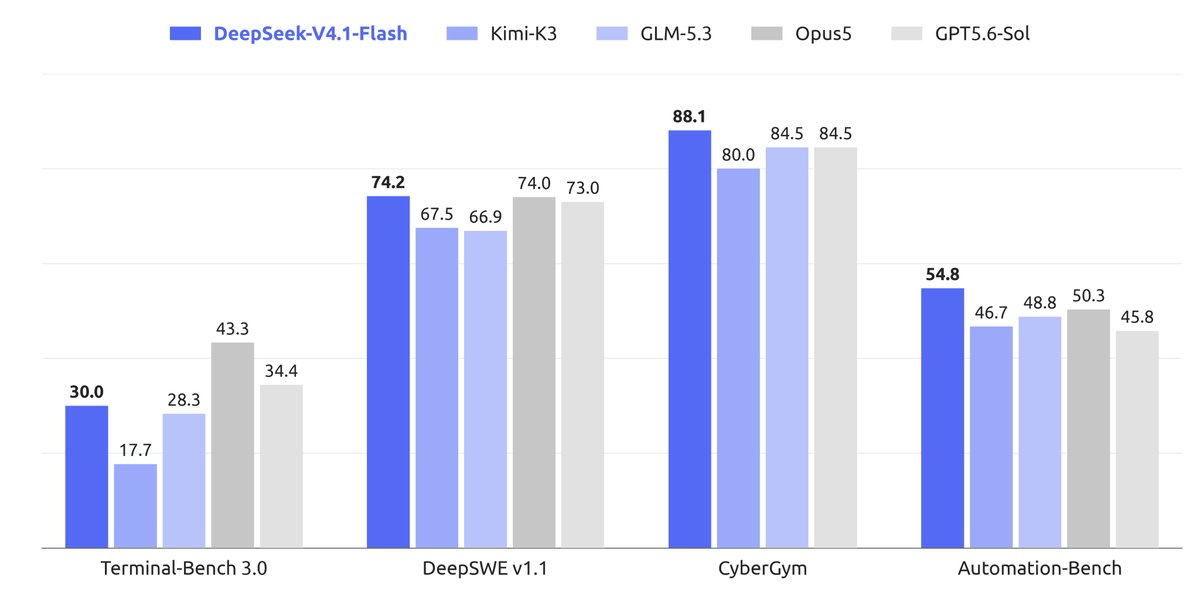
DeepSWE v1.1 (+11.5 atas Pro, +19.8 atas V4-Flash). Ini adalah sorotan utama, dan satu-satunya perbedaan yang cukup besar untuk mengubah keputusan. DeepSWE mengukur tugas rekayasa perangkat lunak multi-file, beban kerja yang dijalankan oleh agen pengkodean sepanjang hari. Jika ini berlaku di repo Anda, V4.1-Flash mengungguli model yang biayanya empat kali lebih mahal.
Terminal-Bench 2.1 (+2.7). Tugas agen berbasis shell. V4-Flash-0731 sudah mengalahkan V4-Pro-Preview di sini pada bulan Juli; V4.1 memperluas keunggulan kurang dari tiga poin. Nyata, tidak menentukan.
HumanEval (+2.6) dan GSM8K (+0.4). Keduanya mendekati saturasi: setiap model mencapai 90 pada GSM8K, dan HumanEval sedikit berbicara tentang kode produksi. Jangan terlalu mempertimbangkan baris ini.
MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 memiliki angka generasi V4 dibandingkan dengan model terbuka lainnya; belum ada yang menyertakan V4.1.
Biaya: tiga model, enam tingkat harga
Puncak adalah Senin hingga Jumat, 01:00 hingga 04:00 dan 06:00 hingga 10:00 UTC; lainnya adalah di luar jam sibuk dengan setengah harga. Tarif adalah per 1 juta token dari halaman harga, berlaku mulai 10 September. Baris V4-Flash menggunakan tarif USD 21 Agustus 2026 sebagai kolom "sebelum".
| Model dan tingkatan | Input, cache hit | Input, cache miss | Output |
|---|---|---|---|
| V4-Flash, di luar jam sibuk (tarif 21 Ags) | $0.007 | $0.22 | $0.66 |
| V4-Flash, jam sibuk (tarif 21 Ags) | $0.014 | $0.44 | $1.32 |
| V4-Pro, di luar jam sibuk | $0.022 | $0.66 | $1.98 |
| V4-Pro, jam sibuk | $0.044 | $1.32 | $3.96 |
| V4.1-Flash, di luar jam sibuk | $0.003 | $0.15 | $0.60 |
| V4.1-Flash, jam sibuk | $0.006 | $0.30 | $1.20 |
Dibandingkan V4-Flash, V4.1 memangkas input cache-hit sekitar 57%, input cache-miss sekitar 32%, dan output sekitar 9%. Dibandingkan V4-Pro, pemangkasan adalah 77% pada input cache-miss dan 70% pada output di jam sibuk.
Satu bulan kerja. Agen pengkodean memproses 2 miliar token input per bulan dengan tingkat cache-hit 70% (prompt sistem dan konteks repo digunakan kembali di setiap giliran) dan menghasilkan 300 juta token output, semuanya pada jam sibuk.
| V4-Pro, jam sibuk | V4-Flash, jam sibuk | V4.1-Flash, jam sibuk | V4.1-Flash, di luar jam sibuk | |
|---|---|---|---|---|
| 1.4B input cache-hit | $61.60 | $19.60 | $8.40 | $4.20 |
| 600 juta input cache-miss | $792.00 | $264.00 | $180.00 | $90.00 |
| 300 juta output | $1,188.00 | $396.00 | $360.00 | $180.00 |
| Total Bulanan | $2,041.60 | $679.60 | $548.40 | $274.20 |
Itu 73% lebih murah dari V4-Pro, dan memindahkan pekerjaan batch di luar jam sibuk akan memangkasnya lagi hingga separuh. Token output mendominasi setiap kolom, jadi pemangkasan output 70% lebih penting daripada judul cache-hit. Rincian harga V4.1-Flash mencakup perhitungan cache-hit.
Kecepatan dan throughput
DeepSeek tidak mempublikasikan angka token per detik, jadi cerita throughput ini didasarkan pada tiga fakta arsitektur dan satu anekdot.
- Cache KV sebesar 890 byte per token. Caching KV utama FP4 menempatkan cache global kira-kira seperempat dari jejak V4-Flash. Catatan rilis menyatakan ukurannya 1/4 HBM dan 1/8 penyimpanan SSD dari generasi sebelumnya. Konteks 1 juta token penuh membutuhkan sekitar 0.9 GB cache.
- 8B parameter aktif pada prefill. Komputasi per token input lebih sedikit daripada 13B milik V4-Flash, sehingga waktu hingga token pertama pada konteks besar seharusnya berkurang.
- Konkurensi 2.500 vs 500. Lalu lintas V4-Pro yang dialihkan mewarisi batas Flash, peningkatan 5x untuk armada agen.
- Laporan satu pengguna: "hampir 400 t/s". Seorang pengguna X mempostingnya dari pengujian video selama beta; ini adalah anekdot, bukan tolok ukur. Utas beta HN sebagian besar menunjukkan antusiasme yang sama.
Ukur p50 dan p95 Anda sendiri sebelum Anda mempercayai semua ini.
Apa yang Anda rugikan dan dapatkan setelah 14 September
Tidak ada "model mana yang harus saya pilih" setelah transisi. deepseek-v4-pro menjadi alias, jadi penjelasannya yang jujur adalah seperti buku besar.
Anda mendapatkan: skor lebih tinggi pada setiap tolok ukur yang terdaftar, harga puncak 70 hingga 77% lebih rendah, konkurensi 5x, input gambar native tanpa ID model visi terpisah, dan dial upaya penalaran yang DeepSeek gambarkan dapat dikontrol secara terus-menerus pada skala 1 hingga 100.
Anda kehilangan: kemampuan untuk mengunci checkpoint generasi V4. Prompt yang disetel untuk gaya, verbositas, atau pemformatan panggilan alat V4-Pro dapat bergeser. Panjang output dan jumlah token penalaran dapat berubah, yang mengubah tagihan Anda dengan cara yang tidak ditunjukkan oleh tabel tarif. Dan pengalihan terjadi sesuai jadwal DeepSeek, bukan Anda.
Daftar kedua itulah mengapa Anda harus membandingkan sebelum tanggal 14, bukan sesudahnya.
Bandingkan V4-Pro dengan V4.1-Flash di Apidog sebelum transisi
Apidog menguji lapisan API, jadi ini adalah tempat yang tepat untuk menjalankan satu set prompt melalui kedua ID model dan membandingkan hasilnya.
- Tambahkan endpoint. Buat proyek dan tambahkan
POST https://api.deepseek.com/chat/completions, atau impor spesifikasi OpenAPI. - Masukkan kunci dan ID model ke dalam lingkungan. Simpan
DEEPSEEK_API_KEYdan variabelMODEL. Buat dua lingkungan,v4-prodenganMODEL=deepseek-v4-prodanv41-flashdenganMODEL=deepseek-flash, lalu referensikan keduanya sebagaiBearer {{DEEPSEEK_API_KEY}}di header dan"model": "{{MODEL}}"di body. - Simpan prompt asli Anda sebagai permintaan. Pilih 20 hingga 30 prompt yang mewakili produksi: prompt sistem Anda, giliran panggilan alat, ringkasan konteks panjang, pengeditan kode multi-file. Simpan setiap permintaan dengan
stream: falseagar objekusagemasuk ke body respons. - Assert pada bidang yang mengubah tagihan Anda. Buat skenario pengujian dari permintaan yang tersimpan dan tambahkan assert pada
usage.prompt_tokens,usage.completion_tokens, danusage.prompt_cache_hit_tokens. Catat waktu respons per langkah, dan tambahkan skrip pra-permintaan yang menyertakan nama lingkungan ke header agar eksekusi diberi label. - Jalankan sekali per lingkungan, lalu bandingkan. Jalankan skenario di bawah
v4-pro, lalu di bawahv41-flash. Bandingkan jumlah completion-token (pengalihan mengubah tagihan output Anda), latensi per langkah, dan konten itu sendiri untuk pergeseran format. - Jalankan ulang di CI pada tanggal 14. Jalankan skenario yang sama dengan
apidog-clidi pipeline Anda saat transisi. Apa pun yang rusak akibat pengalihan akan muncul sebagai assertion yang gagal, bukan tiket dukungan.
Perbandingan yang sama sebagai skrip:
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Make payment retries in the checkout service idempotent. Return a unified diff."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
Jalankan pada jam sibuk dan di luar jam sibuk, lalu simpan outputnya. Unduh Apidog untuk menyimpan perbedaan, assert, dan riwayat eksekusi di satu tempat.
FAQ
- Apakah V4.1-Flash lebih baik dari V4-Pro dalam pengkodean? Berdasarkan angka yang dilaporkan DeepSeek, ya: 74.2 vs 62.7 pada DeepSWE v1.1 dan 90.6 vs 87.9 pada Terminal-Bench 2.1. Untuk perbandingan generasi V4 dengan Claude dalam pengkodean, lihat DeepSeek V4 vs Claude Opus untuk pengkodean.
- Apa yang terjadi pada integrasi V4-Pro saya pada 14 September? Mulai pukul 04:00 UTC, setiap permintaan
deepseek-v4-prodilayani oleh V4.1-Flash dan ditagih dengan tarif Flash. Kode Anda tetap berfungsi; model di baliknya berubah. Panduan migrasi memiliki daftar periksa lengkap. - Apakah saya perlu mengganti nama deepseek-v4-flash menjadi deepseek-flash? Tidak hari ini.
deepseek-v4-flashdandeepseek-v4-flash-vision-expmasih diterima dan dilayani oleh V4.1-Flash. DeepSeek belum memberikan tanggal penghapusan, jadi beralihlah kedeepseek-flashsaat Anda mengubah konfigurasi berikutnya. - Apakah V4.1-Flash lebih cepat dari V4-Pro? DeepSeek mengatakannya tetapi tidak mempublikasikan angka. Arsitekturnya mendukung klaim tersebut: 8B parameter aktif pada prefill dan cache KV seperempat ukuran V4-Flash. Ukur sendiri.
- Bisakah saya masih menjalankan V4-Pro di suatu tempat? Tidak di API DeepSeek setelah tanggal 14. Latar belakang generasi V4 ada di Apa Itu DeepSeek V4; bobot V4.1-Flash ada di Hugging Face di bawah lisensi MIT.
Versi singkat
V4.1-Flash lebih kecil, lebih murah, dan memiliki skor lebih tinggi secara bersamaan, setidaknya di tabel vendor, dan tabel itu tidak dapat memberi tahu Anda apakah itu lebih baik untuk prompt Anda. Jalankan kedua ID model melalui set prompt yang sama di Apidog minggu ini, simpan perbedaannya, dan Anda akan tahu perubahan apa yang terjadi pada 14 September sebelum pengguna Anda mengetahuinya.