
Untuk Claude Fable 5.2 vs Opus 5.5, mulailah dengan Opus 5.5 untuk pengodean sehari-hari dan pekerjaan berbasis pengetahuan. Coba Fable 5.2 ketika penalaran yang sulit, migrasi yang ambigu, atau proyek agen jangka panjang melampaui kapabilitas dasar Opus Anda. Bandingkan pengaturan effort dan biaya per hasil yang diterima sebelum memindahkan seluruh beban kerja Anda.
Rekomendasi ini mengikuti pengumuman Fable 5.2 dari Anthropic, yang diverifikasi pada 10 November 2026. Ini adalah perbandingan berbasis sumber; kami belum menjalankan benchmark head-to-head secara independen. Perbandingan Opus 5 vs Fable 5 kami sebelumnya membahas generasi yang lebih lama. Tarif, default, dan bukti di bawah ini berlaku untuk versi-versi yang lebih baru ini.
Claude Fable 5.2 vs Opus 5.5 sekilas
| Titik keputusan | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| Peran awal | Penalaran berat dan pekerjaan agen jangka panjang | Pilihan default untuk sebagian besar beban kerja |
| ID model Claude API | claude-fable-5-2 |
claude-opus-5-5 |
| Input standar, per satu juta token | $8 | $4 |
| Output standar, per satu juta token | $40 | $20 |
| Effort default API | High | Medium |
| Context window | 1 juta token | 1 juta token |
| Output maksimum | 128 ribu token | 128 ribu token |
| Label latensi komparatif | Moderate | Moderate |
Sumber: ikhtisar model Claude saat ini. Kedua model menerima teks dan gambar, menghasilkan teks, mendukung tools, dan menggunakan adaptive thinking yang selalu aktif. Context window yang lebih besar karenanya tidak membedakan keduanya. Kemampuannya menyelesaikan tugas spesifik Anda itulah yang membedakan.
Tarif token standar Fable dua kali lipat milik Opus. Itu menjadikan Opus titik awal yang masuk akal ketika kedua model memenuhi kriteria penerimaan Anda dengan volume token yang serupa. Namun itu tidak menetapkan mana yang memiliki tagihan lebih rendah ketika kedalaman penalaran, jumlah retry, dan panggilan tool berbeda.
Tugas pengodean seperti apa yang membenarkan beralih ke Fable 5.2?
Gunakan Opus untuk perubahan terbatas dengan pemeriksaan yang jelas. Uji Fable ketika agen harus menemukan masalah, mengoordinasikan beberapa perubahan yang saling bergantung, atau pulih dari pendekatan yang gagal. Ini adalah rekomendasi beban kerja yang disimpulkan dari positioning dan hasil Anthropic, bukan jaminan terukur untuk repositori Anda.
| Tugas Anda | Pilihan awal | Bukti yang membenarkan eskalasi |
|---|---|---|
| Menambahkan endpoint yang terdokumentasi | Opus 5.5 | Kegagalan kontrak atau integrasi yang berulang |
| Memperbarui test setelah refactor kecil | Opus 5.5 | Agen tidak dapat mengidentifikasi invariant yang berubah |
| Debug kegagalan lintas service yang intermiten | Opus, lalu Fable | Opus mengulangi perbaikan tanpa menguji penyebab alternatif |
| Migrasi service dengan dependensi yang tidak jelas | Bandingkan keduanya | Fable menyelesaikan lebih banyak perubahan yang diterima dalam anggaran |
| Mengoordinasikan proyek teknis jangka panjang | Uji coba Fable | Perencanaan yang lebih baik bertahan melalui eksekusi dan review |
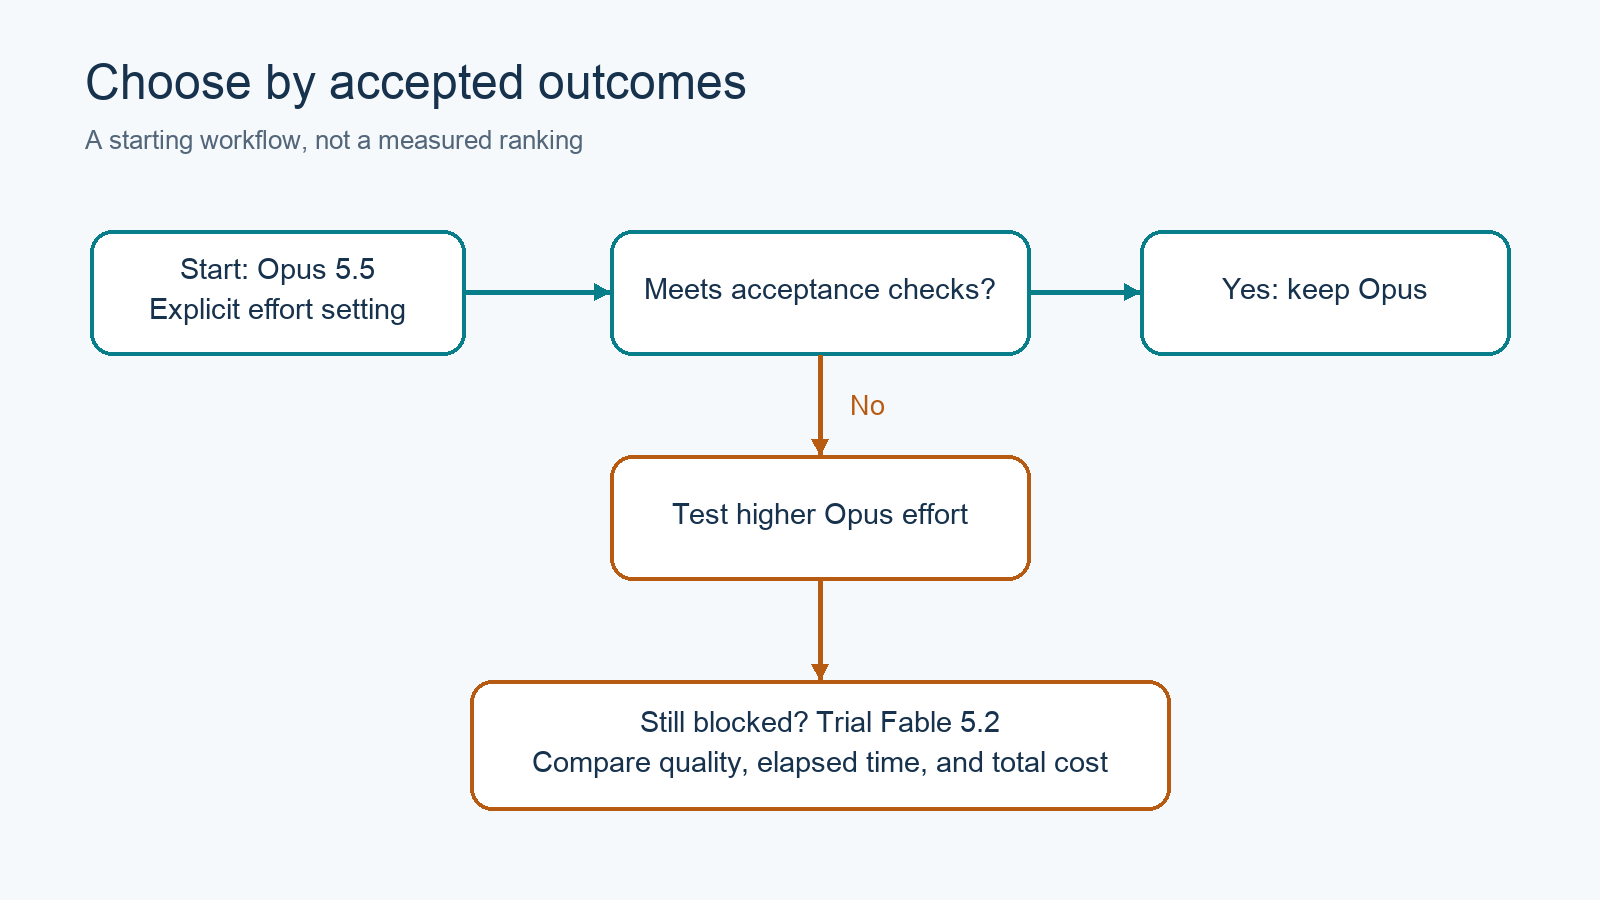
Eskalasi selektif: pertahankan tugas rutin pada baseline Anda dan serahkan pekerjaan sulit ke model yang lolos pemeriksaan Anda.
Pertimbangkan payment webhook yang secara intermiten memproses satu event dua kali. Jika perbaikan yang dibutuhkan sudah dispesifikkan, Opus menghadapi tugas pengodean terbatas. Namun jika agen harus merekonstruksi konkurensi lintas retry, penyimpanan, dan service downstream, investigasi tersebut adalah kandidat yang lebih kuat untuk uji coba Fable.
Berikan model mana pun bukti insiden dan kendala yang sama. Model yang lebih mahal tidak dapat mengompensasi log yang hilang, dependensi yang tidak dapat diakses, atau acceptance test yang menghargai perilaku yang salah.
Apa yang ditunjukkan benchmark Anthropic?
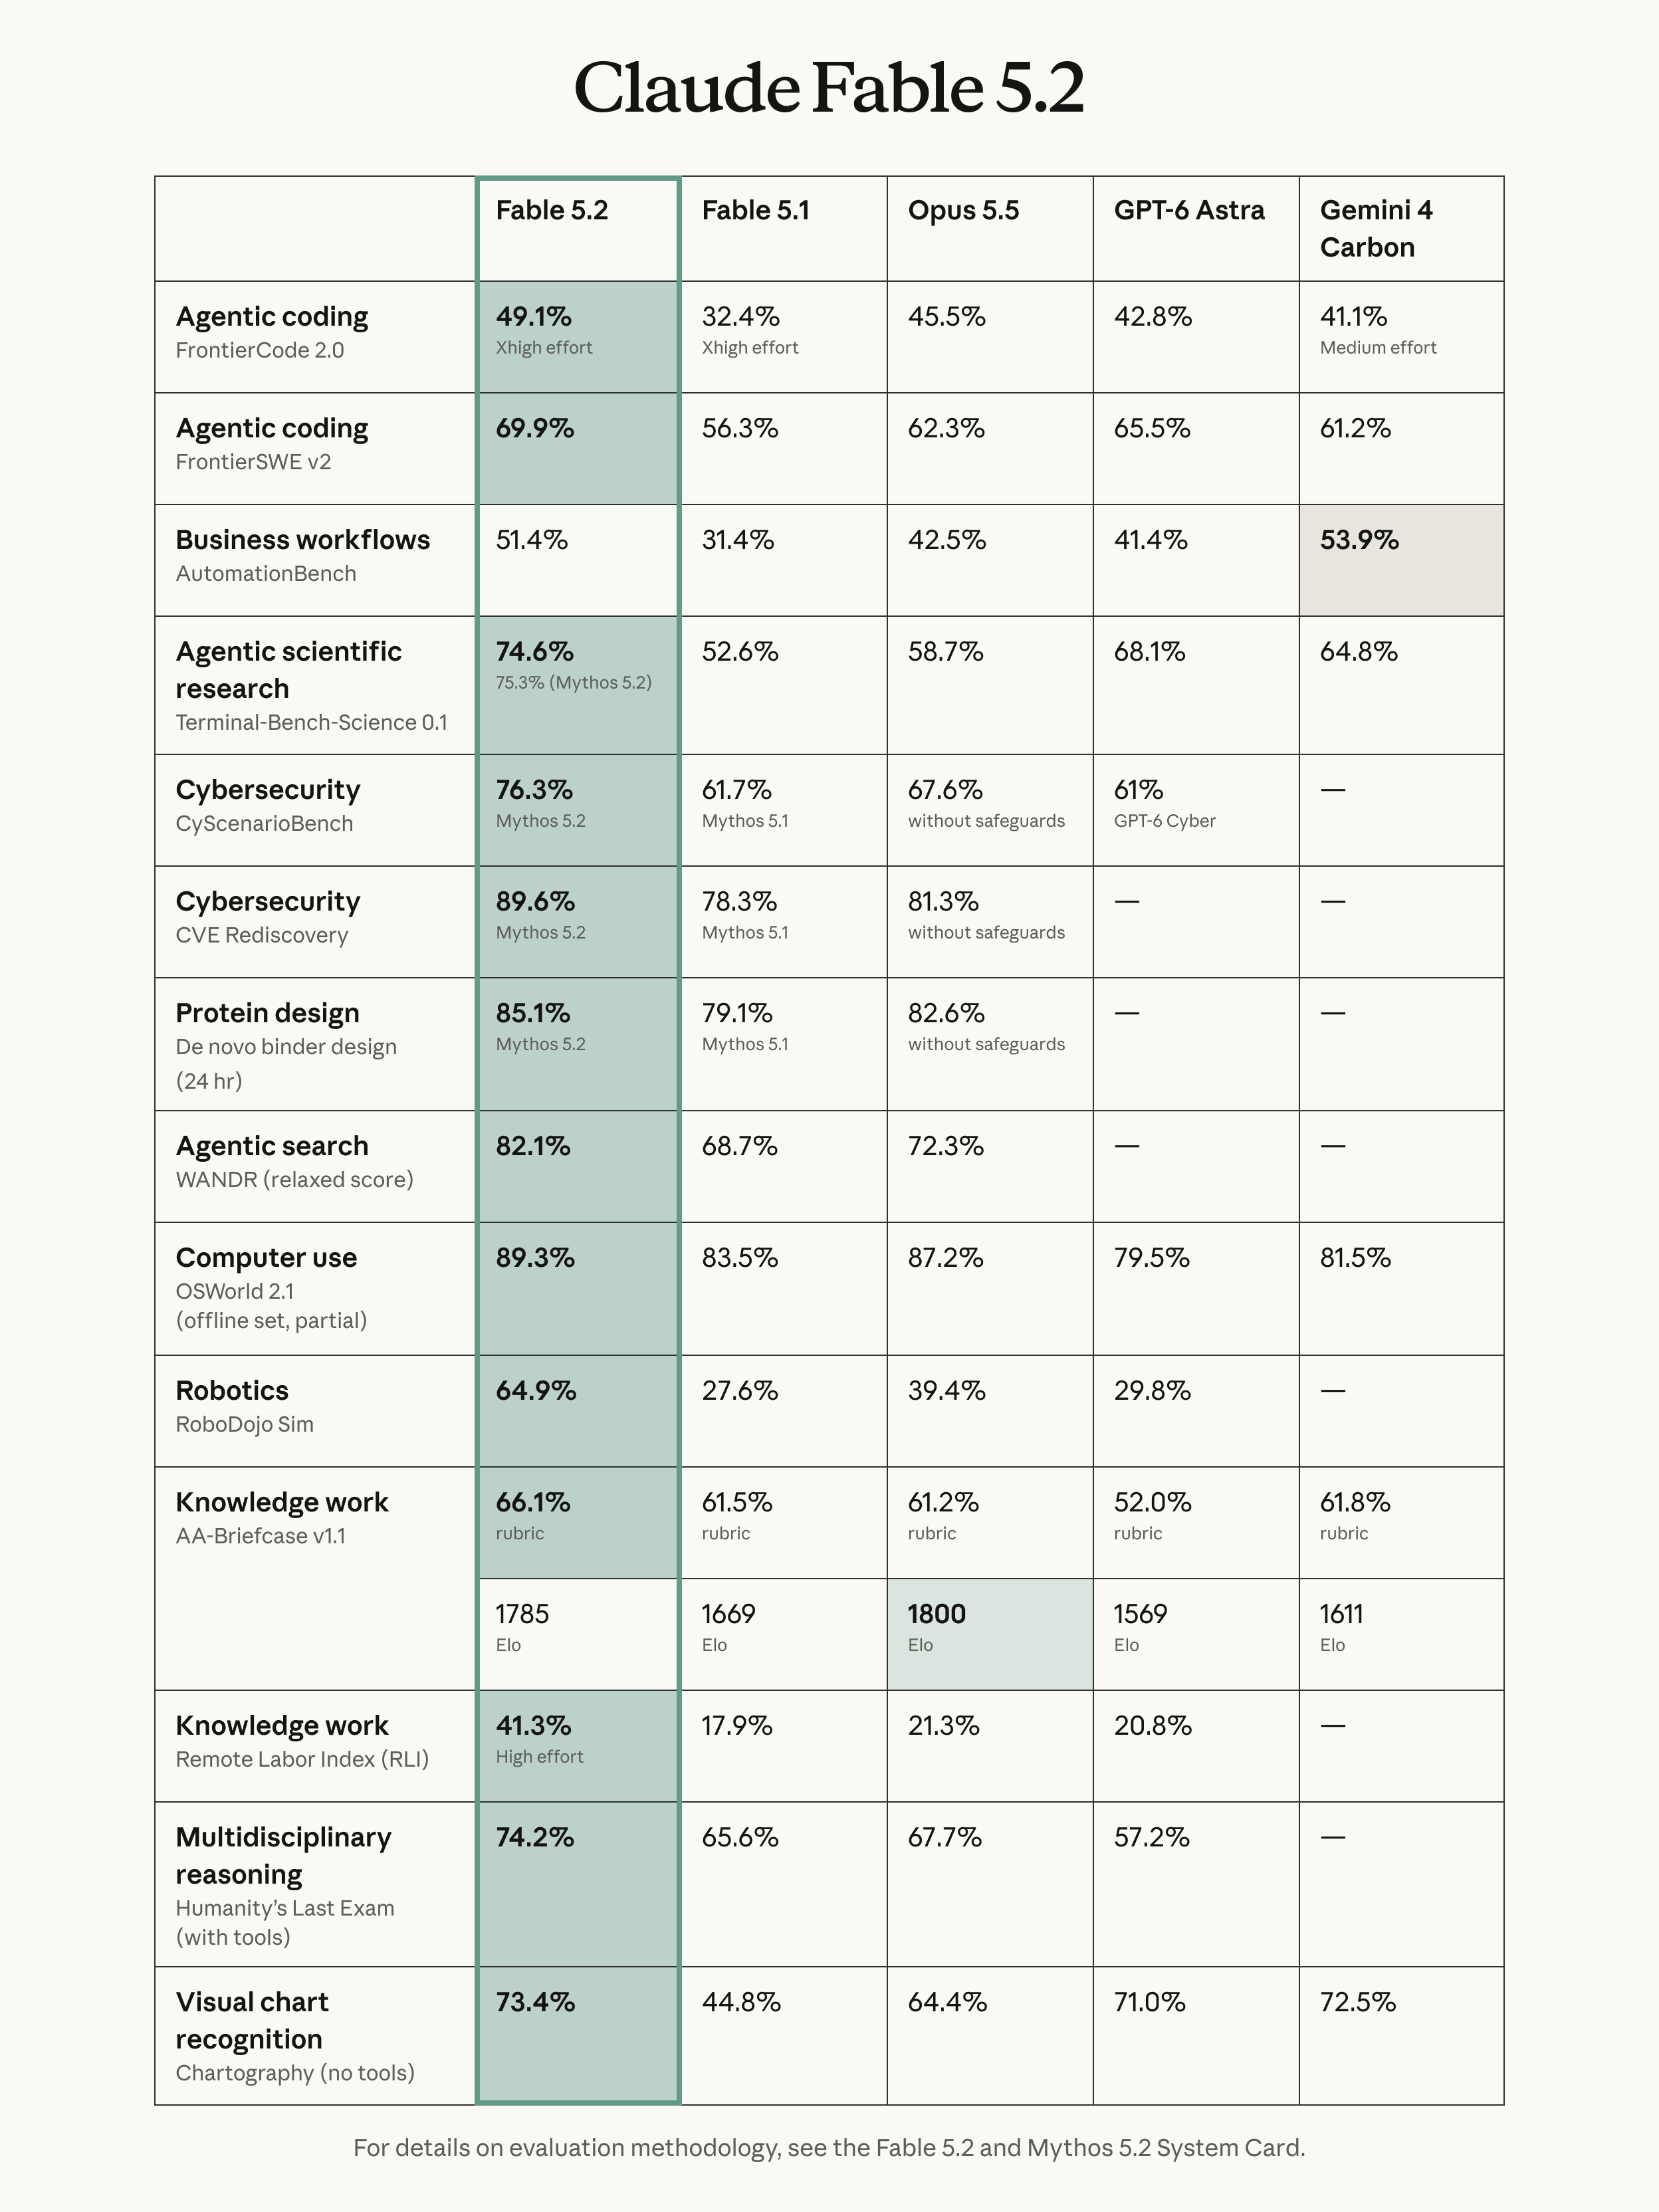
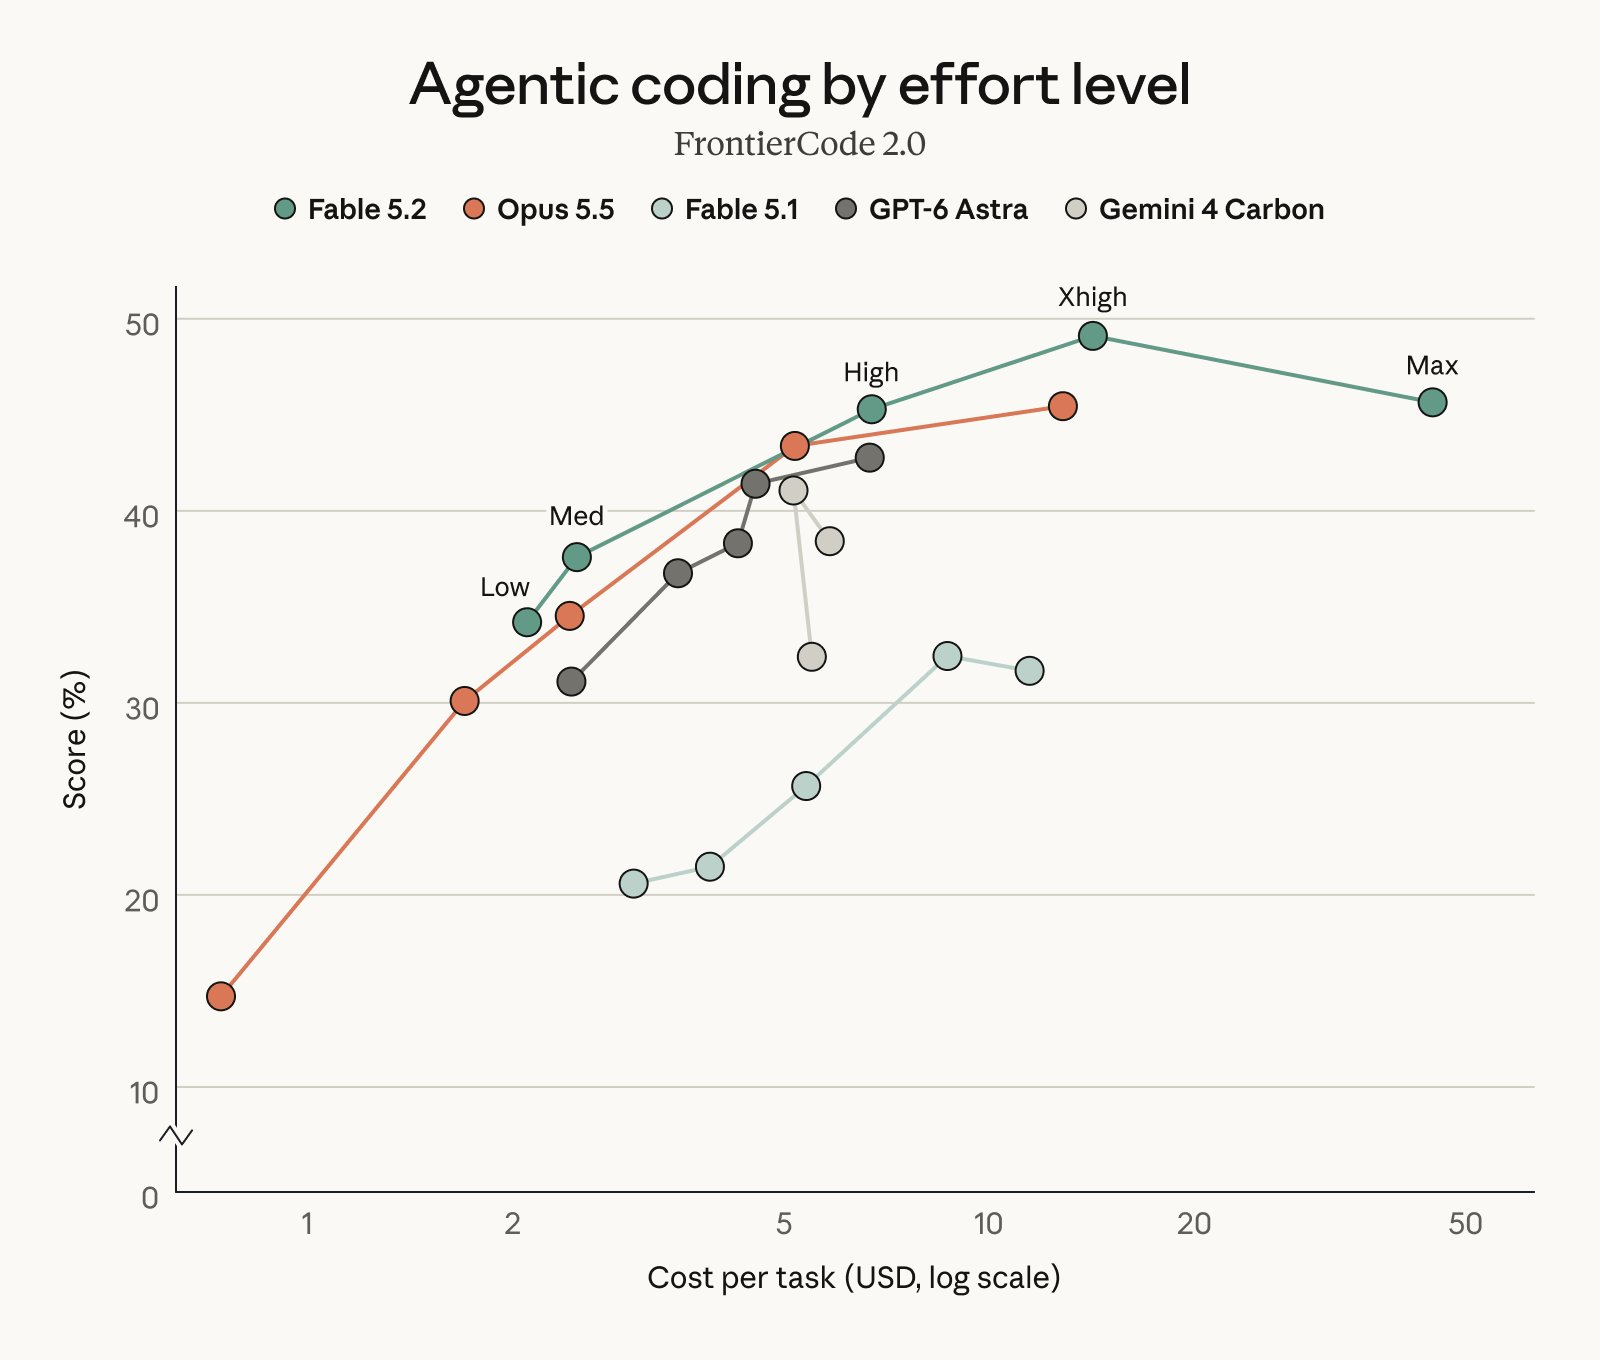
Anthropic melaporkan skor Fable 5.2 yang lebih tinggi pada beberapa evaluasi pengodean dan penalaran. Sinyal praktis terkuat adalah hasilnya dalam hal effort versus biaya: Fable pada High hampir menyamai Opus pada Max di FrontierCode 2.0 dengan biaya per tugas sekitar setengahnya dalam pengujian awal Anthropic.
| Evaluasi yang dilaporkan vendor | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0, agentic coding | 49,1% pada Xhigh | 45,5% |
| FrontierSWE v2, agentic coding | 69,9% | 62,3% |
| WANDR, agentic search, skor relaxed | 82,1% | 72,3% |
| OSWorld 2.1, set offline parsial | 89,3% | 87,2% |
Angka-angka ini berasal dari pengumuman, yang menyatakan skor menggunakan effort tertinggi yang tersedia kecuali disebutkan lain. Angka tersebut menggambarkan kondisi evaluasi Anthropic, bukan pengaturan default atau tingkat kelulusan yang diharapkan untuk tiket Anda.
Perbandingan biayanya masih lebih sempit lagi. Fable pada High mencetak skor 45,3%, dibandingkan dengan skor terbaik Opus sebesar 45,5%. Itu mendukung pengujian konfigurasi yang lebih murah untuk evaluasi tersebut. Namun tidak berarti setiap alur kerja Fable berbiaya setengah dari Opus.
Hindari mengubah persentase benchmark menjadi ramalan produktivitas. Skor pengodean tidak mengukur antrean review Anda, risiko deployment, atau waktu yang dihabiskan untuk memperbaiki migrasi yang salah. Juga keluarkan hasil keamanan siber dan biologi khusus Mythos dari papan skor Fable: pengumuman tersebut mengidentifikasi model dasar yang sama tetapi dengan safeguard dan akses yang berbeda.
Pengaturan effort mengubah perbandingan
Atur effort secara eksplisit saat membandingkan model. Default API adalah High untuk Fable 5.2 dan Medium untuk Opus 5.5. Pengumuman Anthropic secara terpisah menyebutkan Medium sebagai default di aplikasi Claude dan Claude Code. Catat produk dan pengaturannya daripada mengasumsikan satu default berlaku di mana-mana.
Dokumentasi effort mendefinisikan low, medium, high, xhigh, dan max untuk kedua model. Effort memengaruhi teks respons, argumen tool, dan thinking. Ini adalah sinyal perilaku, bukan batas pengeluaran yang keras.
Mulailah dari konfigurasi Opus yang sudah berjalan. Jika hasilnya kurang memuaskan, bandingkan effort Opus yang lebih tinggi dengan Fable pada Medium atau High. Simpan uji coba Xhigh dan Max untuk tugas di mana penalaran tambahan memiliki manfaat yang masuk akal dan Anda dapat menoleransi pengeluarannya.
Perbandingan effort yang setara menjawab satu pertanyaan: bagaimana kedua model berperilaku pada pengaturan bernama yang sama? Perbandingan biaya yang setara menjawab pertanyaan lain: konfigurasi mana yang menghasilkan hasil terkuat yang dapat diterima untuk anggaran Anda? Keduanya tidak saling menggantikan.
Latensi: ukur keseluruhan tugas
Kedua model membawa label latensi komparatif Moderate dalam ikhtisar Anthropic. Tidak ada pemenang universal dari label tersebut. Ukur waktu hingga menghasilkan hasil yang sudah direview, termasuk tools dan retry, daripada menganggap kecepatan output sebagai kecepatan alur kerja pengembangan Anda secara keseluruhan.
Anthropic menyatakan Fable 5.2 menghasilkan output hingga 30% lebih cepat daripada Fable 5.1. Perbandingan tersebut adalah dengan pendahulunya, bukan dengan Opus 5.5. Fast mode opsionalnya menawarkan kecepatan generasi token hingga 2,5 kali lipat, sekali lagi itu klaim vendor, bukan pengurangan durasi tugas Anda yang terukur.
Tugas yang didominasi kompilasi atau database yang lambat tidak akan berakselerasi sebanding dengan generasi token yang lebih cepat. Sebaliknya, agen yang menghindari dua pendekatan yang gagal bisa selesai lebih cepat meskipun menghasilkan token lebih lambat. Lacak keduanya secara terpisah sebelum membayar premi kecepatan.
Bandingkan biaya per hasil yang diterima
Gunakan total pengeluaran alur kerja dibagi jumlah hasil yang diterima sebagai metrik keputusan Anda. Harga token menentukan tarifnya, tetapi volume token, caching, upaya yang gagal, tools, dan review menentukan apa yang Anda beli. Perhitungan berikut bersifat ilustratif, bukan pengukuran perilaku salah satu model.
Asumsikan satu permintaan mengonsumsi 100.000 token input tanpa cache dan 10.000 token output, dengan routing global standar dan tanpa biaya tool tambahan:
| Konfigurasi | Biaya input | Biaya output | Total |
|---|---|---|---|
| Opus 5.5 standar | $0,40 | $0,20 | $0,60 |
| Fable 5.2 standar | $0,80 | $0,40 | $1,20 |
| Opus 5.5 fast | $0,80 | $0,40 | $1,20 |
| Fable 5.2 fast | $1,60 | $0,80 | $2,40 |
Tarif diverifikasi terhadap dokumentasi harga Anthropic pada 10 November 2026. Kuota langganan terpisah dari tarif API ini. Penyedia cloud, caching, opsi residency, dan fitur lainnya dapat mengubah tagihan.
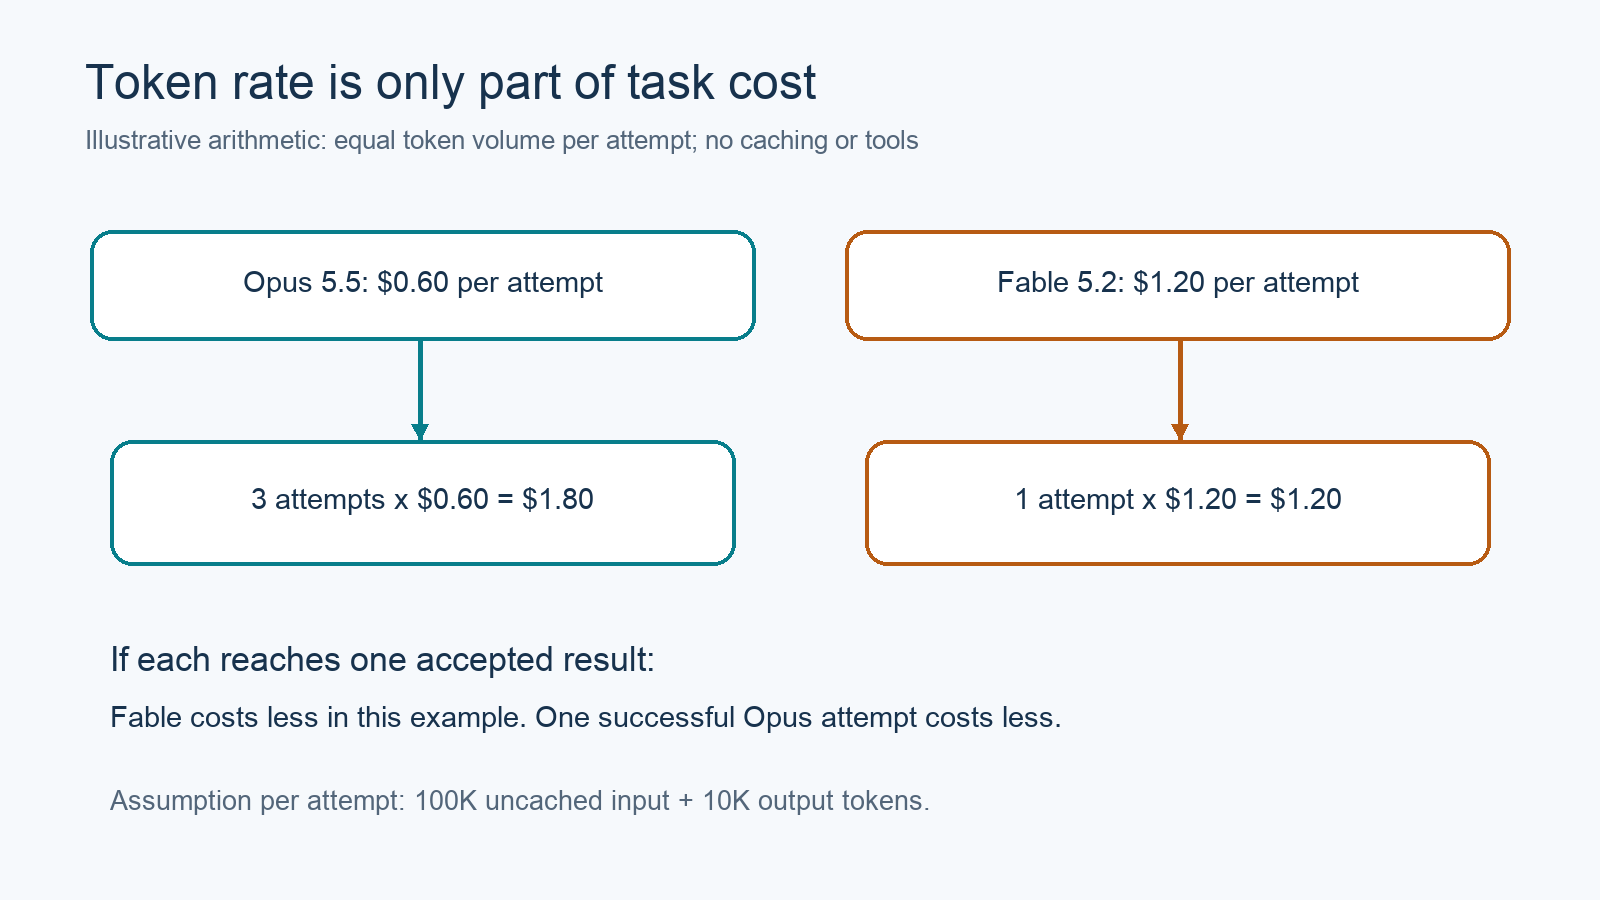
Bandingkan semua upaya yang dibutuhkan untuk mencapai hasil sukses, termasuk retry dan review.
Dalam contoh sederhana ini, tiga upaya Opus dengan volume identik berbiaya $1,80; satu upaya Fable berbiaya $1,20. Fable lebih murah hanya jika mencapai hasil yang diterima dalam satu upaya tersebut. Satu upaya Opus yang sukses tetap lebih murah. Retry di dunia nyata sering mengonsumsi volume yang berbeda, jadi gunakan data penggunaan tercatat daripada mengalikan rata-rata hasil tebakan.
Taruh waktu review rekayasa di samping pengeluaran API. Patch yang lolos test tetapi membutuhkan koreksi substansial belum melewati standar yang sama dengan patch yang siap direview.
Biarkan agen pengodean Anda memeriksa API dengan Apidog CLI
Gunakan Apidog CLI agar agen pengodean Anda dapat membuat dan menjalankan pemeriksaan API yang dapat diulang. Pemeriksaan ini dapat mengungkap regresi request atau response saat Anda berganti model. Pemeriksaan ini tidak menetapkan apakah perubahan repositori yang dilakukan agen sudah benar; tetap sertakan test repositori dan review manusia di sampingnya.
Pasang CLI-nya, lalu biarkan agen Anda membaca panduan instalasi resmi:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
Berikan prompt ini kepada Claude Code atau agen pilihan Anda:
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
Agen akan memeriksa skema, memilih kategori test case yang valid, membangun case.json, lalu menjalankan perintah seperti berikut. Flag-flag ini diverifikasi terhadap bantuan CLI 2.2.12 yang terinstal:
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
Ganti placeholder dengan resource proyek Anda. Ini adalah templat alur kerja, bukan perbandingan model yang dijalankan. Ikuti panduan Apidog CLI di Claude Code atau panduan integrasi Codex untuk pengaturan agennya.
FAQ
Apakah Fable 5.2 lebih baik daripada Opus 5.5 untuk semua pengodean?
Tidak. Anthropic merekomendasikan Opus 5.5 untuk sebagian besar tugas pengodean dan pengetahuan. Fable layak diuji ketika pekerjaan yang sulit melampaui baseline tersebut. Skor benchmark vendor-nya yang lebih tinggi tidak menjamin hasil yang lebih baik pada setiap tugas.
Apakah Fable 5.2 berbiaya dua kali lipat?
Tarif token input dan output standarnya dua kali lipat milik Opus 5.5. Total biaya tugas bisa berbeda karena konfigurasi yang berbeda mengonsumsi jumlah token dan upaya yang berbeda.
Apakah Anda harus selalu menggunakan effort maksimum?
Tidak. Bandingkan pengaturan terhadap pemeriksaan penerimaan dan anggaran Anda. Effort lebih tinggi mengizinkan pengeluaran token yang lebih besar; itu tidak menjamin peningkatan yang berguna untuk tugas terbatas.
Apakah Fable 5.2 lebih cepat daripada Opus 5.5?
Sumber-sumber yang ditinjau di sini tidak menetapkan pemenang latensi head-to-head universal. Keduanya memiliki label latensi Moderate. Ukur alur kerja aktual Anda dan perlakukan fast mode sebagai konfigurasi terpisah.
Bisakah Apidog menentukan model mana yang menulis kode lebih baik?
Apidog CLI dapat membantu agen Anda menjalankan pemeriksaan API dan mengumpulkan bukti response. Kualitas kode tetap membutuhkan test repositori dan review. Gunakan hasil yang diterima tersebut untuk memutuskan model dan pengaturan effort mana yang layak dengan biayanya.