
Cerebras menjual satu angka: kecepatan. Klaimnya adalah bahwa chip wafer-scale-nya mengeluarkan token lebih cepat daripada yang bisa dilakukan klaster GPU, dan tier gratis adalah cara perusahaan membuat Anda memperhatikannya. Tetapi "cepat" bukanlah sesuatu yang sebaiknya Anda terima begitu saja dari kata vendor. Itu adalah sesuatu yang Anda ukur, pada koneksi Anda sendiri, dengan prompt Anda sendiri, lalu simpan sebagai catatan yang dapat Anda jalankan ulang setiap kali Cerebras merilis model baru atau mengubah batas.
Panduan ini melakukan pengukuran itu bersama Anda. Anda akan mendapatkan kunci API Cerebras, melakukan panggilan chat completion sungguhan terhadap endpoint yang kompatibel dengan OpenAI, mengukur waktu token pertama dan respons penuh, serta membuat coding agent Anda mengubah seluruh permintaan menjadi uji Apidog CLI agar tetap bertahan saat pergantian model berikutnya.
TL;DR
Cerebras memberikan akun baru tier Free Trial: kredit $5 yang kedaluwarsa 30 hari setelah diberikan, dibatasi untuk dua model (gpt-oss-120b dan qwen-3.8-27b) pada 5 permintaan per menit dan 30K token tidak tercache per menit untuk masing-masing, sesuai batas laju yang dipublikasikan Cerebras. API-nya kompatibel dengan OpenAI di https://api.cerebras.ai/v1, jadi Anda dapat mengarahkan klien OpenAI yang sudah ada ke sana dan mengubah tiga baris. Di bawah ini, Anda akan membangun permintaan yang mengukur waktu-ke-token-pertama dan token per detik sendiri, alih-alih memercayai halaman pemasaran.
Apa yang didokumentasikan tier gratis, dan apa yang tidak
Halaman harga Cerebras merender angkanya di sisi klien, yang berarti tarif pasti dolar-per-juta-token untuk penggunaan berbayar bukanlah sesuatu yang dapat Anda ambil dari pengambilan statis halaman tersebut. Jangan menebak angka itu. Saat Anda membutuhkannya, buka sendiri tab penagihan konsol Cerebras Cloud, karena itulah satu-satunya tempat tarif saat ini dijamin akurat.
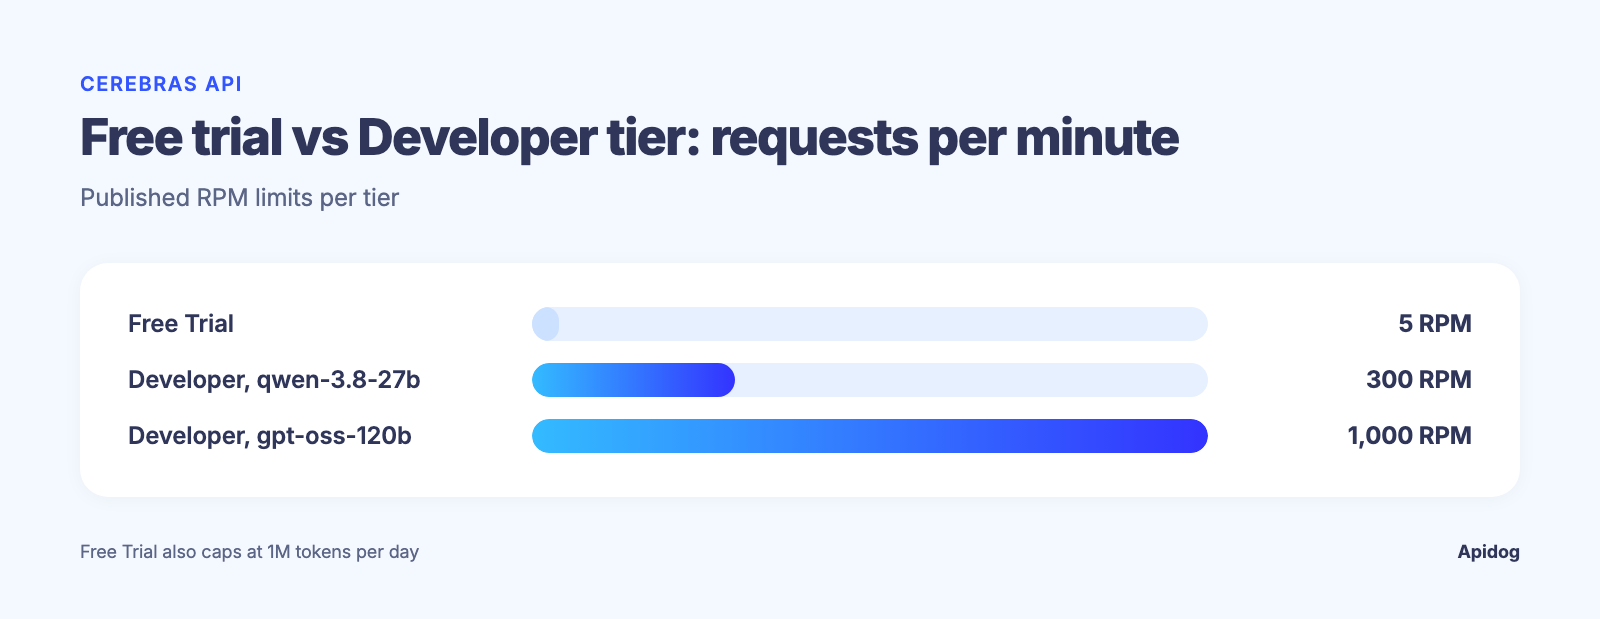
Yang dinyatakan secara jelas dalam dokumentasi, di halaman batas laju dukungan, adalah bentuk tier Free Trial:
| Tier | Models | RPM | Uncached TPM | Total TPM | TPH | TPD |
|---|---|---|---|---|---|---|
| Free Trial | gpt-oss-120b, qwen-3.8-27b |
5 | 30K | 90K | 1M | 1M |
Developer (gpt-oss-120b) |
pay-as-you-go | 1,000 | 1M | 3M | none | none |
Developer (qwen-3.8-27b) |
pay-as-you-go | 300 | 150K | 450K | none | none |
Dua hal penting di sini. Pertama, "uncached TPM" adalah plafon sebenarnya: itu adalah token yang membutuhkan komputasi penuh, dan tunjangan TPM total Anda kira-kira tiga kali lipatnya setelah cache hit dihitung. Kedua, akun Free Trial dibatasi oleh kredit dan waktu, bukan dibatasi permintaan selamanya: setelah $5 habis atau 30 hari berlalu, Anda turun ke apa pun yang diizinkan oleh tier akun hingga Anda menambahkan metode pembayaran. Segala hal di luar tabel ini (harga per token, harga seat, ketentuan enterprise) berada di balik halaman harga yang dirender JavaScript dan konsol, bukan dokumentasi statis, jadi periksa di sana sebelum Anda menganggarkannya.
Jika Anda pernah menemui hambatan seperti ini pada penyedia lain, polanya sama dengan yang dibahas dalam panduan kami tentang apa yang harus dilakukan saat Anda mendapatkan respons 429 rate-limit-exceeded: baca isi error, mundur, dan periksa dasbor sebelum Anda berasumsi API-nya rusak.
Dapatkan kunci dan lakukan satu panggilan sungguhan
Daftar di cloud.cerebras.ai, buka API Keys, dan buat satu. Quickstart Cerebras sendiri memberi tahu Anda untuk mengaturnya sebagai variabel lingkungan agar tidak pernah masuk ke isi permintaan secara manual:
export CEREBRAS_API_KEY="your-key-here"
URL dasarnya adalah https://api.cerebras.ai/v1, dan endpoint chat completions sangat cocok dengan bentuk OpenAI: POST /v1/chat/completions dengan model dan array messages. Kompatibilitas itu didokumentasikan dalam referensi API, dan itulah alasan Anda dapat memasukkan Cerebras ke dalam kode yang ditulis untuk pustaka klien OpenAI dengan mengubah URL dasar dan kuncinya. Panggilan curl mentah terlihat seperti ini:
curl https://api.cerebras.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${CEREBRAS_API_KEY}" \
  -d '{
    "model": "qwen-3.8-27b",
    "messages": [
      {"role": "user", "content": "Explain time-to-first-token in two sentences."}
    ]
  }'
Jalankan, dan responsnya membawa lebih dari sekadar teks completion. Ini mencakup blok usage (prompt_tokens, completion_tokens, total_tokens) dan blok time_info (queue_time, total_time) yang dikembalikan Cerebras pada setiap panggilan.
Jika tim Anda menguji lebih dari satu model atau penyedia, ini saat yang tepat untuk berhenti mengandalkan perintah curl sekali pakai. Bagian Apidog CLI di bawah ini membuat coding agent Anda mengubah panggilan ini menjadi uji yang dijalankan ulang setiap kali Cerebras menambahkan model atau mengubah batas.
Ukur klaim kecepatan: waktu-ke-token-pertama dan token per detik
Dua angka memberi tahu Anda apakah "cepat" itu nyata untuk beban kerja Anda: waktu-ke-token-pertama (TTFT) dan token yang dihasilkan per detik. Keduanya tidak muncul sebagai metrik utama dalam respons API, jadi Anda menghitungnya dari apa yang diberikan panggilan tersebut.
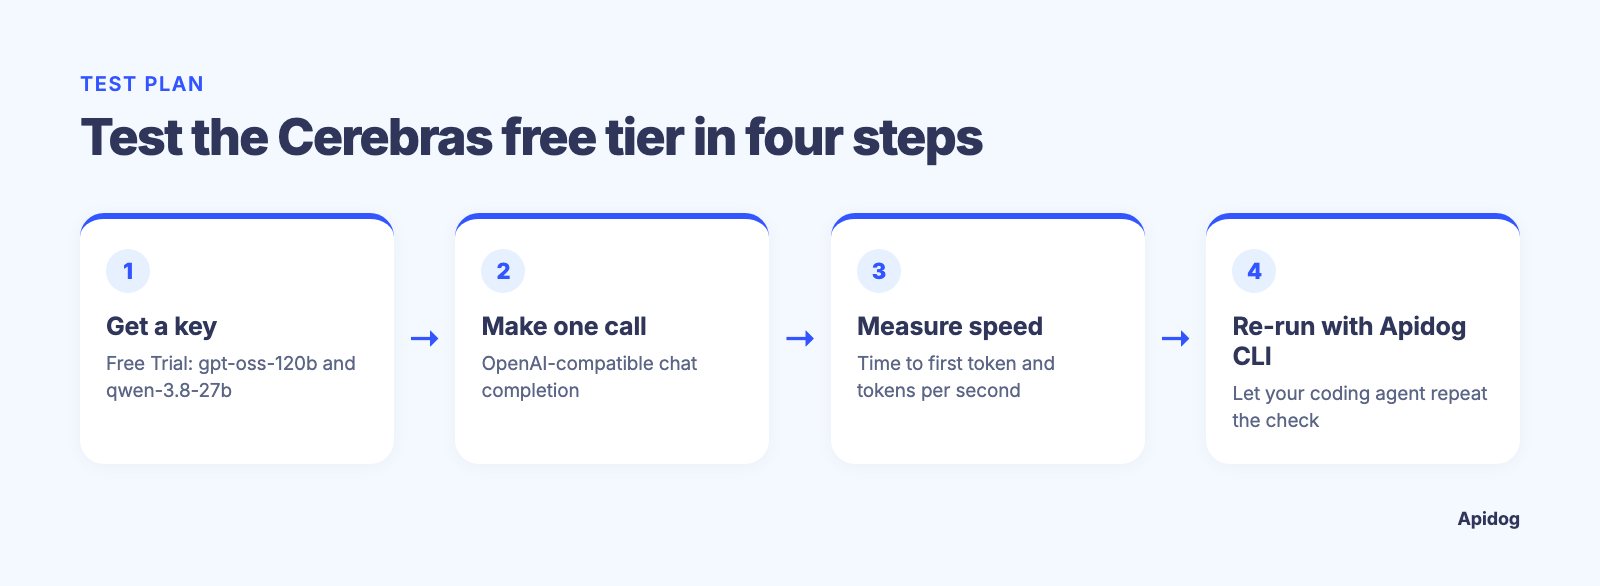
Untuk TTFT, streaming responsnya dan catat selisih waktu dinding antara mengirim permintaan dan menerima potongan pertama:
import time
from cerebras.cloud.sdk import Cerebras

client = Cerebras()
start = time.perf_counter()
first_token_at = None

stream = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Write a haiku about wafer-scale chips."}],
    stream=True,
)

for chunk in stream:
    if first_token_at is None and chunk.choices[0].delta.content:
        first_token_at = time.perf_counter() - start
        print(f"Time to first token: {first_token_at:.3f}s")
Untuk token per detik, gunakan panggilan non-streaming dan bagi token completion dengan total_time yang dilaporkan Cerebras di time_info:
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Explain the CS-3 wafer-scale engine in 100 words."}],
)

tokens = response.usage.completion_tokens
seconds = response.time_info.total_time
print(f"{tokens / seconds:.1f} tokens/sec")
Jalankan ini beberapa kali, pada jam yang berbeda, dengan prompt yang mendekati apa yang dikirim produk Anda. Simpan kedua skrip dan jalankan ulang setiap kali Cerebras menambahkan model ke tier gratis, karena angka token-per-detik berubah per model, bukan hanya per penyedia.
Baca batasnya sebelum batas itu membaca Anda
Desain batas laju Cerebras memiliki satu kehalusan yang layak diketahui sebelum Anda membuat skrip apa pun: ia melacak dua bucket token terpisah per organisasi, uncached TPM dan total TPM, dan menegakkan keduanya sekaligus. Ledakan prompt pendek dan berulang dapat mencapai plafon permintaan-per-menit sebelum mendekati plafon token, persis jebakan yang dijelaskan dalam artikel kami yang lebih luas tentang cara kerja pembatasan laju API.
Satu celah jujur dalam dokumentasi: Cerebras tidak mempublikasikan serangkaian header respons x-ratelimit-* seperti yang dilakukan beberapa penyedia. Referensi API tidak mencantumkan satu pun, dan halaman batas laju juga tidak. Itu berbeda dari chat completions API milik OpenAI sendiri, yang memang mengembalikan header sisa kuota pada setiap panggilan, pola yang dibahas lebih detail dalam panduan batas laju OpenAI kami. Dengan Cerebras, dua tempat untuk memeriksa posisi sebenarnya Anda adalah bagian Limits di konsol Cloud dan isi respons 429, yang menyatakan apakah Anda melampaui plafon token tidak tercache atau total. Bangun logika retry Anda berdasarkan isi error itu alih-alih berasumsi header akan memberi tahu Anda lebih dulu.
Biarkan coding agent Anda menjalankannya ulang dengan Apidog CLI
Pengukuran di file sementara tidak membuktikan apa pun bulan depan. Buat coding agent Anda mengubah panggilan menjadi uji yang dapat dijalankan ulang melalui Apidog CLI. Siapkan sekali:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Token berasal dari Apidog di bawah Account Settings, API Access Token. Lalu beri agent satu prompt:
Use Apidog CLI on project <id>. Create a Cerebras environment with base URL
https://api.cerebras.ai/v1 and add POST /chat/completions with Bearer auth from
{{CEREBRAS_API_KEY}} and model set to {{MODEL}}. Create a test case asserting
status 200 and time_info.total_time under {{MAX_TOTAL_TIME}}, run it for
gpt-oss-120b and qwen-3.8-27b, and report completion tokens per second for each.
Perintah yang dijalankannya, diperiksa terhadap Apidog CLI 2.2.7:
apidog environment create Cerebras --project <id> --base-url https://api.cerebras.ai/v1
apidog endpoint create --project <id> --file cerebras-chat.json
apidog cli-schema validate test-case-create --file speed-case.json
apidog test-case create --project <id> --file speed-case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d models.csv \
  --delay-request 12000 --env-var "CEREBRAS_API_KEY=$CEREBRAS_API_KEY" -r cli,json
models.csv berisi satu kolom MODEL, sehingga satu kali jalankan mencakup kedua model, dan apa pun yang dirilis Cerebras berikutnya tinggal satu baris lagi. --delay-request 12000 memberi jarak panggilan 12 detik agar tetap di bawah 5 permintaan per menit Free Trial. Untuk jalur 429, minta case kedua yang sengaja meledak melewati batas itu dan melakukan assertion pada isi error, sehingga tertangkap dan terversi alih-alih ditemukan kembali di produksi. Itu adalah alur kerja, bukan benchmark sekali pakai; lihat kumpulan kami tentang alat pengujian API yang dibuat untuk beban kerja agent dan LLM jika Anda membandingkan opsi, dan Apidog CLI di Claude Code untuk sisi agent.
Tier gratis atau tier Developer: kapan harus pindah
Tier Free Trial dibangun tepat untuk apa yang dipandu panduan ini: mengonfirmasi klaim kecepatan dan bentuk permintaan sebelum Anda memberikan kartu. Begitu Anda benar-benar membangun dengan Cerebras, lompatan tier Developer, dari 5 RPM ke 1.000 RPM pada gpt-oss-120b, adalah angka yang biasanya memaksa keputusan, bukan harga per token. Jika volume prompt Anda meledak-ledak alih-alih stabil, bandingkan angka Cerebras dengan alternatif sebelum Anda berkomitmen; daftar kami tentang alternatif OpenRouter dan panduan kami tentang tier API gratis Groq keduanya layak dibaca berdampingan dengan tabel di atas, karena kecepatan inferensi dan plafon tier gratis lebih bervariasi antar penyedia daripada yang diakui sebagian besar artikel perbandingan. Satu perbedaan yang layak diketahui sebelum Anda memilih: Groq mendokumentasikan batas Free Plan per model secara langsung, misalnya openai/gpt-oss-120b pada 30 RPM, 1.000 RPD, 8K TPM, dan 200K TPD, dan mengembalikan header respons x-ratelimit-* pada setiap panggilan, sehingga Anda selalu tahu sisa anggaran Anda dari respons itu sendiri. Cerebras tidak memberi Anda keduanya; Anda membaca posisi Anda dari konsol Cloud atau menyimpulkannya dari isi 429, seperti yang dibahas di atas.
FAQ
Apakah tier gratis Cerebras memerlukan kartu kredit? Tier Free Trial berbasis kredit ($5, kedaluwarsa setelah 30 hari) alih-alih paket gratis berulang, dan dokumentasi Cerebras sendiri mengarahkan Anda ke konsol Cloud untuk persyaratan pendaftaran terkini, karena detail itu dapat berubah secara independen dari dokumentasi statis.
Model mana yang tersedia di tier gratis? Per dokumentasi batas laju saat ini, dua: gpt-oss-120b dan qwen-3.8-27b. Keduanya berbagi batas Free Trial yang sama (5 RPM, 30K uncached TPM).
Bisakah saya menggunakan kode OpenAI SDK yang sudah ada dengan Cerebras? Ya. Arahkan URL dasar klien ke https://api.cerebras.ai/v1 dan ganti dengan kunci Cerebras Anda; bentuk /v1/chat/completions cocok, sesuai referensi API.
Mengapa saya mendapat 429 padahal saya masih di bawah anggaran token saya? Cerebras menegakkan uncached TPM, total TPM, dan RPM sebagai plafon terpisah. Rentetan permintaan kecil dapat memicu batas RPM jauh sebelum bucket token mana pun terisi, yang merupakan mode kegagalan sama yang dibahas dalam panduan pemecahan masalah rate-limit-exceeded kami.
Bagaimana cara memeriksa penggunaan saya saat ini tanpa menabrak dinding terlebih dahulu? Cerebras tidak mengembalikan header respons sisa kuota, jadi periksa bagian Limits di konsol Cloud secara langsung alih-alih menyimpulkannya dari respons API. Paket gratis Groq mengambil pendekatan sebaliknya dan mengembalikan header x-ratelimit-* pada setiap panggilan, jadi timbang perbedaan itu jika pemantauan berbasis header penting bagi pengaturan Anda.
Keunggulan sebenarnya Cerebras muncul di blok time_info pada panggilan Anda sendiri, bukan di judul pemasaran.