
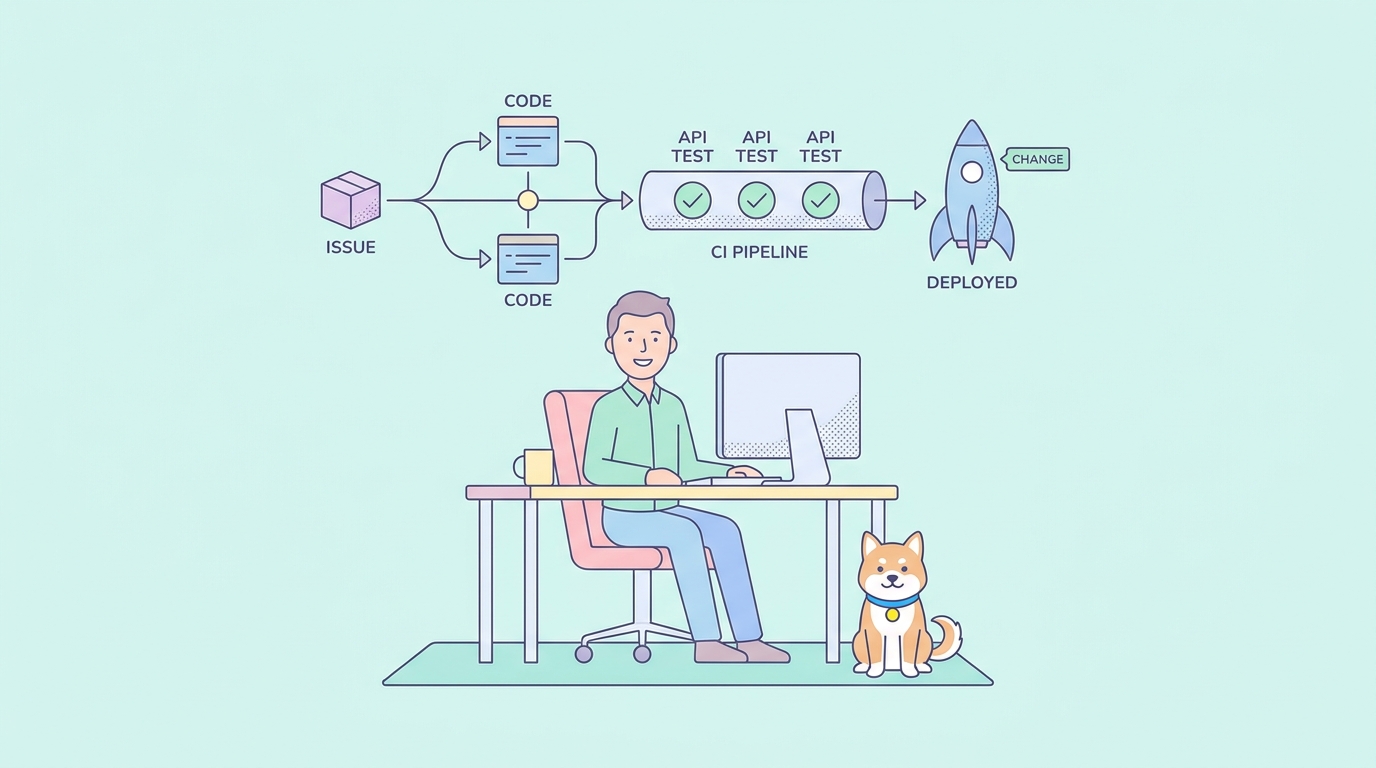
Diagram Gergely Orosz tentang pabrik perangkat lunak internal OpenAI telah beredar minggu ini: seorang pembangun mengajukan hasil, Codex menulis kode, sekelompok agen peninjau spesialis berdebat tentang risiko, dan seorang agen mengawasi penerapan sambil memantau dasbor yang dibuatnya sendiri. Ini juga, untuk bagian-bagian yang paling penting bagi insinyur OpenAI sendiri, deskripsi alat internal yang tidak dapat Anda instal.
Perf Factory, Sevbot, dan penerapan agen dengan dasbor yang dibuat sendiri berjalan di tumpukan observabilitas OpenAI sendiri dan bukan bagian dari produk Codex yang dapat Anda beli. Yang dapat Anda bangun minggu ini adalah loop yang lebih kecil yang masih melakukan pekerjaan nyata: seorang pembangun mendefinisikan hasil sebagai masalah, Codex mengerjakan cabang, CI memeriksa apakah perubahan benar-benar berfungsi, satu atau dua agen peninjau melihatnya, dan manusia menyetujui apa pun yang berisiko sebelum dikirim di balik flag. Semuanya bergantung pada satu detail yang diabaikan oleh diagram asli: "CI lolos" hanya berarti sesuatu jika CI memeriksa hal-hal yang benar. Untuk API, itu berarti menguji API, bukan hanya kode yang memanggilnya.
Apa yang Benar dalam Diagram (dan yang Tidak Bisa Anda Salin)
Bagian publik dari artikel Pragmatic Engineer menjelaskan loop inti di mana Codex "membuat serangkaian perubahan kode hingga mencapai tujuannya, dan kemudian memverifikasi bahwa perangkat lunak berfungsi sebagaimana mestinya." Area berisiko rendah dapat disetujui secara otomatis; perubahan berisiko tinggi mendapatkan lebih banyak tinjauan AI atau persetujuan manual yang wajib. Struktur itu, mengusulkan, memverifikasi, meninjau berdasarkan tingkat risiko, bersifat portabel. Tim telah mendekatinya dengan bot pull request dan gerbang CI selama bertahun-tahun; agen hanya membuat loop lebih cepat dan kurang diawasi.
Yang tidak portabel adalah mekanisme internal di sekitarnya. Perf Factory menyaring peringatan dan dasbor untuk menemukan regresi latensi dan mengusulkan perbaikan. Sevbot menyelidiki insiden dan menjawab pertanyaan di Slack, meskipun tidak menjalankan mitigasi sendiri. Penerapan agen memantau perubahan ke produksi dan membangun pemantauannya sendiri menggunakan tumpukan telemetri internal OpenAI. Tak satu pun dari ketiganya dikirim dalam produk Codex eksternal. Yang dikirim adalah aplikasi desktop, perintah /goal untuk tugas-tugas yang berjalan lama, serta plugin peran dan skill yang Anda konfigurasi sendiri. Halaman produk Codex OpenAI mencakup apa yang sebenarnya tersedia.
Lima Langkah Loop yang Dapat Anda Jalankan Minggu Ini
Versi yang diperkecil terlihat seperti ini:
- Seorang pembangun mengajukan hasil sebagai sebuah isu. Bukan daftar tugas, melainkan deskripsi keadaan akhir: "pesanan dapat membawa kode diskon opsional yang mengurangi total." Menyerahkan isu GitHub yang sama kepada Agen di Sharkly adalah integrasi yang sudah dikirim: isu tersebut menjadi Tugas, dan hasilnya kembali sebagai PR alih-alih tiket terpisah untuk rekonsiliasi. Saat ini gratis untuk organisasi hingga 10 orang.
- Codex mengerjakan cabang dengan
/goal. Seperti yang dibahas dalam bagaimana perintah/goalmenggerakkan eksekusi otonom Codex dan Claude Code, Anda memberikan target kepada agen dan membiarkannya berulang sendiri hingga target tercapai. - CI menjalankan build, unit test, dan skenario tes API. Ini adalah langkah yang dilewati atau dibangun setengah-setengah oleh sebagian besar tim.
- Satu atau dua agen peninjau memeriksa diff, dan manusia meninjau apa pun yang di atas risiko rendah. Alat peninjau kode AI dapat menangkap banyak hal sebelum manusia membuka PR. Di Sharkly, di sinilah "Ready for Release" melakukan pekerjaan: manusia harus memindahkan tugas dari status itu sebelum apa pun mencapai "Done", dan Agen peninjau terpisah dapat berada dalam Crew yang sama dengan yang menulis kode.
- Deploy di balik feature flag sehingga penggabungan yang buruk adalah sakelar, bukan insiden.
Langkah 3 adalah di mana loop tersebut berfungsi atau membohongi Anda.
Mengapa CI Harus Menguji API, Bukan Hanya Kodenya
Fitur tinjauan Codex sendiri, yang dibahas dalam cara kerja tinjauan kode Codex, membaca diff dan menandai masalah yang jelas. Ini tidak menjalankan layanan Anda dan memeriksa apa yang dikembalikannya. Unit test, jika agen menulis atau menyimpannya, sebagian besar memverifikasi bahwa kode melakukan apa yang dimaksudkan oleh kode, yang tidak sama dengan memverifikasi bahwa API melakukan apa yang dijanjikan oleh kontrak. Seorang agen yang mengedit handler dapat melewati setiap unit test sambil diam-diam merusak respons yang diandalkan oleh setiap klien.
Katakanlah Anda menjalankan API pesanan. POST /api/orders membuat pesanan dan mengembalikan rekamannya; GET /api/orders/{id} mengambil satu berdasarkan ID. Anda memelihara spesifikasi OpenAPI untuk keduanya, dan Anda membangun skenario tes Apidog terhadapnya: membuat pesanan, mengambilnya kembali, dan memeriksa empat hal yang biasanya tidak akan dilakukan oleh unit test:
- Kode status.
POST /api/ordersmengembalikan201, bukan200atau500tanpa pemberitahuan pada kasus batas validasi. - Skema respons terhadap spesifikasi OpenAPI. Bidang
total_amounttetap berupa angka,statustetap salah satu nilai enum yang Anda definisikan, dan tidak ada bidang yang diandalkan klien yang diam-diam menghilang atau diganti namanya. - Kegagalan otentikasi. Permintaan tanpa token yang valid mengembalikan
401, bukan 200 dengan body kosong, yang merupakan regresi yang mengejutkan dan umum. - Ambang batas latensi. Skenario menegaskan bahwa respons kembali di bawah batas yang ditentukan, sehingga perubahan yang menambahkan panggilan database tanpa batching di dalam handler terdeteksi sebelum pelanggan menyadarinya.
Itulah persisnya pemeriksaan yang dapat dirusak secara diam-diam oleh refaktor tingkat handler sementara setiap unit test masih lulus, karena unit test biasanya mem-mock batasan yang sebenarnya dijalankan oleh skenario API.
Menghubungkannya ke dalam pipeline
Anda sudah menjalankan versi CLI dari skenario-skenario ini secara lokal jika Anda mengikuti cara menggunakan Apidog CLI di Codex. Perintah yang sama berjalan di CI. Sebuah tugas GitHub Actions yang membangun, menjalankan unit test, dan kemudian menjalankan skenario Apidog terlihat seperti ini:
name: CI

on:
  pull_request:
  push:
    branches: [main]

jobs:
  build-test-verify:
    runs-on: ubuntu-latest
    steps:
      - name: Check out repository
        uses: actions/checkout@v4

      - name: Set up Node.js
        uses: actions/setup-node@v4
        with:
          node-version: '20'

      - name: Install dependencies
        run: npm ci

      - name: Build and run unit tests
        run: npm run build && npm test

      - name: Install Apidog CLI
        run: npm install -g apidog-cli

      - name: Run orders API test scenario
        env:
          APIDOG_ACCESS_TOKEN: ${{ secrets.APIDOG_ACCESS_TOKEN }}
        run: |
          apidog run \
            --access-token $APIDOG_ACCESS_TOKEN \
            -t 88214 \
            -e 3301 \
            -r cli,junit

      - name: Upload Apidog reports
        if: always()
        uses: actions/upload-artifact@v4
        with:
          name: apidog-reports
          path: apidog-reports/
Nilai -t dan -e adalah ID skenario dan lingkungan Anda yang sebenarnya dari Apidog, bukan placeholder yang Anda buat-buat. Referensi perintah apidog run mencakup setiap flag, dan laporan pengujian Apidog CLI menjelaskan output JUnit yang diunggah oleh tugas tersebut. apidog run keluar dengan nilai non-nol pada setiap pernyataan yang gagal, jadi GitHub Actions menandai tugas tersebut gagal sama seperti untuk unit test yang gagal.
Seperti Apa Prompt Agen
Tujuan dari /goal adalah Anda menjelaskan hasil dan kondisi keluar, dan Codex berulang tanpa Anda menyetujui setiap langkah. Untuk contoh kode diskon, prompt yang masuk akal adalah:
/goal Add an optional `discount_code` field to POST /api/orders. Validate it
against the promotions service and apply the discount to `total_amount` in
the response. Do not rename or remove any existing response field. Run
`npm test` and `apidog run --access-token $APIDOG_ACCESS_TOKEN -t 88214 -e 3301
-r cli` before you finish. Both must exit 0. If the Apidog run fails, read the
failing assertion and fix the handler, not the test.
Baris terakhir itu penting. Agen yang di bawah tekanan untuk membuat pemeriksaan berhasil terkadang akan mengedit pernyataan alih-alih bug. Memberitahunya secara eksplisit sisi mana dari loop yang harus diperbaiki menjaga skenario pengujian sebagai sumber kebenaran, bukan sebagai penghalang yang harus dilewati.
Ketika Agen Melanggar Kontrak
Codex menambahkan bidang diskon, dan dalam prosesnya mengganti nama total_amount menjadi totalAmount karena itu adalah konvensi dalam file yang dibacanya di dekatnya. Unit test masih lulus; mereka memeriksa matematika diskon, bukan nama bidang. Build berhasil. Kemudian skenario Apidog berjalan di CI, memvalidasi respons terhadap spesifikasi OpenAPI, dan gagal: spesifikasi mengatakan total_amount, respons sekarang memiliki totalAmount, dan pernyataan skema segera menangkapnya.
CI melaporkan keluar non-nol dan menunjuk pada pernyataan skema yang gagal dalam output JUnit. Codex membaca kegagalan tersebut, melihat bahwa penggantian nama adalah penyebabnya, dan mengembalikannya sambil mempertahankan logika diskon. Skenario tersebut lolos, build menjadi hijau, dan pull request bergerak ke tinjauan dengan jaminan nyata di balik kata "lulus". Tanpa pemeriksaan tingkat API, penggantian nama itu akan dikirim, dan setiap klien yang mengurai total_amount akan rusak pada rilis berikutnya.
Pengelompokan Risiko yang Dapat Anda Dasarkan pada Spesifikasi
Alih-alih memiliki gagasan yang tidak jelas tentang apa yang dianggap berisiko rendah, kaitkan klasifikasi risiko Anda dengan diff OpenAPI. Perubahan yang menambahkan bidang opsional dengan nilai default adalah kandidat untuk penggabungan otomatis setelah pengujian lulus. Perubahan yang menghapus bidang, mengganti nama bidang, atau mengubah kode status tidak pernah berisiko rendah, terlepas dari seperti apa sisa diff. Aturan tunggal itu menangkap sebagian besar hal yang akan ditandai oleh agen peninjau spesialis. Arahkan apa pun yang ditandai oleh aturan tersebut ke peninjau manusia atau tinjauan kedua dari alat peninjau kode AI sebelum digabungkan.
Kirim di Balik Flag, Bukan ke Dalam Kehampaan
Setelah perubahan melewati CI dan tinjauan, terapkan di balik feature flag daripada langsung ke setiap pengguna. Ini adalah pengganti murah untuk langkah penerapan agen OpenAI: tidak ada agen yang mengawasi peluncuran atau membangun dasbornya sendiri. Sebuah flag yang dimulai pada 5% lalu lintas dan seseorang yang memeriksa tingkat kesalahan sebelum mengubahnya menjadi 100% memberi Anda sebagian besar keamanan tanpa alat internal apa pun. Jika ada yang salah, Anda mematikan flag daripada mengembalikan penggabungan di bawah tekanan.
Kerangka yang Sudah Ada
Anda tidak perlu menyusun semua lima langkah dari awal. orchflows adalah proyek sumber terbuka yang muncul dalam balasan utas Orosz: perintah /software-factory berlisensi MIT untuk Claude Code dan Codex, dibangun di sekitar sejumlah kecil skill yang dapat digunakan kembali. Ini adalah kerangka awal, bukan pengganti langkah-langkah CI dan tinjauan di atas; Anda masih mengarahkannya ke skenario pengujian dan aturan risiko Anda sendiri.
Apa yang Harus Dilewati untuk Dibangun
Jangan mencoba mereproduksi Perf Factory, Sevbot, atau penerapan agen dengan dasbor yang dibuat sendiri. Mereka adalah sistem internal OpenAI yang terhubung ke telemetri yang tidak dijalankan oleh sebagian besar tim. Manusia di OpenAI masih menentukan hasil, menyetujui perubahan berisiko tinggi, mengizinkan mitigasi insiden, dan melakukan tugas oncall; seperti yang dikatakan OpenAI, "tugas oncall bukanlah sesuatu dari masa lalu." Salin bagian-bagian dari loop yang hanya merupakan disiplin rekayasa yang baik: verifikasi sebelum menggabungkan, kelompokkan risiko berdasarkan apa yang sebenarnya berubah, dan libatkan manusia pada apa pun yang tidak jelas keamanannya.
Jalankan Loopnya
Mulailah dengan langkah CI; ini membuat setiap langkah lainnya dapat dipercaya. Bangun skenario pengujian API pesanan Anda di Apidog, yang mencakup kode status, skema, otentikasi, dan anggaran latensi. Hubungkan ke pipeline Anda dengan CLI, arahkan /goal ke masalah nyata, dan biarkan Codex berulang terhadap pemeriksaan yang benar-benar menegaskan perilaku API alih-alih mempercayai perkataan agen. Unduh Apidog untuk membangun skenario pertama, lalu tambahkan langkah peninjau dan flag setelah loop membuktikan dirinya.