
Jawaban singkat: Generator video AI tanpa pembatasan dalam arti sebenarnya hanya ada di perangkat keras milik Anda sendiri: model open-weight seperti Wan2.2, HunyuanVideo-1.5, dan LTX-2 berjalan tanpa filter sisi server. Setiap layanan hosted menerapkan kebijakan konten. Jika Anda ingin mengurangi penolakan false-positive tanpa GPU, platform multi-model seperti A2E memungkinkan Anda berganti model saat satu model menandai prompt yang sebenarnya tidak berbahaya.
“Tanpa pembatasan” dalam panduan ini berarti kebebasan kreatif: lebih sedikit penolakan untuk prompt yang sah seperti film pendek horor, adegan perang, aksi stunt, atau video penjelasan medis. Ini tidak berarti konten eksplisit, dan tidak pernah berarti menggunakan wajah atau suara orang nyata tanpa persetujuannya. Ini adalah panduan video pendamping dari artikel AI image generators with no restrictions kami.
Apa arti “tanpa pembatasan” bagi generator video AI
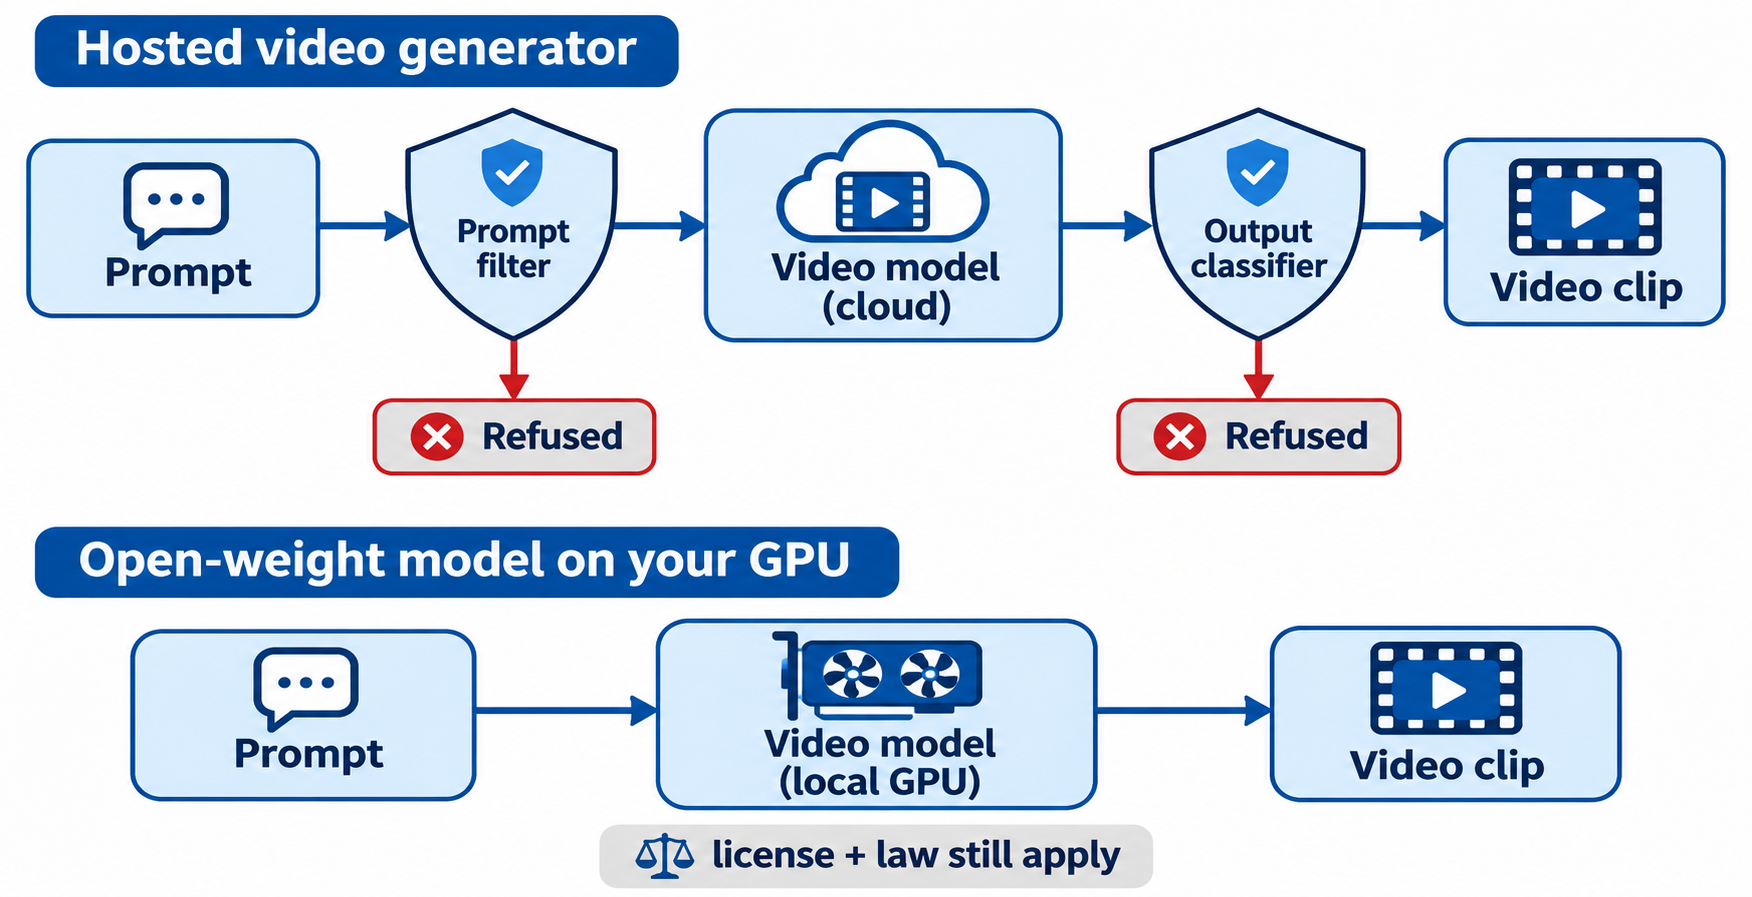
Generator video AI tanpa pembatasan adalah generator yang menjalankan prompt Anda tanpa filter konten dari penyedia. Dalam praktiknya, itu hanya berlaku untuk model open-weight yang Anda jalankan sendiri. Semua alat hosted melakukan filtering, tetapi mereka berbeda dalam seberapa sering menolak prompt yang tidak berbahaya dan berapa banyak model yang bisa Anda coba dengan satu akun.
Generator video hosted biasanya memeriksa dua kali: filter prompt membaca teks Anda terlebih dahulu, lalu classifier output memeriksa frame sebelum klip dikembalikan. Keduanya bisa menolak. Jalankan model secara lokal, dan kedua lapisan tersebut tidak ada.
Generator video AI terbaik tanpa pembatasan: daftar singkat
Berikut perbandingan opsi utama. Harga dan kredit diambil dari halaman resmi masing-masing, diperiksa pada 13 November 2026.
| Alat | Jenis | Filter | Jalur gratis | Terbaik untuk |
|---|---|---|---|---|
| A2E | Hosted, multi-model | Kebijakan penyedia | 30 kredit/hari, watermark, 720p | Banyak model dalam satu akun, plus API |
| Kling 4.0 | Hosted | Kebijakan penyedia | Cek halaman resmi | Adegan gerakan besar dengan audio |
| Gemini Omni Flash | Hosted (Google) | Kebijakan Google | Cek halaman resmi | Klip 3 hingga 15 detik dengan audio native |
| Grok Imagine | Hosted (xAI) | Kebijakan xAI | API berbayar, ditagih per detik | Klip pendek hingga 15 detik, 1080p di 1.5 |
| Seedance 2.5 | Hosted (ByteDance) | Kebijakan ByteDance | Cek halaman resmi | Shot tunggal hingga 30 detik |
| Wan2.2 | Open weights | Tidak ada di mesin Anda | Bebas, bobot gratis | 720p lokal 24fps pada satu GPU kelas atas |
| HunyuanVideo-1.5 | Open weights | Tidak ada di mesin Anda | Bebas, bobot gratis | Eksekusi lokal yang lebih ringan (14 GB dengan offloading) |
| LTX-2 | Open weights | Tidak ada di mesin Anda | Bebas, bobot gratis | Video dengan audio tersinkronisasi, secara lokal |
1. A2E: satu akun, banyak model video
A2E adalah platform AI gambar dan video all-in-one. Ia masuk daftar karena kelengkapan fiturnya, bukan karena mengabaikan kebijakan: saat satu model menolak prompt yang tidak berbahaya, Anda bisa menjalankannya ulang di model lain dengan akun dan kredit yang sama. Model videonya mencakup Seedance 2.5, Kling 4.0, Wan 3.0, Veo 3.1, Sora 2, dan Grok Imagine, ditambah face swap, talking photo, lip sync, dan voice clone.
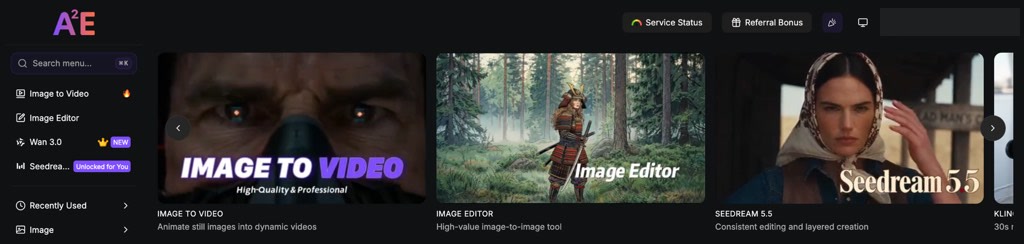
Akun baru mendapat 100 kredit gratis plus 30 per hari melalui check-in, dengan output 720p ber-watermark. Paket Pro berharga $14,9 untuk satu bulan dengan 1.500 kredit, tanpa watermark, dan akses API. Dalam pengujian kami pada 13 November 2026, klip image to video 5 detik di model V2 milik A2E memakan 40 kredit dan selesai render dalam sekitar 2 menit. Face swap pada klip yang sama berjalan gratis dari kuota, dan wajah baru itu konsisten di setiap frame.
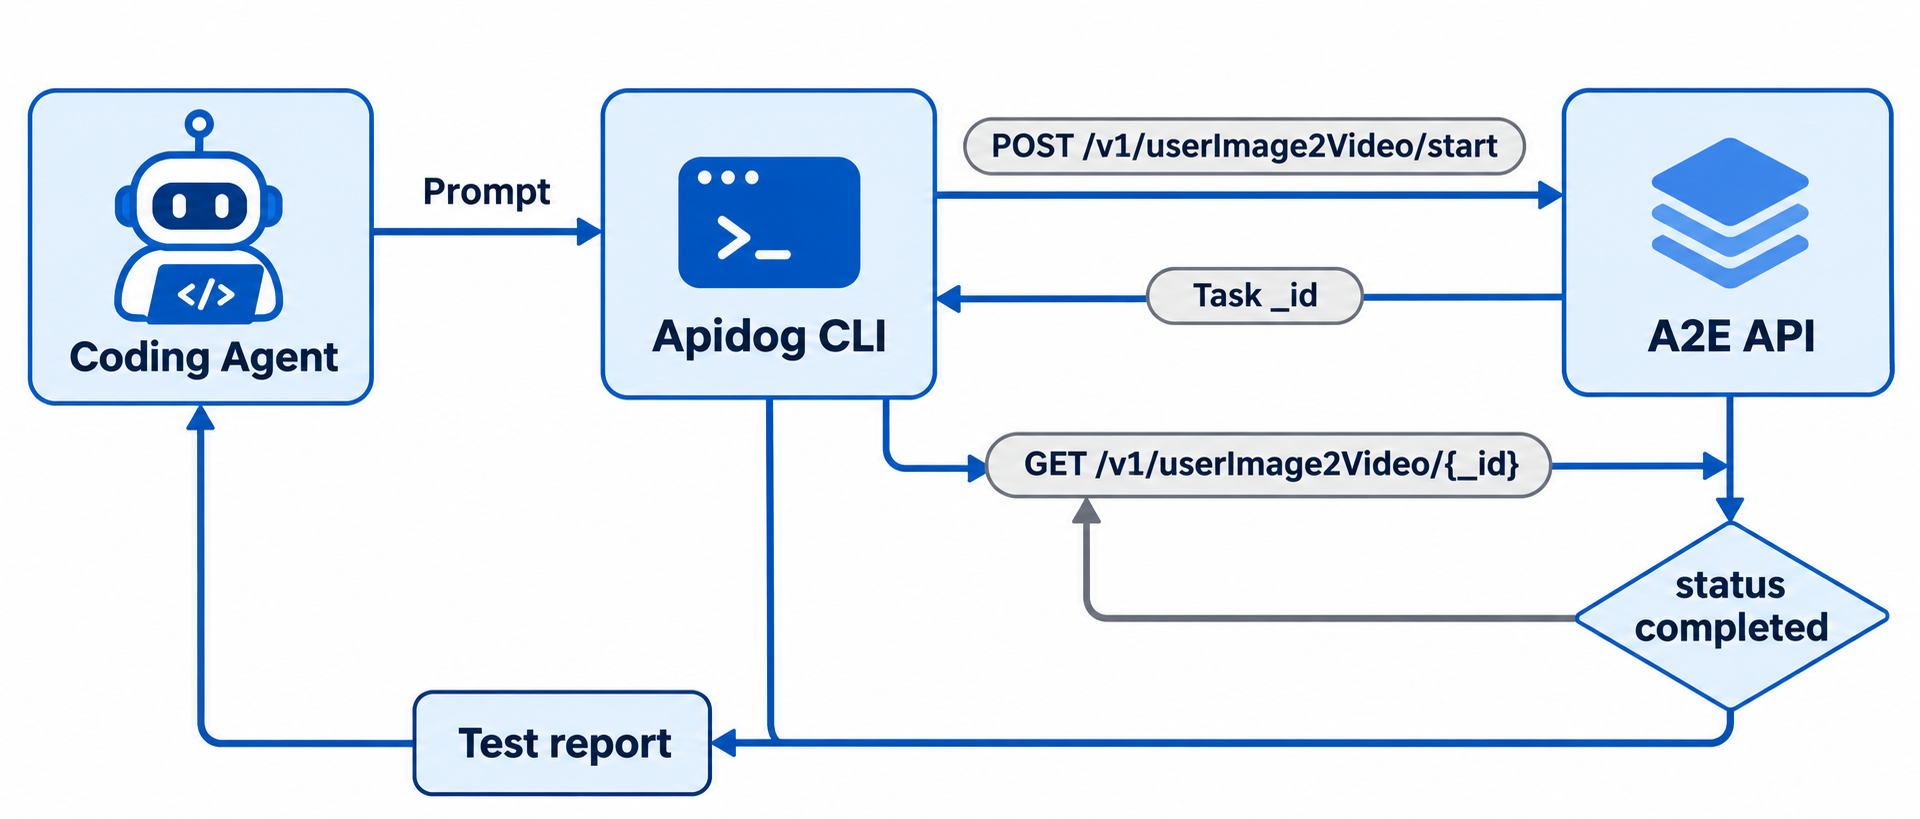
Untuk developer, tersedia REST API di https://api.a2e.ai dengan OpenAPI spec dan SKILL.md untuk coding agent. Pekerjaannya bersifat asinkron: Anda memulai sebuah task, lalu melakukan polling pada _id-nya hingga selesai.
Kesimpulan: Jalur hosted termudah untuk mengurangi penolakan, karena berganti model hanya butuh dropdown, bukan langganan baru. Ketentuan A2E tetap berlaku, dan situsnya menyediakan tautan formulir pelaporan CSAM.
2. Kling 4.0
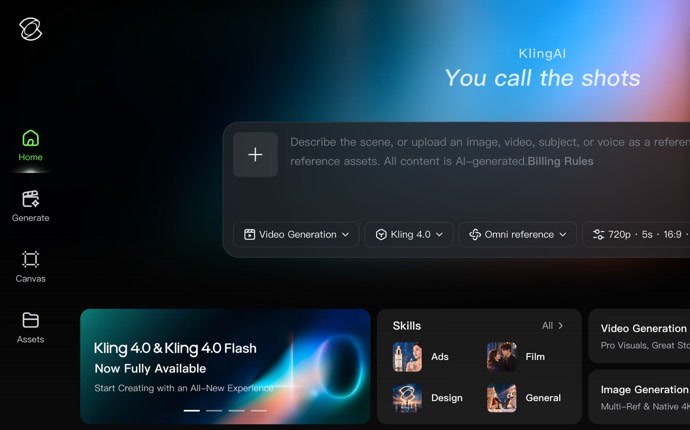
Hosted. Situs Kling menawarkan Kling 4.0 dengan realisme audio-visual dan adegan gerakan besar yang stabil. Kotak prompt menerima teks plus gambar, video, subjek, atau suara sebagai referensi, dan dimulai dari 720p, 5 detik, dan 16:9. Di sekitarnya ada motion control, lip sync, talking avatar, dan video to audio, plus Canvas berbasis node serta jalur MCP dan API untuk pekerjaan batch. Paket berbayar dimulai dari $6,99, dan Kling juga tersedia di menu A2E.
Kesimpulan: Pilihan kuat untuk klip penuh aksi. Cek jatah gratisnya lebih dulu di kling.ai.
3. Google Gemini Omni Flash (dahulu Veo)
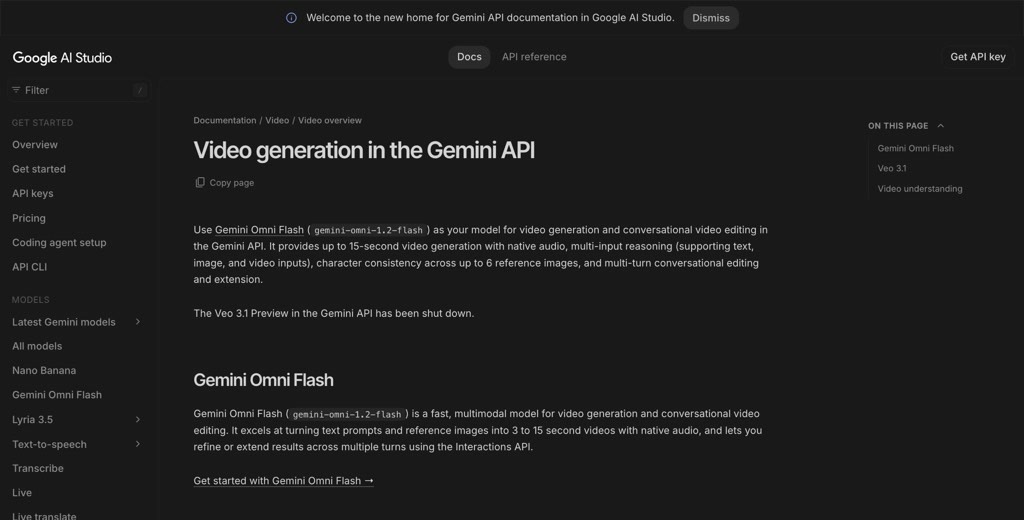
Hosted. Google menghentikan model pratinjau Veo 3.1 di Gemini API pada 22 Oktober 2026, dan dokumentasi videonya kini mengarahkan developer ke Gemini Omni Flash (gemini-omni-1.2-flash). Ia membuat klip hingga 15 detik dengan audio native dari input teks, gambar, atau video, menjaga konsistensi karakter hingga 6 gambar referensi, dan memungkinkan Anda memperhalus atau memperpanjang klip dalam beberapa putaran. Generative AI Prohibited Use Policy Google mengatur apa saja yang boleh dibuat.
Kesimpulan: Kualitas bagus di dalam ekosistem Google, tetapi bukan pilihan utama jika penolakan adalah masalah utama Anda.
4. Grok Imagine
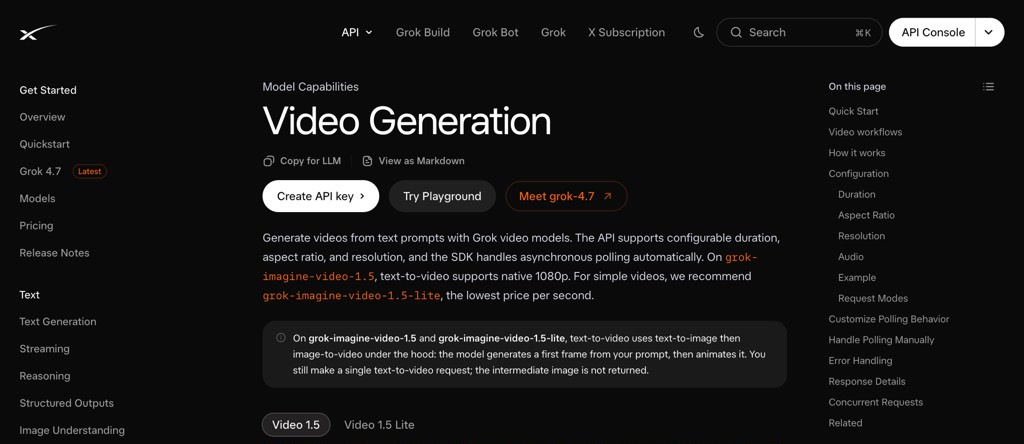
Hosted. Model video xAI berjalan di aplikasi Grok dan melalui xAI API. Di grok-imagine-video-1.5, text to video dirender pada 1080p native, dan model 1.5-lite adalah yang paling murah per detik. Klip berdurasi 1 hingga 15 detik dengan audio aktif secara default, dan SDK xAI menangani polling asinkron untuk Anda. Moderasinya sama di aplikasi dan API, jadi API tidak akan lebih longgar, tetapi setiap pekerjaan melaporkan statusnya sendiri. Ia juga ada di menu A2E. Uraian Grok Imagine no restrictions kami membahas apa yang berubah dan apa yang masih berfungsi.
Kesimpulan: Klip pendek yang cepat dan murah, dengan filter yang masih sering salah menandai prompt yang tidak berbahaya.
5. Seedance 2.5
Hosted. Seedance 2.5 dari ByteDance menghasilkan audio dan video secara bersamaan dan dirancang untuk bercerita 30 detik dalam satu shot, hingga 1080p. Ia menerima hingga 30 gambar referensi, 10 video, dan 10 klip audio. Anda dapat mengaksesnya melalui aplikasi ByteDance, API BytePlus ModelArk, dan penyedia pihak ketiga, termasuk A2E. Ia memblokir wajah manusia nyata pada gambar referensi di semua jalur. Panduan kami tentang Seedance 2 prompts that avoid content flags membahas pilihan kata yang tak sengaja memicu filternya.
Kesimpulan: Pilihan terbaik untuk shot tunggal yang panjang, selama Anda menghindari wajah nyata.
6. Wan2.2
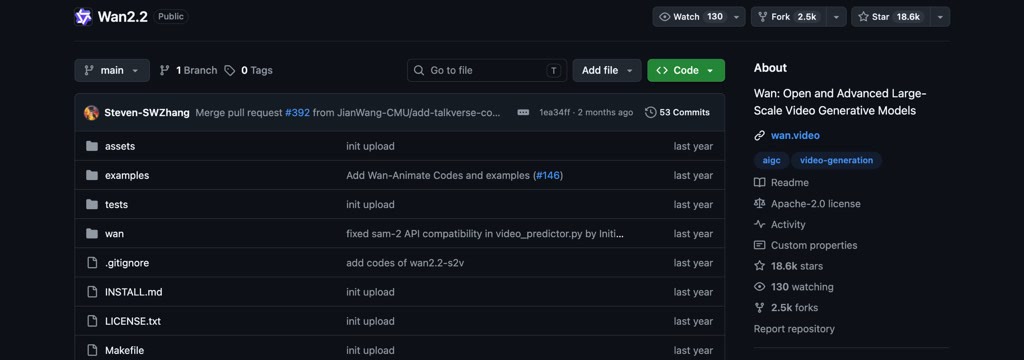
Open weights, berjalan lokal. Wan2.2 dilisensikan Apache 2.0 dan menyediakan model text to video, image to video, dan speech to video. Ia menggunakan arsitektur Mixture-of-Experts dan dilatih dengan 65,6% lebih banyak gambar serta 83,2% lebih banyak video dibanding Wan2.1. Model TI2V-5B-nya menangani text dan image to video pada 720p dan 24fps, dan README menyatakan ia berjalan pada kartu konsumen seperti RTX 4090. Model Animate-14B terpisah menangani animasi dan penggantian karakter.
Kesimpulan: Titik awal lokal terbaik jika Anda memiliki satu GPU kelas atas.
7. HunyuanVideo-1.5
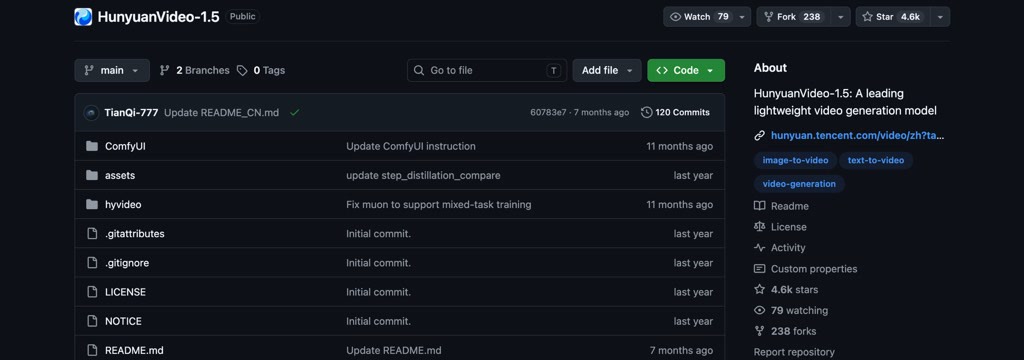
Open weights, berjalan lokal. HunyuanVideo-1.5 adalah model 8,3 miliar parameter untuk text to video dan image to video, dirancang untuk berjalan di GPU konsumen. README-nya mencantumkan kebutuhan minimal 14 GB memori GPU dengan model offloading aktif, dan model image-to-video 480p yang ter-distill per langkah mampu merender sebuah klip dalam sekitar 75 detik pada satu RTX 4090. Kode pelatihan dan skrip tuning LoRA juga terbuka. Ia dirilis di bawah lisensi komunitas Tencent sendiri, jadi bacalah itu sebelum penggunaan komersial.
Kesimpulan: Opsi lokal paling ringan, jika lisensinya sesuai dengan kebutuhan Anda.
8. LTX-2
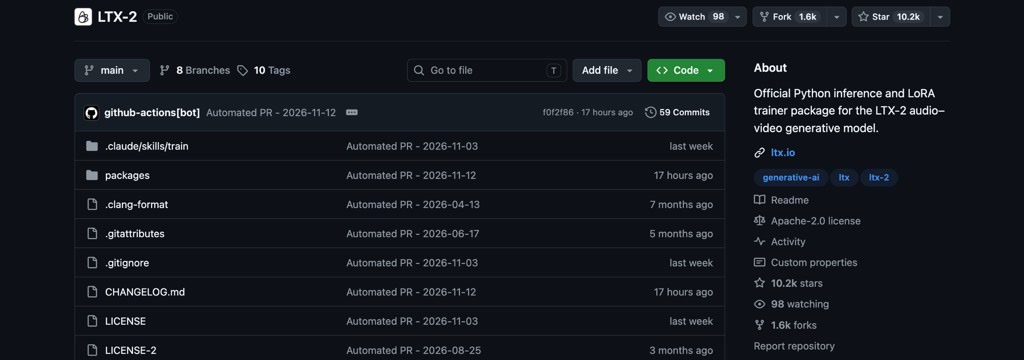
Open weights, berjalan lokal. LTX-2 dari Lightricks menghasilkan video dengan audio tersinkronisasi dalam satu model, dengan beberapa mode performa. Kodenya Apache 2.0, sedangkan bobotnya membawa lisensi model tersendiri yang tercantum di README, dan Hugging Face meminta Anda menyetujui ketentuan sebelum mengunduh. Quick start saat ini mengunduh sekitar 66 GiB bobot LTX-2.5, jadi siapkan ruang disk. Ia mendukung kuantisasi fp8 dan offload saat memori GPU terbatas, dan repositorinya menyertakan trainer LoRA.
Kesimpulan: Pilihan lokal saat Anda butuh suara dalam satu proses yang sama.
Untuk ketiga model open-weight tersebut, ComfyUI adalah front end yang lazim: muat bobotnya, rangkai workflow, dan generate secara offline. Anda menukar filter penyedia dengan kebutuhan perangkat keras dan waktu setup.
Cara mengurangi penolakan false-positive pada alat hosted
Sebagian besar penolakan pada prompt yang sah berasal dari pilihan kata, bukan niat:
- Deskripsikan shot secara literal. “Seorang koki mengiris bawang dengan pisau besar” lebih baik daripada prompt yang dibangun dengan kata kerja kekerasan.
- Hindari nama nyata. Sebagian besar penyedia memblokir prompt yang menyebut tokoh publik, dengan alasan yang baik.
- Mulai dari gambar Anda sendiri. Ini memberi model subjek yang jelas dan telah mendapat persetujuan.
- Gunakan negative prompt untuk menyingkirkan gore, blur, dan distorsi.
- Ganti model. Prompt yang ditolak satu model sering lolos di model lain.
Biarkan coding agent Anda menguji API A2E dengan Apidog CLI
Pada API video, bagian yang berisiko adalah job asinkron yang berstatus failed atau penolakan yang tidak ditangani UI Anda. Biarkan coding agent Anda menulis dan menjalankan pemeriksaan tersebut dengan Apidog CLI.
Setup sekali saja:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
curl -sL https://video.a2e.ai/dev/openapi-spec -o a2e-openapi.json
apidog import --project <projectId> --format openapi --file ./a2e-openapi.json
Lalu beri agent Anda (Claude Code, Codex, Cursor, atau OpenCode) satu prompt:
In Apidog project <projectId>, create a test case for POST /v1/userImage2Video/start
with a Bearer token from the environment variable A2E_TOKEN. Assert the response
has code 0 and a data._id. Then call GET /v1/userImage2Video/{_id} until
current_status is completed or failed, and fail the test on failed with the
reason. Run it against environment <envId> and summarize the result.
Eksekusi nyata memakai kredit A2E, jadi minta agent menambahkan mock expectation untuk status failed (apidog cli-schema get mock-create, lalu apidog mock create) dan uji penanganan error terhadapnya. Di CI, apidog run --test-case <caseId> -r junit menghasilkan laporan JUnit; lihat Apidog CLI in a CI/CD pipeline.
Generator video AI mana yang sebaiknya Anda pilih?
- Tanpa filter penyedia sama sekali, GPU 14 GB atau lebih: HunyuanVideo-1.5 atau Wan2.2 TI2V-5B di ComfyUI.
- Audio dan video dari satu model lokal: LTX-2.
- Banyak model hosted dalam satu akun: A2E.
- Klip penuh aksi: Kling 4.0.
- Shot tunggal panjang: Seedance 2.5.
- Membangun produk: API A2E plus tes Apidog CLI untuk siklus hidup job asinkron.
FAQ
Apakah ada generator video AI yang benar-benar tanpa pembatasan?
Hanya model open-weight yang Anda jalankan sendiri, seperti Wan2.2, HunyuanVideo-1.5, dan LTX-2. Mereka tidak memiliki filter sisi penyedia. Lisensi mereka dan hukum setempat tetap berlaku, dan setiap layanan hosted menegakkan kebijakan konten tertentu.
Apakah A2E bisa digunakan gratis?
A2E memiliki paket Gratis $0 dengan 30 kredit bonus per hari melalui check-in, dengan watermark dan output 720p. Akses API dimulai di paket Pro seharga $14,9 untuk satu bulan.
Mengapa generator video AI saya menolak prompt yang tidak berbahaya?
Filter prompt dan classifier output terpicu oleh kata-kata yang terkait dengan kekerasan atau orang nyata, bahkan dalam adegan yang tidak berbahaya. Deskripsikan shot secara literal dan coba model lain.
Apakah image to video lebih jarang ditolak dibanding text to video?
Sering kali iya, karena gambar Anda sendiri memberi model subjek yang jelas. Classifier output tetap memeriksa frame-nya, jadi ini bukan jaminan.