
Gemini 3.7 Flash est le tout dernier modèle d'IA performant de Google, lancé le 13 août 2026, trois semaines après Gemini 3.6 Flash. Il conserve la fenêtre de contexte de 1 million de tokens et l'entrée multimodale de son prédécesseur tout en affichant de grands gains sur les benchmarks de codage et d'agents, et il est lancé à un prix d'API d'introduction de 0,75 $ pour 1 million de tokens d'entrée. Google le qualifie de « notre modèle performant le plus intelligent ».
Cet écart de trois semaines entre les lancements est significatif. Google déploie les mises à jour Flash à un rythme effréné tandis que Gemini 3.5 Pro reste retardé, ce qui signifie que le modèle de milieu de gamme est désormais le premier à bénéficier des avancées techniques intéressantes. Les écarts des benchmarks le confirment : DeepSWE bondit de 16 points, AutomationBench a presque doublé, et le prix de lancement est inférieur de moitié au taux de lancement de 3.6 Flash.
Cet article couvre tout ce qui a changé : le tableau complet des benchmarks que Google a dispersé dans son annonce, les périodes tarifaires que vous devez noter, tous les endroits où vous pouvez accéder au modèle aujourd'hui, et une requête cURL fonctionnelle que vous pouvez exécuter en cinq minutes. Si vous souhaitez une présentation plus approfondie des points d'accès, le guide de démarrage rapide de l'API Gemini 3.7 Flash complète cette explication, et Apidog vous offre un espace de travail pour tester le nouveau modèle avec vos invites existantes avant de vous engager dans un changement.
En bref
- Gemini 3.7 Flash a été lancé le 13 août 2026, trois semaines après 3.6 Flash. ID du modèle :
gemini-3.7-flash. - Les benchmarks de codage et d'agents ont bondi : DeepSWE v1.1 de 49,0 % à 65,3 %, AutomationBench de 17,0 % à 30,4 %, WebDev Arena Elo de 1538 à 1588.
- Le prix de lancement de l'API est de 0,75 $ par million de tokens d'entrée et 3,75 $ par million de tokens de sortie, soit la moitié du prix de lancement de 3.6 Flash. Les tarifs standard (1,50 $ / 7,50 $) débutent le 1er janvier 2027.
- Les spécifications restent stables : contexte d'entrée de 1 million de tokens, limite de sortie de 64k, entrée multimodale (texte, image, vidéo, audio, PDF), appel de fonction, recherche en tant qu'outil, et utilisation d'ordinateur.
- Disponible dès maintenant dans l'API Gemini, AI Studio, l'application Gemini, Gemini Spark, Google Antigravity, Android Studio et Gemini Enterprise, dans plus de 160 pays.
- Gemini 3.5 Pro est toujours retardé ; Google déploie des améliorations Flash avant son prochain modèle phare.
Qu'est-ce que Gemini 3.7 Flash
Flash est le niveau intermédiaire de la gamme Gemini : moins cher et plus rapide que Pro, plus intelligent que Flash-Lite, et optimisé pour les charges de travail à volume élevé qui constituent la majeure partie du trafic d'IA en production. Gemini 3.7 Flash est la troisième version Flash de la gamme 3.x, et le cadre de Google a évolué avec elle. L'annonce officielle le positionne comme un modèle de codage et d'agent en premier lieu, et un modèle de chat en second.
La fiche technique est reprise de 3.6 Flash :
- Contexte : fenêtre d'entrée de 1 million de tokens, limite de sortie de 64k tokens.
- Modalités d'entrée : texte, image, vidéo, audio et PDF. La sortie est du texte.
- Outils : appel de fonction, recherche en tant qu'outil et utilisation d'ordinateur.
- Sécurité : des protections CBRN et cyber actualisées sont incluses dans la version.
Ce qui a changé, c'est le comportement, pas l'architecture. Google affirme que 3.7 Flash débogue mieux, génère plus souvent du code prêt à être déployé en production dès le premier essai, s'adapte lorsqu'il rencontre des obstacles, pose des questions de clarification lorsque l'intention est ambiguë et suit les instructions avec une plus grande fidélité. Ce sont les affirmations. Les benchmarks ci-dessous en sont la preuve.
Améliorations des benchmarks : 3.6 vs 3.7
Google a réparti ces chiffres dans un article de blog et une fiche modèle. Les voici dans un tableau, avec les écarts qui comptent :
| Benchmark | Gemini 3.6 Flash | Gemini 3.7 Flash | Changement |
|---|---|---|---|
| DeepSWE v1.1 (codage agentique) | 49.0% | 65.3% | +16.3 pts |
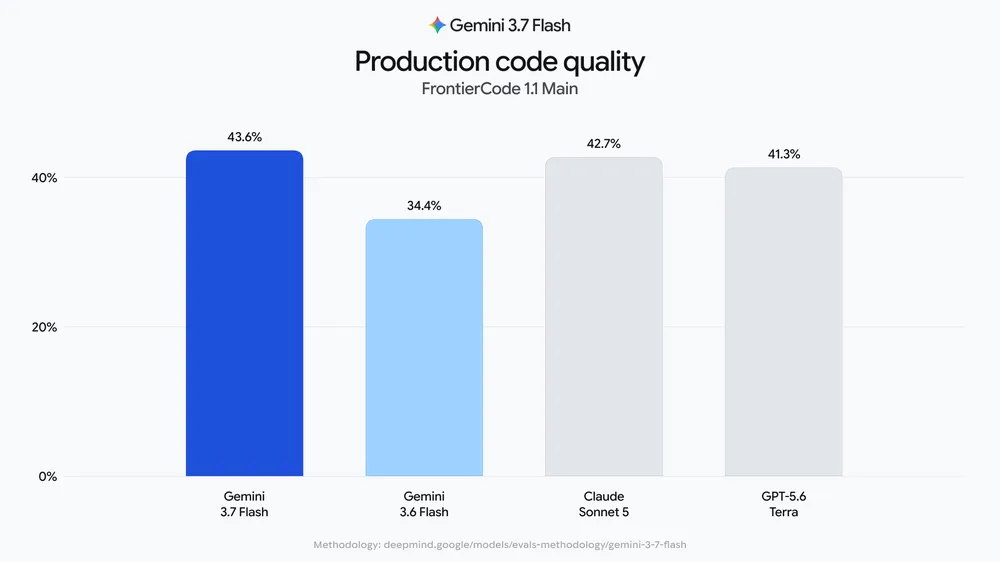
| FrontierCode 1.1 Main | 34.4% | 43.6% | +9.2 pts |
| WebDev Arena (Elo) | 1538 | 1588 | +50 Elo |
| GDP.pdf (raisonnement documentaire) | 22.0% | 34.0% | +12.0 pts |
| AutomationBench (tâches d'agent) | 17.0% | 30.4% | +13.4 pts |
Deux scores isolés complètent le tableau : 90,7 % sur Harvey LAB-AA, un benchmark de raisonnement juridique, et 97,0 % sur la récupération de contexte long de 128k-needle. Ce deuxième chiffre est important si vous alimentez le modèle avec de longs documents ; la qualité de la récupération en profondeur est l'endroit où de nombreux modèles s'effondrent discrètement.
Le schéma observé dans le tableau est cohérent. Les plus grands bonds se produisent sur les benchmarks agentiques, ceux qui mesurent le travail en plusieurs étapes plutôt que les réponses uniques. Le passage d'AutomationBench de 17,0 % à 30,4 % est le type d'écart qui modifie les tâches que l'on peut confier à un modèle de milieu de gamme. La couverture du lancement a mis en évidence le gain de DeepSWE comme le résultat principal, et pour une bonne raison : un saut de 16 points sur le codage agentique en trois semaines est inhabituel pour n'importe quelle gamme de modèles. Pour comprendre comment les écarts de benchmark se traduisent entre les modèles concurrents, la comparaison Grok 4.6 vs GPT 5.6 vs Claude montre comment des écarts similaires se manifestent dans des charges de travail réelles.
Améliorations du codage et des agents
Le tableau des benchmarks indique ce qui a été amélioré. Les notes de version de Google expliquent comment cela se manifeste en pratique, et les affirmations sont suffisamment spécifiques pour être testées :
- Débogage. Le modèle est meilleur pour localiser la cause d'une défaillance plutôt que de masquer les symptômes. Le gain de DeepSWE est le chiffre clé ici, puisque ce benchmark évalue les corrections de bugs multi-fichiers dans des dépôts réels.
- Code déployable dès le premier essai. Google affirme que davantage de code généré s'exécute sans cycle de correction. L'amélioration de 9,2 points de FrontierCode est la mesure publique la plus proche.
- Gestion des obstacles. Lorsqu'un appel d'outil échoue ou qu'un fichier est manquant, 3.7 Flash adapte son plan au lieu de boucler. C'est le comportement qu'AutomationBench met en évidence.
- Clarification de l'intention. Le modèle pose une question lorsque la requête est ambiguë plutôt que de deviner. Dans un pipeline d'agent, une étape de clarification est moins coûteuse qu'une réponse incorrecte de 5 000 tokens.
- Fidélité des instructions. Les requêtes de format de sortie, les limites de longueur et les contraintes négatives sont mieux respectées sur de longues conversations.
La pile d'outils est tout aussi importante que les scores bruts. L'appel de fonction et la recherche en tant qu'outil sont hérités de 3.6, et la prise en charge de l'utilisation d'un ordinateur signifie que le modèle peut piloter un navigateur lorsqu'aucune API n'existe pour la tâche. Cette dernière capacité se trouve dans une position étrange pour les développeurs : puissante, mais plus lente et moins déterministe qu'un point de terminaison structuré. Le comparatif entre l'utilisation d'un ordinateur et les API structurées explique quand chaque approche est pertinente.
Tarification : à moitié prix jusqu'au 31 décembre 2026
Gemini 3.7 Flash est lancé avec un calendrier de prix en deux phases sur l'API Gemini :
| Période | Entrée (par 1M de tokens) | Sortie (par 1M de tokens) |
|---|---|---|
| Jusqu'au 31 décembre 2026 | $0.75 | $3.75 |
| À partir du 1er janvier 2027 | $1.50 | $7.50 |
Le tarif de lancement est la moitié de ce que coûtait Gemini 3.6 Flash à son lancement, ce qui fait des quatre mois et demi à venir la période la moins chère que cette famille de modèles ait jamais connue. Le piège est le doublement du prix le 1er janvier. Si vous établissez un budget basé sur des tokens d'entrée à 0,75 $, ce budget sera insuffisant dans cinq mois à moins de le prévoir dès maintenant.
Deux points pratiques à retenir. Premièrement, vérifiez les tarifs actuels sur la page officielle des tarifs avant de déployer quoi que ce soit ; les périodes d'introduction ont déjà été modifiées par le passé. Deuxièmement, estimez vos coûts pour 2027 au tarif standard, et non au tarif promotionnel. Les exemples complets, incluant le calcul des tokens pour les chatbots, les pipelines de documents et les boucles d'agents, se trouvent dans l'analyse détaillée des prix de Gemini 3.7 Flash.
Où vous pouvez l'utiliser aujourd'hui
Google a déployé 3.7 Flash sur l'ensemble de sa surface dès le premier jour, dans plus de 160 pays :
- API Gemini. La voie des développeurs. Obtenez une clé depuis AI Studio et appelez directement
gemini-3.7-flash. - Google AI Studio. Un environnement de test basé sur navigateur pour tester les invites avant d'écrire du code.
- Application Gemini. L'application de chat grand public a intégré le nouveau modèle au lancement.
- Gemini Spark. Disponible pour les abonnés AI Pro et Ultra.
- Google Antigravity. L'environnement de développement agentique de Google l'utilise.
- Android Studio. L'intégration à l'IDE utilise le modèle pour l'assistance au codage.
- Gemini Enterprise. L'offre gérée pour les organisations ayant des exigences de conformité.
Pour un accès API à grande échelle, vous disposez également de la voie Vertex AI sur aiplatform.googleapis.com avec OAuth, IAM et journalisation d'audit. Même modèle, même schéma de requête, différentes garanties d'authentification et d'hébergement.
Pourquoi Google a lancé Flash avant Gemini 3.5 Pro
L'ordre de sortie est inhabituel. Les modèles phares précèdent normalement et les niveaux moins chers suivent. Google a inversé cette logique : 3.6 Flash fin juillet, 3.7 Flash trois semaines plus tard, et Gemini 3.5 Pro toujours sans date. Axios rapporte que Google déploie délibérément les mises à jour Flash avant son prochain modèle phare, tandis que Pro reste retardé.
Interprétée comme une stratégie plutôt qu'un retard de calendrier, cette démarche a du sens. La plupart du trafic de production s'exécute sur des modèles de milieu de gamme, car c'est là que le coût par token rencontre une qualité acceptable. Améliorer Flash, c'est améliorer le modèle que la plupart des clients utilisent quotidiennement. Cela maintient également Google dans la conversation sur les cycles de publication à un moment où chaque grand laboratoire déploie rapidement, sans brûler l'annonce de son modèle phare.
Pour les développeurs, la conséquence pratique est que le niveau Flash n'est plus à la traîne. Les capacités d'agent y sont introduites en premier. Si vous avez retardé le déplacement de vos charges de travail de 3.6 parce que vous attendiez Pro, le guide de migration de 3.6 à 3.7 Flash couvre le changement, qui pour la plupart des bases de code est un simple changement d'ID de modèle sur une ligne et un passage de régression.
Comment essayer l'API en cinq minutes
Vous avez besoin d'une clé API d'AI Studio. Créez-en une, exportez-la et envoyez votre première requête :
export GEMINI_API_KEY="AIza..."

curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.7-flash:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "contents": [{
      "parts": [{ "text": "Review this function for bugs: def dedupe(items): return list(set(items))" }]
    }],
    "generationConfig": {
      "temperature": 0.4,
      "maxOutputTokens": 1024
    }
  }'
La réponse est renvoyée sous forme d'un tableau candidates avec le texte généré dans content.parts, plus un bloc usageMetadata qui indique le nombre exact de tokens d'entrée et de sortie. Surveillez ce bloc dès le premier jour ; c'est votre compteur de coûts. Pour le streaming, remplacez :generateContent par :streamGenerateContent?alt=sse et l'API renvoie des événements envoyés par le serveur.
Une fois le premier appel fonctionnel, déplacez l'expérimentation hors de votre terminal. Dans Apidog, importez la spécification de l'API Generative Language, liez GEMINI_API_KEY à l'en-tête x-goog-api-key en tant que variable d'environnement, et enregistrez l'ID du modèle en tant que variable de chemin. Vous pouvez maintenant réexécuter la même invite côte à côte avec gemini-3.6-flash et gemini-3.7-flash, visualiser les flux SSE en direct et enregistrer les réponses comme exemples afin que les vérifications de régression ne consomment pas de tokens. C'est le moyen le plus rapide de vérifier l'affirmation de Google concernant une « meilleure exécution des instructions » avec vos propres invites, au lieu de vous fier uniquement au communiqué de lancement.
FAQ
Gemini 3.7 Flash est-il gratuit ?
L'API Gemini dispose d'un niveau gratuit via AI Studio avec un quota quotidien, ce qui couvre le prototypage. L'utilisation payante commence au tarif de lancement de 0,75 $ par million de tokens d'entrée jusqu'au 31 décembre 2026. Si vous souhaitez étendre davantage le quota gratuit, le guide pour l'accès gratuit illimité à l'API Gemini couvre les limites et la manière de les gérer.
Quelle est la différence entre Gemini 3.6 Flash et 3.7 Flash ?
Mêmes spécifications, meilleur comportement. La fenêtre de contexte, la limite de sortie, les modalités et le support des outils sont inchangés. Les gains se situent sur les benchmarks de codage et d'agents : DeepSWE en hausse de 16,3 points, AutomationBench en hausse de 13,4 points, WebDev Arena en hausse de 50 Elo. Google revendique également un meilleur débogage, une meilleure exécution des instructions et une planification multi-étapes.
Gemini 3.7 Flash remplace-t-il Gemini 3.5 Pro ?
Non. Pro reste le niveau phare pour les tâches de raisonnement les plus difficiles, et Gemini 3.5 Pro est toujours en développement. Flash 3.7 est le modèle que Google recommande pour le travail de production à grand volume où le coût et la latence sont aussi importants que la qualité.
Que se passe-t-il avec la tarification le 1er janvier 2027 ?
Le tarif de lancement prend fin et la tarification standard entre en vigueur : 1,50 $ par million de tokens d'entrée et 7,50 $ par million de tokens de sortie, soit le double du tarif de lancement. Établissez votre budget en fonction du tarif standard pour toute charge de travail qui se prolongera au-delà de 2026.
Gemini 3.7 Flash peut-il traiter des images et des PDF ?
Oui. Les modalités d'entrée couvrent le texte, l'image, la vidéo, l'audio et le PDF dans le même tableau contents. La sortie est uniquement du texte. Le score de 34,0 % sur le benchmark GDP.pdf, en hausse par rapport à 22,0 %, est la preuve de Google que la compréhension des documents s'est améliorée en même temps que les gains en codage.
Où 3.7 Flash s'intègre dans votre pile
Gemini 3.7 Flash est un modèle de milieu de gamme avec des scores de benchmark de niveau agent et une remise de prix de quatre mois. Cette combinaison fait que la décision n'est pas tant de savoir s'il faut l'évaluer, mais plutôt à quelle vitesse. Les gains agentiques sont des chiffres réels sur les benchmarks publics, les spécifications correspondent à ce que vous utilisez aujourd'hui sur 3.6, et le prix de lancement signifie que le tester maintenant coûte la moitié de ce que coûtera la même évaluation en janvier.
La séquence logique : exécutez votre suite d'invites existantes avec gemini-3.7-flash, comparez les sorties et l'utilisation des tokens avec votre modèle actuel, et laissez les résultats désigner le gagnant. Téléchargez Apidog pour effectuer cette comparaison dans un seul espace de travail ; enregistrez vos réponses de 3.6 comme exemples, rejouez les mêmes requêtes avec 3.7, et vous saurez en un après-midi si l'histoire des benchmarks est valable pour votre charge de travail.