
Alibaba a officiellement lancé Qwen 3.8-Max début août 2026, et il arrive avec une combinaison inhabituelle : un modèle MoE (Mixture-of-Experts) de 2,4 billions de paramètres qui n'active que 95 milliards de paramètres par jeton, un prix forfaitaire de 2 $/6 $ par million de jetons sur un contexte complet de 1 million, et la promesse que les poids seront rendus publics sur Hugging Face et ModelScope dans la semaine. Cette dernière partie est importante. Aucun modèle de la classe Qwen-Max n'a jamais été livré avec des poids ouverts auparavant.
L'annonce officielle le présente comme le Qwen le plus performant à ce jour, et le tableau de référence du fournisseur le confirme avec des résultats vraiment solides et quelques défaites honnêtes. Ce guide détaille ce qu'est réellement Qwen 3.8-Max, ce que disent les chiffres, où il se situe par rapport à Kimi K3, Fable 5 et GPT-5.6 Sol, et toutes les façons de l'utiliser aujourd'hui. Si vous prévoyez de développer avec l'API, le modèle est livré avec des points de terminaison compatibles OpenAI et Anthropic, ce qui rend un client conscient des protocoles comme Apidog utile pour tester les deux formes avec la même clé.
Qwen 3.8-Max en un coup d'œil
| Spécification | Qwen 3.8-Max |
|---|---|
| Développeur | Alibaba (équipe Qwen) |
| Lancement | Début août 2026 (Disponibilité générale sur Model Studio, 3 août) |
| Architecture | MoE, basé sur la fondation Qwen 3.5 |
| Paramètres totaux | 2.4T |
| Paramètres actifs | 95 milliards (~4% d'activation) |
| Fenêtre de contexte | 1 000 000 de jetons |
| Sortie maximale | 65 536 jetons |
| Modalités | Entrée texte + image, sortie texte |
| Contrôles de raisonnement | reasoning_effort : xhigh (par défaut), medium, low |
| ID du modèle API | qwen3.8-max |
| Tarification | 2 $ entrée / 6 $ sortie par million de jetons, forfaitaire sur tout le contexte |
| Poids ouverts | Promis pour la semaine prochaine (~10 août) ; pas encore téléchargeables début août 2026 |
| Protocoles API | Compatibles OpenAI et Anthropic |
Tout ce qui figure dans ce tableau provient des documents de lancement d'Alibaba et de la page de tarification de Model Studio. Passons maintenant aux détails.
Qu'est-ce que Qwen 3.8-Max
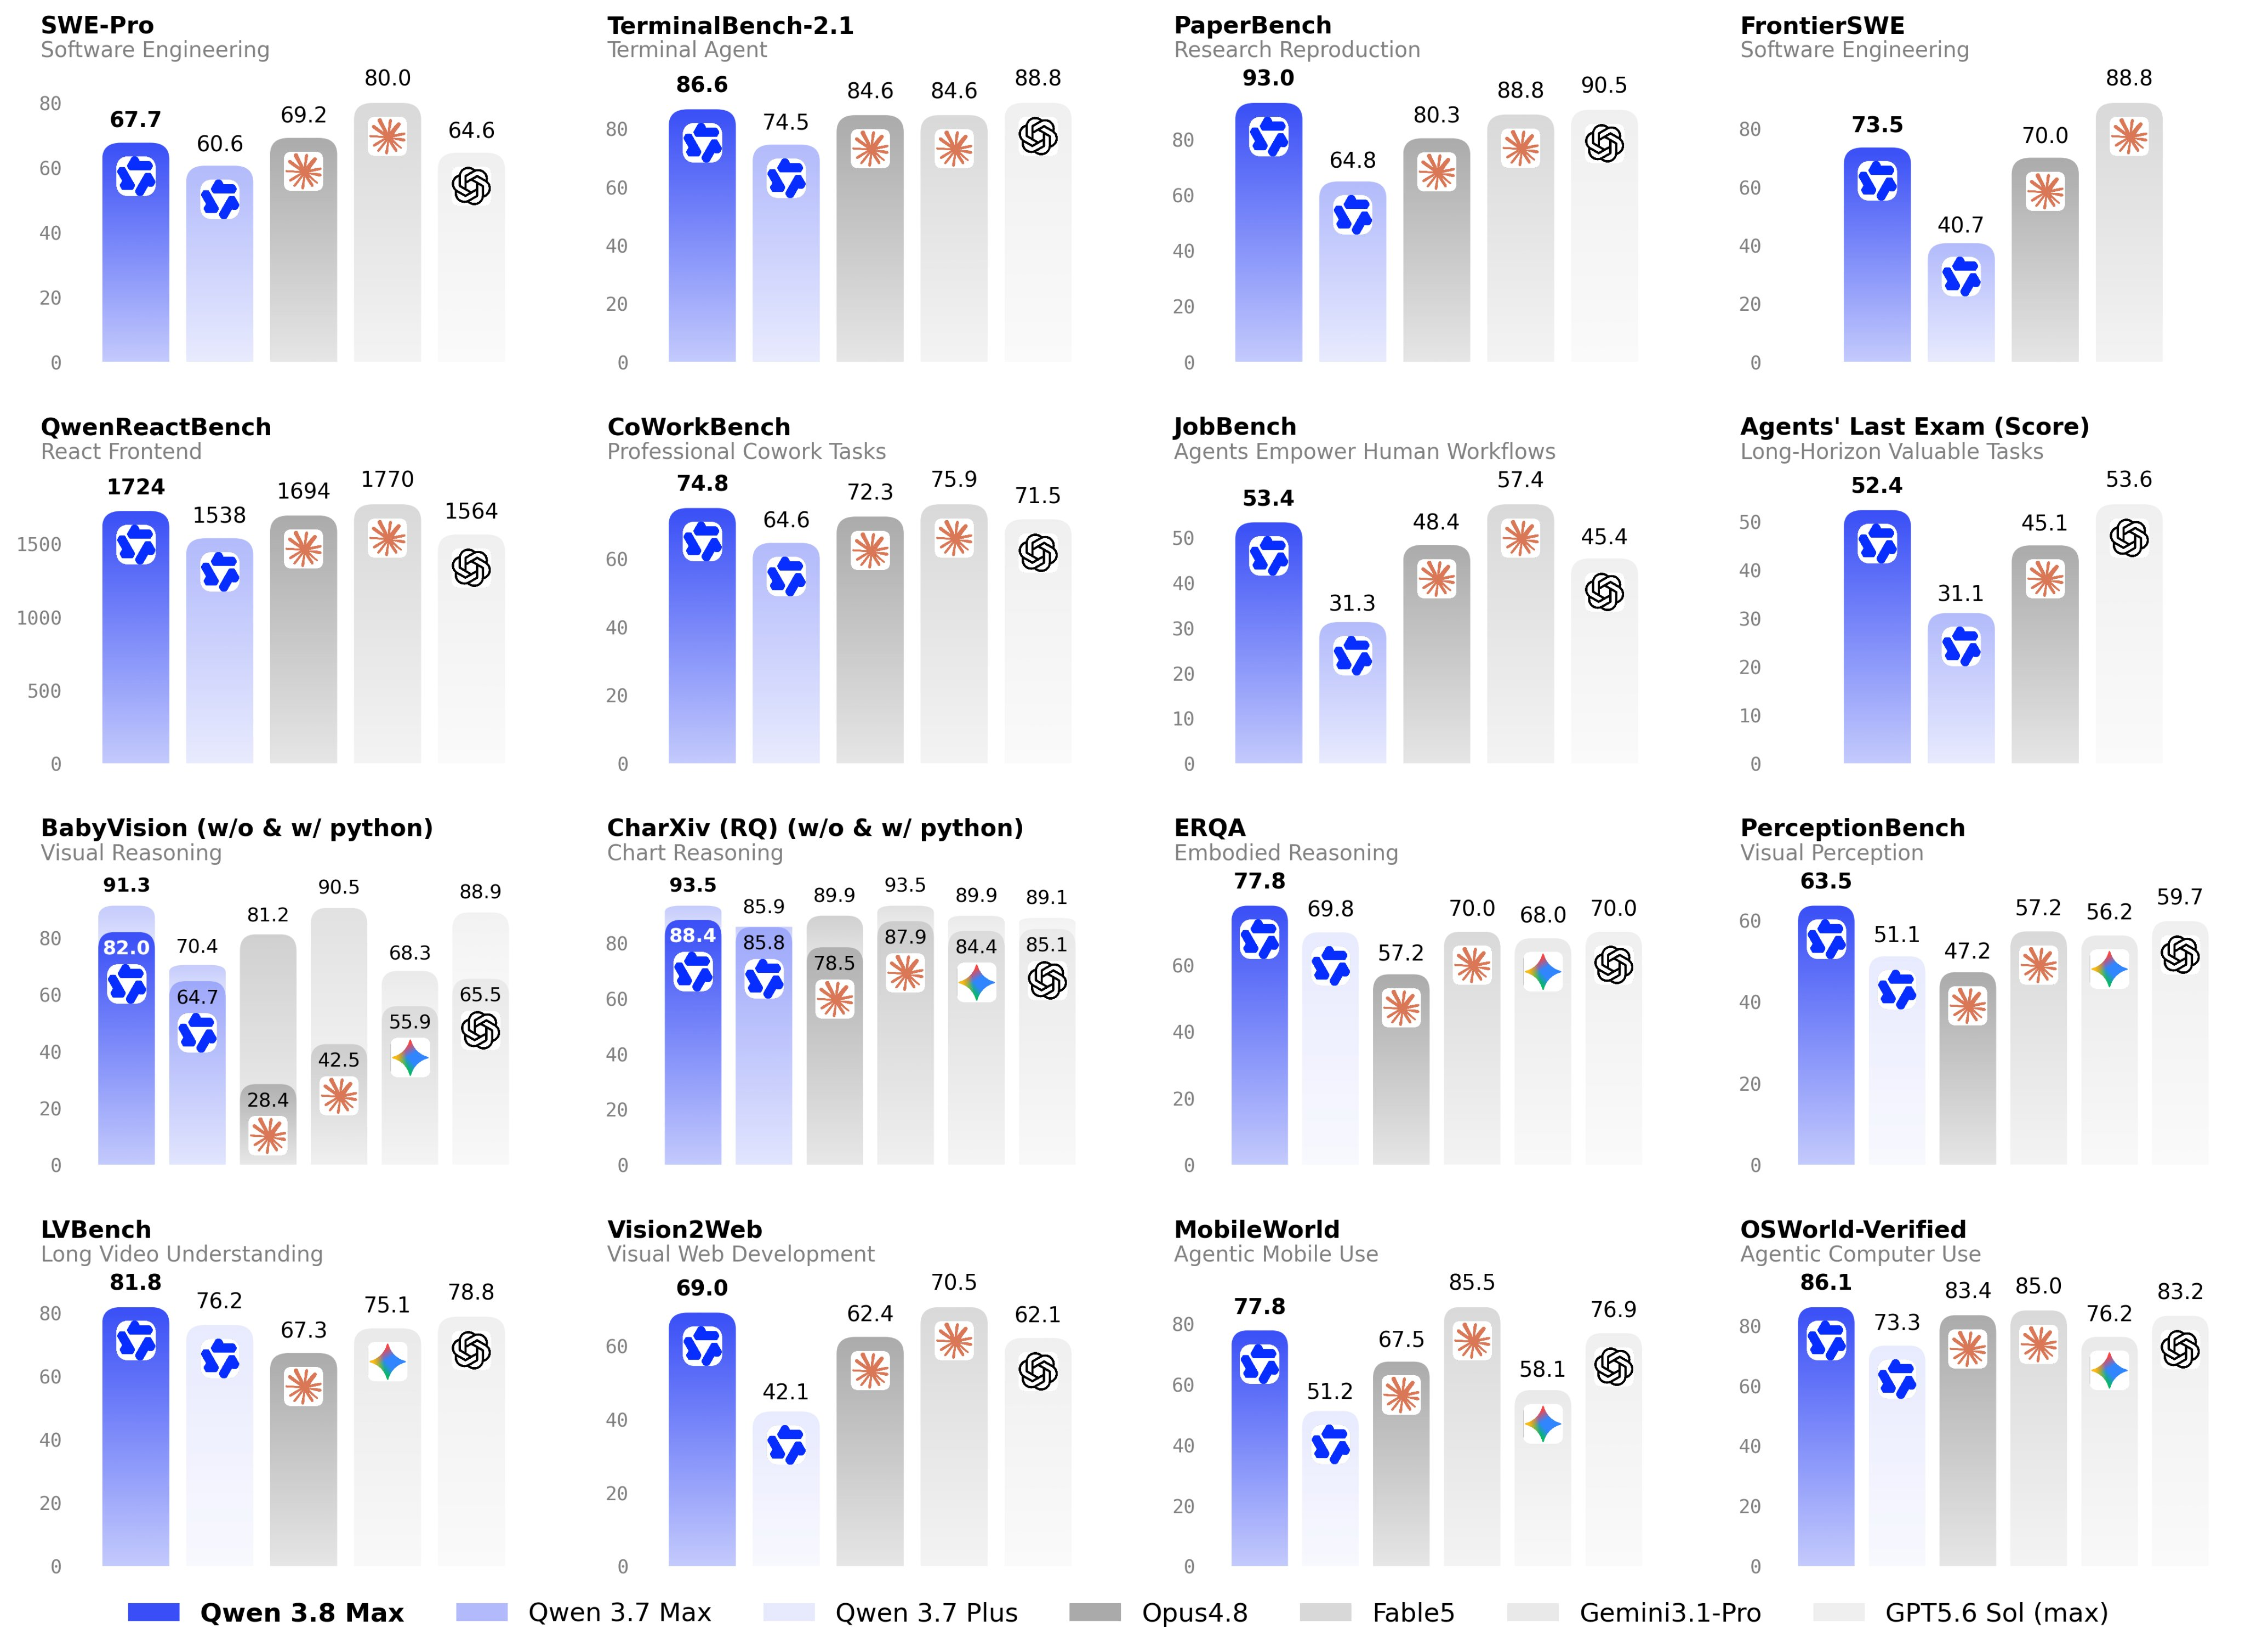
Qwen 3.8-Max est le nouveau fleuron de la famille Qwen d'Alibaba, construit sur les fondations architecturales de Qwen 3.5. Il remplace Qwen 3.7-Max en tête de gamme, et le tableau du fournisseur montre des bonds significatifs par rapport à son prédécesseur : Terminal Bench 2.1 passe de 74.5 à 86.6, et PaperBench de 64.8 à 93.0. Si vous hésitez à passer de l'ancien modèle, les différences sont détaillées dans notre comparaison Qwen 3.8 vs Qwen 3.7 Max.
La spécification principale est la répartition des paramètres. 2,4 billions de paramètres totaux, cela semble énorme, et ça l'est, mais la conception MoE n'active que 95 milliards par passage avant. Ce ratio d'activation d'environ 4 % est la raison pour laquelle Alibaba peut proposer un modèle aussi grand à 2 $/6 $ par million de jetons. À titre de comparaison, Kimi K3 fonctionne avec un total de 2,8 billions et 104 milliards actifs, donc Qwen 3.8-Max est le modèle plus petit sur les deux points.
Côté entrée, le modèle accepte le texte et les images via l'API. Le blog d'Alibaba démontre également la compréhension de documents longs (PDF de plus de 200 pages) et la compréhension de vidéos de 100 heures via ce qu'il appelle des graphes de mémoire. Considérez-les comme des capacités démontrées sur le blog plutôt que comme des types d'entrée API distincts ; les configurations API publiées listent le texte et l'image comme modalités d'entrée.
Le raisonnement est contrôlé via un paramètre reasoning_effort à trois niveaux : xhigh (par défaut), medium et low. Il y a aussi enable_thinking et preserve_thinking, avec le raisonnement préservé par défaut. Un détail de tarification à connaître tôt : les modes de raisonnement et de non-raisonnement sont facturés au même tarif, mais les jetons de raisonnement comptent comme sortie, donc les factures réelles avec le défaut xhigh seront plus élevées qu'un calcul simple.
Le premier Qwen de classe Max à poids ouverts
Il s'agit du plus grand mouvement stratégique de cette version. Alibaba a open-sourcé de nombreux modèles Qwen au fil des ans, mais jamais la catégorie Max. Qwen 3.8-Max rompt avec cette habitude : l'entreprise annonce que les poids seront disponibles sur Hugging Face et ModelScope « la semaine prochaine », ce qui correspond à environ le 10 août.
Deux mises en garde, clairement énoncées :
- Les poids ne sont pas encore téléchargeables. Début août 2026, la promesse reste une promesse. Kimi K3 a créé un précédent récent ici : ses poids sont arrivés 11 jours après le lancement, donc un léger retard ne serait pas surprenant.
- L'auto-hébergement d'un modèle de 2,4 billions de paramètres est un projet multi-nœuds. Même fortement quantifié, ce n'est pas quelque chose que l'on exécute sur une station de travail. Pour la plupart des équipes, les « poids ouverts » signifieront un accès hébergé moins cher via des fournisseurs tiers plutôt qu'un déploiement local.
Si votre intérêt pour Qwen 3.8-Max est principalement de ne pas payer le prix catalogue, les voies réalistes actuelles sont Qwen Chat et le quota gratuit de Model Studio, tous deux couverts dans notre guide sur l'utilisation gratuite de Qwen 3.8.
Ce que les benchmarks montrent, y compris les défaites
Alibaba a publié un tableau de benchmarks complet comparant Qwen 3.8-Max à Claude Opus 4.8, Fable 5, GPT-5.6 Sol et Qwen 3.7-Max. Deux avertissements avant tout chiffre : il s'agit de résultats obtenus par le fournisseur, et la plupart des lignes de codage ont été exécutées à l'aide de l'outil Claude Code pour tous les modèles. Plusieurs benchmarks (QwenSWEBench, QwenQoderBench, CoWorkBench, RecreationBench) sont des créations internes d'Alibaba. Aucun chiffre indépendant provenant d'organismes comme Artificial Analysis n'existait au moment de la rédaction.
Avec ce cadrage, les lignes les plus remarquables selon le tableau d'Alibaba :
Où il gagne :
- PaperBench : 93.0, son meilleur résultat phare unique, devant GPT-5.6 Sol (90.5), Fable 5 (88.8) et Opus 4.8 (80.3)
- IFBench : 82.8, le score le plus élevé de la ligne, devant les 72.7 de Sol
- Terminal Bench 2.1 : 86.6, battant Opus 4.8 et Fable 5 (tous deux 84.6), juste derrière Sol (88.8)
- Le multimodal est son point fort : MathVision 95.2, LogicVista 91.9, OSWorld-Verified 86.1, et les lignes OCR qui devancent presque tout le reste du tableau
Où il perd :
- SWE-bench Pro : 67.7, bien derrière les 80.0 de Fable 5 et légèrement derrière les 69.2 d'Opus 4.8 (il bat cependant les 64.6 de Sol)
- HLE : 43.6, le score phare le plus faible de la ligne ; Fable 5 affiche 53.3, Sol 47.2 et Opus 4.8 45.7
En résumé honnête : selon les propres chiffres d'Alibaba, Qwen 3.8-Max bat Opus 4.8 sur plusieurs lignes d'agents, est en retrait par rapport à Fable 5 sur la plupart des tâches de codage de base, et remporte une victoire éclatante sur les tâches multimodales et d'intelligence documentaire. Sur GPQA Diamond, il se situe à 92.6, à égalité avec Fable 5 et juste derrière les 94.1 de Sol, donc le raisonnement scientifique pur est compétitif. Pour une présentation complète du tableau, y compris les détails de l'outil et ce qu'il faut surveiller en matière de vérification indépendante, consultez notre analyse des benchmarks de Qwen 3.8.
Alibaba a également publié une série de démonstrations : une session de codage autonome de 16 jours sur un dépôt public (265 commits, 127 pull requests), une reproduction d'article qui a battu le résultat AIME24 de l'article original, et une participation à un concours Tianchi qui a surpassé 458 des 526 équipes humaines en 24 heures. Ce sont les propres démonstrations du fournisseur, il faut donc les considérer comme des publicités de capacités plutôt que des évaluations contrôlées. L'histoire du codage, y compris la reproduction des configurations d'outils, est traitée en détail dans Qwen 3.8 pour le codage.
Où il se situe par rapport à Kimi K3, Fable 5 et GPT-5.6 Sol
Vs Kimi K3. C'est la rivalité naturelle : deux laboratoires chinois, deux modèles MoE géants à poids ouverts, lancés à quelques semaines d'intervalle. K3 est plus grand (2,8 billions au total, 104 milliards actifs vs 2,4 billions/95 milliards), textuel uniquement là où Qwen est multimodal, et ses poids sont déjà disponibles tandis que ceux de Qwen ne sont encore qu'une promesse. La tarification diverge également fortement : K3 facture 3 $ en entrée / 15 $ en sortie avec 0,30 $ pour les accès au cache, contre le forfait de 2 $/6 $ de Qwen. Aucune évaluation directe en face à face n'existe encore ; chaque fournisseur a publié son propre tableau. Nous les comparons ligne par ligne dans Qwen 3.8 vs Kimi K3, et si vous débutez avec le modèle de Moonshot, commencez par ce qu'est Kimi K3.
Vs Fable 5. Le fleuron d'Anthropic reste la référence en matière de codage à battre, et Qwen 3.8-Max ne le bat pas : SWE-bench Pro (67.7 vs 80.0) et HLE (43.6 vs 53.3) présentent des écarts clairs, selon le propre tableau d'Alibaba. Ce que Qwen offre à la place, c'est un prix (une fraction des tarifs de pointe), un contexte de 1 million de jetons, des poids ouverts en route, et des lignes multimodales plus solides.
Vs GPT-5.6 Sol. Sol l'emporte sur Terminal Bench (88.8 vs 86.6), GPQA (94.1 vs 92.6) et HLE (47.2 vs 43.6), tandis que Qwen 3.8-Max gagne sur PaperBench (93.0 vs 90.5) et IFBench (82.8 vs 72.7). En termes de prix, le 2 $/6 $ de Qwen est inférieur au 2 $/12 $ de GPT-5.6 Terra pour la sortie, et l'accès de niveau Sol coûte encore plus cher.
Un autre point de comparaison : Claude Opus 5 est tarifé à 5 $/25 $. Quoi que vous pensiez des tableaux de fournisseurs, Alibaba fixe le prix de son fleuron à un niveau qui modifie le calcul pour les charges de travail à volume élevé.
Tarification : 2 $/6 $, forfaitaire sur 1 million de jetons
La tarification est suffisamment simple pour être énoncée en une phrase : 2 $ par million de jetons en entrée, 6 $ par million de jetons en sortie, un niveau forfaitaire unique du jeton zéro à la limite de contexte de 1 million, mode de raisonnement activé ou non.
Le niveau forfaitaire est la partie inhabituelle. La plupart des modèles à long contexte augmentent les prix à mesure que votre prompt s'allonge ; Qwen 3.8-Max ne le fait pas. Il est également lancé moins cher que le prix catalogue de Qwen 3.7-Max (2.5 $/7.5 $), bien que ce modèle plus ancien bénéficie actuellement d'une promotion de 50 % (1.25 $/3.75 $), ce qui le maintient pertinent en tant qu'option économique.
La mise en cache de contexte adoucit les charges de travail à préfixes répétés : les accès au cache sont facturés à 10 % du taux d'entrée, et la création explicite de cache coûte 125 %. Il existe également un quota gratuit (1 million de jetons, région de Singapour uniquement, valable 90 jours) pour tester le modèle. La répartition complète des coûts, avec des exemples par tâche et la quantification du piège des jetons de raisonnement, se trouve dans notre guide de tarification de Qwen 3.8.
Comment accéder à Qwen 3.8-Max
La matrice d'accès est plus large que pour un lancement typique. Cinq voies :
1. Qwen Chat. L'application grand public, aucune clé API nécessaire. Le moyen le plus rapide de se faire une opinion.
2. L'API sur Alibaba Cloud Model Studio (DashScope). Obtenez une clé sur home.qwencloud.com, définissez DASHSCOPE_API_KEY, et appelez l'ID de modèle qwen3.8-max via les points de terminaison de complétions de chat ou de réponses compatibles OpenAI. Trois URL de base régionales sont actives : Pékin (dashscope.aliyuncs.com/compatible-mode/v1), Singapour (dashscope-intl.aliyuncs.com/compatible-mode/v1) et Virginie (États-Unis) (dashscope-us.aliyuncs.com/compatible-mode/v1). La page des modèles de Model Studio le répertorie en haut de la pile recommandée.
3. Le point de terminaison compatible Anthropic. C'est le plus inhabituel : https://dashscope-intl.aliyuncs.com/apps/anthropic prend en charge le protocole Anthropic Messages, de sorte que les outils conçus pour Claude peuvent cibler Qwen avec deux variables d'environnement.
4. Outils de codage. Alibaba a publié des configurations officielles pour cinq agents : Claude Code (via ANTHROPIC_BASE_URL plus ANTHROPIC_MODEL=qwen3.8-max), Codex, Qoder, Qwen Code et OpenClaw. Il est à noter qu'Alibaba a exécuté la plupart de ses benchmarks de codage à l'intérieur de l'outil Claude Code, de sorte que la configuration qu'il a publiée est également la configuration derrière ses propres chiffres.
5. Poids ouverts, bientôt. Hugging Face et ModelScope, promis pour la semaine prochaine, pas encore téléchargeables début août 2026.
Les détails de configuration pour les voies 2 à 4, avec du Python et cURL prêts à copier-coller, se trouvent dans notre guide API Qwen 3.8.
Tester l'API à double protocole
Le même modèle répondant sur deux formes de protocole différentes soulève une question pratique de test : votre requête se comporte-t-elle de manière identique sur les deux ? C'est là qu'un client API s'avère utile. Dans Apidog, vous pouvez enregistrer les trois URL de base régionales comme environnements et changer de région sans modifier les requêtes, envoyer le même prompt via le point de terminaison compatible OpenAI et le point de terminaison compatible Anthropic côte à côte, et inspecter le flux SSE pour observer l'arrivée des deltas de reasoning_content avant la réponse finale. Cette dernière partie est utile pour vérifier la quantité de raisonnement générée par le défaut xhigh, puisque ces jetons sont facturés comme sortie. Téléchargez Apidog gratuitement si vous voulez suivre lorsque vous connectez les points de terminaison ; le même espace de travail facilite également le test A/B de qwen3.8-max contre qwen3.7-max ou kimi-k3 sur des invites identiques avant de valider une charge de travail.
Où Qwen 3.8-Max se situe dans la gamme
Si vous cartographiez la famille élargie, Qwen 3.8-Max se situe désormais au-dessus de Qwen 3.7-Max et des modèles de niveau Plus, et notre guide des meilleurs modèles Qwen couvre quel niveau convient à quelle charge de travail. En bref : 3.8-Max est le choix lorsque vous avez besoin du plafond multimodal et d'agent, 3.7-Max à 50 % de réduction est le fleuron économique tant que la promotion dure, et les modèles Plus restent les chevaux de trait bon marché pour les tâches routinières.
FAQ
Qwen 3.8 est-il open source ?
Pas encore, mais c'est proche. Alibaba a promis les poids pour Hugging Face et ModelScope « la semaine prochaine » à partir du lancement début août 2026, ce qui en ferait le premier Qwen de classe Max à poids ouverts. Rien n'est téléchargeable au moment de la rédaction. D'ici là, l'accès se fait via l'API ou Qwen Chat ; voir comment utiliser Qwen 3.8 gratuitement pour les voies sans coût.
Combien coûte Qwen 3.8-Max ?
2 $ par million de jetons en entrée et 6 $ par million de jetons en sortie, sur un seul niveau forfaitaire sur l'intégralité du contexte de 1 million. Les accès au cache sont facturés à 10 % du taux d'entrée. Les jetons de raisonnement sont facturés comme sortie, et l'effort de raisonnement par défaut est xhigh, donc prévoyez un budget supérieur au prix affiché pour les travaux nécessitant beaucoup de raisonnement.
Qwen 3.8-Max est-il meilleur que Kimi K3 ?
Il n'y a pas encore d'évaluation directe en face à face ; les deux fournisseurs ont publié leurs propres tableaux. Sur le papier, Qwen 3.8-Max est plus petit (2,4 billions / 95 milliards actifs vs 2,8 billions / 104 milliards), multimodal là où K3 est textuel uniquement, et moins cher en sortie (6 $ vs 15 $). L'avantage de K3 aujourd'hui est que ses poids sont déjà publics.
Puis-je utiliser Qwen 3.8-Max dans Claude Code ?
Oui. Alibaba a publié une configuration officielle : pointez ANTHROPIC_BASE_URL vers le point de terminaison DashScope compatible Anthropic et définissez ANTHROPIC_MODEL=qwen3.8-max. Codex, Qoder, Qwen Code et OpenClaw ont également des configurations officielles.
Que faire ensuite
Qwen 3.8-Max est une véritable version phare, pas un aperçu pour la presse : disponibilité générale sur trois régions API, tarification publiée, un tableau de benchmarks complet (réalisé par le fournisseur) avec des victoires et des défaites, et des poids ouverts à quelques jours. La lecture honnête est qu'il ne détrône pas Fable 5 sur le codage de base, mais il bat Opus 4.8 sur plusieurs lignes d'agents, domine sur le travail documentaire et multimodal, et coûte 2 $/6 $ en le faisant.
La démarche sensée est de le tester par rapport à votre propre charge de travail plutôt qu'à n'importe quel tableau. Obtenez le quota gratuit, connectez les deux points de terminaison de protocole et comparez les sorties sur les invites que vous exécutez réellement. Commencez par le guide de configuration de l'API, et revenez vers le 10 août pour voir si les poids sont arrivés à temps.