
Jev est un nouveau type de modèle de TypeSafe AI. Il n'écrit pas de texte. Vous lui donnez un morceau d'état de programme, déclarez les questions auxquelles vous avez besoin de réponses, et il renvoie des réponses typées avec des probabilités calibrées : une probabilité oui/non, un choix parmi une liste, ou un score sur une grille. TypeSafe appelle cela un « Modèle Système Un », et l'argument est simple : la plupart des appels d'IA au sein des logiciels ne demandent pas de prose, ils demandent une décision. Si vous avez câblé un LLM dans un classificateur et ensuite écrit un analyseur pour extraire une étiquette de sa réponse, Jev est conçu précisément pour ce travail, de la même manière que les sorties structurées en ont été une première étape.
Il a été lancé sur Vercel AI Gateway le 16 septembre 2026, ce qui l'a rendu accessible à la plupart des développeurs. Ce guide explique ce qu'est Jev, comment il diffère d'un modèle linguistique, les trois types de questions, comment l'appeler directement et via la passerelle, et comment le tester et le simuler dans Apidog avant qu'il n'affecte votre logique de routage.
Qu'est-ce que Jev
Le billet de lancement de TypeSafe décrit Jev comme « un appel de fonction d'intelligence de pointe : état non structuré en entrée, décisions probabilistes typées en sortie. » Trois propriétés le définissent.
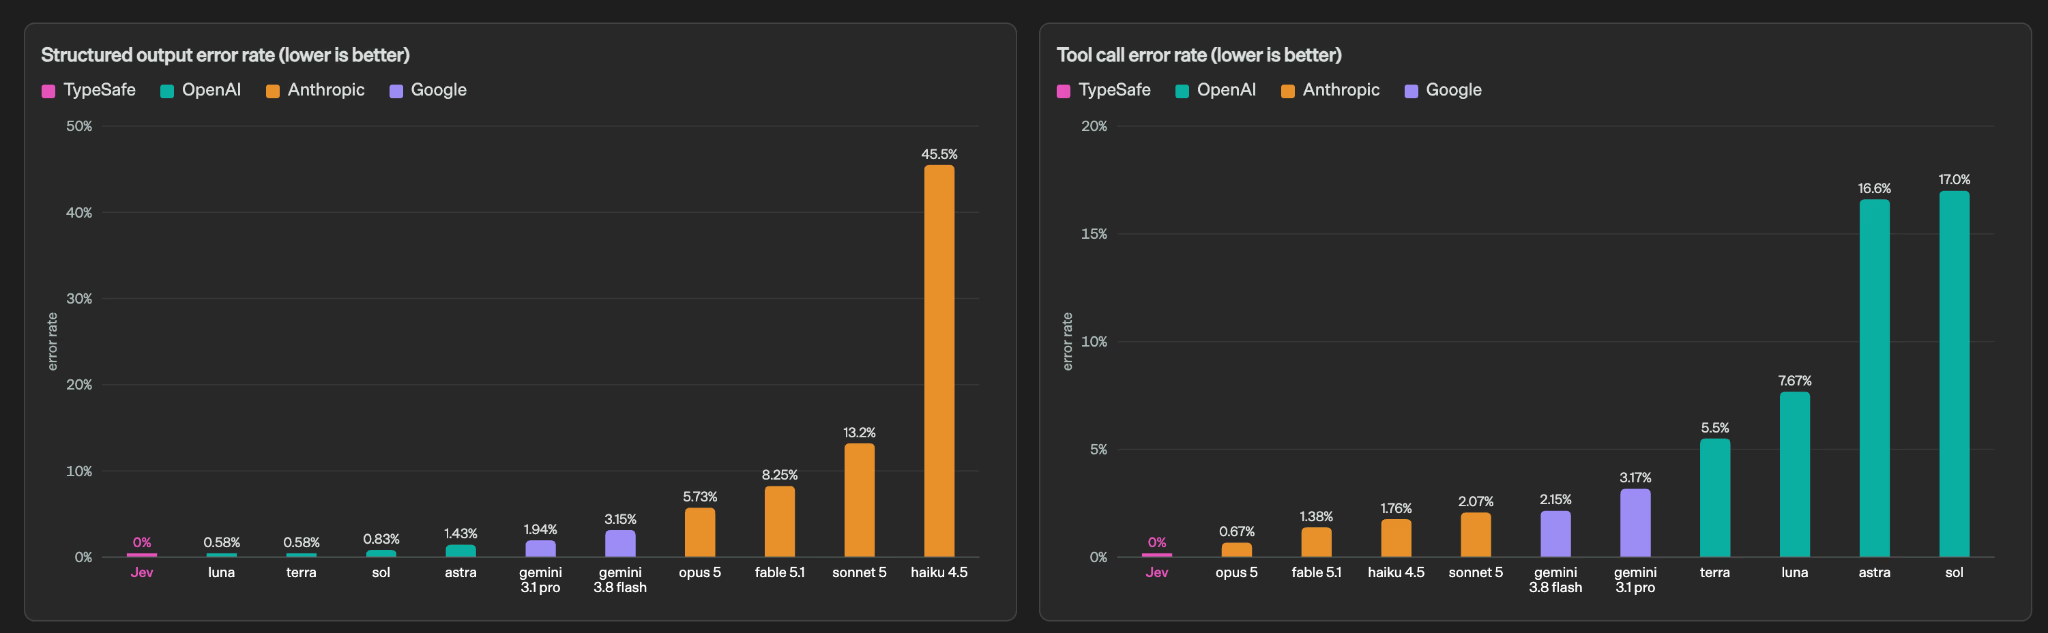
La sortie est typée et déclarée avant l'appel. Vous définissez la forme de chaque question à l'avance. Le modèle ne peut répondre qu'à l'intérieur de cette forme, il n'y a donc rien à analyser et aucune incohérence de schéma à détecter. Le mot de TypeSafe pour cela est que Jev « ne fait jamais d'erreurs de type ».
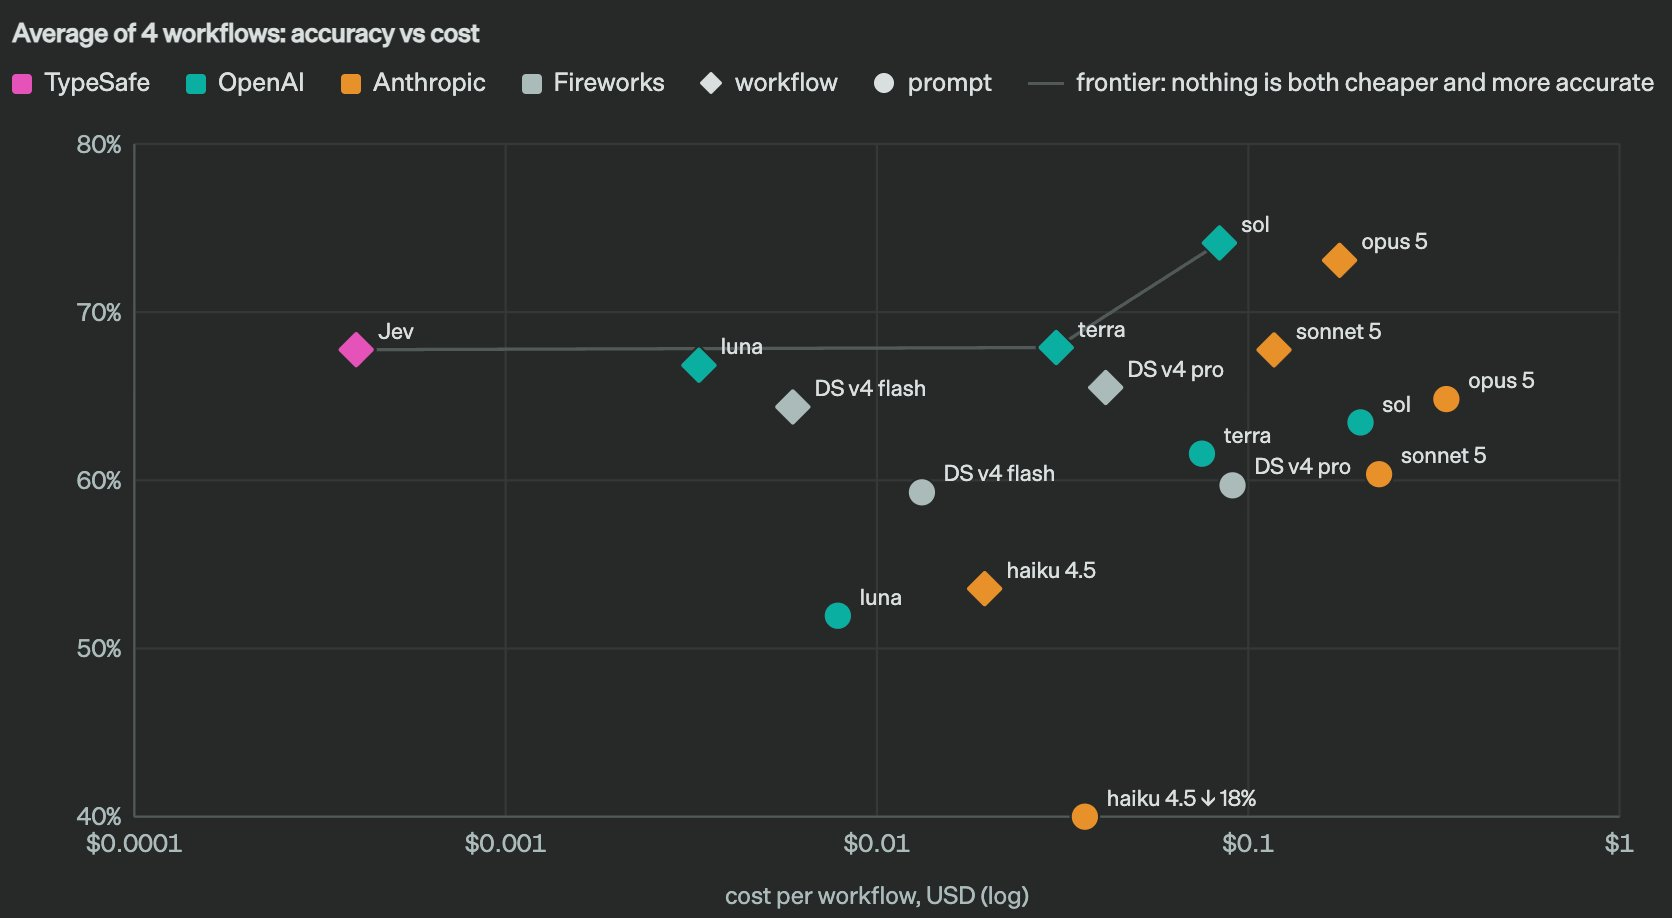
Chaque réponse est accompagnée d'une probabilité. Une question oui/non ne renvoie pas `true` ; elle renvoie un nombre comme `0.97`. Un choix renvoie la distribution complète sur les options. TypeSafe a entraîné le modèle avec une méthode qu'il appelle l'Apprentissage par Renforcement pour les Décisions Calibrées, et l'affirmation est qu'une confiance plus élevée signifie une précision plus élevée, vous pouvez donc seuiller : automatiser les cas clairs, acheminer les cas incertains vers un humain.
Les questions sont répondues en parallèle, en une seule requête. Un modèle linguistique produit un jeton à la fois. Jev évalue toutes les questions déclarées simultanément par rapport au même état, c'est pourquoi TypeSafe annonce des temps de réponse de bout en bout de 70 ms à 500 ms. Ce sont les chiffres du fournisseur ; traitez-les comme une affirmation à vérifier par rapport à votre charge de travail, et non comme une référence.
Comment Jev diffère d'un modèle linguistique
| Modèle linguistique | Jev | |
|---|---|---|
| Sortie | Texte libre que vous analysez | Valeurs typées que vous avez déclarées |
| Échantillonnage | Séquentiel, jeton par jeton | Toutes les questions en parallèle |
| Confiance | Non exposée par défaut | Une probabilité sur chaque réponse |
| Meilleur pour | Écrire, discuter, résumer | Décider, acheminer, noter, vérifier |
| Entrée | Messages | État structuré : une chaîne, un objet ou un tableau |
| Images | Souvent supportées | Texte seulement, pour l'instant |
Le compromis est explicite : Jev abandonne entièrement la génération de chaînes de caractères. Ce n'est pas un modèle de chat et il ne résumera pas un document. Sa place est celle de la « instruction conditionnelle intelligente » au sein d'une application : quelle équipe gère ce ticket, quelle est la gravité de ce bug, cette réponse est-elle sûre à envoyer, la compilation a-t-elle réussi.
Les trois types de questions
L'API directe de Jev expose trois primitives. Chacune est un objet JSON sous une clé que vous choisissez.
Noul : une probabilité oui/non. Nom de TypeSafe pour le type booléen. Il renvoie la probabilité que la réponse soit oui, et vous la seuillez dans le code.
{ "is_urgent": { "type": "noul", "instructions": "Does this message express urgency?" } }
Réponse : ` { "type": "noul", "noul": 0.99 }`.
Choix : sélectionnez une option parmi un ensemble nommé. `criteria` associe des noms d'options à des descriptions, jusqu'à 255 options. La réponse contient la meilleure sélection ainsi que la distribution complète et un chiffre de confiance.
{ "department": { "type": "choice", "instructions": "Which team should handle this?",
  "criteria": { "billing": "Charges, invoices, payment problems",
                "shipping": "Delivery status, delays, lost packages",
                "returns":  "Exchanges, refunds, damaged items" } } }
Réponse : ` { "type": "choice", "choice": "returns", "confidence": 1.0, "probabilities": { "returns": 1.0, "shipping": 0.0, "billing": 0.0 } }`.
Score : une position sur une échelle ordonnée. `criteria` est un tableau de 2 à 10 descriptions de niveaux, du plus bas au plus haut. Le score est la position pondérée par la probabilité, il peut donc se situer entre les échelons.
{ "bug_severity": { "type": "score", "instructions": "How severe is the reported issue?",
  "criteria": [ "Cosmetic; no impact to functionality",
                "Broken feature, but a workaround exists",
                "Blocking issue; no workaround" ] } }
Réponse : ` { "type": "score", "score": 1.3, "confidence": 0.54, "probabilities": { "0": 0.0, "1": 0.7, "2": 0.3 }, "legend": { "0": "Cosmetic...", "1": "Broken...", "2": "Blocking..." } }`.
Une petite différence de nom : via le SDK Vercel AI, le type oui/non est appelé `boolean` et le champ de réponse est `probability`. Avec l'API propre de TypeSafe, c'est `noul`. Même idée, clé différente.
Deux façons d'appeler Jev
Directement. Obtenez une clé sur console.typesafe.ai/settings/keys, puis envoyez `POST https://api.typesafe.ai/v1/systemone` avec un jeton `Bearer`. L'ID du modèle est `jev-latest`, qui se résout actuellement en `jev-1.13.0` ; `jev-preview` pointe vers la version la plus récente, officielle ou non. Des SDK Python et JavaScript existent, selon le guide de démarrage rapide, mais le point d'accès brut est un simple POST, que nous utiliserons dans Apidog.
Via Vercel AI Gateway. L'ID du modèle est `typesafe-ai/jev` et vous l'appelez avec `experimental_evaluate` du SDK AI (version 7 ou ultérieure). Une mise en garde des documents d'évaluation : l'évaluation est disponible uniquement via le SDK AI, et non via les points d'accès compatibles OpenAI ou Anthropic de la passerelle. Si vous routez déjà des modèles via la passerelle, comme dans notre présentation de GPT-5.6 Sol sur AI Gateway, c'est le chemin naturel ; notre guide du SDK Vercel AI couvre la configuration.
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: { refunded: { type: 'boolean', instructions: 'Was a refund issued?' } },
});
// result.answers.refunded -> { type: 'boolean', probability: 0.99 }
Votre première requête avec curl
Ceci trie un message de support avec les trois types en un seul appel :
export TYPESAFE_API_KEY="..."

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My card was charged twice for one order and I need this fixed today.",
    "questions": {
      "department": { "type": "choice", "instructions": "Which team handles this?",
        "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
      "urgency": { "type": "score", "instructions": "How urgent is this?",
        "criteria": ["low", "medium", "high"] },
      "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
    }
  }'
La réponse contient `model`, un objet `answers` indexé par vos IDs de question, et `usage` avec `input_tokens` et `output_tokens`. Lisez `answers.department.choice`, `answers.urgency.score` et `answers.wants_refund.noul`, puis appliquez vos seuils.
Tester et simuler Jev dans Apidog
Un modèle qui renvoie des probabilités change l'apparence d'un test. Vous n'affirmez plus une chaîne de caractères ; vous affirmez qu'un nombre dépasse un seuil. Apidog en fait une vérification enregistrée et répétable plutôt qu'une commande curl unique.
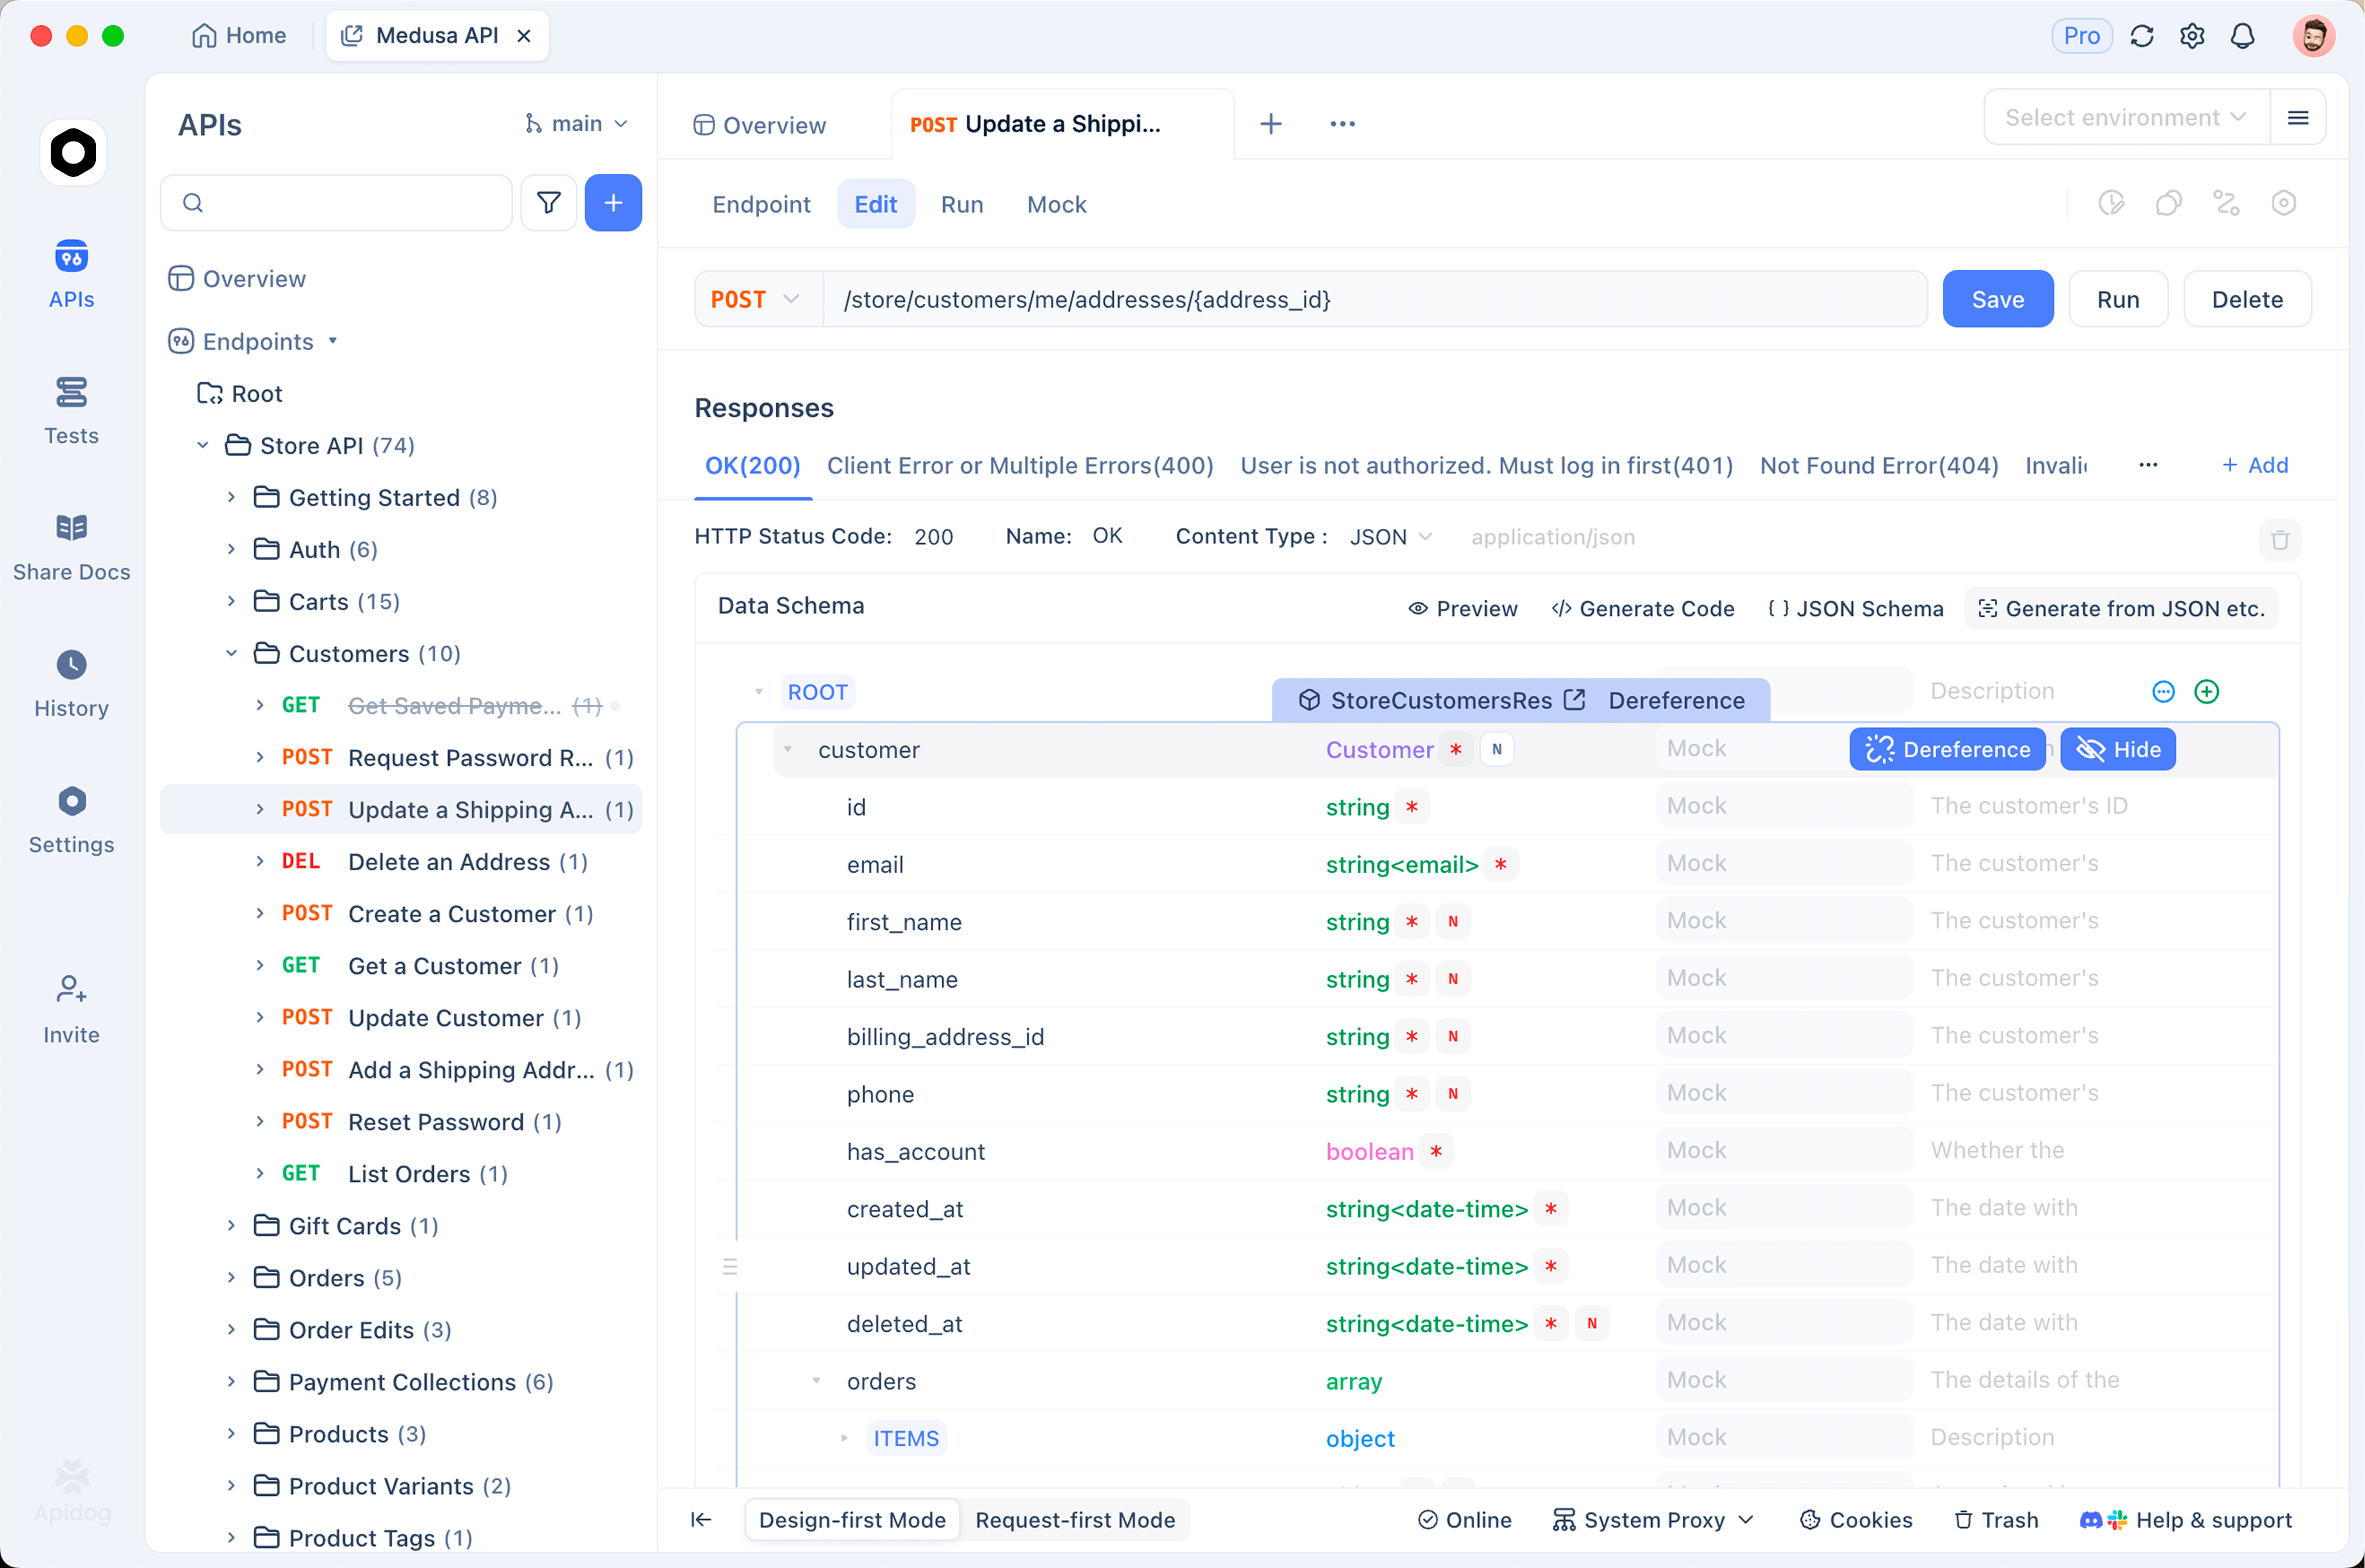
Stockez la clé. Ouvrez la Gestion de l'environnement, créez un environnement nommé `TypeSafe`, et ajoutez `TYPESAFE_API_KEY` avec la valeur réelle dans le champ local, afin qu'elle reste sur votre machine et ne soit jamais synchronisée avec l'équipe. Notre guide sur les environnements et variables secrètes couvre les règles de portée.
Construisez la requête. Nouvelle requête, `POST https://api.typesafe.ai/v1/systemone`, type d'authentification Bearer Token avec `{{TYPESAFE_API_KEY}}`, corps JSON de l'exemple curl. Envoyez-la et lisez les réponses dans le panneau de réponse.
Affirmez la décision, pas le texte. Ajoutez des assertions de post-traitement telles que `answers.department.choice` est égal à `billing`, `answers.wants_refund.noul` est supérieur à `0.9`, et `answers.urgency.score` est supérieur à `1.5`. Désormais, une régression dans le comportement de Jev, ou dans votre propre formulation de critères, fera échouer un test au lieu de mal acheminer silencieusement les tickets.
Simulez-le pour le frontend. Enregistrez la réponse comme une simulation, et votre interface utilisateur de tickets pourra être construite et démontrée avec un objet `answers` stable, sans dépenser de jetons ni attendre le modèle. Étant donné que la forme est déclarée, la simulation et la réponse réelle ne peuvent pas diverger.
Enregistrez-le comme un scénario. Enchaînez quelques états, un message calme, un message en colère, un message ambigu, et affirmez que la confiance diminue dans le cas ambigu. C'est la vérification qui vous indique que votre seuil fait son travail. Téléchargez Apidog pour le configurer ; le plan gratuit couvre une équipe de quatre personnes.
Tarification, limites et erreurs
De la page des modèles de TypeSafe :
- Prix : 0,042 $ par million de jetons en entrée. Les jetons en sortie ne sont pas facturés. La passerelle affiche le même prix de 0,042 $ par million en entrée.
- Limites de débit : 250 000 jetons par seconde et 1 200 requêtes par minute, ajustées dynamiquement.
- Contexte : 64k jetons par requête, dont 32k pour le `state` plus la question la plus longue.
- Entrée : texte seulement. Une chaîne, un objet JSON ou un tableau de texte. Pas d'images, d'audio ou de vidéo.
- Langue : L'anglais est préférable ; d'autres langues fonctionnent avec une précision moindre.
Les erreurs sont renvoyées sous forme de codes de statut HTTP : `401` pour une clé manquante ou invalide, `422` lorsque le corps échoue à la validation (un Score avec un seul niveau, un Choix sans critères), `429` pour les limites de débit, et `529` lorsque le service est surchargé. Reculez et réessayez sur les deux derniers ; les SDKs le font par défaut.
FAQ
Jev remplace-t-il un LLM ?
Non. Il remplace la partie d'un appel LLM où vous demandiez une décision et analysiez du texte pour l'obtenir. La génération, le chat et la synthèse nécessitent toujours un modèle linguistique.
Jev peut-il halluciner ?
Il peut se tromper, mais il ne peut pas produire de réponse en dehors du schéma que vous avez déclaré. L'argument de TypeSafe est que la correspondance de schéma est garantie, donc une étiquette « hallucinatoire » est impossible ; une étiquette erronée avec une faible confiance reste possible, c'est pourquoi la probabilité est importante.
Que signifie « calibré » en pratique ?
Si le modèle dit `0.9`, il devrait être correct environ 90 % du temps pour ce type de question. C'est ce qui vous permet de choisir un seuil et d'automatiser au-delà. Testez-le sur vos propres données avant de faire confiance au chiffre ; un scénario enregistré dans Apidog avec des états étiquetés est un moyen peu coûteux de le faire.
Ai-je besoin de Vercel pour utiliser Jev ?
Non. L'API directe sur api.typesafe.ai fonctionne seule avec une clé Bearer. Vercel AI Gateway est une commodité si vous utilisez déjà le SDK AI, et c'est la seule route qui supporte `experimental_evaluate`. Dans tous les cas, les bases de JSON Schema derrière les formes déclarées méritent d'être connues.
Où Jev s'intègre
Faites appel à Jev lorsque la question a un ensemble fixe de réponses et que vous avez besoin d'une probabilité : routage, classification, notation, vérification, garde-fous. Gardez votre modèle linguistique pour tout ce qui nécessite des mots. Déclarez la forme, testez les seuils dans Apidog, et laissez le chiffre de confiance décider ce qui est automatisé.