
Grok 4.6 est le modèle linguistique de pointe de xAI, lancé le 12 août 2026. Il s'appuie sur Grok 4.5 en se concentrant sur les agents de longue durée, le codage agentique et le travail interactif ou visuel, offrant une fenêtre contextuelle de 500 000 jetons à 2 $ par million de jetons d'entrée et 6 $ par million de sortie. Sur l'indice d'intelligence d'Artificial Analysis, il obtient un score de 61, égalant le GPT-5.6 Sol d'OpenAI et se classant un point derrière le Claude Fable 5 d'Anthropic, ce qui en fait le modèle le moins cher actuellement à la pointe de l'intelligence.
C'est la réponse en un paragraphe. Le reste de cet article couvre ce qui a réellement changé par rapport à Grok 4.5, ce que signifient les chiffres de référence, où vous pouvez utiliser le modèle aujourd'hui, et ce que cela signifie pour vous si vous développez avec des API LLM. Si cette dernière partie vous concerne, Apidog vous offre un espace de travail gratuit pour concevoir, tester et simuler des appels d'API LLM, pratique pour tester Grok 4.6 sans écrire de client au préalable.
TL;DR
- Lancé : 12 août 2026, par xAI.
- Objectif : agents à long terme, codage multi-étapes, travail interactif et visuel. xAI affirme que le modèle s'auto-teste et vérifie son propre travail plus souvent avant de continuer.
- Spécifications : fenêtre contextuelle de 500K, date de coupure des connaissances le 1er février 2026.
- Tarification : 2 $ / 1M en entrée, 6 $ / 1M en sortie. Une variante plus rapide coûte 2x. La première semaine inclut 2x l'utilisation dans Grok Build et Cursor.
- Benchmarks : Indice d'intelligence 61 (à égalité avec GPT-5.6 Sol), grands sauts par rapport à 4.5 sur DeepSWE (54 → 65.9) et APEX-Agents (47.1 → 57.5).
- Où l'utiliser : API xAI, Grok Build, Cursor, OpenRouter, Vercel et Cloudflare.
Grok 4.6 en un coup d'œil
| Spécification | Grok 4.6 |
|---|---|
| Développeur | xAI |
| Date de sortie | 12 août 2026 |
| Fenêtre contextuelle | 500 000 jetons |
| Date de coupure des connaissances | 1er février 2026 |
| Prix entrée / sortie | 2 $ / 6 $ par 1M de jetons |
| Variante rapide | 2x le prix |
| Indice d'intelligence | 61 (GPT-5.6 Sol : 61, Claude Fable 5 : 62) |
| Disponibilité | API xAI, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
Qu'est-ce qui est réellement nouveau par rapport à Grok 4.5
Grok 4.6 n'est pas une révélation d'architecture, c'est une histoire de formation. Selon xAI, le modèle a subi une période d'entraînement supplémentaire plus longue que Grok 4.5, avec trois éléments clés pour la tâche lourde :
- Données générées par le modèle, sélectionnées et ciblées sur le raisonnement et les concepts techniques avancés.
- Ensembles de données d'ingénierie de haute qualité, poursuivant le régime intensif de codage qui a commencé lorsque xAI a commencé à s'entraîner sur des sessions de développement réelles.
- Un optimiseur et une recette d'entraînement améliorés, avec des trajectoires de réglage fin supervisées régénérées dans les domaines du raisonnement et des spécificités de domaine.
Le changement de comportement que les développeurs remarqueront est l'auto-vérification. Pendant les longues exécutions agentiques, Grok 4.6 vérifie son propre travail avant de passer à l'étape suivante, exécutant le test qu'il vient d'écrire, relisant le fichier qu'il vient d'éditer, plutôt que d'avancer à toute vitesse sur une hypothèse non vérifiée. xAI rapporte également de meilleures premières tentatives sur les projets interactifs et visuels : les tableaux de bord, les petites applications et le travail d'interface utilisateur sont plus proches d'être utilisables dès le premier passage.
Si l'approche d'entraînement de Grok 4.5 vous a intéressé, notre analyse de ce que la formation de session Cursor signifiait pour les développeurs couvre la lignée sur laquelle ce modèle s'appuie.
Les benchmarks, avec des écarts significatifs
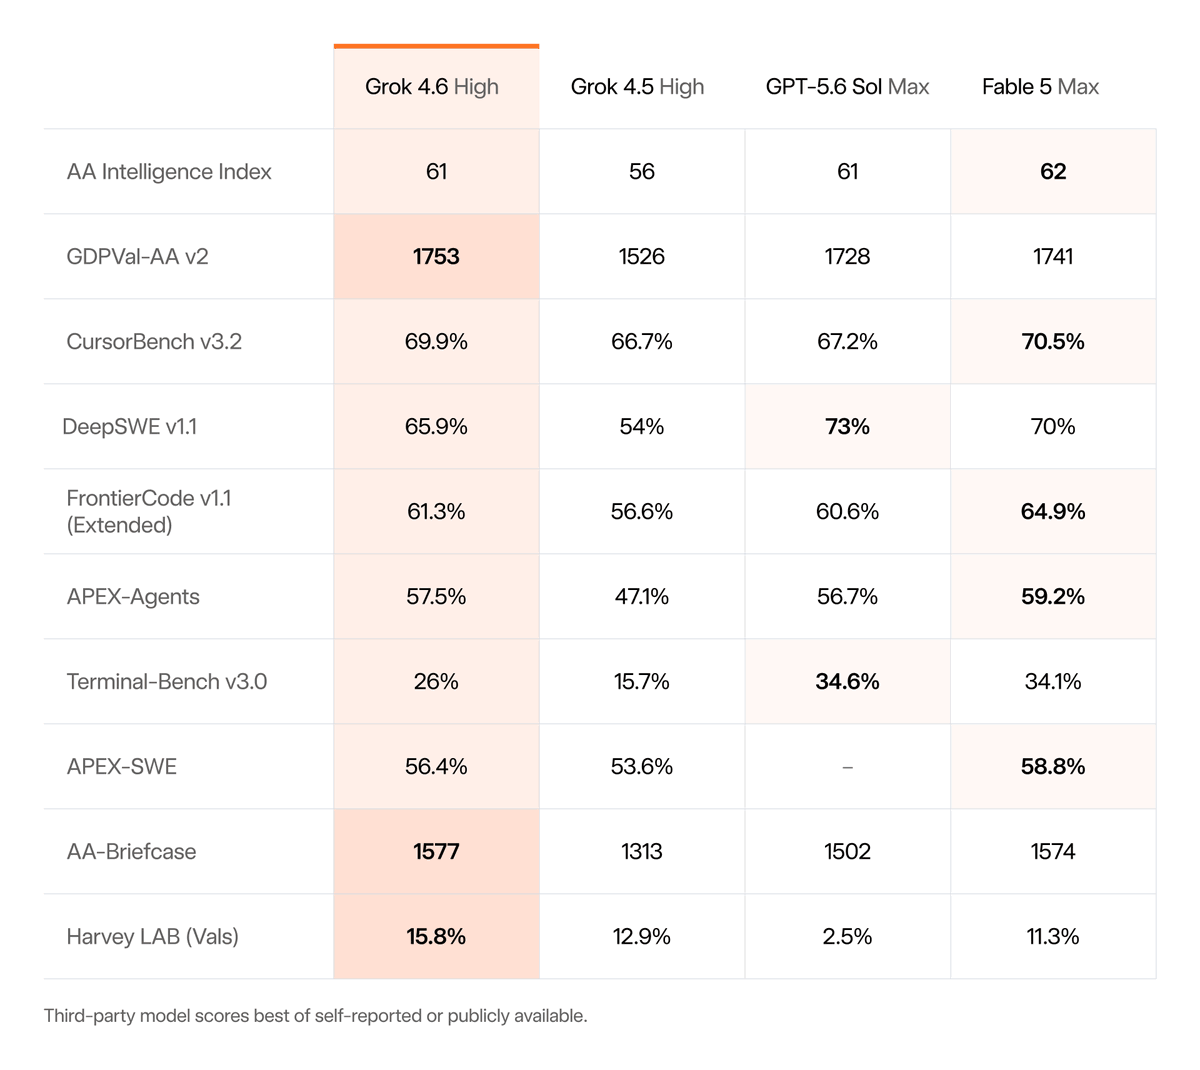
Les chiffres de lancement des fournisseurs méritent d'être considérés avec scepticisme, mais les écarts entre 4.5 et 4.6 sont suffisamment importants pour être significatifs. Voici le tableau, y compris la position de la concurrence :
Trois points clés :
- L'écart des agents s'est réduit. Le bond de 10,4 points sur APEX-Agents fait passer Grok de « clairement en retard » à moins de 1,7 point de Fable 5 Max, et légèrement devant GPT-5.6 Sol Max (56,7 %).
- Le codage à l'échelle du dépôt s'est le plus amélioré. L'augmentation de près de 12 points de DeepSWE fait la différence entre un modèle qui trébuche sur les modifications de plusieurs fichiers et un modèle qui est compétitif, bien que Sol Max domine toujours ce benchmark de loin.
- Des chiffres indépendants confirment l'histoire. Artificial Analysis a mesuré un coût moyen de 0,84 $ par tâche dans ses évaluations agentiques, le plus bas parmi les modèles de pointe, et un Elo de 1753 sur GDPval-AA v2 pour le travail de connaissance professionnel.
Pour comprendre comment lire les versions de benchmark de xAI, et les mises en garde qui s'appliquaient également à la génération précédente, consultez notre analyse des benchmarks de Grok 4.5.
Tarification : l'atout valeur de la frontière
Grok 4.6 a conservé la tarification de Grok 4.5 : 2 $ par million de jetons d'entrée, 6 $ par million de sortie. Face aux modèles avec lesquels il est désormais comparé, c'est un écart frappant :
| Modèle | Prix de sortie / 1M jetons |
|---|---|
| Grok 4.6 | 6 $ |
| Claude Opus 4.8 | 25 $ |
| GPT-5.6 Sol | 30 $ |
C'est une différence de 5x au niveau de la sortie par rapport à GPT-5.6 Sol pour un modèle qui l'égale sur l'indice d'intelligence composite. Des jetons bon marché ne signifient pas automatiquement des tâches bon marché ; une exécution plus faible qui nécessite une révision et une réparation coûte plus cher que sa facture de jetons, mais les données indépendantes de coût par tâche suggèrent que l'efficacité est réelle, et pas seulement un prix d'autocollant bas.
La variante plus rapide, à un prix 2x (4 $/12 $), est destinée à une utilisation interactive sensible à la latence. Et jusqu'au 19 août, les utilisateurs de Grok Build et Cursor bénéficient d'une utilisation 2x incluse pour tester le modèle.
Où vous pouvez utiliser Grok 4.6 aujourd'hui
- API xAI via console.x.ai, compatible OpenAI. Notre guide de l'API Grok 4.5 s'applique directement ; il suffit de changer le nom du modèle.
- Cursor, disponible en option de modèle ; Cursor a publié ses propres notes de lancement en même temps que xAI.
- Grok Build, l'espace de travail agentique propre à xAI, avec le bonus d'utilisation 2x de la semaine de lancement.
- OpenRouter, Vercel et Cloudflare, pour les équipes qui acheminent plusieurs modèles via une seule passerelle ; listé comme
x-ai/grok-4.6sur OpenRouter.
Il n'y a pas de déploiement grand public distinct à démêler ici : il s'agit d'une version axée sur les développeurs, et le moyen le plus rapide de l'évaluer est via l'API ou un IDE qui l'intègre déjà.
Limitations et questions ouvertes
Une évaluation de la semaine de lancement vous doit les mises en garde ainsi que les chiffres principaux :
- Les benchmarks sont principalement rapportés par le fournisseur. Artificial Analysis a publié des scores indépendants qui concordent globalement, mais les chiffres spécifiques de codage (DeepSWE, FrontierCode, CursorBench) proviennent du tableau de lancement de xAI. Les chiffres de lancement de Grok 4.5 n'ont été confirmés que partiellement lors des tests indépendants ; supposez également une certaine régression vers la moyenne ici.
- La fenêtre contextuelle est la plus petite à la frontière. 500K jetons couvre la plupart des charges de travail réelles, mais GPT-5.6 Sol offre 1,05M et Claude Fable 5 offre 1M. Si vous traitez des monorepos entiers ou d'énormes ensembles de documents en un seul appel, cet écart est significatif.
- Sol reste en tête là où c'est le plus difficile. Le déficit de 7 points sur DeepSWE signifie que le travail entièrement autonome sur de grandes bases de code existantes reste plus fort sur GPT-5.6 Sol Max, et c'est la charge de travail d'agent la plus économiquement précieuse.
- La maturité de l'écosystème est en retard. Le traitement par lots, les niveaux de mise en cache des prompts et les contrôles d'utilisation sur la plateforme xAI sont plus jeunes que les équivalents d'OpenAI et d'Anthropic. La compatibilité OpenAI couvre la majeure partie, mais pas la totalité.
Aucun de ces points n'est rédhibitoire. Ils définissent la place de Grok 4.6 : l'option rapport qualité-prix que vous évaluez sérieusement, pas le choix par défaut que vous adoptez sur la réputation.
Ce que cela signifie pour les développeurs d'API
La lecture stratégique : la frontière a maintenant un véritable concurrent en termes de prix. Jusqu'à cette version, égaler la sortie de niveau GPT-5.6 Sol signifiait payer 25 à 30 $ par million de jetons de sortie. Grok 4.6 le fait pour 6 $, ce qui change les calculs sur les boucles d'agents en particulier ; un agent qui effectue 40 appels de modèle par tâche ressent immédiatement une différence de prix de sortie de 5x.
Pratiquement, l'API compatible OpenAI signifie que l'évaluer coûte un après-midi, pas un sprint. Orientez votre client existant vers https://api.x.ai/v1, exécutez votre charge de travail réelle dessus et comparez. Configurez cette comparaison dans Apidog et vous pourrez conserver les requêtes GPT-5.6, Claude et Grok 4.6 côte à côte dans un seul projet, avec des environnements par fournisseur et des assertions vérifiant la qualité de la sortie, l'utilisation des jetons et la latence des trois, des preuves utiles avant de confier une charge de travail de production à l'un d'entre eux.
L'orientation agent du modèle augmente également les enjeux en matière de correction des appels d'outils. Si votre intégration Grok implique l'appel de fonctions, testez les charges utiles qu'il génère, et pas seulement le texte qu'il écrit.
FAQ
Qu'est-ce que Grok 4.6 en une phrase ? Le modèle de pointe de xAI d'août 2026, optimisé pour les agents de longue durée et le codage, avec une fenêtre contextuelle de 500K et des scores de benchmark de pointe à environ un cinquième du prix de sortie des concurrents.
Grok 4.6 est-il meilleur que GPT-5.6 ? Ils sont à égalité sur l'indice d'intelligence d'Artificial Analysis à 61. GPT-5.6 Sol Max est en tête sur le codage à l'échelle du dépôt (DeepSWE) ; Grok 4.6 prend l'avantage sur APEX-Agents et coûte environ 5 fois moins par jeton de sortie.
Quelle est la différence entre Grok 4.5 et 4.6 ? Même prix, même API, modèle significativement amélioré : +11,9 points sur DeepSWE, +10,4 sur APEX-Agents, et une nouvelle tendance à l'auto-vérification lors des tâches longues.
Puis-je essayer Grok 4.6 gratuitement ? Grok Build et Cursor incluent 2x l'utilisation pendant la semaine de lancement, et les méthodes de notre guide pour utiliser Grok 4.5 gratuitement s'appliquent en grande partie à 4.6.