
GPT-Live-1.1 est le modèle vocal full-duplex d'OpenAI, disponible dans l'API depuis le 20 novembre 2026. Il écoute pendant qu'il parle, confie le raisonnement et les appels d'outils à un modèle backend de votre choix, et se facture à la minute : 0,05 $ par minute active et 0,02 $ par minute en veille. On y accède via un seul endpoint, v1/live/sessions, et non via l'API Realtime.
Notre précédent article sur ce qu'est GPT-Live portait sur la fonction vocale de ChatGPT avant que les développeurs puissent l'appeler. Ce guide couvre le modèle côté API : les nouveautés, le tarif, le fonctionnement d'une session et la comparaison avec GPT-Realtime.
Qu'est-ce que GPT-Live-1.1 ?
GPT-Live-1.1 est un modèle vocal capable de tenir une conversation parlée en temps réel pendant qu'un modèle backend distinct se charge du raisonnement. Il accepte l'audio et le texte, renvoie de l'audio et du texte, et continue d'écouter pendant qu'il parle, ce qui permet aux interlocuteurs de l'interrompre ou d'ajouter des précisions en pleine phrase. Son identifiant de modèle est gpt-live-1.1, et il prend en charge le streaming et le function calling.
La page du modèle GPT-Live-1.1 le décrit comme un « modèle vocal full-duplex pour conversations multilingues ». Le full-duplex signifie que l'audio circule dans les deux sens simultanément, comme lors d'un appel téléphonique, et non comme avec un talkie-walkie où chaque partie doit attendre son tour.
L'autre pilier de sa conception est la délégation. GPT-Live détermine quand une requête nécessite un vrai traitement, l'envoie à un backend (un modèle Responses d'OpenAI ou votre propre agent), continue de parler pendant l'exécution, puis annonce le résultat à voix haute.
Ce qui change par rapport à GPT-Live-1
GPT-Live-1.1 conserve le même endpoint, la même tarification et le même ensemble de fonctionnalités que GPT-Live-1. Les changements concernent la qualité vocale et l'exécution des tâches. Voici ce qu'OpenAI indique dans la documentation du modèle et dans son annonce sur X :
| Domaine | GPT-Live-1 | GPT-Live-1.1 |
|---|---|---|
| Transcription de la parole | Point de référence | Plus précise, selon la page du modèle |
| Accent et voix selon les langues | Point de référence | Plus homogènes, selon la page du modèle |
| Sessions inactives | Tarif de veille indiqué sur sa page | Veille annoncée comme nouvelle option, 0,02 $/min |
| Exécution des tâches | Point de référence | « Exécute les tâches encore plus fiablement », selon l'annonce d'OpenAI |
| Endpoint | v1/live/sessions |
v1/live/sessions |
| Prix (actif) | 0,05 $/min | 0,05 $/min |
| Limites de débit | Sessions simultanées | Limite de sessions simultanées distincte |
OpenAI n'a pas publié de chiffres de benchmark pour les gains de transcription ou de fiabilité ; considérez-les donc comme des affirmations du fournisseur jusqu'à ce que vous les mesuriez vous-même. Par ailleurs, l'annonce d'OpenAI présente la veille comme une nouveauté de cette version, alors que la page de GPT-Live-1 liste désormais le même tarif de veille de 0,02 $.
Les deux modèles partagent le même endpoint et la même tarification : pour basculer, il suffit de définir le model de la session sur gpt-live-1.1. Réexécutez ensuite vos propres évaluations vocales pour confirmer les gains sur votre trafic.
Tarification de GPT-Live-1.1
GPT-Live-1.1 facture les sessions vocales à la durée, et non au token. Voici les tarifs de la page de tarification d'OpenAI, vérifiés le 20 novembre 2026 :
| Métrique | Prix |
|---|---|
| Temps de session actif | 0,05 $ par minute |
| Temps de session en veille | 0,02 $ par minute |
| Modèle backend et outils | Facturés séparément aux tarifs habituels du modèle utilisé |
Quelques détails de facturation à connaître pour estimer vos coûts :
- Facturation à la seconde. La durée n'est pas arrondie à la minute entière suivante.
- La veille est réservée au WebRTC. Le tarif réduit s'applique aux sessions WebRTC lorsque l'inférence est en pause.
- Frais d'initialisation. La création d'une session WebRTC est facturée 15 secondes pendant la configuration, créditées ensuite sur les frais de durée une fois la session active.
- Le backend constitue une deuxième facture. Les tokens Responses délégués et les appels d'outils sont également facturés.
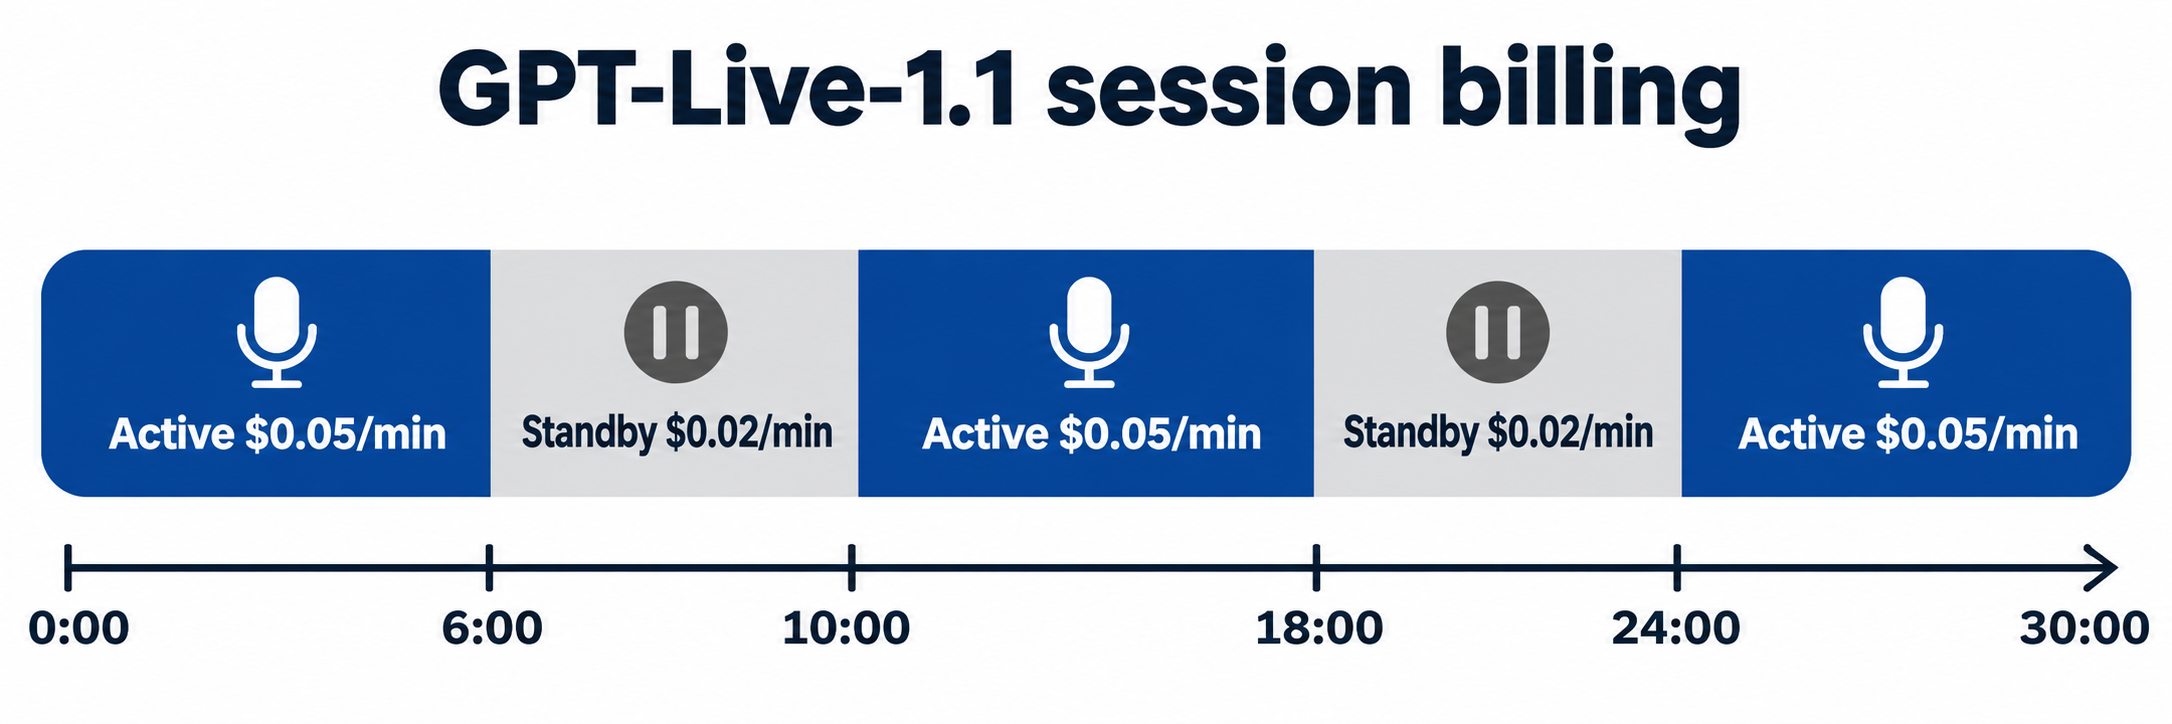
Exemple calculé à partir de la chronologie ci-dessus : une session d'assistance de 30 minutes passe 20 minutes en état actif et 10 minutes en veille pendant que l'appelant effectue une recherche. Coût vocal : 20 x 0,05 $ + 10 x 0,02 $ = 1,20 $. Sans veille, la même session coûterait 30 x 0,05 $ = 1,50 $. Ajoutez ensuite ce que le modèle backend dépense pour ses tâches déléguées.
Fonctionnement de GPT-Live-1.1 : voix plus délégation
Une application GPT-Live comporte deux volets. Le guide de démarrage les présente ainsi :
- GPT-Live gère la conversation. Il écoute, parle et décide quand solliciter le backend. Vous lui fournissez un prompt court décrivant le style de parole et les cas de délégation.
- Le backend traite les tâches déléguées. Il raisonne, appelle des outils et renvoie les résultats que GPT-Live énoncera. C'est là que résident les instructions détaillées, les règles métier et les workflows d'outils.
- Votre application gère les parties sensibles. Elle vérifie les permissions, collecte les confirmations, exécute les fonctions qui touchent à vos systèmes et sauvegarde l'avancement des tâches.
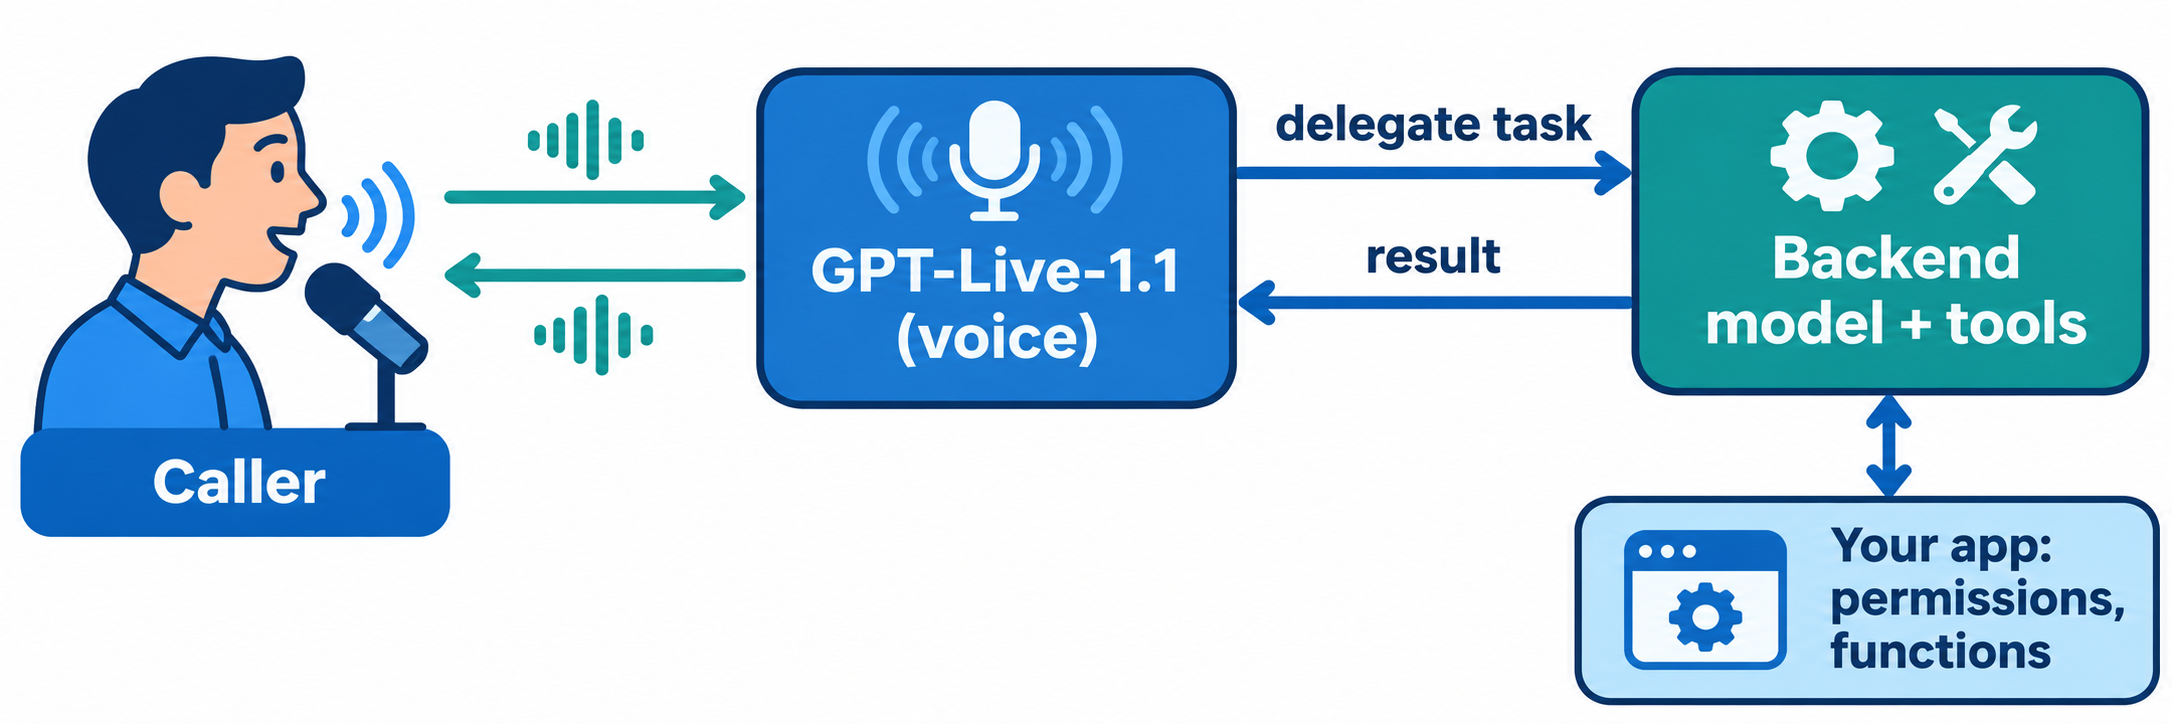
Vous choisissez l'un des deux modes de délégation à la création de la session, et il est impossible de changer de mode en cours de session :
| Mode | Qui exécute le backend | Quand le choisir |
|---|---|---|
| Délégation Responses | OpenAI appelle le modèle Responses que vous configurez et transmet le contexte et les résultats | Vous voulez que GPT-Live gère les requêtes backend pour vous |
| Délégation client | Votre application exécute n'importe quel modèle, agent ou service et renvoie les résultats | Vous devez valider, anonymiser ou combiner les résultats, ou utiliser un backend non OpenAI |
Le guide de la délégation recommande de commencer par la délégation Responses. La délégation client convient aux équipes qui ajoutent une interface vocale devant un agent textuel existant.
Créer votre première session GPT-Live-1.1
GPT-Live dispose de son propre endpoint. La page du modèle liste v1/live/sessions comme pris en charge et marque Chat Completions, Responses et v1/realtime comme non pris en charge. OpenAI recommande WebRTC pour l'audio, avec WebSockets et SIP comme alternatives.
Le flux WebRTC décrit dans le quickstart se déroule en cinq étapes :
- Le navigateur demande l'accès au microphone et ajoute ses pistes à une connexion pair à pair.
- Il crée un canal de données, puis génère une offre SDP.
- Le navigateur envoie l'offre à votre serveur.
- Votre serveur envoie
sessionettransport: { type: "webrtc", sdp }en POST versPOST /v1/live/sessionsavec votre clé API. - Le navigateur applique la réponse SDP renvoyée et attend
session.started.
Voici l'appel serveur de l'exemple TypeScript d'OpenAI, réduit à la configuration de session :
const result = await client.live.create({
  session: {
    model: "gpt-live-1.1",
    instructions:
      "Be concise. Delegate requests needing current information to the backend, which can search the web.",
    delegation: {
      type: "responses",
      responses: {
        model: "gpt-5.6-terra",
        instructions:
          "Use web search when current facts are needed. Return concise, grounded results for a spoken conversation.",
        tools: [{ type: "web_search" }],
        tool_choice: "auto",
      },
    },
  },
  transport: { type: "webrtc", sdp: request.body.sdp },
});
Conservez la clé API côté serveur, et n'envoyez pas session.start sur le canal de données : la requête HTTP démarre déjà la session. OpenAI propose également l'OpenAI Live Console, une application d'exemple locale pour observer les conversations, la délégation et l'activité des outils du backend.
Mode veille : réduire les coûts au repos
La veille maintient une connexion WebRTC ouverte quand personne ne parle, puis reprend l'inférence dès qu'une voix se fait entendre. La connexion et l'identifiant de session restent les mêmes, et l'historique de la conversation est restauré à la reprise de la session.
Vous l'activez avec deux champs de session :
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 20
  }
}
wake_policy.type: "speech"attend une détection de parole avant de démarrer l'inférence.idle_timeout_sprend un nombre entier entre 5 et 60. Après ce nombre de secondes sans transcription entrante ni sortante, la session passe en veille.vad_thresholdva de 0 à 1 et vaut 0,5 par défaut. Plus la valeur est élevée, plus la preuve de parole doit être marquée pour réveiller la session.
Écoutez les événements session.paused et session.resumed pour suivre l'état, et gardez la piste micro active. Un compromis à connaître, indiqué dans le guide de gestion des sessions : la première réponse à une courte énonciation après une sortie de veille peut être plus lente. Pour de longues interruptions, fermer la session et en ouvrir une nouvelle peut coûter moins cher que la veille.
GPT-Live-1.1 vs GPT-Realtime
Le guide des agents vocaux d'OpenAI présente le choix sous l'angle de l'architecture. GPT-Live convient aux conversations full-duplex avec un backend séparé. L'API Realtime convient à un modèle unique qui entend, raisonne, appelle des outils et parle au sein d'une même session.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Endpoint | v1/live/sessions |
v1/realtime |
| Conception | Frontal vocal plus backend délégué | Un seul modèle speech-to-speech |
| Entrées | Audio, texte | Texte, audio, image |
| Facturation | 0,05 $/min actif, 0,02 $/min en veille | Au token : 32 $ en entrée, 64 $ en sortie par 1M de tokens audio |
| Coût du backend | Facturé séparément | Inclus dans le prix au token |
| Idéal pour | Ajouter la voix à un agent textuel existant | Agents vocaux autonomes |
La facturation à la minute rend les coûts vocaux de GPT-Live faciles à prévoir sur de longs appels. La facturation au token de Realtime suit le volume d'audio et de texte échangé et intègre le raisonnement dans un prix unique. Pour un examen plus approfondi de la comparaison initiale, consultez GPT-Live vs GPT-Realtime et notre guide de l'API GPT-Realtime-2.
Limites de débit et accès
Les limites de GPT-Live comptent les sessions simultanées, et non les tokens. GPT-Live-1.1 et GPT-Live-1 ont des limites distinctes qui s'appliquent à toutes les régions d'inférence. La page de GPT-Live-1 indique 50 sessions simultanées au niveau Build, 300 au niveau Launch et 500 au niveau Grow, et marque le niveau Free comme non pris en charge. La page de GPT-Live-1.1 ne publie pas encore son propre tableau ; vérifiez donc la page des limites de votre organisation avant de planifier votre charge.
Tester votre serveur de sessions avec Apidog CLI
Votre intégration GPT-Live comporte une surface HTTP qui vous appartient : l'endpoint /api/session qui échange les offres SDP. L'exemple d'OpenAI renvoie 403 pour une origine inattendue et 400 pour une offre SDP manquante. Ces chemins ne passent jamais par OpenAI ; vous pouvez donc les tester à chaque commit sans aucun coût vocal. Laissez votre agent de codage écrire et exécuter les tests avec Apidog CLI.
Installez le CLI, connectez-vous et ajoutez la compétence Apidog à votre agent :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Donnez ensuite un seul prompt à votre agent :
In Apidog project <projectId>, add POST /api/session for my GPT-Live-1.1 server.
Create test cases that assert: a request with a wrong Origin header returns 403,
a request with no sdp field returns 400. Run them against the local environment
and summarize any failures.
L'agent lit les schémas, valide ses charges utiles, crée l'endpoint et les cas de test, puis les exécute :
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file ./endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
La même commande apidog run avec -r junit s'intègre au CI ; voir exécuter Apidog CLI dans un pipeline CI/CD. Si vous utilisez Claude Code, le guide Apidog CLI dans Claude Code détaille la configuration. Le plan Free d'Apidog couvre les équipes jusqu'à 4 utilisateurs.
FAQ
GPT-Live-1.1 est-il disponible dans l'API ? Oui. OpenAI a rendu GPT-Live-1.1 disponible dans l'API le 20 novembre 2026, avec l'identifiant de modèle gpt-live-1.1 sur l'endpoint v1/live/sessions. Notre précédent article sur l'API GPT-Live est antérieur à cette version.
Combien coûte GPT-Live-1.1 ? 0,05 $ par minute active et 0,02 $ par minute en veille, facturées à la seconde. Le modèle backend et l'utilisation des outils sont facturés séparément à leurs tarifs habituels.
Quelle est la différence entre GPT-Live-1 et GPT-Live-1.1 ? GPT-Live-1.1 transcrit la parole avec plus de précision, conserve un accent et une voix plus homogènes d'une langue à l'autre et ajoute une option de veille pour les sessions inactives. La tarification et l'endpoint restent identiques.
GPT-Live-1.1 peut-il voir des images ? Pas directement. Envoyez les images à un modèle backend capable de vision, qui renvoie du texte que GPT-Live pourra exploiter.
GPT-Live-1.1 prend-il en charge le function calling ? Oui. La page du modèle liste le streaming et le function calling. En pratique, votre backend traite les appels d'outils via la délégation, et votre application exécute les fonctions personnalisées.