
Le niveau le moins cher dans une famille de modèles était autrefois le niveau auquel vous ne faisiez pas confiance. Vous y envoyiez le trafic de classification, de résumé et de réessai, gardiez tout ce qui était "agentic" sur le modèle phare, et acceptiez que le modèle économique échoue dès qu'une tâche nécessitait plus d'une étape.
GPT-6 Luna, annoncé le 22 septembre 2026, est tarifé comme ce niveau mais ne se comporte pas comme lui. Il coûte 0,10 $ par million de jetons d'entrée et 0,50 $ par million de jetons de sortie, il dispose d'une fenêtre contextuelle d'un million de jetons, et les chiffres publiés par OpenAI le placent dans la fourchette des modèles de pointe sur les benchmarks de codage "agentic" à une petite fraction de leur coût par tâche.
Une chose à clarifier d'abord : il ne s'agit pas du GPT-5.6 Luna que vous avez peut-être déjà intégré dans une chaîne de secours. Même nom de niveau, nouveau modèle, nouveau prix, nouvelle fenêtre contextuelle. Supposer le contraire est un moyen facile de déployer un changement de comportement silencieux et de ne le découvrir que par un ticket de support.
GPT-6 Luna en un coup d'œil
| Élément | Valeur |
|---|---|
| ID du modèle API | gpt-6-luna |
| Prix d'entrée | 0,10 $ par million de jetons |
| Prix de sortie | 0,50 $ par million de jetons |
| Lectures d'entrée en cache | 90 % de réduction |
| Fenêtre contextuelle | 1 000 000 de jetons |
| Indice d'intelligence d'analyse artificielle | 37 |
| Annoncé | 22 septembre 2026, aux côtés de GPT-6 Sol |
| Disponible dans | ChatGPT Work et Codex, l'application de bureau pour les utilisateurs Free et Go, plus l'API |
| Non disponible dans | Chat, au moment du lancement |
Au sein de la même famille, GPT-6 Sol est à 2 $/10 $ avec une fenêtre de 872 000 jetons et un indice de 48, et GPT-6 Astra est à 10 $/50 $. OpenAI déclare qu'Astra "continue d'être notre meilleur modèle à tous égards", donc Luna n'est pas vendu comme le modèle le plus intelligent. Il est vendu comme celui où le coût par tâche s'est effondré.
C'est un nouveau modèle, pas un niveau renommé
La famille GPT-5.6 était Sol, Terra et Luna. La famille GPT-6 est Astra, Sol et Luna. Deux noms ont été conservés, Terra non, et Astra est nouveau. OpenAI décrit Sol et Luna comme ayant été entraînés avec des méthodes similaires à GPT-6 Astra, ce qui signifie qu'il s'agit de nouveaux modèles partageant une convention de nommage avec les anciens.
Il n'y a pas de GPT-6 Terra. Si vous avez construit une logique de routage autour du schéma de nommage GPT-5.6, l'échelon intermédiaire n'existe plus, et notre comparaison antérieure de Sol contre Terra et Luna se lit maintenant comme une histoire plutôt que comme une orientation actuelle.
La lignée des prix montre à quel point le niveau a évolué :
| Niveau | Liste GPT-5.6 | Promotionnel GPT-5.6 | GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | pas de GPT-6 Terra |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
Tous les chiffres sont par million de jetons d'entrée et par million de jetons de sortie. Les lignes GPT-5.6 proviennent de notre couverture de l'époque, tarification GPT-5.6 et la réduction de prix GPT-5.6.
OpenAI décrit Sol et Luna comme 50 % moins chers que les prix promotionnels du GPT-5.6. Le mot "promotionnel" est celui d'OpenAI et il change le sens de l'affirmation : la comparaison est faite par rapport à un taux réduit, et non au taux de lancement du GPT-5.6. Mesuré par rapport au prix catalogue de 1 $/6 $ du GPT-5.6 Luna, le GPT-6 Luna à 0,10 $/0,50 $ représente une réduction de 90 % sur l'entrée et de 92 % sur la sortie. La réduction réelle est plus importante que le titre, et le titre est mesuré à partir d'une remise. Mettez le deuxième chiffre dans votre modèle de budget, pas le premier.
Le modèle économique a la plus grande fenêtre contextuelle
C'est le détail que la plupart des couvertures de lancement ont ignoré. Luna est livré avec une fenêtre contextuelle d'un million de jetons. Sol, à vingt fois le prix, est livré avec 872 000.
Cela inverse une hypothèse que beaucoup de code de routage intègre : que vous promouvez une requête vers un modèle plus cher lorsque la charge utile augmente. Avec GPT-6, la plus grande fenêtre de la famille se trouve en bas de la liste de prix. Un document de 900 000 jetons ne rentre pas dans Sol et rentre dans Luna.
L'arithmétique découle des deux prix. Remplir la fenêtre complète de Luna une fois coûte 0,10 $ en jetons d'entrée. Remplir la fenêtre de 872 000 jetons de Sol une fois coûte environ 1,74 $. Remplir la fenêtre d'1 million de Claude Opus 5.5 à 4 $ par million coûte 4,00 $. Même classe de charge utile, un écart de quarante fois dans ce que vous payez pour la lire.
Ajoutez le travail de mise en cache d'OpenAI et l'écart se creuse à nouveau. GPT-6 applique une réduction de 90 % aux lectures d'entrée en cache, de sorte qu'un préfixe d'un million de jetons qui reste en cache entre les appels coûte environ 0,01 $ à relire au lieu de 0,10 $. OpenAI indique également que GPT-6 obtient des taux de succès de cache plus élevés par défaut, que la modification de l'effort de raisonnement ou de la disponibilité des outils n'invalide plus le cache, et que des points d'arrêt explicites vous permettent de contrôler où se termine un préfixe mis en cache. GitHub signale plus de 50 % de jetons d'invite en moins nécessitant un nouveau traitement sur des milliards de requêtes.
Ce qu'OpenAI a publié
Chaque chiffre ci-dessous provient du matériel de lancement d'OpenAI. Les paramètres d'effort de raisonnement apparaissent entre parenthèses, car ces modèles obtiennent des scores très différents à différents niveaux d'effort et une ligne de benchmark sans son paramètre d'effort n'est pas un nombre utilisable.
| Benchmark | GPT-6 Luna | Point de comparaison |
|---|---|---|
| DeepSWE 1.1 | 66.6% (max) | Comparable à Claude Opus 5 et Claude Fable 5 à un effort moyen, 93 % moins cher par tâche qu'Opus 5 et 96 % moins cher que Fable 5 |
| AutomationBench 1.0.6 | Dépasse son prédécesseur de 5,4 points (élevé) | À un coût par tâche 58 % inférieur |
| OSWorld 2.0 hors ligne | Dépasse GPT-5.6 Sol (moyen) à effort maximal | À environ un dixième du coût |
| Précision factuelle | Égale GPT-5.6 Sol à un effort plus élevé | À environ un centième du coût |
La ligne DeepSWE est celle à considérer. Un modèle à 0,10 $ par million de jetons d'entrée obtenant un score de 66,6 % sur un benchmark d'ingénierie logicielle "agentic", dans le même territoire que deux modèles de pointe à effort moyen, pour 93 % de moins par tâche que l'un d'entre eux, est une proposition différente d'un niveau économique. Cela ne signifie pas que Luna remplace un modèle de pointe pour votre travail le plus difficile. Cela signifie que la frontière entre "acheminer ceci vers le modèle bon marché" et "cela nécessite le modèle coûteux" a bougé, et que partout où vous avez tracé cette ligne avant septembre 2026, elle est maintenant tracée au mauvais endroit.
Le résultat de précision factuelle est celui qui a le plus de chances d'être important pour le travail produit ordinaire. Égaler le niveau intermédiaire de la génération précédente en matière de précision factuelle, à environ un centième de son coût, est ce qui rend Luna viable pour le résumé et l'extraction destinés aux utilisateurs plutôt que pour de simples tâches de traitement par lots internes.
Chaque comparaison ici est contre Claude Opus 5
Notez le modèle Claude contre lequel ces lignes sont comparées. Claude Opus 5.
Anthropic a livré Claude Opus 5.5 le même jour, à 4 $/20 $ contre 5 $/25 $ pour Opus 5, et il a pris la première place de l'Indice d'intelligence d'analyse artificielle à 58, classé premier sur 212 modèles. Le billet de lancement d'OpenAI a été rédigé avant l'existence d'Opus 5.5, de sorte que chaque comparaison de coût par tâche avec Opus 5 est mesurée par rapport à un modèle qui a été remplacé quelques heures après la publication.
Cela ne rend pas les chiffres d'OpenAI faux. Ils sont exacts pour la comparaison qui a été effectuée. Cela signifie que vous ne devriez pas inclure "93 % moins cher qu'Opus 5" dans un document d'approvisionnement comme état actuel du marché sans préciser à quel Opus il fait référence. Aucun fournisseur n'a publié de comparaison directe de Luna contre Opus 5.5, et les comparaisons circulant sur les réseaux sociaux proviennent de testeurs individuels plutôt que de l'un ou l'autre laboratoire. Notre pilier sur la guerre des prix suit les trois lancements les uns par rapport aux autres dans un seul tableau.
Latence : le modèle économique n'est pas le modèle rapide
Les mesures tierces d'Artificial Analysis placent GPT-6 Luna à 153,9 jetons de sortie par seconde avec un temps de première émission de jeton de 124,23 secondes. Deux mises en garde s'appliquent et les deux sont importantes. Ce sont des chiffres de tiers, non publiés par le fournisseur. Et ils sont mesurés sur la variante de raisonnement maximale, la configuration la plus lente et la plus chère disponible.
Même avec ces deux mises en garde, la direction est à retenir : Luna est plus lent au premier jeton que Sol, qui mesure 102,15 secondes. Le prix et la latence ne sont pas corrélés dans cette famille. Une attente de deux minutes avant l'arrivée du premier jeton rompra le délai d'attente par défaut d'un client HTTP, mettra en veille un équilibreur de charge et dépassera le plafond d'exécution de la plupart des runtimes sans serveur. Si vous acheminez un point de terminaison synchrone vers Luna à effort élevé, le travail d'intégration réside dans votre couche de timeout et de streaming, et non dans votre prompt.
Testez-le avec votre propre charge de travail avant de l'y acheminer
Les tableaux de benchmarks sont agrégés. Votre invite ne l'est pas. La question utile est de savoir si Luna tient le coup sur votre trafic à un niveau d'effort que vous pouvez vous permettre, et cela prend environ dix minutes pour y répondre correctement.
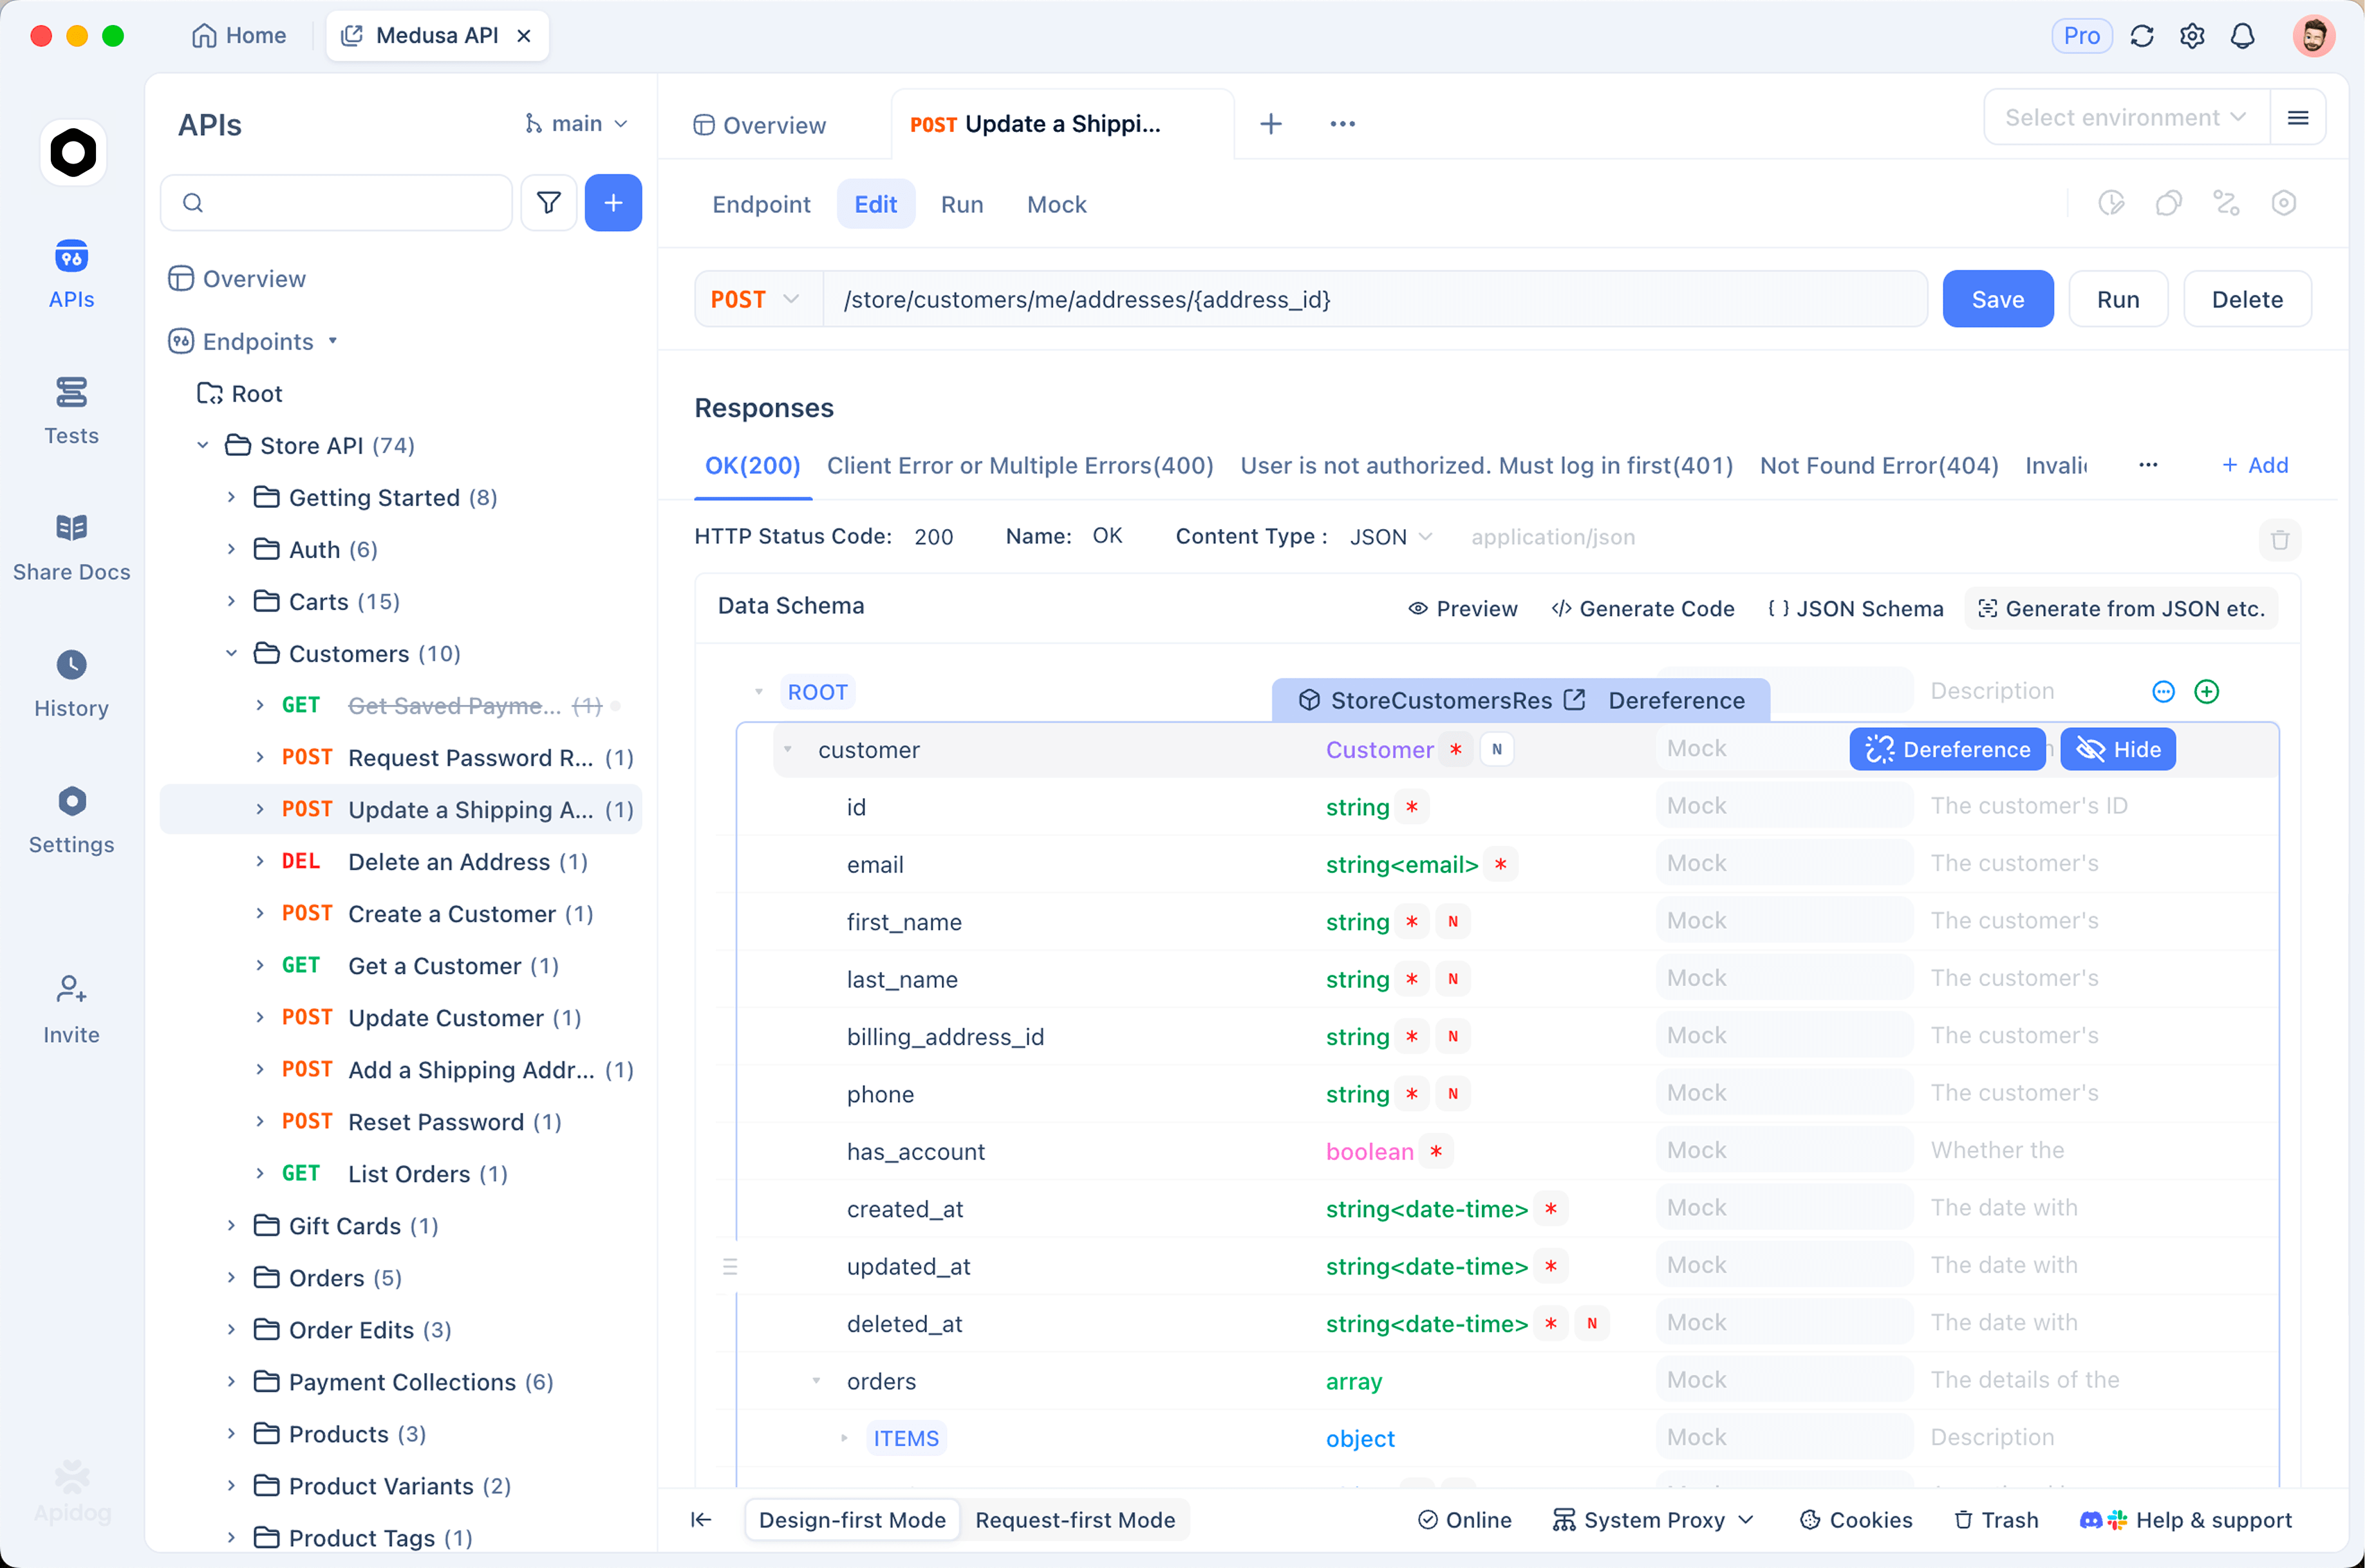
Configurez une requête par modèle, paramétrez l'ID du modèle et exécutez la même charge utile sur l'ensemble du niveau :
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Extract every endpoint, method and required parameter from the OpenAPI document below as JSON.",
    "reasoning": { "effort": "high" }
  }'
Confirmez le point de terminaison et les noms des paramètres par rapport à la référence de modèle actuelle d'OpenAI avant de construire sur cette forme. L'ID de modèle gpt-6-luna est la partie confirmée par le matériel de lancement.
Dans Apidog, la même requête devient un point de terminaison enregistré avec l'ID du modèle comme variable d'environnement, de sorte qu'une seule collection couvre Luna, Sol et Astra sans rien dupliquer. Exécutez-la comme un scénario de test et vous obtiendrez le temps de réponse et l'utilisation des jetons par exécution, ainsi que des assertions sur la forme de la réponse, ce qui est ce qui détecte le véritable mode de défaillance d'un modèle moins cher : non pas une mauvaise réponse, mais une réponse qui ne se conforme plus au schéma JSON attendu par votre analyseur. Exécutez le même scénario à trois niveaux d'effort et vous aurez un tableau de coûts, de latence et de fiabilité pour vos propres invites plutôt que pour la suite de benchmarks de quelqu'un d'autre.
Quand Luna est le bon choix
Acheminez vers Luna lorsque la charge utile est importante, la tâche est bien spécifiée et que vous pouvez vérifier la sortie de manière programmatique. L'extraction de documents, l'analyse de spécifications, le tri de journaux, la génération de tests, la classification à fort volume et tout travail par lots où une fenêtre d'un million de jetons vous évite un pipeline de découpage sont tous admissibles, et la réduction de mise en cache se compose lorsqu'un long préfixe reste stable entre les appels.
Gardez le niveau coûteux pour les tâches où vous ne pouvez pas vérifier la réponse à moindre coût, et pour tout ce qui est sensible à la latence tant que vous n'avez pas mesuré le temps du premier jeton sur votre propre trafic. Luna a déplacé la ligne. Elle ne l'a pas effacée.