
Gemini 4 Hydrogen est le modèle Gemini 4 rapide et économique de Google, sorti le 12 novembre 2026 et conçu pour le codage quotidien et le travail agentique. Il coûte 1,50 $ par million de tokens d'entrée et 7,50 $ par million de tokens de sortie sur un contexte de 1 M de tokens, propose quatre niveaux de réflexion (low, medium, high, xhigh) et est disponible sur le palier gratuit de l'API Gemini.
Si vous utilisez Gemini 3.8 Flash, Hydrogen est la mise à niveau recommandée par Google. Si vous payez pour Carbon ou Argon sur des étapes de routine, Hydrogen est destiné à les prendre en charge. Voici ce qui a été lancé, comment il s'intègre, et ce qui reste encore à découvrir.
Qu'est-ce que Gemini 4 Hydrogen ?
Gemini 4 Hydrogen (gemini-4-hydrogen) est le modèle axé sur la vitesse de la famille Gemini 4 de Google. Google le présente comme le « compagnon du quotidien pour les workflows agentiques » : un modèle qui écrit du code, appelle des outils, exécute des tests et lit des documents rapidement, seul ou en tant que moteur d'exécution sous un modèle de pointe comme Gemini 4 Carbon.
Les faits essentiels, tirés de l'annonce de lancement de Google et du guide « Quoi de neuf » d'AI Studio :
| Caractéristique | Gemini 4 Hydrogen |
|---|---|
| Identifiant du modèle | gemini-4-hydrogen |
| Date de sortie | 12 novembre 2026 |
| Tarif payant | 1,50 $ / 1 M d'entrée, 7,50 $ / 1 M de sortie (tarif uniforme sur tout le contexte) |
| Entrée en cache | 0,075 $ / 1 M de tokens via le cache implicite |
| Fenêtre de contexte | 1 048 576 tokens, partagés entre l'entrée, la réflexion et la sortie |
| Sortie par requête | 65 536 tokens en synchrone ; jusqu'à 1 M avec exécution en arrière-plan |
| Niveaux de réflexion | low, medium, high (par défaut), xhigh |
| Entrées | Texte, images, PDF, feuilles de calcul, graphiques, audio, vidéo |
| Palier gratuit | Oui, avec limites de débit, dans AI Studio et l'API Gemini |
| API | generateContent et l'API Interactions |
Les tokens de sortie incluent les tokens de réflexion, donc une requête au niveau xhigh coûte plus cher que la même requête au niveau low, même si la réponse visible a la même longueur.
Hydrogen vs Carbon vs Argon : quelle place occupe-t-il ?
Les trois modèles Gemini 4 partagent le même contexte unifié de 1 M, la même conception de décodage long et les mêmes outils intégrés. Ils se distinguent par la quantité de réflexion par tour et par leur coût.
| Hydrogen | Argon | Carbon | |
|---|---|---|---|
| Rôle | Exécution rapide, codage quotidien | La plupart des tâches à long terme, moins de tokens que Carbon | Modèle de pointe le plus puissant |
| Réflexion par défaut | high |
medium |
medium |
| Réflexion maximale | xhigh |
high |
high |
| Tampon non streaming | 65 536 tokens | 32 768 tokens (REST) | 32 768 tokens (REST) |
| Conseil de Google | Voie de mise à niveau depuis le 3.8 Flash | Tâches longues avancées | Architecture complexe, sécurité, science |
La recommandation de Google est de les associer : laisser Carbon planifier les interfaces ou démêler un bug difficile, puis confier à Hydrogen les modifications de code, le travail des sous-agents en parallèle et l'exécution des tests. Le changement de modèle au sein d'une même conversation fonctionne via previous_interaction_id dans l'API Interactions, sans modification du schéma de requête.
Pour une comparaison plus approfondie entre les deux modèles de pointe, consultez Gemini 4 Carbon vs Argon. Pour leurs coûts, voir les analyses des tarifs de Carbon et des tarifs d'Argon.
Les quatre niveaux de réflexion
Le niveau de réflexion d'Hydrogen est votre principal levier sur la vitesse, la qualité et les dépenses. Il se définit via le champ thinking_level, et Google recommande de commencer avec le niveau par défaut et de ne le modifier que si vos évaluations le justifient.
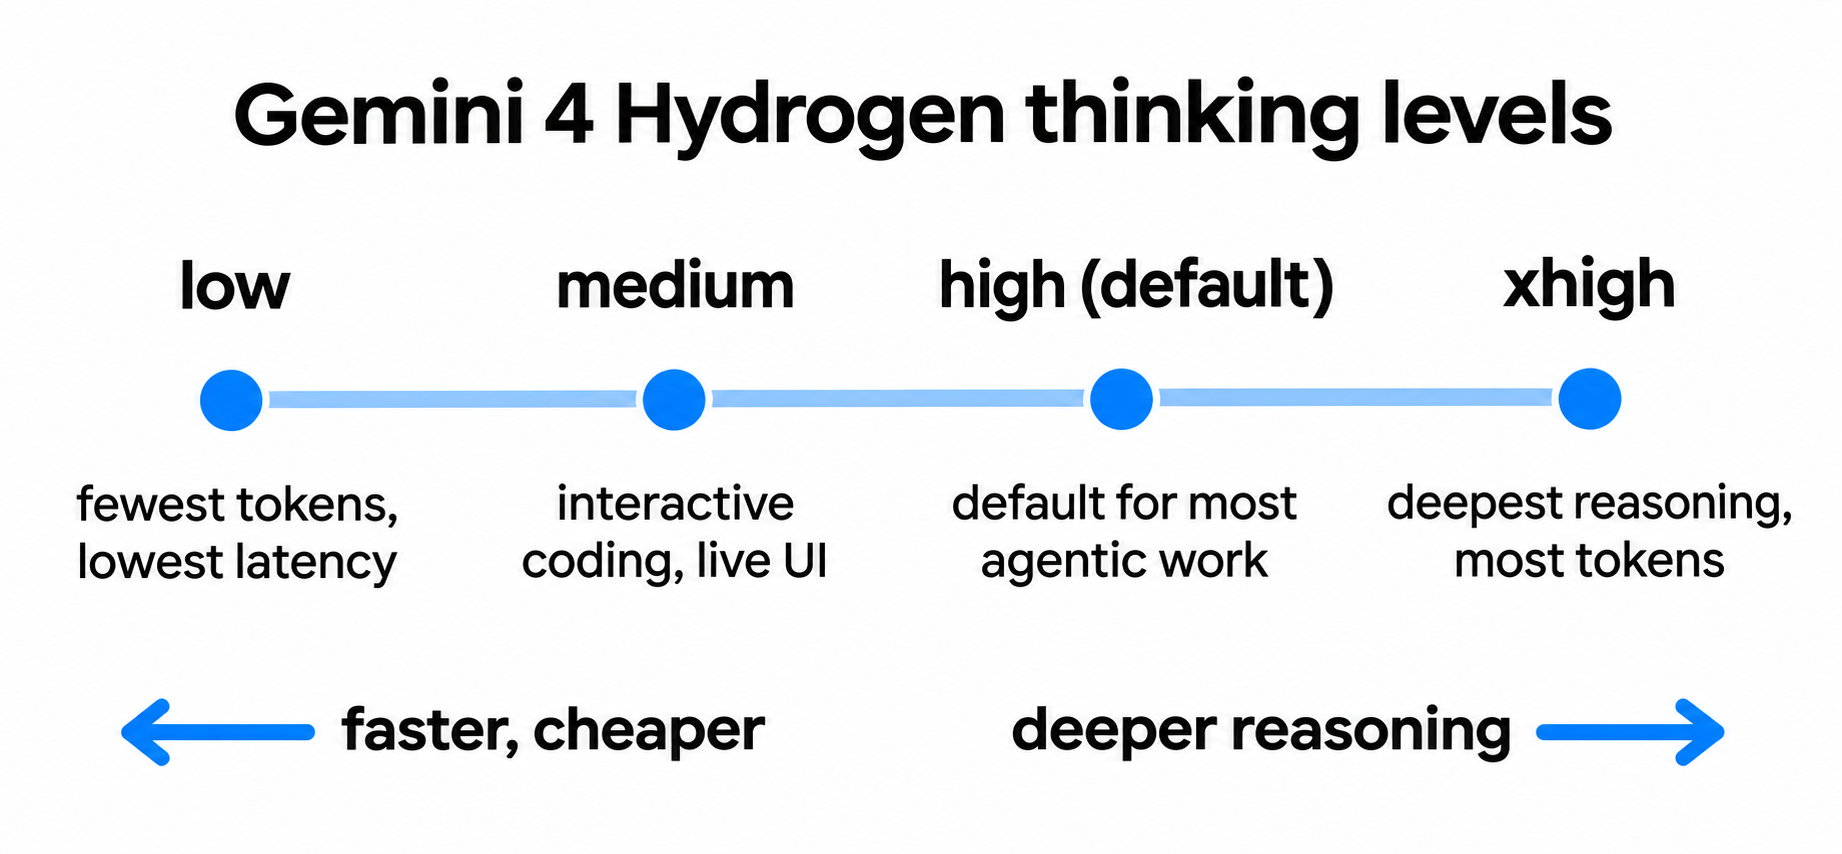
low: le moins de tokens, la latence la plus faible. Discussions rapides et traitement à haut débit.medium: codage interactif, prototypage d'interface en direct et appels d'outils sensibles à la latence.high(par défaut) : codage complexe, exécution agentique, appels d'outils et travail sur des documents multimodaux.xhigh: nouveau avec Hydrogen. Problèmes difficiles en plusieurs étapes oùhighne suffit pas.
Google avertit que xhigh peut sur-réfléchir sur des prompts simples, ajoutant de la latence et des tokens sans améliorer la réponse. Son conseil : exécuter votre suite d'évaluations aux quatre niveaux avec un max_output_tokens généreux, puis choisir le niveau le plus bas qui atteint votre seuil de qualité. Si vous migrez depuis le 3.8 Flash, notez qu'Hydrogen rejette minimal avec une erreur et utilise high par défaut plutôt que medium. Le guide des tarifs d'Hydrogen détaille le coût de chaque niveau.
Benchmarks de Gemini 4 Hydrogen
Tous les chiffres ci-dessous proviennent de Google et ont été publiés au lancement. Les réplications indépendantes étaient rares un jour après la sortie : considérez-les comme des affirmations du fournisseur.
Face à Argon et à ses propres réglages
- Indice d'intelligence d'Artificial Analysis : 51 au niveau
high, devant les 50 d'Argon, et 54 au niveauxhigh.
Face à Gemini 3.8 Flash
- 2,5 fois plus rapide au niveau par défaut
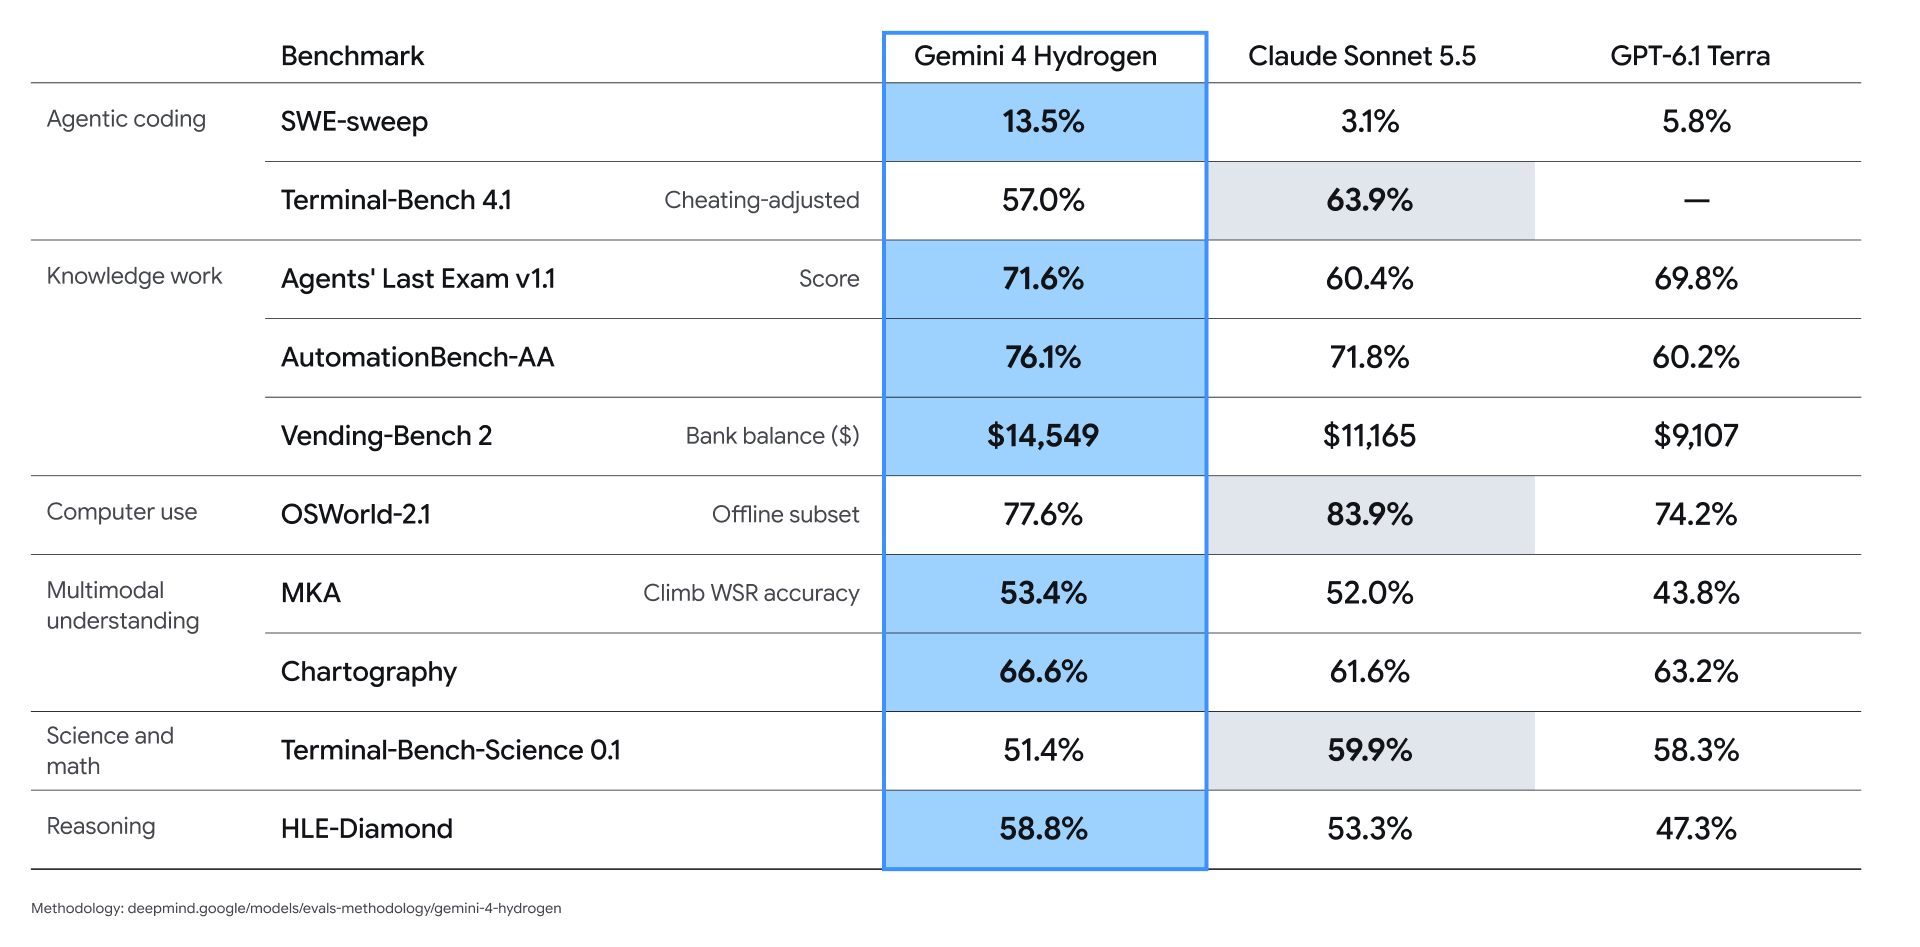
high. - Terminal-Bench 4.1 : 57 % contre 18,2 %.
- Plus de 5 fois moins d'affirmations fabriquées.
- Les partenaires du lancement signalent des exécutions 2 à 2,8 fois plus rapides et 12 à 23 % de tokens en moins sur des charges de travail graphiques, SQL et gourmandes en données.
Travail agentique et domaines spécialisés
- HLE-Diamond : 58,8 %, ce que Google présente comme la meilleure performance de sa catégorie.
- Vals Tax Agent Bench : classé n° 1 avec 52,3 %.
- Vals Legal Research Bench : ex æquo n° 1 avec 55,8 %.
- Agent Arena (arena.ai) : n° 5.
- Multimodal Knowledge Agent (MKA) : 53,4 %.
- Agents' Last Exam v1.1 : 71,6 %.
Sécurité, selon Google
- Jusqu'à 81 % de sur-ingérence en moins et jusqu'à 79 % de sous-service en moins dans les tâches agentiques.
- 12 fois moins d'actions désalignées et de raccourcis de tâche sur les évaluations d'usage d'outils et de codage.
- 96,7 % à l'évaluation interne de Google sur l'honnêteté des agents.
- Plus de 2,3 fois plus résistant à l'injection indirecte de prompts sur le benchmark Gray Swan IPI.
La tendance globale compte plus qu'un score isolé : Hydrogen égale à peu près Argon en intelligence générale et constitue un bond important par rapport au 3.8 Flash sur le codage agentique. Testez-le sur votre charge de travail avant de lui faire confiance. La fiche technique du modèle contient les notes d'évaluation complètes de Google.
Où utiliser Gemini 4 Hydrogen dès aujourd'hui
Google a déployé Hydrogen dès le jour du lancement sur l'ensemble de ses produits pour développeurs, entreprises et grand public :
- API Gemini, Google AI Studio et Android Studio : tous les paliers, gratuits et payants. Le palier gratuit est soumis à des limites de débit ; le guide Hydrogen gratuit détaille ce que vous obtenez sans carte bancaire.
- Gemini pour les entreprises : via l'API, le menu de sélection de modèles, Antigravity, et Gemini dans Google Sheets pour les formules professionnelles éligibles.
- Application Gemini : dans le menu de sélection de modèles. Les utilisateurs gratuits n'accèdent à Hydrogen que par la sélection automatique du modèle, quand Gemini estime qu'il convient au prompt.
- Google Search : alimente les réponses pour tous les utilisateurs.
- Google Sheets : d'abord pour les abonnés Google AI Pro et Ultra.
- Google Antigravity : pour les abonnés payants Google AI Pro et Ultra.
Hydrogen est désormais aussi le modèle par défaut derrière l'agent Antigravity dans Gemini Managed Agents : quiconque appelle cet agent via l'API utilise donc déjà Hydrogen, sauf s'il configure un autre modèle.
Orchestrator : Hydrogen et Carbon dans une même session
Orchestrator est une nouvelle option de modèle dans Google Antigravity qui alterne entre Carbon et Hydrogen au sein d'une même tâche, dans les deux sens. Carbon explore et planifie, Hydrogen rédige les modifications, met à jour les paquets et exécute les tests ; quand Hydrogen rencontre une difficulté, il redonne la main à Carbon pour réparer le plan. Il remplace le routeur statique qui estimait la difficulté une seule fois à partir de votre premier prompt.
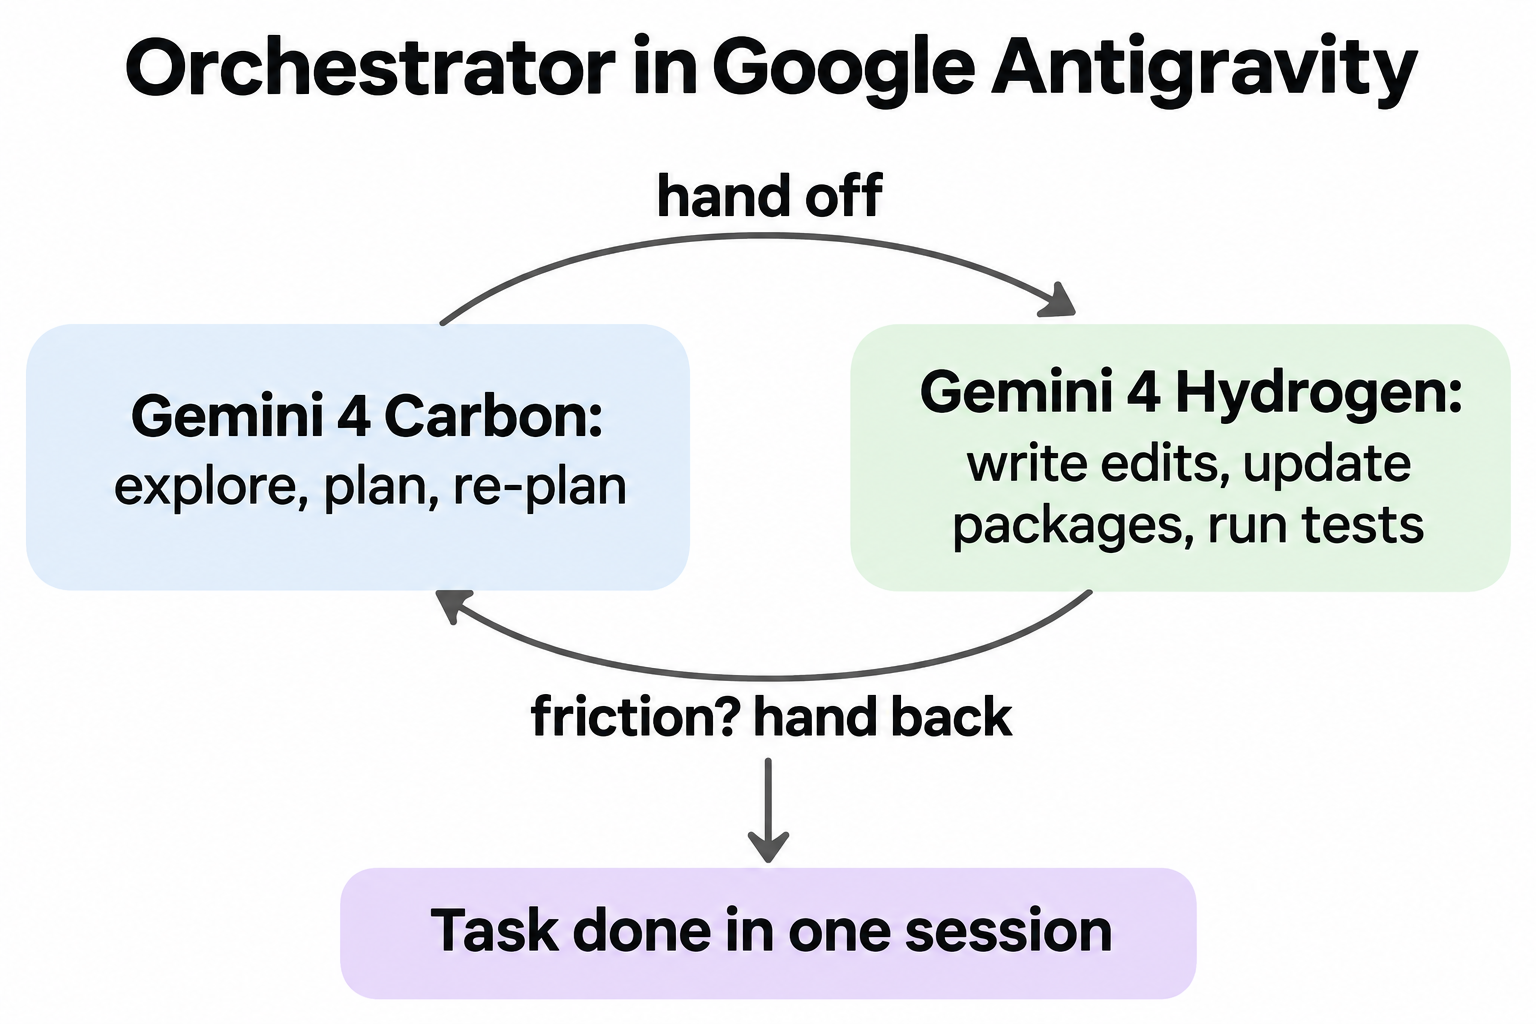
Sur Terminal-Bench, Google indique qu'Orchestrator a atteint des taux de réussite proches de Carbon tout en consommant 24 % de quota en moins et en terminant 19 % plus vite en moyenne. À noter : les deux articles de lancement de Google citent des versions différentes du benchmark pour ce résultat (4.0 dans l'article principal, 4.1 dans l'article Antigravity).
La disponibilité dépend du palier. Les abonnés Ultra obtiennent Orchestrator (Carbon) et Orchestrator (Argon) ; les abonnés Pro payants obtiennent Orchestrator (Argon). Si vous préférez câbler les rôles vous-même, le SDK Antigravity permet d'assigner explicitement des agents Hydrogen et Carbon. Le guide Gemini 4 Hydrogen Orchestrator va plus loin.
Limites et questions en suspens
Un jour après le lancement, tenez compte de ces points :
- Benchmarks auto-déclarés. Chaque chiffre ci-dessus provient de Google ou de ses partenaires de lancement.
- Pas de cache explicite.
cachedContentsetcaches.createne sont pas pris en charge ; seul le cache implicite sur les prompts de 4 096 tokens et plus s'applique. - Paramètres d'échantillonnage ignorés.
temperature,top_pettop_kn'ont aucun effet : impossible d'ajuster l'aléa ainsi. - Limites du palier gratuit sur une page séparée. Google renvoie à sa page des limites de débit plutôt que de lister les chiffres d'Hydrogen dans le guide de lancement.
- Orchestrator réservé à Antigravity. Pas d'Orchestrator au niveau de l'API ; dans votre propre code, vous routez les modèles vous-même.
Tester Gemini 4 Hydrogen avec Apidog CLI et votre agent de codage
Pour décider si Hydrogen peut remplacer le 3.8 Flash, exécutez la même requête sur les deux et comparez. Laissez votre agent de codage s'en charger, pour que le changement devienne un résultat de test plutôt une supposition. Cette requête suit le format generateContent documenté par Google ; nous ne l'avons pas exécutée en conditions réelles pour cet article :
MODEL="${GEMINI_MODEL:-gemini-4-hydrogen}"

curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"contents": [{"parts": [{"text": "List three checks a CI job should run before a release."}]}]}'
Apidog CLI offre à Claude Code, Codex, Cursor ou OpenCode un moyen en ligne de commande de créer et d'exécuter des tests d'API. Configurez-le une fois :
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Puis donnez à votre agent un seul prompt :
In Apidog project <id>, create an environment for the Gemini API with a MODEL
variable set to gemini-4-hydrogen and a GEMINI_API_KEY variable. Add a test case
for POST /v1beta/models/{MODEL}:generateContent that asserts HTTP 200, a non-empty
candidates array, and that usageMetadata is present. Run it for gemini-4-hydrogen
and gemini-3.8-flash and compare response time and token counts.
L'agent crée l'environnement, valide la charge utile du cas de test par rapport à son schéma, puis l'exécute une fois par modèle :
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-3.8-flash" -r cli,json
Intégrez le même apidog run ... -r junit dans votre CI avec le guide CI/CD d'Apidog CLI, ou commencez avec Apidog CLI dans Claude Code. Pour des exemples complets de requêtes, voir le guide API de Gemini 4 Hydrogen. Le plan gratuit d'Apidog couvre jusqu'à 4 utilisateurs.
FAQ
Gemini 4 Hydrogen est-il gratuit ? Oui, dans certaines limites. Google liste Hydrogen sur le palier gratuit de l'API Gemini et dans Google AI Studio, avec des limites de débit. L'usage payant coûte 1,50 $ par million de tokens d'entrée et 7,50 $ par million de tokens de sortie.
Quel est l'identifiant du modèle Gemini 4 Hydrogen ? gemini-4-hydrogen. Il fonctionne aussi bien avec generateContent qu'avec l'API Interactions.
Gemini 4 Hydrogen est-il meilleur que Gemini 4 Argon ? Selon les chiffres de Google, Hydrogen obtient 51 à l'indice d'intelligence d'Artificial Analysis au niveau high, contre 50 pour Argon, et 54 au niveau xhigh. Argon reste toutefois recommandé pour la plupart des tâches avancées à long terme : testez les deux sur votre propre charge de travail.
Qu'est-ce que le niveau de réflexion xhigh ? C'est un quatrième niveau de réflexion, nouveau avec Hydrogen, au-dessus du niveau par défaut high. Il consomme le plus de tokens pour le raisonnement le plus approfondi. Google ne le recommande que pour les problèmes difficiles en plusieurs étapes où high ne suffit pas.
Gemini 4 Hydrogen remplace-t-il Gemini 3.8 Flash ? Google le présente comme la mise à niveau recommandée depuis le 3.8 Flash. Changez l'identifiant du modèle, augmentez les plafonds max_output_tokens trop bas, supprimez le cache explicite et les paramètres d'échantillonnage, puis retestez votre niveau de réflexion.
Puis-je utiliser Orchestrator via l'API Gemini ? Non. Orchestrator est une option de modèle au sein de Google Antigravity, réservée aux abonnés payants AI Pro et Ultra. Avec l'API, vous routez vous-même entre Carbon et Hydrogen, par exemple avec previous_interaction_id entre les tours.