
Google a mis à jour son offre Flash le 21 juillet 2026, et Gemini 3.5 Flash-Lite en est l'option économique. C'est le Gemini le moins cher et le plus rapide que vous puissiez utiliser aujourd'hui, conçu pour les tâches à grand volume et sensibles à la latence : classification, extraction, courtes réponses de chat et réponses de récupération simples où le débit et le coût importent plus que le raisonnement approfondi. Si vous envoyez des millions de petites requêtes par jour, c'est la version que Google veut dans votre "hot path".
La mise à jour a livré trois modèles en même temps, et la nomenclature prête à confusion, alors clarifions cela rapidement avant d'aborder les spécifications, les prix, les benchmarks et la manière de tester l'endpoint vous-même.
Qu'est-ce que Gemini 3.5 Flash-Lite ?
Gemini 3.5 Flash-Lite est le modèle le plus petit et le moins cher de la famille Gemini de Google. Il est optimisé pour la vitesse et le volume, pas pour les raisonnements les plus complexes. Google l'évalue à environ 350 tokens de sortie par seconde, de sorte que les réponses semblent quasi instantanées même sous charge. Vous l'appelez via l'API Gemini avec l'ID de modèle gemini-3.5-flash-lite.
Considérez-le comme la version à utiliser pour les tâches répétitives, à haute fréquence et peu complexes. Étiqueter des tickets de support. Extraire des champs d'un document. Répondre à une courte question à partir d'un extrait de texte récupéré. Alimenter un widget de chat qui doit répondre avant que l'utilisateur ne remarque un délai. Dans chacun de ces cas, vous envoyez un grand nombre de requêtes et vous voulez que chacune soit bon marché et rapide. Flash-Lite est la réponse de Google pour ce type de charge de travail.
Il a été lancé dans le cadre d'une mise à jour Flash en trois modèles : le nouveau cheval de bataille Gemini 3.6 Flash, ce Gemini 3.5 Flash-Lite, et un modèle de sécurité cloisonné appelé Gemini 3.5 Flash Cyber. Vous pouvez lire le propre résumé de Google sur le blog de Google et les détails du modèle sur la page DeepMind Flash. Flash-Lite se situe en bas de cette pile en termes de prix et en haut en termes de vitesse brute.
Attendez, pourquoi 3.5 et non 3.6 ?
C'est là que ça devient confus. Le nouveau modèle principal est Gemini 3.6 Flash. Mais Flash-Lite est resté en 3.5, tout comme le modèle de sécurité Cyber cloisonné. Donc, un lancement, un jour, trois modèles, deux numéros de version. Ce n'est ni une faute de frappe de la part de Google, ni une erreur dans cet article. Google a expédié un versionnement mixte : le Flash phare est passé à 3.6, tandis que les variantes Lite et Cyber ont conservé l'étiquette 3.5.
Pourquoi Google fait-il cela ? Le numéro de version suit le modèle, pas l'événement de lancement. Le modèle principal a reçu une plus grande amélioration générationnelle, il a donc mérité l'étiquette 3.6. Flash-Lite est également un nouveau modèle, mais Google a choisi de le maintenir aligné sur la ligne 3.5. C'est ennuyeux à suivre, mais c'est ainsi que les étiquettes ont été attribuées.
Une autre source de confusion à éliminer maintenant. Gemini 3.5 Flash-Lite n'est pas l'ancien Gemini 3.1 Flash-Lite de la génération précédente. Même nom "Flash-Lite", modèle différent, numéros différents. Si vous avez construit sur 3.1 Flash-Lite auparavant, c'est le remplacement plus récent et plus rapide, pas un renommage de ce que vous aviez déjà. Vérifiez l'ID du modèle avant de supposer : gemini-3.5-flash-lite est le nouveau.
Spécifications et prix
Voici ce que coûte Flash-Lite et comment il se comporte. Tous les prix sont par million de tokens via l'API Gemini.
| Attribut | Valeur |
|---|---|
| ID du modèle | gemini-3.5-flash-lite |
| Prix en entrée | $0.30 / 1M tokens |
| Prix en sortie | $2.50 / 1M tokens |
| Vitesse | ~350 tokens de sortie/seconde |
| Tier gratuit | Oui (Google AI Studio, avec limite de débit) |
| Mise en cache du contexte | $0.03 / 1M tokens + $1.00 / 1M/heure de stockage |
Ces 0,30 $ en entrée et 2,50 $ en sortie représentent le tarif publié le moins cher de la gamme Gemini actuelle. À titre de comparaison, le modèle principal 3.6 Flash coûte 1,50 $ en entrée et 7,50 $ en sortie, ce qui signifie que Flash-Lite représente environ un cinquième du coût en entrée et un tiers du coût en sortie. Lorsque vous traitez des millions de petits appels, cet écart est crucial. Vous pouvez confirmer les chiffres actuels sur la documentation des prix de l'API Gemini, car Google met à jour cette page directement.
La mise en cache du contexte réduit encore les coûts pour les invites que vous envoyez de manière répétée, comme une invite système fixe ou un long document de référence. Vous payez un petit tarif pour mettre en cache les tokens plus des frais de stockage horaires, et l'entrée mise en cache est beaucoup moins chère à chaque réutilisation.
Quelles sont ses performances ?
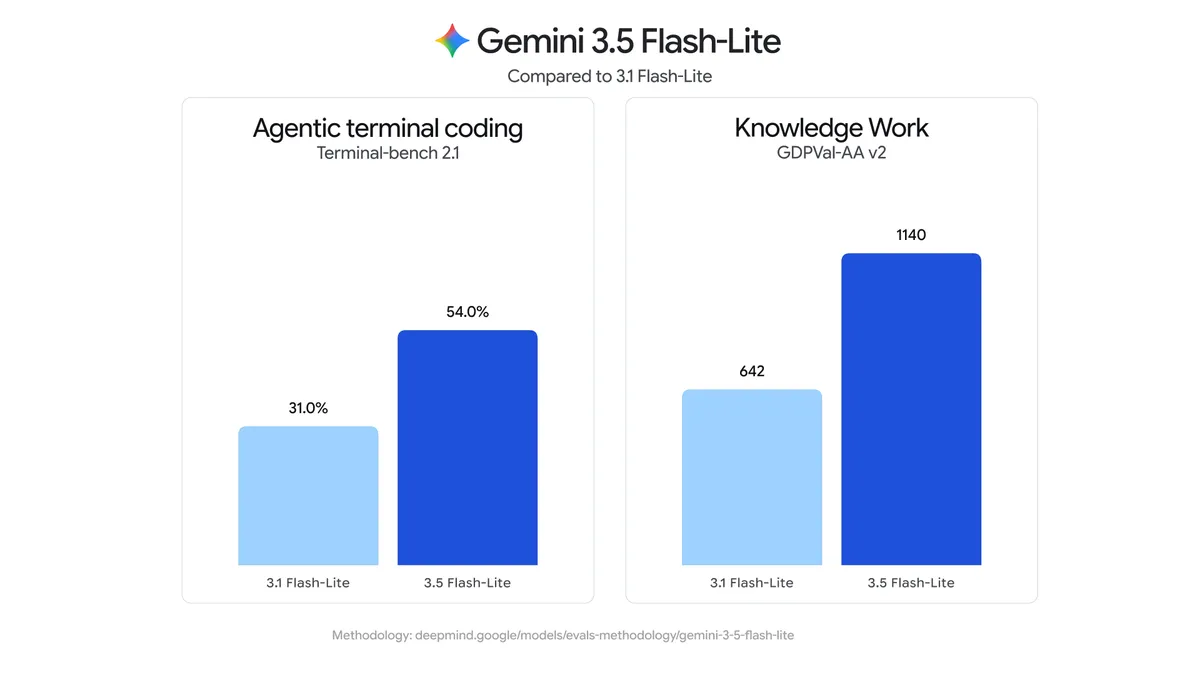
Le chiffre clé : Gemini 3.5 Flash-Lite obtient un score de 54 % sur Terminal-Bench 2.1, contre 31 % pour son prédécesseur. C'est un réel bond pour un modèle de classe Lite, et cela signifie que la petite version est maintenant réellement utile pour des tâches qui auparavant lui échappaient.
Là où il excelle : classification, extraction, réponses de chat et réponses simples augmentées par la récupération. Ce sont les tâches où un modèle rapide et bon marché justifie son existence. Trier les entrées en catégories, extraire des données structurées de texte désordonné, répondre à une courte question basée sur un passage récupéré, maintenir un assistant léger réactif. Flash-Lite gère tout cela bien et rapidement.
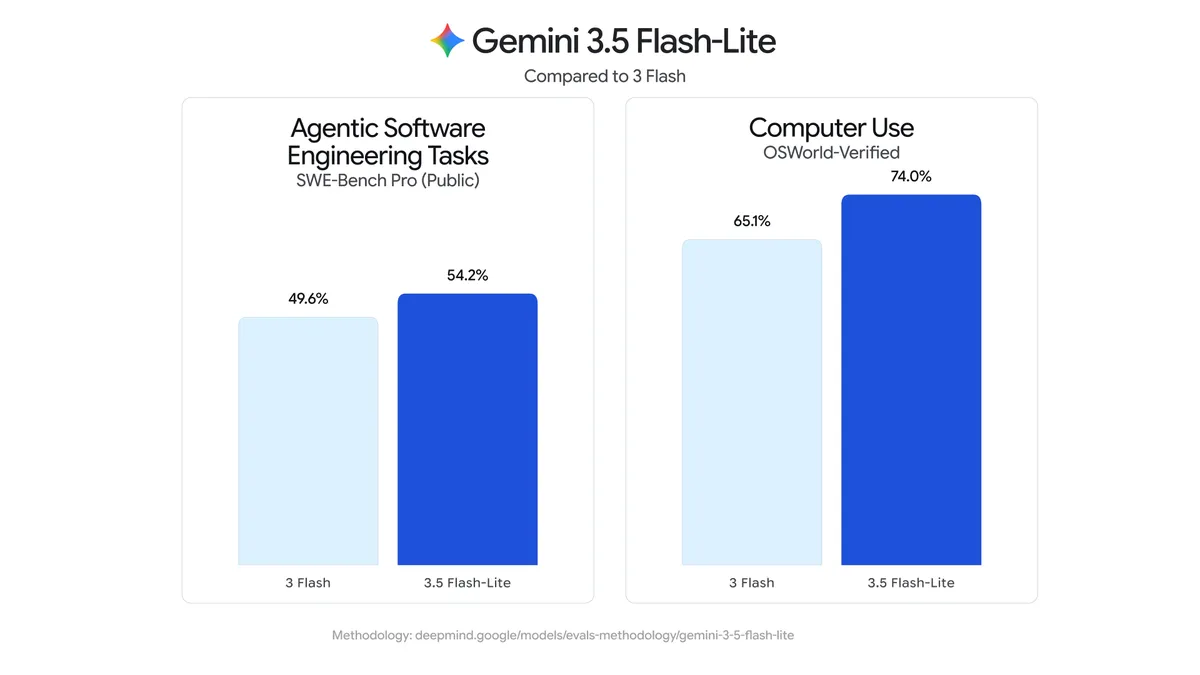
Maintenant, la limite honnête. Flash-Lite échange la qualité contre le coût et la vitesse. Ce n'est pas le modèle pour le codage agentique le plus difficile, les longues chaînes d'outils multi-étapes ou les problèmes de raisonnement approfondi. Lorsqu'une tâche nécessite de planifier plusieurs étapes, d'appeler des outils de manière fiable en séquence ou de raisonner à travers une base de code complexe, vous préférerez Gemini 3.6 Flash ou un modèle plus grand. Choisir Flash-Lite pour ce travail permet d'économiser de l'argent jusqu'à ce que les mauvaises réponses vous coûtent plus cher que ce que vous avez économisé. Adaptez le niveau à la tâche.
Où Google utilise Flash-Lite
Google ne vend pas seulement Flash-Lite aux développeurs. Il intègre le modèle dans Google Search. C'est un signal utile : lorsque Google place un modèle face au trafic de Search, cela signifie qu'il parie que le modèle est suffisamment rapide et bon marché pour gérer un nombre énorme de requêtes sans subir de problèmes de latence ou de budget.
Pour vous, c'est une preuve. Les mêmes propriétés qui rendent Flash-Lite adapté à la recherche, un débit élevé et un faible coût par appel, sont exactement ce qui le rend adapté à un endpoint de production très sollicité. S'il peut servir le trafic de recherche, il peut servir votre pipeline de classification.
Flash-Lite vs Gemini 3.6 Flash : lequel choisir ?
En bref : choisissez Flash-Lite lorsque la tâche est simple, à volume élevé et sensible à la vitesse. Choisissez 3.6 Flash lorsque la tâche nécessite un raisonnement plus poussé, du codage ou un travail d'agent multi-étapes.
Flash-Lite l'emporte sur le prix et la latence. C'est le Gemini le moins cher et il fonctionne à environ 350 tokens par seconde, c'est donc le choix par défaut idéal pour la classification, l'extraction, le chat court et le RAG simple à grande échelle. Gemini 3.6 Flash coûte plus cher par token mais raisonne plus difficilement, code mieux et tient le coup sur les workflows agentiques où Flash-Lite trébucherait. Le prix de 3.6 Flash le reflète : vous payez pour la capacité supplémentaire.
Un schéma pratique consiste à acheminer en fonction de la difficulté. Envoyez les appels faciles et fréquents à Flash-Lite et faites remonter les plus difficiles à 3.6 Flash. Vous obtenez un débit bon marché sur la majeure partie du trafic et un raisonnement plus poussé uniquement là où cela justifie son coût. Pour une comparaison côte à côte complète sur la vitesse, le prix et la qualité, voir Gemini 3.5 Flash-Lite vs 3.6 Flash.
Comment y accéder et le tester
Flash-Lite fonctionne sur l'API Gemini. Le moyen le plus rapide de commencer est Google AI Studio : obtenez une clé API, et le niveau gratuit vous permet d'essayer le modèle avant de configurer la facturation. Notez que le niveau gratuit est soumis à des limites de débit, et Google peut utiliser les données du niveau gratuit pour améliorer ses produits, alors gardez les entrées sensibles sur une clé payante. La référence complète se trouve dans la documentation de l'API Gemini. Réglez le modèle sur gemini-3.5-flash-lite et vous appellerez la version la moins chère.
Une fois que vos requêtes fonctionnent, vous voulez qu'elles continuent de fonctionner. Les prix, les limites de débit et les formes de réponse changent à mesure que Google met à jour l'API, et un modèle Lite rapide mais parfois erroné nécessite des assertions pour détecter les dérives. C'est là qu'un client API est utile. Avec Apidog, vous pouvez construire la requête POST vers l'endpoint Gemini, stocker votre clé API comme variable d'environnement afin qu'elle ne soit jamais dans le corps de la requête, et ajouter des assertions sur le code d'état et les champs JSON dont vous dépendez.
À partir de là, vous pouvez transformer cette requête en un test de régression enregistré et le programmer pour qu'il s'exécute afin de détecter une réponse défectueuse ou un changement de prix avant vos utilisateurs. Apidog n'exécute pas le modèle et ne remplace pas l'API Gemini ; c'est le client que vous utilisez pour appeler, valider et surveiller l'endpoint. Téléchargez Apidog si vous souhaitez tester l'endpoint gemini-3.5-flash-lite avec le reste de votre pile API.
FAQ
Gemini 3.5 Flash-Lite est-il identique à Gemini 3.6 Flash ? Non. Ce sont deux modèles différents issus de la même mise à jour du 21 juillet 2026. Flash-Lite est la version la moins chère et la plus rapide pour les tâches simples à grand volume. 3.6 Flash est le modèle principal plus cher avec un raisonnement et un codage plus solides.
Pourquoi est-ce 3.5 et non 3.6 ? Versionnement mixte. Google a fait passer le modèle Flash principal à 3.6, mais a conservé Flash-Lite et le modèle Cyber cloisonné sous l'étiquette 3.5 lors du même lancement. Le numéro suit la ligne de modèle, pas la date de lancement.
Est-ce l'ancien Gemini 3.1 Flash-Lite ? Non. Gemini 3.5 Flash-Lite est un modèle plus récent. L'ancien 3.1 Flash-Lite est de la génération précédente. Même nom de famille, modèle et version différents, alors vérifiez l'ID du modèle gemini-3.5-flash-lite pour être sûr d'utiliser le nouveau.
Gemini 3.5 Flash-Lite est-il gratuit ? Il existe un niveau gratuit via Google AI Studio, et il est soumis à des limites de débit. Il convient pour les tests et une utilisation légère. Pour un volume de production, vous passez à une clé API payante, et Google peut utiliser les données du niveau gratuit pour améliorer ses produits.
À quoi Flash-Lite est-il le plus adapté ? Classification, extraction, courtes réponses de chat et réponses simples augmentées par la récupération à grand volume. Ce n'est pas le choix pour le codage agentique difficile ou les raisonnements multi-étapes complexes, où 3.6 Flash est plus adapté.