
Firecrawl Local est un binaire Rust unique qui scrape, crawle et cartographie des sites web pour produire du markdown propre sur votre propre machine. Vous l’installez avec cargo install firecrawl-local, et il peut servir l’API Firecrawl v2 sur localhost:3002 sans clé API, sans base de données, sans file d’attente et sans conteneur. La recherche et quelques autres fonctionnalités passent encore par Firecrawl Cloud, et vous pouvez désactiver ce recours.
Ci-dessous : ce qui s’exécute sur votre ordinateur portable, ce qui passe par le cloud, comment l’installer, les routes API qu’il sert, ses limites, et comment laisser votre agent de codage tester l’API locale avec Apidog CLI.
Qu’est-ce que Firecrawl Local ?
Firecrawl Local est l’édition open source et locale de Firecrawl. C’est un seul binaire qui récupère des pages web, les nettoie avec le même code de nettoyage HTML que celui utilisé par l’API Firecrawl hébergée, et renvoie du markdown, du HTML ou des liens. Il s’exécute comme CLI, comme serveur MCP pour les agents d’IA, ou comme copie locale de l’API Firecrawl v2.
Firecrawl l’a annoncé le 18 novembre 2026 dans une annonce de lancement sur X, et le code se trouve dans le dossier apps/local du dépôt Firecrawl. Le paquet est publié sur crates.io sous le nom firecrawl-local, et le dépôt est sous licence AGPL-3.0.
Firecrawl affirme qu’il est 37 fois plus rapide que Firecrawl auto-hébergé et qu’il utilise 230 fois moins de mémoire (11 Mo au repos). Le README ne publie aucune méthode de benchmark, considérez donc ces chiffres comme des affirmations de l’éditeur.
Si vous connaissez l’API hébergée ou la CLI Firecrawl, le principe est simple : les mêmes appels, exécutés sur votre machine.
Comment fonctionne Firecrawl Local : un binaire, dix commandes
Chaque fonctionnalité est accessible via une sous-commande de firecrawl-local. Voici la liste complète issue du README :
| Commande | Ce qu’elle fait | S’exécute sur |
|---|---|---|
scrape <urls...> |
Scrape une ou plusieurs URL | Votre machine |
crawl <url> |
Suit les liens à partir d’une URL de départ | Votre machine |
map <url> |
Liste les URL d’un site à partir des sitemaps et de la page de départ | Votre machine |
serve |
Exécute l’API Firecrawl v2 sur localhost | Votre machine |
mcp |
Exécute le serveur MCP Firecrawl via stdio | Votre machine, certains outils sur le cloud |
init |
Ajoute le serveur MCP aux outils d’IA de cette machine | Votre machine |
search <query> |
Recherche sur le Web | Firecrawl Cloud |
find-tools <query> |
Trouve des fournisseurs de données Alexandria | Firecrawl Cloud, connexion requise |
data <provider> <capability> |
Exécute un fournisseur de données Alexandria | Firecrawl Cloud, connexion requise |
login |
Se connecte à Firecrawl dans le navigateur | Firecrawl Cloud |
Trois commandes couvrent la plupart des usages quotidiens :
# Print one page as markdown
firecrawl-local scrape https://example.com --markdown

# Crawl up to 50 pages and save one markdown file per page
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages

# List every URL on a site
firecrawl-local map https://firecrawl.dev
Sans --markdown, scrape affiche le JSON de l’API Firecrawl. --format accepte markdown, html, rawHtml et links. Les PDF et les documents Office sont eux aussi analysés localement.
Pour les pages JavaScript, il pilote le Chrome ou Chromium que vous avez déjà. Sans navigateur, les pages statiques fonctionnent toujours, et une page qui nécessitait un navigateur renvoie un avertissement. --browser auto|never|always détermine quand Chrome est utilisé.
Ce qui s’exécute en local et ce qui passe par Firecrawl Cloud
Le scraping, le crawling, le mapping et l’analyse de documents s’exécutent sur votre machine et n’envoient rien à Firecrawl. Trois fonctionnalités passent par Firecrawl Cloud, car un ordinateur portable n’a ni l’index, ni le réseau, ni les données nécessaires :
- La recherche. Il n’y a pas d’index de recherche sur votre machine. La recherche sans clé fonctionne, mais elle est limitée en débit.
- Les pages qui refusent votre machine. Si un site bloque à la fois la récupération simple et le navigateur local, Firecrawl Cloud la récupère. Aucun compte n’est nécessaire.
- Les fournisseurs de données Alexandria. Ils s’exécutent sur Firecrawl Cloud et nécessitent un compte gratuit. Notre présentation de Firecrawl Alexandria explique de quoi il s’agit.
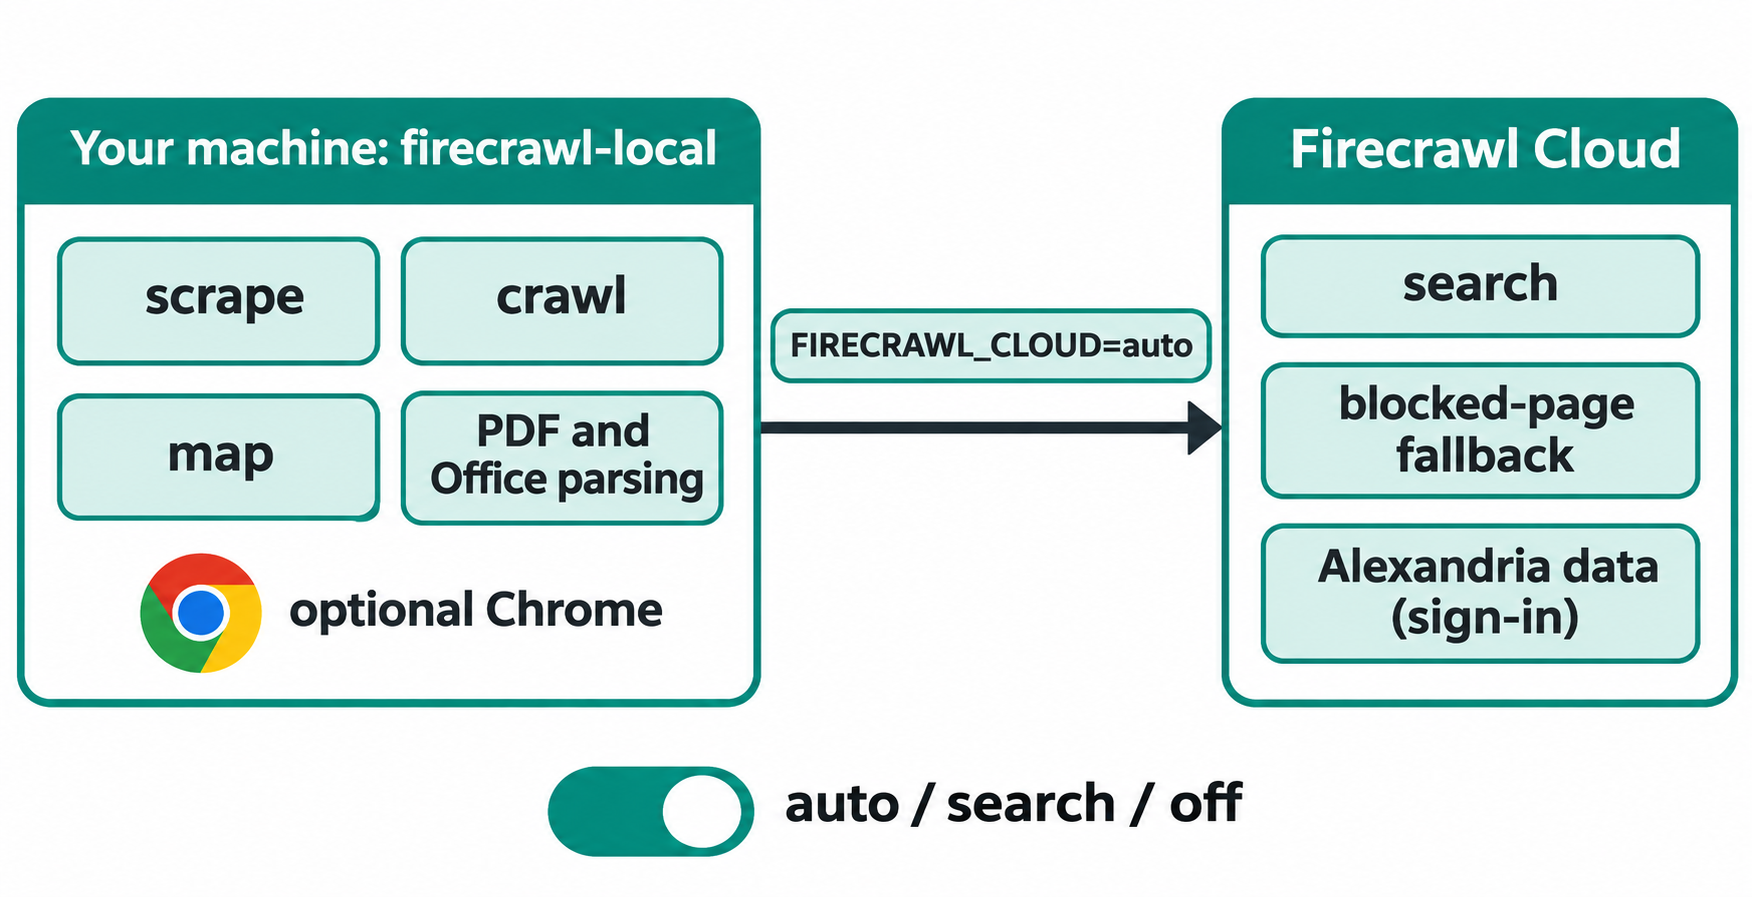
La variable d’environnement FIRECRAWL_CLOUD contrôle ce transfert :
| Valeur | Effet |
|---|---|
auto (par défaut) |
La recherche, le repli pour les pages bloquées et Alexandria fonctionnent |
search |
Seule la recherche passe par Firecrawl Cloud |
off |
Rien ne passe par Firecrawl Cloud |
Une valeur non reconnue est traitée comme off. Les résultats récupérés depuis le cloud portent "source": "firecrawl-cloud" ; si le cloud échoue aussi, vous obtenez "blocked": true.
Les appels au cloud transportent un identifiant d’installation aléatoire et le nom de l’outil appelant, ce qui permet à Firecrawl de compter les installations.
Comment installer Firecrawl Local
Vous avez besoin de Rust et d’un compilateur C. Ensuite :
- Installez les outils de compilation. Sur macOS, exécutez
xcode-select --install. Sur Debian ou Ubuntu, installezbuild-essential. - Ajoutez Chrome ou Chromium (facultatif) si vous avez besoin de pages rendues en JavaScript ou de captures d’écran.
- Ajoutez Node.js 22 ou une version ultérieure (facultatif) si vous voulez le serveur MCP, qui exécute le paquet npm
firecrawl-mcpvianpx. - Connectez-vous (facultatif) avec
firecrawl-local loginpour les fournisseurs Alexandria.
Installez le binaire depuis crates.io.
cargo install firecrawl-local
firecrawl-local --version
Pour compiler plutôt le code le plus récent, exécutez cargo build --release dans apps/local d’un clone du dépôt.
API Firecrawl Local : les routes v2 sur localhost:3002
firecrawl-local serve répond à l’API Firecrawl v2 sur le port 3002. Aucune clé API n’est nécessaire pour les routes locales.
firecrawl-local serve

# in another terminal
curl -s http://localhost:3002/v2/scrape \
  -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown"]}'
Ces routes s’exécutent sur votre machine :
| Route | Ce qu’elle fait |
|---|---|
POST /v2/scrape |
Scrape une URL |
POST /v2/map |
Liste les URL d’un site |
POST /v2/crawl, GET et DELETE /v2/crawl/{id} |
Démarre, vérifie et annule un crawl |
POST /v2/batch/scrape, GET et DELETE /v2/batch/scrape/{id} |
Démarre, vérifie et annule un scrape par lot |
GET /health |
Contrôle de santé |
Toute autre route /v2, comme /v2/search, est transmise à Firecrawl Cloud, sauf si FIRECRAWL_CLOUD indique le contraire. Les routes v0 et v1 ne sont pas servies.
Le code existant bascule en changeant un seul paramètre : pointez l’URL d’API de n’importe quel SDK Firecrawl vers http://localhost:3002. Votre scraper ou pipeline RAG conserve son code, et vous cessez de dépenser des crédits cloud pendant vos itérations. Pour un tour d’horizon plus large des pipelines de scraping, consultez notre guide de scraping web Firecrawl.
Firecrawl Local comme serveur MCP pour les agents d’IA
firecrawl-local init enregistre Firecrawl Local comme serveur Model Context Protocol dans chaque outil d’IA qu’il détecte. Il reconnaît Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI et Codex, sauvegarde d’abord chaque fichier de configuration, et accepte --dry-run pour prévisualiser les changements ou --agent cursor pour configurer un seul outil.
Votre agent dispose des outils standard de Firecrawl MCP : scrape, crawl, map et batch scrape s’exécutent localement, le reste passe par Firecrawl Cloud.
Si votre agent parcourt des sites auxquels vous ne faites pas confiance, enregistrez-le avec firecrawl-local mcp --public-only. Sinon, une page contenant des instructions cachées pourrait pousser l’agent à ouvrir une URL interne sur votre réseau.
Les limites de Firecrawl Local
Firecrawl Local n’est pas le serveur Firecrawl complet. Le README liste ce qui manque :
- Pas de formats
jsonousummaryen local. Les scrapes locaux les ignorent avec un avertissement, car ils nécessitent un modèle. - Pas d’
actionsde navigateur. Les clics, les défilements et les étapes de saisie sont ignorés. - Les captures d’écran nécessitent Chrome.
- Les tâches vivent en mémoire. Les tâches de crawl et de batch expirent une heure après leur démarrage et sont perdues lorsque
serves’arrête. - Pas de routes d’API v0 ou v1.
Pour les files d’attente, les workers et tous les formats, le serveur complet dans apps/api existe toujours ; il est présenté dans le guide d’auto-hébergement de Firecrawl.
Paramètres de sécurité par défaut à connaître
Les valeurs par défaut diffèrent selon la commande, car serve reçoit des requêtes d’autres programmes :
scrape,crawl,mapetmcps’exécutent pour la personne derrière le clavier, ils peuvent donc atteindrelocalhostet votre réseau privé.scrape,crawletmcpacceptent--public-onlypour refuser ces adresses.servese lie à127.0.0.1et refuse localhost ainsi que les cibles privées, sauf si vous passez--allow-private. Lier une autre adresse avec--hostnécessite--token.- Les adresses link-local et de métadonnées cloud sont toujours bloquées, y compris après les redirections et la résolution DNS.
Chrome s’exécute en mode headless, dans un sandbox, avec un profil jetable. Lors d’un crawl, Firecrawl Local lit robots.txt conformément au Robots Exclusion Protocol, où les propriétaires de sites peuvent l’identifier comme FirecrawlLocal.
À qui s’adresse Firecrawl Local ?
- Les développeurs qui construisent des scrapers ou des pipelines RAG et veulent itérer gratuitement et rapidement avant de payer pour du volume cloud.
- Les utilisateurs d’agents de codage qui veulent lire le Web dans Claude Code, Cursor ou Codex sans envoyer chaque page à un tiers.
- Les équipes soumises à des règles sur les données qui ont besoin que le contenu récupéré reste sur la machine, avec
FIRECRAWL_CLOUD=off.
Il est moins adapté si vous dépendez de l’extraction json, des actions de navigateur ou de tâches de crawl de longue durée. Si vous avez seulement besoin de recherche pour agents, consultez notre sélection de recherche web open source pour Claude.
Laissez votre agent de codage tester l’API locale avec Apidog CLI
Une fois serve lancé, vous disposez d’une véritable API HTTP sur localhost:3002. Avant de brancher un pipeline dessus, vérifiez que les routes répondent comme votre code l’attend. Donnez à votre agent de codage Apidog CLI et une seule invite au lieu de cliquer sur des requêtes une par une.
Configurez-le une fois :
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Demandez ensuite à votre agent :
Start firecrawl-local serve in the background. Write an OpenAPI 3 file for its
local routes (POST /v2/scrape, POST /v2/map, GET /health) and import it into
Apidog project <id>. Create an environment pointing at http://localhost:3002,
add test cases that assert /health returns 200 and /v2/scrape returns
success: true with non-empty data.markdown for https://example.com, then run
them and summarize any failures.
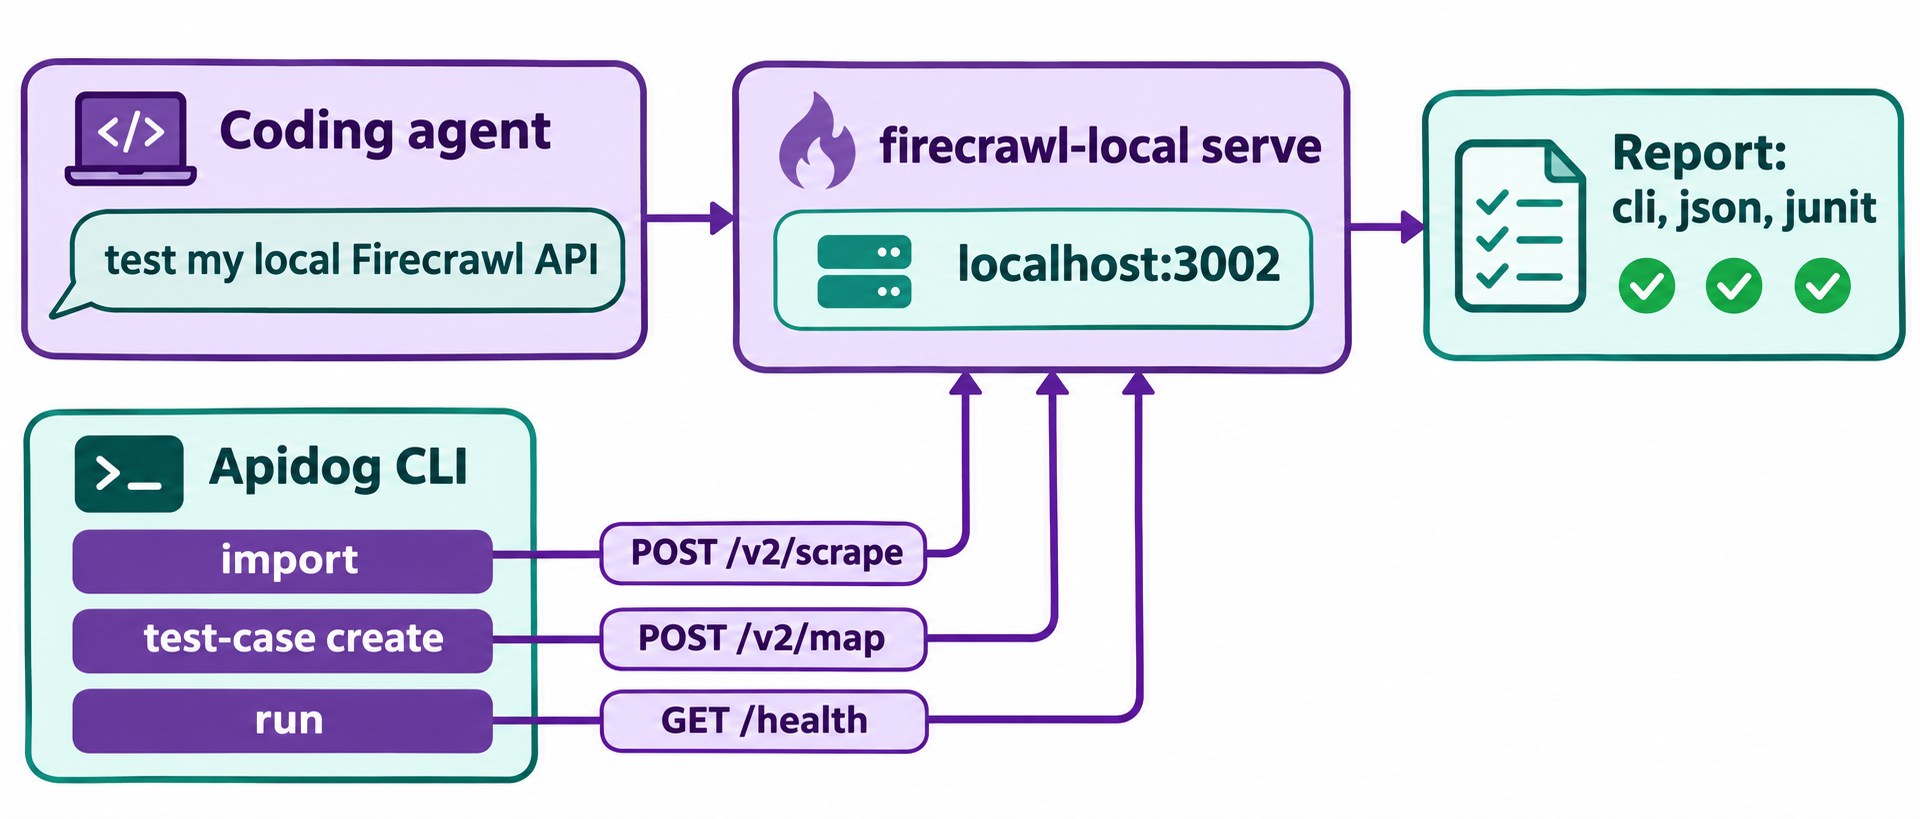
L’agent lit le schéma, valide son payload et exécute des commandes comme celles-ci :
firecrawl-local serve &
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file ./case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Apidog CLI envoie les requêtes depuis votre machine, donc localhost:3002 est accessible. Remplacez -r cli,json par -r junit et la même exécution s’intègre à la CI ; notre guide CI/CD d’Apidog CLI montre la configuration, et Apidog CLI dans Claude Code détaille le côté agent. Le forfait Free d’Apidog couvre les équipes jusqu’à 4 utilisateurs.
FAQ
Firecrawl Local est-il gratuit ? Le binaire est open source sous AGPL-3.0, et le scraping, le crawling et le mapping locaux ne nécessitent aucune clé API. La recherche, le repli pour les pages bloquées et Alexandria passent par Firecrawl Cloud, et Alexandria nécessite un compte gratuit.
Puis-je utiliser mon code existant basé sur le SDK Firecrawl avec Firecrawl Local ? Oui, pour les routes locales. Définissez l’URL d’API du SDK sur http://localhost:3002. Scrape, map, crawl et batch scrape s’exécutent localement ; les routes v0 et v1 ne sont pas servies.
Comment empêcher Firecrawl Local d’appeler le cloud ? Définissez FIRECRAWL_CLOUD=off. La recherche et le repli pour les pages bloquées cessent de fonctionner, et rien ne quitte votre machine, sauf avec une commande login explicite.
Quelle est la différence entre Firecrawl Local et Firecrawl auto-hébergé ? Firecrawl auto-hébergé est le serveur complet dans apps/api, avec des files d’attente, des workers et tous les formats. Firecrawl Local est un binaire unique plus léger qui abandonne les formats json et summary, les actions de navigateur et les tâches persistantes.