
DeepSeek a retiré son modèle phare au profit de son plus petit modèle. Le 10 septembre 2026, DeepSeek-V4.1-Flash est devenu disponible pour le grand public (GA) sur l'API, et la note de publication contient une phrase que la plupart des laboratoires cacheraient : à partir du 14 septembre, chaque requête vers deepseek-v4-pro sera acheminée vers V4.1-Flash et facturée aux prix Flash. Le modèle Flash de 552 milliards de paramètres, avec 8 milliards de paramètres actifs en entrée, répond désormais pour toute la famille V4.
C'est l'histoire derrière les recherches « deepseek v4.1 flash » de cette semaine, et cela compte pour deux raisons. Premièrement, l'architecture est nouvelle. Une division Encodeur-Décodeur Causal, la mise en cache KV FP4 à 890 octets par jeton, et la vision native dès la première étape de pré-entraînement ne sont pas des changements incrémentaux par rapport à DeepSeek V4. Deuxièmement, la grille tarifaire a évolué avec elle. Si vous payiez les tarifs V4-Pro, votre facture diminuera de 70 % ou plus le 14, que vous changiez quoi que ce soit ou non.
Ce guide couvre ce qui a été livré, comment l'architecture fonctionne en termes de développeur, ce que disent les benchmarks du fournisseur, et les calculs de prix. Il se termine par un flux de travail pour tester le modèle avec vos propres requêtes dans Apidog, car un tableau de benchmarks est un point de départ, pas un verdict.
TL;DR
- DeepSeek-V4.1-Flash est disponible pour le grand public (GA) depuis le 10 septembre 2026. ID du modèle :
deepseek-flash. URL de base inchangée :https://api.deepseek.com. - 552 milliards de paramètres MoE (763 milliards avec l'encodeur de vision), 8 milliards actifs pour le pré-remplissage, 16 milliards actifs pour le décodage. Contexte de 1 million, sortie maximale de 384K.
- Selon les chiffres de DeepSeek, il surpasse V4-Pro sur HumanEval, GSM8K, DeepSWE et Terminal-Bench.
- Tarifs de pointe : 0,30 $ par 1M d'entrées avec accès au cache manqué, 1,20 $ par 1M de sorties. Les tarifs hors pointe sont la moitié de cela.
- Les requêtes V4-Pro seront redirigées vers V4.1-Flash le 14 septembre à 04:00 UTC.
Ce qui a été livré le 10 septembre
DeepSeek a mené une bêta interne de deux jours à partir du 8 septembre sous le nom de modèle deepseek-v4.1-flash-expires-on-0910, limitée à 20 requêtes concurrentes par compte et au même prix que deepseek-v4-flash. TechNode a rapporté cette bêta. Deux jours plus tard, le modèle est devenu disponible pour le grand public (GA), avec une entrée dans le journal des modifications datée du 2026-09-10 et une annonce sur X.
Trois changements de nom sont importants pour votre code :
- Le nouvel ID de modèle est
deepseek-flash. Utilisez-le pour les nouvelles intégrations. - Les anciens noms
deepseek-v4-flashetdeepseek-v4-flash-vision-expsont toujours résolus, mais ils sont desservis par V4.1-Flash. V4-Flash et V4-Flash-Vision-Exp sont retirés en tant que modèles séparés. deepseek-v4-procontinue de fonctionner jusqu'au 14 septembre, puis est acheminé vers V4.1-Flash.
Les URL de base n'ont pas changé : https://api.deepseek.com pour le format OpenAI, https://api.deepseek.com/anthropic pour le format Anthropic. L'API Responses était déjà prise en charge sur la gamme Flash, de sorte que les intégrations de style Codex sont conservées. Pour les détails des paramètres, y compris l'entrée d'image et l'effort de raisonnement, consultez comment utiliser l'API DeepSeek-V4.1-Flash.
L'architecture Encodeur-Décodeur Causal pour les développeurs
La fiche modèle décrit une conception que DeepSeek appelle Encodeur-Décodeur Causal, ou CED. Voici ce que chaque chiffre signifie lorsque vous êtes celui qui paie pour les jetons.
552 milliards de paramètres, 763 milliards avec la vision. L'ossature linguistique est un modèle de mélange d'experts (MoE) de 552 milliards de paramètres. Ajoutez l'encodeur DeepSeek-ViT, entraîné de zéro pour cette version, et le modèle complet atteint 763 milliards. Ce sont des paramètres stockés, pas le coût d'une requête.
8 milliards actifs pour le pré-remplissage, 16 milliards actifs pour le décodage. C'est le changement majeur. Les 40 couches sont divisées en 20 couches d'encodeur et 20 couches de décodeur. La lecture de votre prompt (pré-remplissage) active environ 8 milliards de paramètres par jeton. L'écriture de la réponse (décodage) active environ 16 milliards. Les modèles MoE DeepSeek précédents utilisaient un budget de paramètres actifs unique pour les deux phases.
Pourquoi cette division est-elle importante ? Le pré-remplissage est limité par le calcul : vous poussez un document de 200K jetons à travers le modèle en un seul passage. Le décodage est limité par la mémoire : vous générez un jeton à la fois, et le coût est la lecture des poids et du cache KV depuis la HBM. Moins de paramètres au pré-remplissage réduit le temps de premier jeton sur les longues entrées. Plus au décodage améliore la qualité de la réponse lorsque le calcul supplémentaire est bon marché par rapport au trafic mémoire. Une trace d'agent de 1M de contexte qui produit une réponse de 2K jetons emprunte le chemin le moins coûteux pour 99,8 % de ses jetons.
384 experts routés plus 1 expert partagé par couche. Le routeur choisit quelques-uns des 384 experts par jeton, et l'expert partagé s'exécute à chaque fois. C'est ainsi que 552 milliards de paramètres stockés deviennent 8 milliards ou 16 milliards actifs.
CSA2 et le cache KV FP4. La Compressed Sparse Attention 2 (CSA2) est livrée avec trois modes d'attention statiques. Associé au stockage FP4 pour le cache KV principal, l'empreinte mémoire globale du cache est de 890 octets par jeton, soit environ un quart de DeepSeek-V4-Flash. La note de version indique que c'est 1/4 de la HBM et 1/8 du stockage SSD de la génération précédente. À 890 octets par jeton, un contexte complet de 1M de jetons nécessite environ 0,9 Go de cache KV. C'est en partie la raison pour laquelle la limite de concurrence est de 2 500 pour Flash contre 500 pour Pro.
Contexte de 1M, sortie de 384K. L'attention parcimonieuse a été entraînée à 64K et étendue à 1M au cap des 34T jetons d'un corpus multimodal de 45T jetons. L'effort de raisonnement est décrit comme étant contrôlable en continu sur une échelle de 1 à 100 ; la forme exacte du paramètre API pour cette échelle est [VÉRIFIER] par rapport à la documentation.
Benchmarks : ce que DeepSeek rapporte
Chaque chiffre de cette section est rapporté par DeepSeek à partir de la fiche modèle. Aucune évaluation indépendante n'avait été publiée au 10 septembre. Lisez-les comme l'affirmation du fournisseur, puis effectuez vos propres tests.
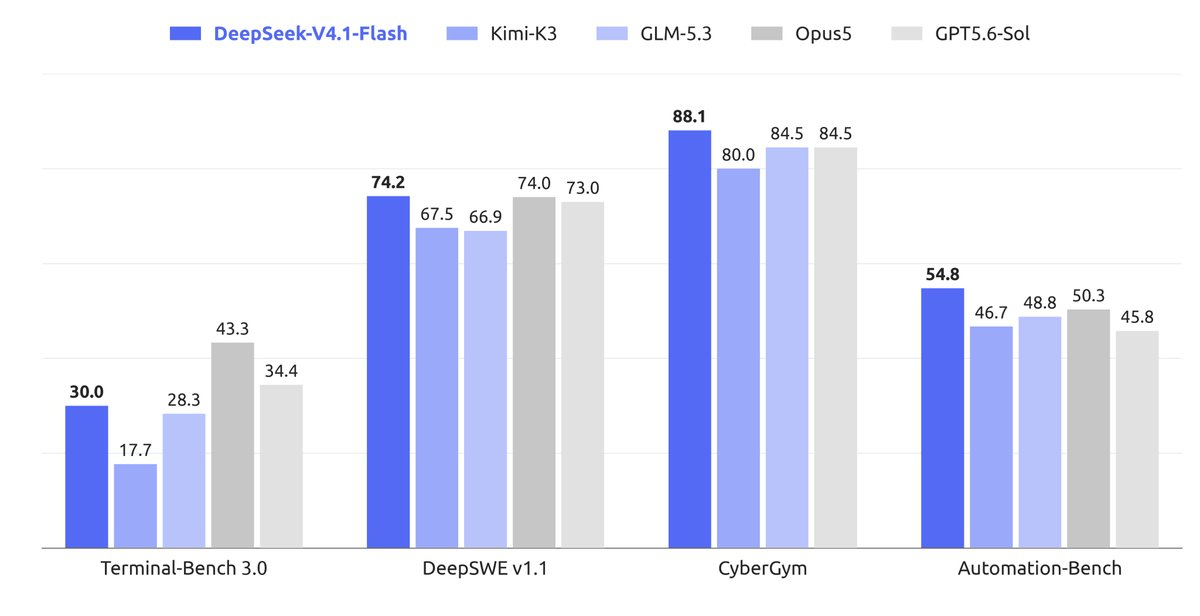
Le schéma est cohérent : V4.1-Flash se situe au-dessus de V4-Pro sur chaque ligne, avec le plus grand écart sur le codage agentique. DeepSWE bondit de 11,5 points par rapport à Pro et de près de 20 points par rapport à l'ancien Flash. GSM8K est saturé, donc l'avantage de 0,4 point vous en dit peu.
Scores de vision, également rapportés par le fournisseur : MMMU-Pro 56.5, CVBench 77.9, DocVQA 95.6, RefCOCO 86.0. DocVQA est le chiffre à surveiller, car l'analyse de documents est l'endroit où la plupart du trafic de vision en production se dirige.
La justification de DeepSeek pour la redirection de V4-Pro est que V4.1-Flash « a surpassé de manière exhaustive V4 Pro en termes de performances, de coût, de vitesse et de temps total », citant des tests effectués par plusieurs parties. Les parties ne sont pas nommées. Traitez cette phrase comme une affirmation que vous pouvez vérifier.
Tarification et la redirection de V4-Pro
Les tarifs ci-dessous proviennent de la page de tarification, en vigueur le 10 septembre à 04:00 UTC, en USD par 1M de jetons.
| deepseek-flash heures creuses | deepseek-flash heures de pointe | deepseek-v4-pro heures creuses | deepseek-v4-pro heures de pointe | |
|---|---|---|---|---|
| Entrée, accès cache réussi | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrée, accès cache manqué | $0.15 | $0.30 | $0.66 | $1.32 |
| Sortie | $0.60 | $1.20 | $1.98 | $3.96 |
Les heures de pointe sont de 01:00 à 04:00 et de 06:00 à 10:00 UTC en semaine ; les heures creuses représentent 50 % des tarifs de pointe. La mise en cache du contexte est automatique, et un accès au cache réussi coûte 50 fois moins cher qu'un accès manqué à n'importe quel niveau.
Par rapport aux tarifs d'août de V4-Flash, V4.1-Flash réduit le coût des entrées avec accès au cache réussi d'environ 57 %, celui des entrées avec accès au cache manqué d'environ 32 %, et celui des sorties d'environ 9 %.
La colonne V4-Pro est celle à surveiller. Après le 14 septembre, une requête envoyée à deepseek-v4-pro paie le tarif de la colonne Flash. Aux heures de pointe, cela représente 0,30 $ au lieu de 1,32 $ par 1M d'entrées avec accès au cache manqué (77 % de moins) et 1,20 $ au lieu de 3,96 $ par 1M de sorties (70 % de moins). Vous obtenez la réduction sans toucher au code, bien que vous devriez de toute façon mettre à jour l'ID du modèle au lieu de dépendre d'un alias retiré. Le guide de migration passe en revue la liste de contrôle, et l'analyse approfondie de la tarification couvre le calcul de l'accès au cache pour les longues sessions d'agent.
Évaluez V4.1-Flash avec vos propres requêtes dans Apidog
Le tableau du fournisseur indique que le modèle est bon pour DeepSWE. Il ne dit pas s'il gère votre schéma d'extraction, votre format d'appel d'outil ou vos transcriptions de support de 300K jetons. Voici un flux de travail dans Apidog qui répond à ces questions en un après-midi et continue d'y répondre après chaque mise à jour silencieuse du modèle.
- Stockez la clé comme variable d'environnement. Créez un environnement Apidog et ajoutez `DEEPSEEK_API_KEY` depuis la plateforme DeepSeek. Référencez-la dans l'en-tête d'autorisation comme
Bearer {{DEEPSEEK_API_KEY}}. - Ajoutez le point d'accès. Créez `POST https://api.deepseek.com/chat/completions`, ou importez une spécification OpenAPI.
- Enregistrez une requête par prompt réel. Prenez cinq à dix prompts des logs de production et enregistrez chacun comme sa propre requête avec
"model": "deepseek-flash". Gardez une copie pointée versdeepseek-v4-projusqu'au 14 afin de pouvoir comparer les sorties côte à côte. - Diffusez et observez les événements. Définissez
"stream": true. Apidog affiche les réponses SSE événement par événement, de sorte que les deltas de raisonnement et les deltas de réponse apparaissent séparément au lieu d'un mur de lignesdata:. C'est le moyen le plus rapide de voir le temps de premier jeton sur un long pré-remplissage. - Ajoutez des assertions et construisez un scénario de test. Affirmez sur le code de statut, sur un champ
tool_callsoù vous en attendez un, et sur la validité JSON de la sortie. Enchaînez les requêtes enregistrées dans un scénario de test. - Relancez à chaque mise à jour du modèle. Lorsque DeepSeek pousse le prochain changement derrière
deepseek-flash, exécutez le scénario. Intégrez-le à votre CI avecapidog-clipour qu'il s'exécute à chaque déploiement.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "Extract the order ID, SKU list, and refund amount as JSON."},
        {"role": "user", "content": "Ticket #48213: customer wants a refund of $42.90 for SKUs KB-220 and MS-114 from order ORD-99117."},
    ],
    stream=True,
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="")
Téléchargez Apidog et collez ce corps dans une requête enregistrée. Apidog teste la couche API, pas un hôte de modèle, donc ce que vous voyez est la réponse que vos utilisateurs recevront.
FAQ
- DeepSeek-V4.1-Flash remplace-t-il V4-Pro ? Oui, par décision de DeepSeek. À partir du 14 septembre à 04:00 UTC, les requêtes
deepseek-v4-proseront servies par V4.1-Flash aux prix Flash. Il n'y a plus de modèle plus grand dans la gamme API V4. - Dois-je changer mon ID de modèle ? Pas immédiatement. `deepseek-v4-flash`, `deepseek-v4-flash-vision-exp`, et (après le 14) `deepseek-v4-pro` résolvent tous vers V4.1-Flash. Passez à `deepseek-flash` lors de votre prochaine modification de l'intégration. Le guide API contient la référence complète des paramètres.
- Que signifient 8 milliards de pré-remplissage / 16 milliards de décodage pour la latence ? Moins de paramètres actifs en entrée signifie un temps de premier jeton plus rapide sur les longs prompts. Plus en sortie signifie que le calcul est dirigé là où la qualité de la génération est décidée. Le cache KV de 890 octets par jeton maintient les longues sessions peu coûteuses en mémoire.
- Puis-je l'exécuter localement ? Les poids sont sous licence MIT sur Hugging Face. L'ossature seule représente environ 552 Go en 8 bits ou 280 Go en 4 bits, il s'agit donc d'un projet multi-GPU ou de streaming SSD, pas d'un projet pour ordinateur portable. Le support du moteur d'inférence au jour zéro est [VÉRIFIER].
- Les benchmarks sont-ils indépendants ? Non. Chaque score ci-dessus provient de la fiche modèle de DeepSeek. Le rapport technique contient la méthodologie.
Où en est la ligne V4
DeepSeek a fusionné une API à deux modèles en une seule. Le pari est qu'un modèle de 552 milliards de paramètres avec un budget de décodage de 16 milliards, un cache KV de taille réduite d'un quart et 2 500 sessions concurrentes par compte sert mieux les charges de travail d'agent qu'un modèle plus grand à trois ou quatre fois le prix. Les chiffres du fournisseur appuient ce pari ; votre charge de travail décidera s'il tient.
Pointez votre SDK vers `deepseek-flash`, exécutez vos propres prompts à travers lui avant le 14, et conservez le scénario de test. Si vous avez construit sur l'API V4-Flash originale, votre intégration fonctionne déjà. Ce qui a changé, c'est le modèle derrière elle, et c'est la partie qui mérite d'être mesurée.