
Claude Opus 5.5 est le tout nouveau modèle de la gamme Opus d’Anthropic, publié le 22 septembre 2026. Il est arrivé le jour même où OpenAI lançait GPT-6 Sol et GPT-6 Luna, ce qui explique pourquoi votre fil d’actualité a passé cette semaine-là à débattre du prix par token au lieu de lire l’une ou l’autre page de lancement.
Si vous avez claude-opus-5 qui traîne dans un fichier de configuration, voici la version courte de ce que le changement d’identifiant vous rapporte. Opus 5.5 coûte 4 $ par million de tokens en entrée et 20 $ par million de tokens en sortie, contre 5 $ et 25 $ pour Opus 5. Il embarque une fenêtre de contexte de 1 000 000 de tokens et une sortie maximale de 128 000 tokens. Anthropic affirme qu’il coûte 40 % moins cher à exécuter qu’Opus 5, produit sa sortie 30 % plus vite et reste sur une seule tâche pendant 18 heures ou plus. Sur l’Artificial Analysis Intelligence Index, il se classe premier sur 212 modèles avec un score de 58, même si cet indice est une mesure tierce et non une affirmation du fournisseur.
Ce guide couvre la fiche technique, les huit scores de benchmarks publiés par Anthropic, l’arithmétique du cache qui détermine votre facture réelle, et les comparaisons que vous devriez refuser de faire. Chaque requête ci-dessous est du HTTP simple avec du JSON, vous pouvez donc la construire et l’inspecter dans Apidog. Pour le contexte plus large de trois lancements de pointe en deux jours, voir la guerre des prix des modèles d’IA de septembre 2026.
Claude Opus 5.5 en un coup d’œil
| Spécification | Valeur |
|---|---|
| Identifiant de modèle API | claude-opus-5-5 |
| Date de publication | 22 septembre 2026 |
| Tarif d’entrée | 4 $ par million de tokens |
| Tarif de sortie | 20 $ par million de tokens |
| Lecture d’entrée en cache | 0,20 $ par million de tokens |
| Écriture de cache | 5 $ par million de tokens |
| Mode rapide | 8 $ en entrée / 40 $ en sortie par million de tokens |
| Fenêtre de contexte | 1 000 000 de tokens |
| Sortie maximale | 128 000 tokens |
| Coût d’exécution vs Opus 5 | 40 % de moins, selon Anthropic |
| Vitesse de sortie vs Opus 5 | 30 % plus rapide, selon Anthropic |
| Durée de tâche soutenue | 18 h et plus sur une tâche |
| Sécurité | 85 % de tentatives réussies de contournement de limites en moins |
| Disponibilité | Claude Platform, AWS, Google Cloud, Azure |
| Artificial Analysis Intelligence Index | 58, classé n° 1 sur 212 (tiers) |
Deux lignes méritent un second regard. Le tarif de lecture en cache de 0,20 $ représente 5 % du tarif d’entrée standard, ce qui change les architectures qui sont abordables. Et le chiffre de 18 heures est une affirmation sur la persistance des tâches, pas sur un délai d’expiration de requête. Ce sont des problèmes d’ingénierie très différents.
Ce qui a changé depuis Opus 5
L’identifiant de modèle est la rupture évidente. Anthropic utilise un nom de produit avec point et un identifiant API sans point, donc Claude Opus 5.5 correspond à claude-opus-5-5. Un remplacement de chaîne dans votre configuration constitue la première étape de migration.
| Claude Opus 5 | Claude Opus 5.5 | |
|---|---|---|
| Identifiant de modèle API | claude-opus-5 |
claude-opus-5-5 |
| Entrée par million | 5 $ | 4 $ |
| Sortie par million | 25 $ | 20 $ |
C’est une baisse de 20 % des deux côtés du compteur. Anthropic affirme par ailleurs qu’Opus 5.5 coûte 40 % moins cher à exécuter qu’Opus 5, ce qui est une mesure différente et qu’il vaut la peine de ne pas confondre. Une baisse du prix par token combinée à moins de tokens dépensés pour terminer le même travail se cumule en une baisse plus importante du coût par tâche. Le coût par token est ce que vous vérifiez sur une facture. Le coût par tâche est ce que le fournisseur a mesuré sur ses propres évaluations, alors reproduisez-le sur votre charge de travail avant de budgétiser en fonction de lui.
Le reste du delta est comportemental : une sortie 30 % plus rapide, 18 heures ou plus de travail soutenu sur une seule tâche, et 85 % de tentatives réussies de contournement de limites en moins. Ce dernier chiffre est une affirmation de sécurité étroite, pas un badge général « plus sûr ». Notre article sur l’injection de prompt et la sécurité des API décortique ce qu’il mesure. Pour la fiche technique de la génération précédente, voir qu’est-ce que Claude Opus 5.
Les huit scores de benchmarks publiés par Anthropic
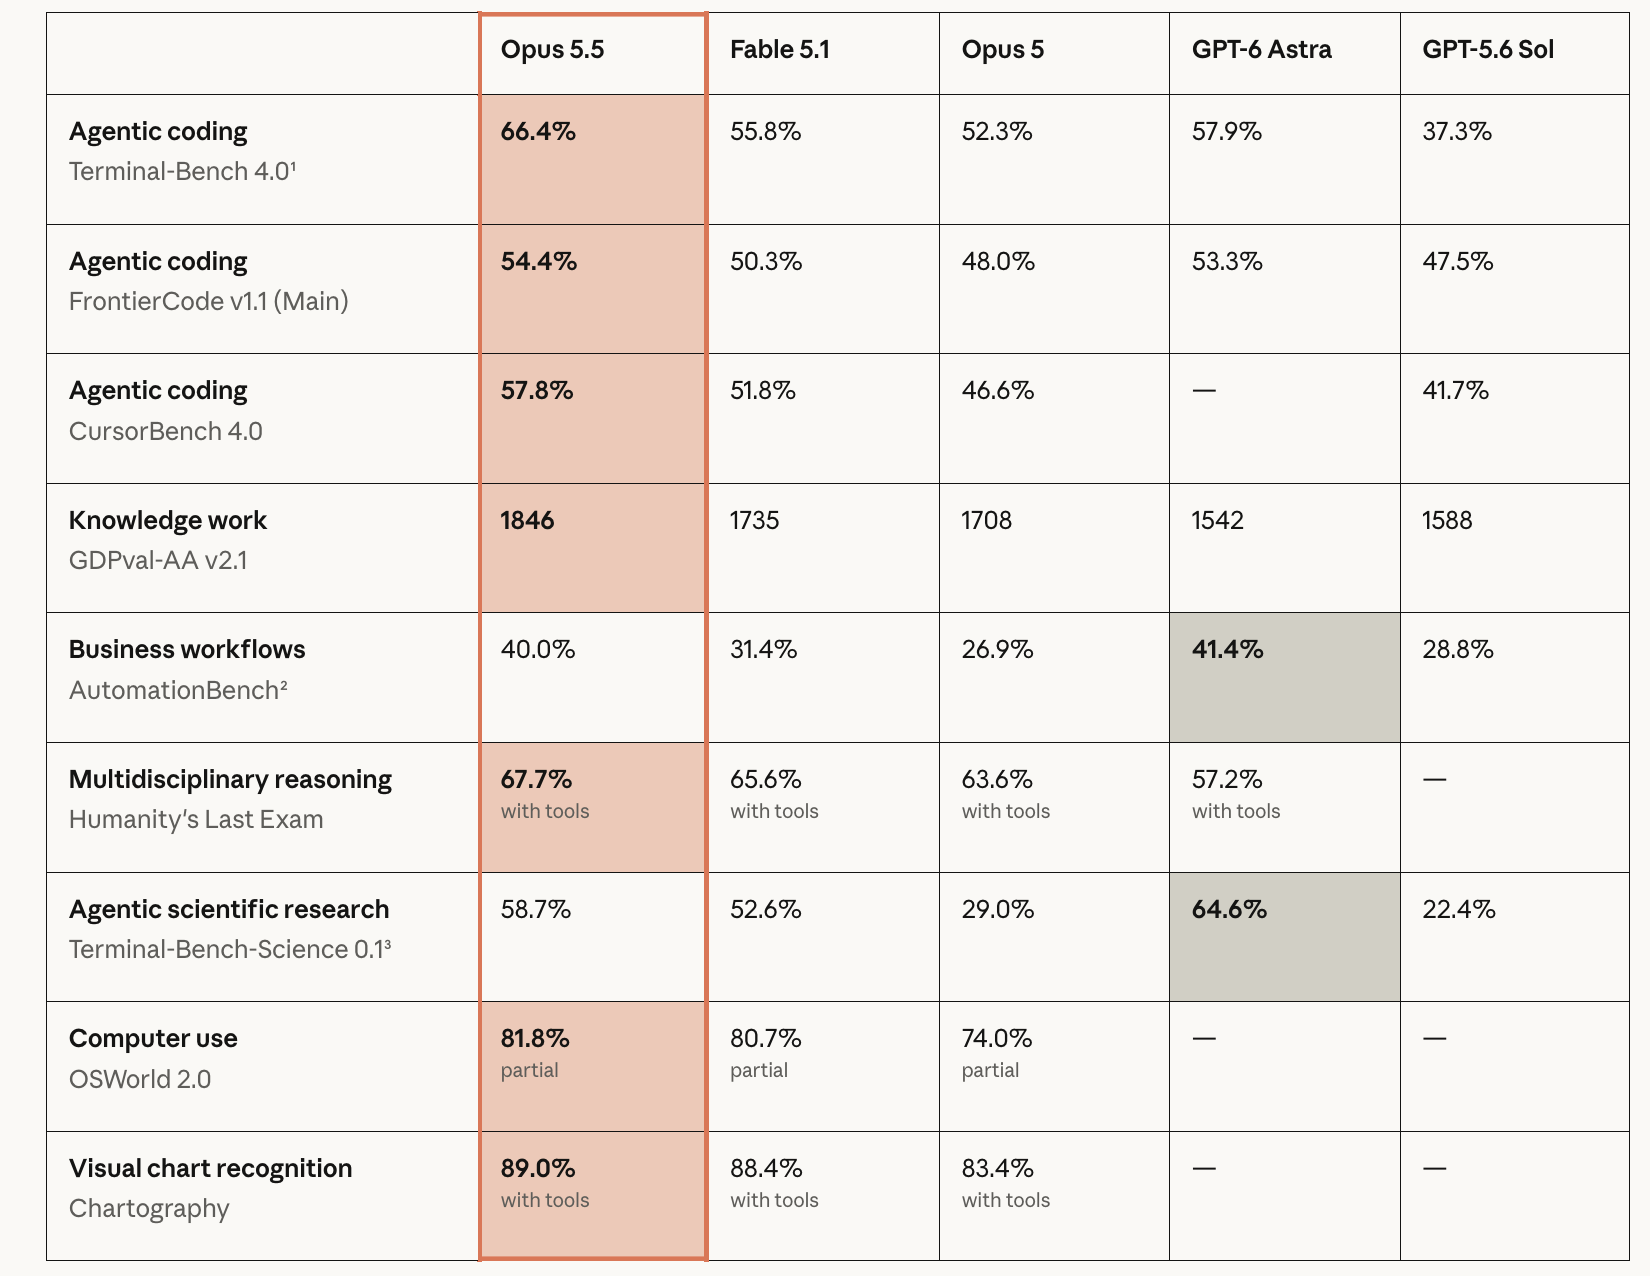
Ce sont des chiffres produits par Anthropic, issus de son propre matériel de lancement.
| Benchmark | Claude Opus 5.5 |
|---|---|
| Terminal-Bench 4.0 | 66,4 % |
| FrontierCode v1.1 | 54,4 % |
| CursorBench 4.0 | 57,8 % |
| GDPval-AA v2.1 | 1846 Elo |
| AutomationBench | 40,0 % |
| Humanity’s Last Exam, avec outils | 67,7 % |
| OSWorld 2.0 | 81,8 % |
| Chartography | 89,0 % |
Remarquez ce qui manque : des colonnes adverses. Anthropic a publié des scores, pas une grille comparative face à GPT-6, donc quiconque vous montre un beau tableau Opus 5.5 contre Astra construit à partir de ces lignes l’a assemblé lui-même.
AutomationBench est le piège, car il apparaît dans le matériel de lancement des deux fournisseurs. Les chiffres d’OpenAI proviennent d’AutomationBench 1.0.6 et placent GPT-6 Sol avec un raisonnement extra-élevé à 33,2 %, GPT-6 Astra en faible à 30,3 %, et Claude Opus 5 au maximum à 26,9 %. Le 40,0 % d’Anthropic pour Opus 5.5 provient de sa propre exécution, et la version ainsi que le niveau d’effort ne sont pas indiqués dans le matériel que nous avons vérifié. Deux fournisseurs, deux harnais, deux réglages d’effort, peut-être deux versions du benchmark. Ne soustrayez pas l’un de l’autre pour appeler la différence une avance.
Où se situe Opus 5.5 dans le paysage du 22 septembre
| Modèle | Identifiant API | Entrée $/M | Sortie $/M | Contexte | Indice AA |
|---|---|---|---|---|---|
| Claude Opus 5.5 | claude-opus-5-5 |
4 $ | 20 $ | 1M | 58 |
| GPT-6 Sol | gpt-6-sol |
2 $ | 10 $ | 872k | 48 |
| GPT-6 Luna | gpt-6-luna |
0,10 $ | 0,50 $ | 1M | 37 |
| GPT-6 Astra | n/a | 10 $ | 50 $ | n/a | n/a |
| Claude Opus 5 | claude-opus-5 |
5 $ | 25 $ | n/a | n/a |
| Grok 4.7 | n/a | 2 $ | 6 $ | n/a | n/a |
La colonne Artificial Analysis est un indice tiers, pas une affirmation de fournisseur, et un seul chiffre composite représente beaucoup de tâches très différentes. Considérez-le comme un ordre de tri, pas comme un verdict.
Il y a une chose réellement utile à remarquer à propos du timing. Le billet de lancement d’OpenAI évalue Sol et Luna par rapport à Claude Opus 5, parce qu’Opus 5.5 n’existait pas quand ce billet a été écrit. Anthropic a livré Opus 5.5 quelques heures plus tard, à 20 % en dessous du prix d’Opus 5. Donc la phrase largement citée selon laquelle Sol en extra-élevé bat Opus 5 au maximum pour 9 % du coût par tâche est vraie telle qu’écrite et mesurée contre un modèle qui a été remplacé le jour même. Personne n’a publié la nouvelle exécution.
L’affirmation inverse est tout aussi non étayée. OpenAI déclare qu’Astra « continue d’être notre meilleur modèle sur tous les plans », et aucun des deux fournisseurs n’a publié de comparaison Astra contre Opus 5.5. Les chiffres comparatifs spécifiques qui circulent sur X sont des tweets, pas des données de fournisseurs. Si vous avez besoin de cette réponse, la seule source honnête est votre propre harnais d’évaluation sur vos propres tâches.
L’arithmétique du cache qui décide de votre facture
À 4 $ en entrée et 0,20 $ pour une lecture en cache, un accès au cache coûte 5 % d’une lecture fraîche. Les écritures de cache sont facturées à 5 $ par million, soit une prime de 25 % par rapport au tarif d’entrée standard. Ce ratio rend le seuil de rentabilité peu profond.
Prenons un préfixe système de 200 000 tokens, un schéma d’outil plus un morceau de votre base de code ou de votre spécification. Sans cache, chaque appel facture 200 000 tokens à 4 $ par million, soit 0,80 $ chacun. Dix appels coûtent 8,00 $ rien qu’en entrée.
Avec cache, vous payez l’écriture une fois à 5 $ par million, soit 1,00 $, puis chaque lecture suivante est facturée à 0,20 $ par million, soit 0,04 $. Dix appels coûtent 1,00 $ plus neuf lectures à 0,04 $, soit 1,36 $. La prime d’écriture est remboursée dès la première relecture, et au dixième appel vous payez environ 17 % de la facture sans cache.
En haut de la fourchette, envoyer la fenêtre complète de 1 000 000 de tokens coûte 4,00 $ en entrée fraîche et 0,20 $ en lecture en cache. C’est la différence entre une stratégie de contexte que vous pouvez exécuter en boucle et une que vous ne pouvez pas. Le modèle complet de coût de mise en cache détaille les boucles d’agents et les préfixes multi-locataires.
Le mode rapide est facturé à 8 $ en entrée et 40 $ en sortie, exactement le double du tarif standard. Budgétez-le comme un achat de latence pour les chemins interactifs, pas comme un réglage par défaut.
Ce que 18 heures sur une tâche fait à votre couche API
Un modèle qui travaille pendant 18 heures n’est pas une requête plus longue. C’est une forme d’intégration différente, et la plupart du code API écrit pour des complétions de chat va casser dessus.
Quatre points nécessitent votre attention. Les délais d’expiration au niveau du répartiteur de charge, de la passerelle et du client doivent tolérer des flux de longue durée, sinon vous avez besoin d’une conception tâche-plus-interrogation à la place. Les tentatives doivent être idempotentes, car rejouer une requête qui a déjà consommé trois heures d’appels d’outils est coûteux d’une manière qu’un GET réessayé n’est jamais. Le streaming a besoin d’une gestion du keepalive pour qu’une connexion d’apparence inactive ne soit pas coupée en pleine tâche. Et la reprise après incident compte plus que le débit : si le processus meurt à la onzième heure, vous devez savoir quel état était durable. L’article sur la conception d’API pour les tâches de 18 heures couvre chacun avec des patrons concrets.
Appeler Claude Opus 5.5
La forme de l’API Messages est inchangée. Échangez l’identifiant et donnez à max_tokens une vraie marge.
curl https://api.anthropic.com/v1/messages \
  --header "x-api-key: $ANTHROPIC_API_KEY" \
  --header "anthropic-version: 2023-06-01" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-opus-5-5",
    "max_tokens": 16384,
    "messages": [
      {"role": "user", "content": "Review this handler and list the failure modes."}
    ]
  }'
Deux habitudes rapportent immédiatement. Gardez la clé dans une variable d’environnement pour qu’elle n’atterrisse jamais dans une collection partagée. Et lisez le bloc usage de chaque réponse, car c’est là que vous confirmez que les lectures en cache arrivent bien au lieu d’être silencieusement refacturées à 4 $ par million. Un cache qui rate silencieusement ressemble exactement à une intégration qui fonctionne, jusqu’à l’arrivée de la facture.
C’est là qu’un client API mérite sa place. Dans Apidog, vous pouvez enregistrer une requête Messages de référence, la dupliquer pour le streaming et le non-streaming, exécuter les deux sur le même prompt, et faire des assertions sur les champs usage afin qu’une régression de cache fasse échouer un test au lieu de vous surprendre en fin de mois. Le visualiseur SSE montre aussi où un long flux s’est réellement arrêté. Téléchargez Apidog et importez la requête ci-dessus pour suivre le guide.
Disponibilité
Anthropic liste Opus 5.5 sur Claude Platform, AWS, Google Cloud et Azure. Les niveaux de l’application grand public et la date de coupure des connaissances ne figurent pas dans le matériel que nous avons vérifié, nous n’imprimons donc ni l’un ni l’autre. Vérifiez la page de modèle d’Anthropic avant d’écrire une date de coupure dans un prompt système.
Devriez-vous migrer ?
Migrez si vous êtes aujourd’hui sur claude-opus-5. Même gamme, 20 % de moins par token des deux côtés, de meilleurs chiffres publiés, et le seul coût est l’échange d’identifiant plus une exécution de non-régression. Les notes de migration couvrent les détails visibles par l’appelant.
Réfléchissez davantage si votre charge de travail est bon marché et à fort volume. Le tarif de la gamme Opus n’est pas là où appartiennent la classification ou l’extraction en masse, et les lancements de septembre ont fait entrer une fenêtre de contexte de 1M dans la gamme sous le dollar. Comparez avec cette gamme avant de choisir Opus par défaut.
Et mesurez avant de croire une quelconque affirmation inter-fournisseurs de cette semaine-là, y compris le tableau ci-dessus. Deux laboratoires ont livré trois modèles de pointe le même jour, chaque comparaison publiée a été écrite par rapport à un modèle qui avait déjà été remplacé, et le seul benchmark qui tranche votre décision est celui qui exécute vos propres requêtes.